
Alibabaが実際に語ったことと発表した製品
まずはキーノートから見ていきましょう。Qianwen Officeの公式アカウントが中国語で公開した公式の書き起こしによると、この講演は企業が直面する3つの障害を中心に構成されています。要約すると、自社のビジネスを知らないAIは、「東部地域の第1四半期の売上総利益率は?」といった質問に答えることができません。なぜなら、そのAIは「我が社」がどの会社を指しているのかを知らないからです。また、AIをうまく使いこなす個人だけに生産性の向上が留まってしまい、組織全体でその経験を共有する優れた仕組みが欠けています。そして、企業はデータセキュリティへの懸念から導入を躊躇しています。
Chenの回答は、エンタープライズエージェントの前提条件はデータであり、それは「接続(connect)」「理解(understand)」「再利用(reuse)」という3つのアイデアを中心に整理されるべきだというものでした。彼はまた、見落とされがちですが重要な指摘をしました。何かを知らないエージェントは単にそれを知らないのであり、よりスマートなモデルであっても、与えられていない事実を推測することはできません。一度教えてしまえば、コスト効率の高いモデルで十分な場合が多いのです。
彼が発表した製品はEnterprise Contextでした。36Krの英語レポートが説明するように、これは「エンタープライズコンテキストデータ管理のための製品」です。企業がかつて暗黙知と呼んでいたもの(ドキュメント、会議、グループチャットなど)を接続し、「レイヤーごとに圧縮して、必要に応じてエージェントが使用できるように抽出」します。Qianwen Officeのエージェントホスティングと組み合わせることで、企業のビジネスを理解するデジタル従業員の実現を目指しています。
書き起こしでは、なぜ圧縮が重要なのかについて具体的に述べられています。Chenは、企業のすべてのデータを単に1つの場所に集めるだけでは、エージェントはそれを活用できないと主張しました。コンテキストウィンドウを過負荷にすると、エージェントがタスク自体を実行するために必要なスペースが浪費されてしまうからです。彼が説明したアプローチは階層的でした。企業の知識をファイルシステムのように整理し、各レベルがその下のレベルを圧縮する(スキルが段階的に詳細を開示していくようなイメージ)とともに、人、プロジェクト、チャット、ドキュメントの間の関係性を示すグラフを構築します。
Alibaba Cloudの発表は、この同じアイデアをインフラストラクチャレイヤーに配置しました。同社のプレスリリースでは、同社のエージェント型クラウドは「モデル、ハーネス、コンテキストという3つのコアシナリオを中心に構築されている」と説明されており、Context Engineレイヤーが「リアルタイムデータと長期記憶を提供」します。その中で、「Agent Contextは、AIエージェントにリアルタイムのコンテキストと長期記憶を提供するエンタープライズグレードのコンテキストデータサービスです。企業のドキュメント、ビジネスシステム、チャット記録、マルチモーダルデータを単一の基盤に接続することで、エージェントが過去のタスクを記憶し、チーム間で知識を共有し、継続的に学習することを可能にします。」
会議に関しても新たな発表がありました。ChenはウェアラブルなノートテイカーであるQwenNote A2を紹介し、Shuは後にハードウェアを「段階的なコンテキスト収集のための非常に優れた入り口」と表現しました。これは、会話をエージェントが利用できるテキストに変換する方法です。プライバシーに関して、レポートは「A2は元の音声を保持せず、文字起こしコンテンツはテキストと会議の議事録のみを保持する」と指摘しています。
レポートは、オフィスにおけるこのスローガンの意味を「コンテキストがすべて(Context is everything)」という言葉で要約しています。
二度読み返す価値のある主張:コンテキストは所有者に帰属する
インタビューの中で、このアイデアは単なる製品の売り込みではなく、一つの原則へと昇華します。
Shu Junliangは、なぜAlibaba自体のアプリが依然として統一されたコンテキストを共有していないのかと尋ねられました。彼の回答はこうです。「Qwen、Feishu、Qianwen Officeなどのソフトウェア間でコンテキストを相互接続するという次元で考えるべきではありません。なぜなら、コンテキストは実際にはその主体(私の個人的なコンテキストであれ、この企業のコンテキストであれ)に追従するものであり、これは最終的に使用するエージェントから切り離されている(デカップリングされている)からです。」
そして、彼はAlibabaが提供しようとしているものについて説明しました。「私たちが提供するのは、企業自体に帰属するエンタープライズレベルのコンテキストのインフラストラクチャです。」さらに、企業がそれを求めるべき理由を説明しました。「大企業は1つのAI製品を使用するだけでなく、自社でいくつかのAI製品を開発することもあります。これらのAI製品が、自社のコンテキストから恩恵を受けられないなどということがあってよいでしょうか?」
彼の締めくくりの比較は、この記事の中で最も率直な一言です。彼はエンタープライズコンテキストを「新しい時代のデータインフラであり、データベースと同じようなものだが、データベースのようにまだ標準化されていないだけだ」と呼びました。
これらの言葉から、3つのことが導き出されます。コンテキストは組織の資産であり、今日使用しているエージェントの機能ではありません。企業は、購入したものや自社で構築したものを含め、複数のエージェントを運用することになり、そのすべてが同じコンテキストから恩恵を受けるべきです。そして、業界にはまだこれを実現するための標準的な方法が存在しません。
Shuは個人の側面についても同様に率直でした。個人データは「現在、さまざまなアプリに分散して存在している」とし、それを収集できるかどうかは「これらの企業が個人に権限を開放するかどうかにかかっています。現時点では、そのような開放の傾向は見られません」と述べました。
これによって何が変わり、何が変わらないのか
It does make "enterprise context" a named category. When Alibaba Cloud organizes its agent strategy around model, harness and context, and gives context its own product line, the idea of a context layer for AI agents stops being niche. Expect more vendors to describe their products this way.
It does validate an approach many teams arrived at the hard way. Connect the sources, compress them into something an agent can use, and make individual know-how reusable across the group. Chen's three keys — connect, understand, reuse — are a clean summary of what context engineering looks like at company scale.
It does not create a standard. Shu said so himself. Enterprise Context is a product inside Qianwen Office, which is deeply integrated with DingTalk; Chen stressed openness, telling the audience that Qianwen Office serves many customers who use Feishu and WeCom and that "Whether it is Qianwen Office or Enterprise Context, we must adhere to the principle: openness, and more openness." That is a commitment from one vendor, not an interoperable format.
It does not settle personal context. By Shu's own account, the data that describes an individual is scattered across apps that do not open it up.
And it does not tell a team using ChatGPT, Claude, Cursor and an internal agent where their context should live today. That part is left to you.
人々がここから受け取るべきこと —— そして、受け取るべきではない誤解
「より優れたモデルが解決してくれる」 キーノートではその逆が主張されています。どれほどインテリジェントなモデルであっても、あなたの会社の価格設定ルールや地域の定義を推測することはできません。同じ論理から、コンテキストウィンドウの拡大は記憶ではないと言えます。容量は知識ではないのです。
「すべてを1つの大きなストアに放り込んで、エージェントに検索させればいい」 Chenは講演の大部分を割いて、なぜその方法が失敗するのかを説明しました。圧縮と構造化こそが重要な作業です。
「コンテキストは、自分が選んだエージェントの機能である」 Shuの指摘は、コンテキストはエージェントから切り離されるべきだということです。コンテキストが1つのツール内だけに存在している場合、ツールを切り替えることは最初からやり直すことを意味します。これは、AIの記憶は機能なのか、それともロックインなのかという疑問の背景にある問題です。
「これは大企業だけのものだ」 キーノートで挙げられた3つの障害(ビジネスを知らないエージェント、個人に留まるノウハウ、データに対する不安)は、大企業だけでなく、10人のチームにもまったく同じように当てはまります。規模は変わっても、課題は同じです。
解決策:コンテキストをチームが所有するものとして扱う
Alibabaの主張を実行に移すために、エンタープライズプラットフォームは必要ありません。エージェントが何を知るべきかを決定し、それをコンパクトに保ち、特定のツールよりも長生きする場所に保管するだけでよいのです。
ステップ 1:エージェントが推測できないコンテキストを書き出す
キーノートの例を文字通りに受け止めてみましょう。あなたの会社において「東部地域」とは何を意味しますか?売上総利益率はどのように計算されますか?どの顧客が戦略的で、どの製品が廃止予定で、どの決定が最終決定ですか?これらはモデルが推測できない事実であり、新しいチャットのたびに何度も説明し直されていることそのものです。
これらをリストアップしてください。次に、Chenが説明した2つ目のカテゴリー、つまりAIをうまく使いこなしている人々のノウハウを追加します。効果的なプロンプト、レビューのチェックリスト、トップ営業担当者が提案書を作成する方法などです。現在、その知識は一人のチャット履歴の中に眠っています。
これは、誰かが退職するときに失われる暗黙知でもあります。退職時にAIコンテキストを維持するための取り組みも、この同じリストから始まります。
ステップ 2:エージェントがナビゲートできるレイヤーに圧縮する
すべてをアップロードしたいという衝動を抑えてください。チームの規模に合わせて、キーノートで説明された構造に従いましょう。
最上部には、チームの業務内容、主要なプロジェクト、詳細情報の参照先を示す短いインデックスを置きます。その下には、プロジェクト、顧客、またはプロセスごとに、現在のステータスとそれを形成した決定事項をまとめた簡潔なエントリを1つずつ配置します。さらにその下に、本当に詳細が必要な場合のためのソースドキュメント自体を配置します。
各要素を接続します。プロジェクトに関するエントリには、関与しているメンバーや重要なドキュメントの名前を記載し、エージェントが推測するのではなく、一方から他方へと移動できるようにします。会議の結果もここに含めますが、書き起こしではなく決定事項として記述します。書き起こしは発言内容を記録するものですが、エントリは合意事項を記録するものだからです。そして、日付を入れます。Shuは、企業内には「データの性質とデータの時系列順との間に多くの矛盾が存在する」と指摘しました。最新の決定事項が古い決定事項を視覚的に置き換えるようにする必要があります。
ステップ 3:単一のエージェントから切り離し、それが機能しているかテストする
これは、Shuの原則をチェックリストに落とし込んだものです。複数のエージェントがアクセスできる場所にコンテキストを保存し、2つの異なるツールで同じ質問をしてみてください。一方しか答えを知らない場合、あなたのコンテキストはそのツールの中に閉じ込められています。
同時に境界線を設定します。キーノートでは、エージェントが機密データにアクセスする前に確認を求めるなど、セキュリティに大きな注意が払われていました。何かを接続する前に、どのコンテキストをすべてのエージェントと共有し、どれを制限するかを決定してください。
最後に、常に最新の状態を保ちます。Chenは、ビジネスデータは絶えず変化するため、変化に合わせて再理解する必要があると指摘しました。コンテキストの更新を、別の雑用にするのではなく、意思決定を完了するプロセスの一部に組み込んでください。チーム用の共有AIメモリを設定するでは、この習慣の日常的な実践方法について説明しています。
MemoryLakeでの設定方法
Alibabaのフレームワークは、組織に帰属し、使用するあらゆるエージェントにサービスを提供するレイヤーについて説明しています。ChatGPT、Claude、コーディングエージェント、および自社ツールをまたいで作業するチームにとって、MemoryLakeはそのレイヤーを維持するための最適な場所の1つです。これは、特定の製品の外部に存在する、AIエージェント用の長期記憶です。
エントリはあなた自身の言葉で作成します。Qianwen Office、DingTalk、Alibaba Cloud、またはその他のベンダーのストアからデータが読み取られたり、書き込まれたり、削除されたりすることはありません。
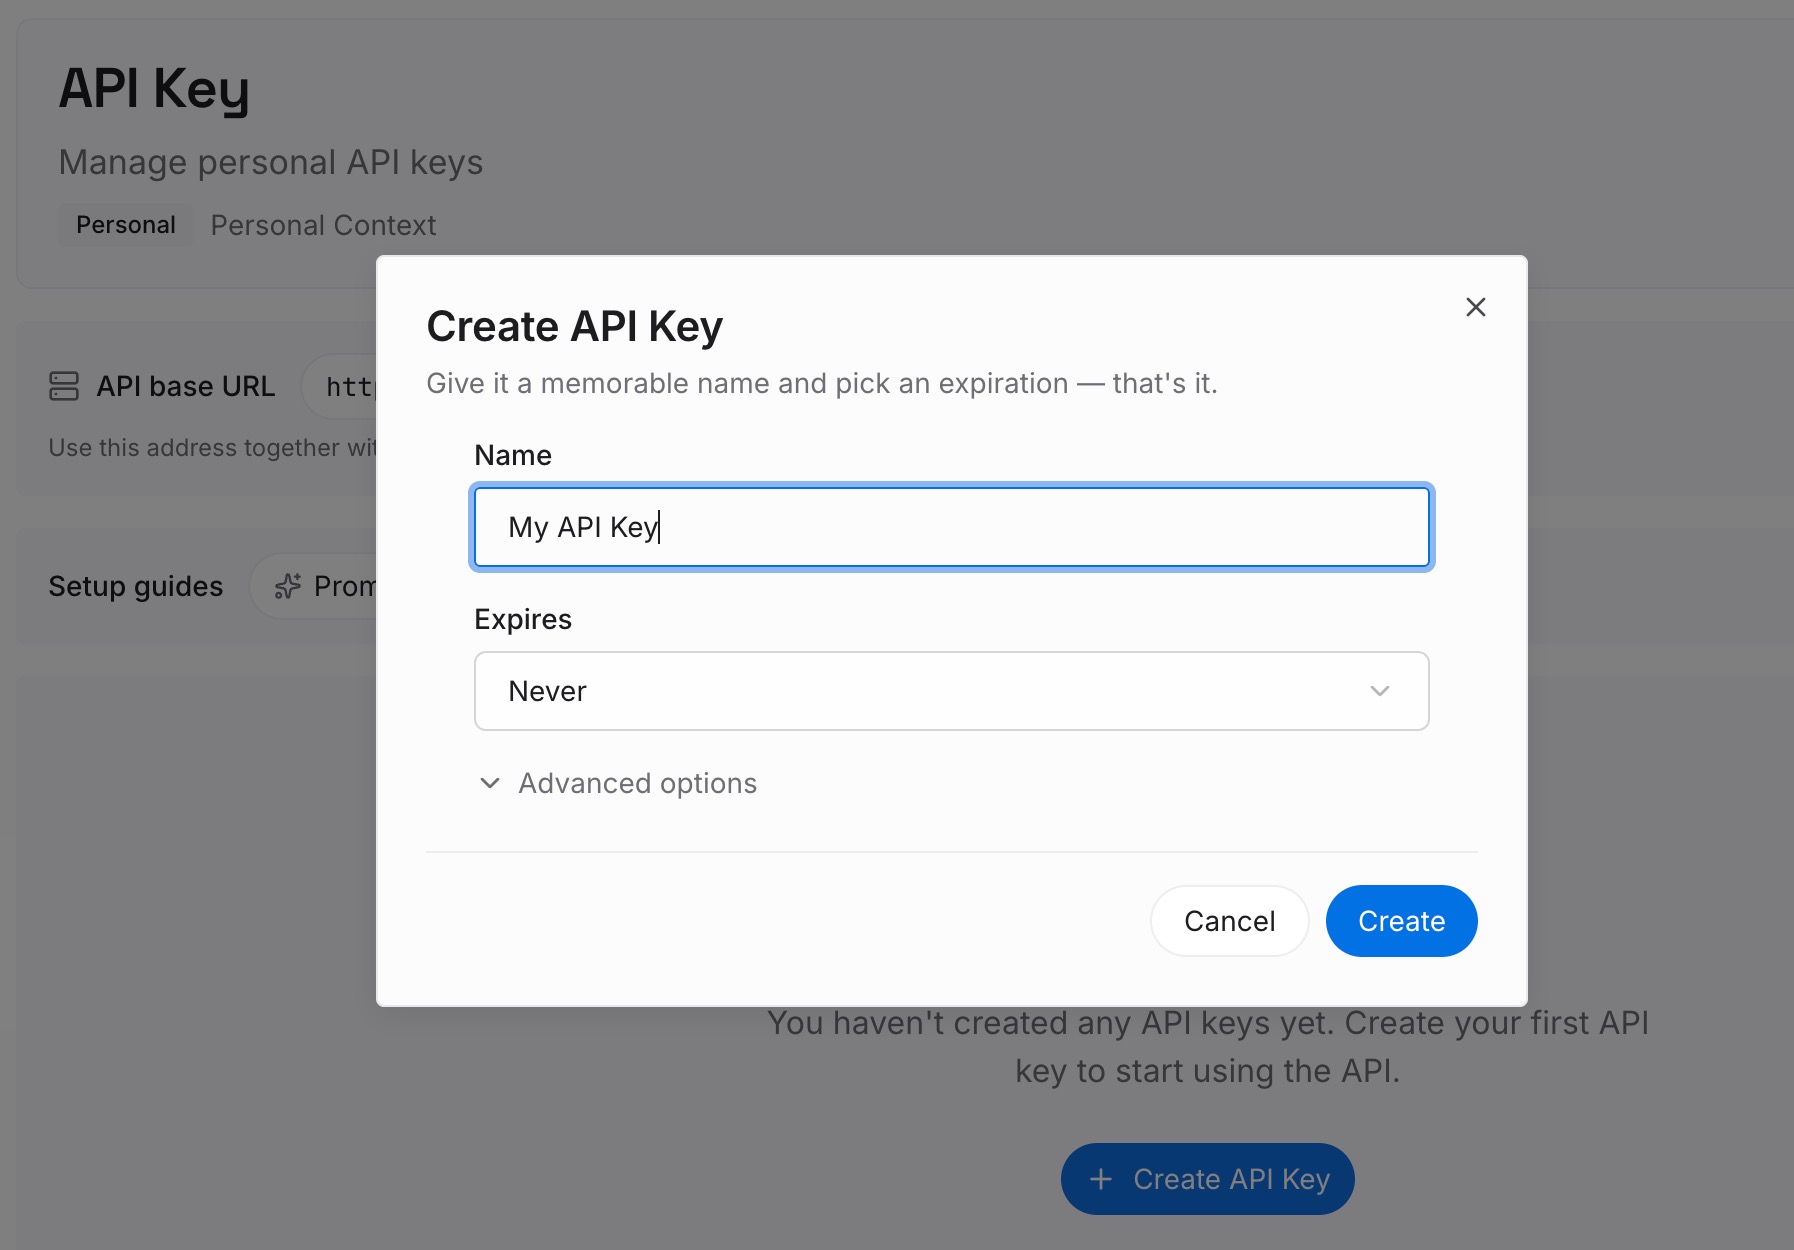
ステップ 1:APIキーを作成する
サインインし、ダッシュボードからキーを生成します。キーはメモリレイヤー内のワークスペースに属しているため、チームが今期どのエージェントを使用しているかに関係なく独立しています。
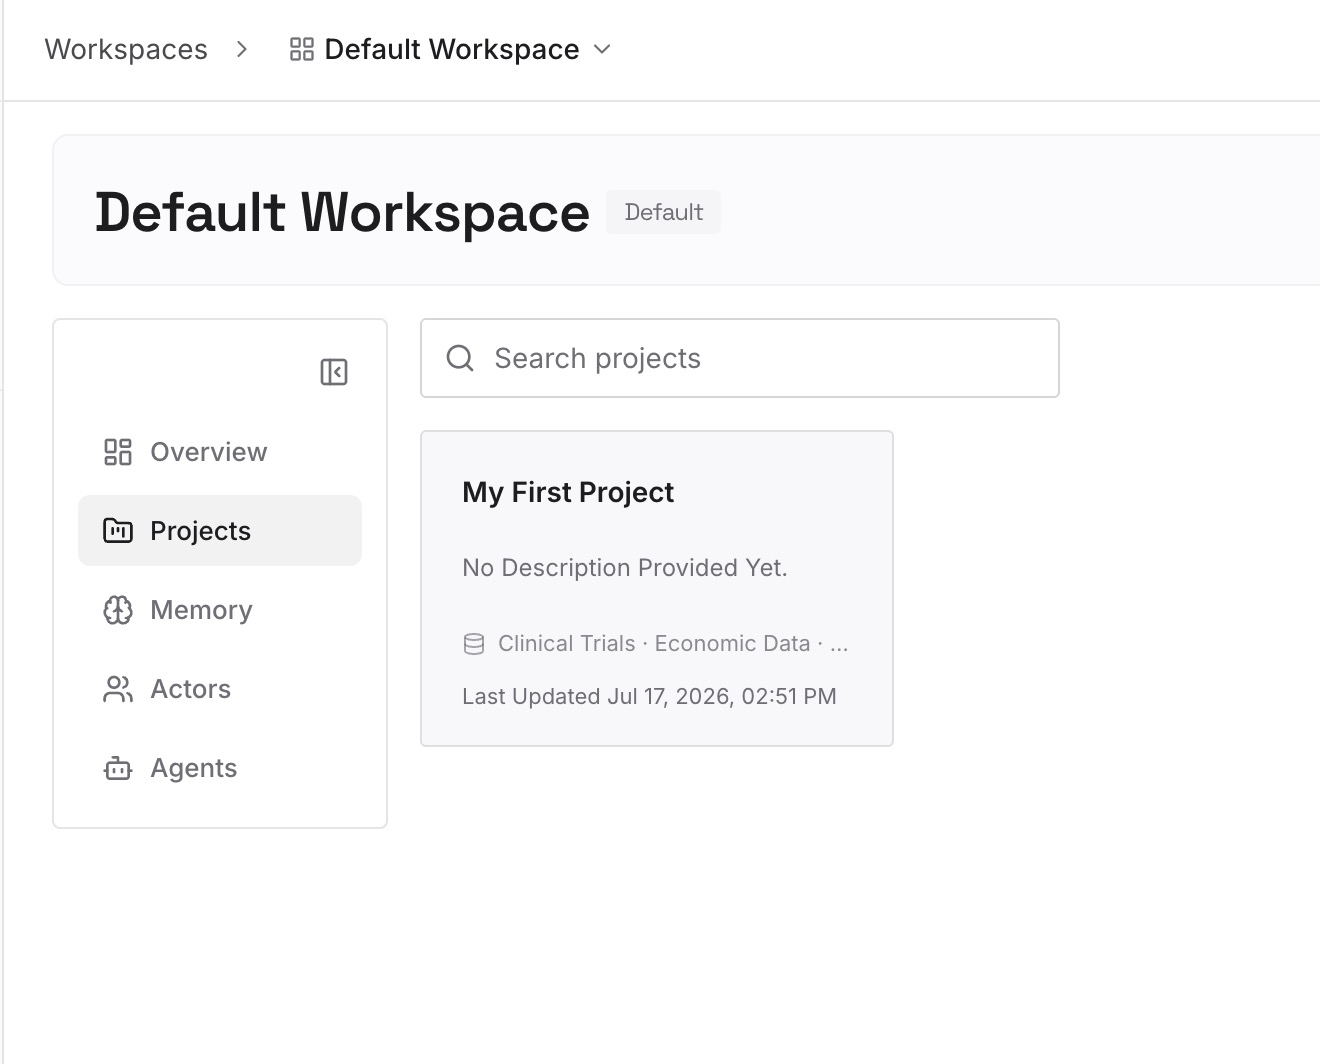
ステップ 2:最初のメモリをアップロードする
上記の解決策のステップ1のリストから始めましょう。モデルが推測できない定義、最終決定事項、共有する価値のあるノウハウなどです。ステップ2の階層構造に従って、各エントリをコンパクトに保ち、日付を記載します。
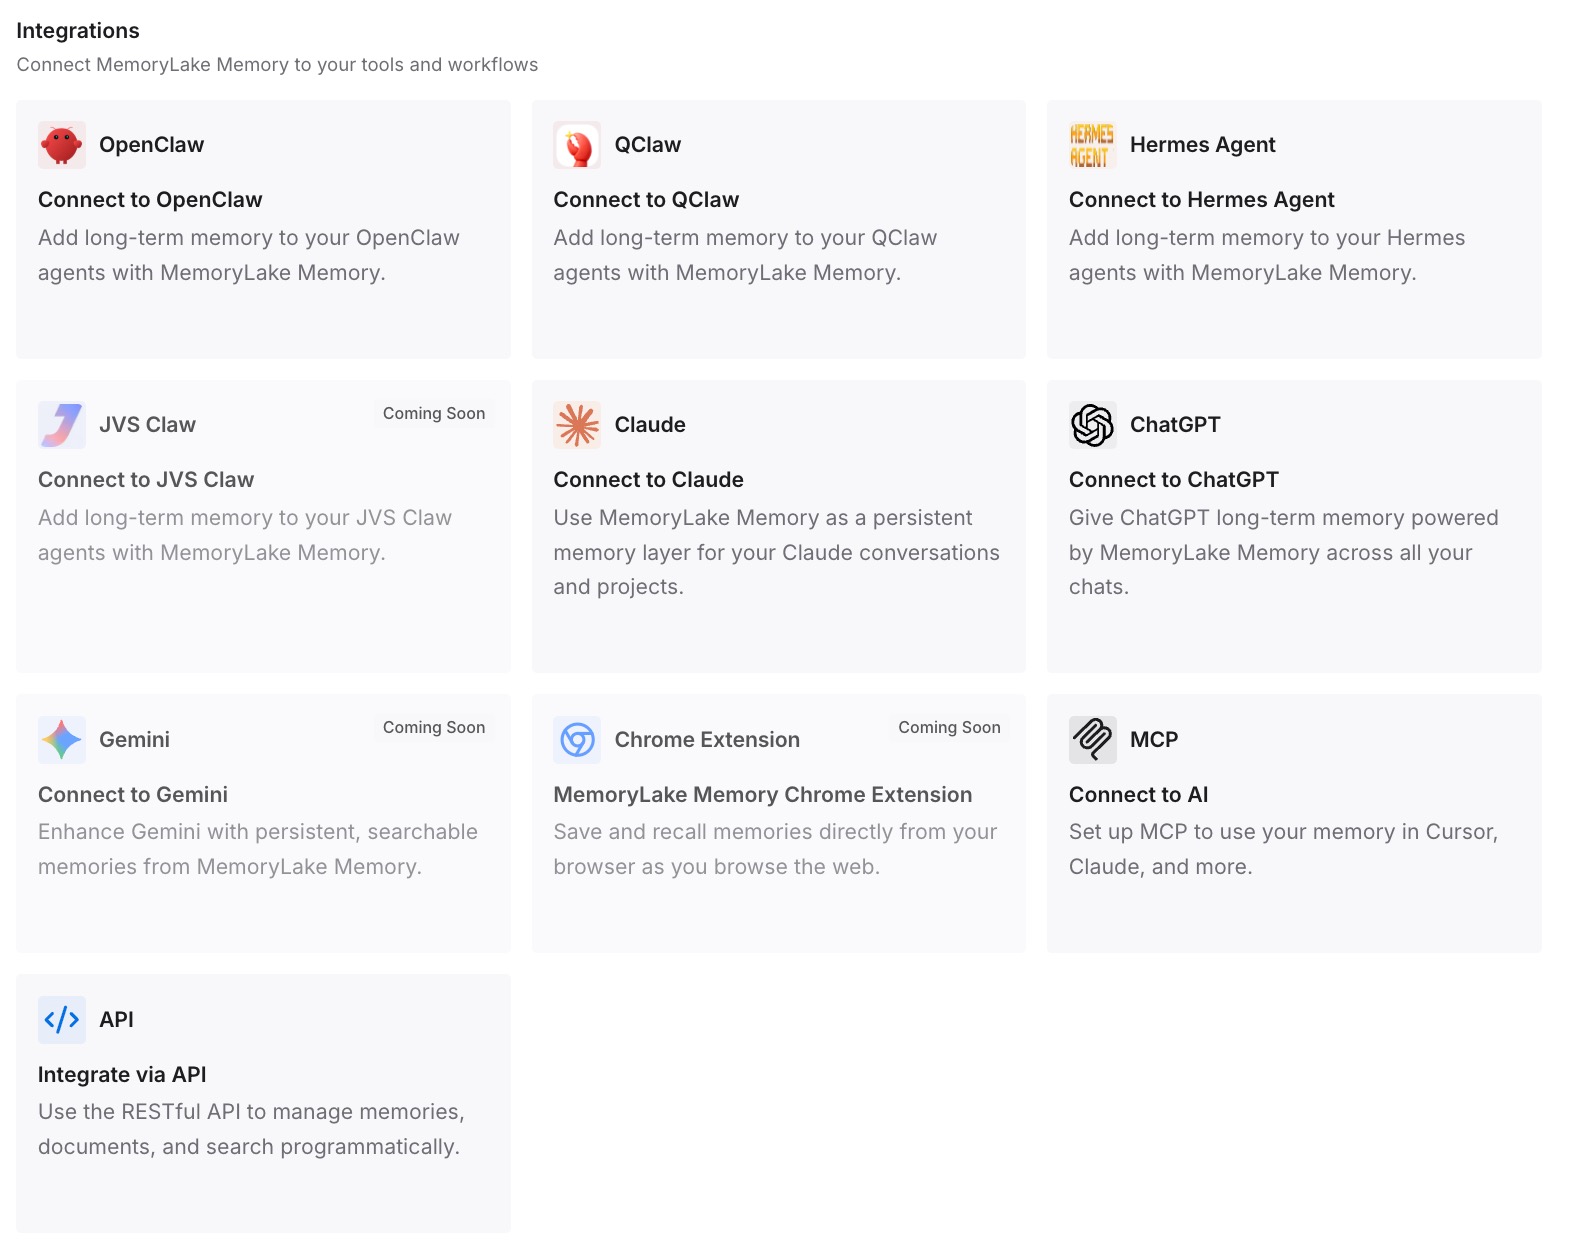
ステップ 3:AIとエージェントを接続する
チームが使用しているアシスタントやエージェントを接続します。これにより、同じエントリがそれぞれで利用可能になり、ステップ3のデカップリングテストが設計通りにクリアされます。
実務において何が変わるのか
第1の違いは、エージェントのオンボーディングが人間のオンボーディングのようになることです。すべてのチャットでビジネスについて何度も説明し直する代わりに、新しいツールはすべて同じブリーフィングから開始できます。職場で人々が「AIの物忘れ」と呼ぶもののほとんどは、このギャップによるものです。これについては、なぜ企業のAI知識は毎週月曜日に消えてしまうのかで説明されています。
第2の違いは、個人のノウハウがチームの知識になることです。共有されない経験に関するキーノートの指摘は、新しい機能によって解決されるというよりも、習慣によって解決されます。誰かが効果的なアプローチを見つけたら、それを個人の履歴に留めるのではなく、共有コンテキストに追加するのです。
第3の違いは、エージェントの切り替えや追加にコストがかからなくなることです。コンテキストが切り離されていれば、新しいコーディングエージェント、新しいチャットアシスタント、あるいは来年構築される社内ツールであっても、最初から情報を把握した状態で開始できます。これこそが、クロスエージェントメモリがもたらすポータビリティです。
第4の違いは、セキュリティに関する決定が明確になることです。各エージェントが何を表示できるかを決定することは、コンテキストがそれぞれ独自のデフォルト設定を持つツール群に分散している場合よりも、自分がコントロールする1つのレイヤーにまとまっている場合の方がはるかに容易になります。
エンタープライズコンテキストのベストプラクティス
推測できないことから始める。 大量のドキュメントよりも、定義、決定事項、例外事項の方が重要です。
接続する前に圧縮する。 エージェントが苦労して読み進めなければならない大量のデータよりも、短く階層化されたエントリのセットの方が優れています。
すべての決定に日付を入れる。 最新のバージョンが古いバージョンを視覚的に置き換えるようにします。
コンテキストを特定のエージェントから独立させる。 2つのツールに同じ質問をしてテストします。
アクセス境界を早期に設定する。 すべてのエージェントがすべての事実を必要とするわけではありません。
機能だけでなく、所有権に基づいてプラットフォームを評価する。 エンタープライズAIメモリプラットフォームを比較する際は、ベンダーを変更してもコンテキストが自分のものとして残るかどうかを確認してください。
結論
「Context is All You Need」はスローガンですが、その背後にある主張は極めて論理的です。Chen Yusenのキーノートは、エージェントが職場で失敗する主な理由は会社のコンテキストが不足しているためであり、その解決策はコンテキストを接続し、圧縮し、再利用可能にすることであると主張しました。Alibabaは、これを大規模に実現するためにEnterprise ContextとAgent Contextを発表しました。
この発表よりも長く記憶に残るであろう言葉は、Shu Junliangのものです。コンテキストは「最終的に使用するエージェントから切り離されており」、企業のコンテキストは「その企業自体に帰属しなければならない」という言葉です。彼は、このためのインフラストラクチャが「データベースのようにまだ標準化されていない」と率直に認めました。
標準化されるまでの間、あらゆるチームにとっての実践的な答えは同じです。エージェントが推測できないことを書き出し、それをコンパクトかつ最新の状態に保ち、使用するすべてのエージェントがアクセスできる場所に保管することです。