
Anthropicが定義する「エージェント記憶」とは
この投稿では、エージェント記憶を狭義に定義しています。それは「Claudeが経験(ユーザーとのやり取りや割り当てられたタスクを含む)から得た知識であり、セッション間で保持され、後で読み取ることができるコンテキストとして保存されるもの」です。
また、除外されるものもリストアップされています。モデルの重みの変更、単一の会話内でのインコンテキスト学習(in-context learning)、そして古いターンを要約に置き換えてClaudeが作業を継続できるようにする「圧縮(compaction)」です。
この証拠は、いくつかの評価から得られています。Continual Learning Bench、Claudeによる『ポケットモンスター 赤』のプレイ、社内ドキュメントのコーパス、そして合併案件を題材にした法務ベンチマークです。
記憶とは「何が必要になるか」の予測である
投稿の最初のアイデアは、メモを書くことは一種の「賭け」であるということです。Anthropicの言葉を借りれば、「記憶とは、時として予測である」となります。さらに、「ルールを書き留めることで、エージェントはその記述しているパターンが再び関連性を持つようになると予測している」と続きます。
Continual Learning Benchのタスクでは、Claudeはデータベースに関する質問に答え、正解を教えられ、次の質問の前に記憶を書くことができました。各質問は新しいセッションで開始されましたが、一つだけ例外がありました。それは記憶ディレクトリが引き継がれることです。
古いモデルは、検証されていない推測が散らばったファイルを残しました。投稿によると、「Claude Opus 5がこのループを閉じた最初のモデル」であり、ルール、そのルールが真であると判断した根拠、そして落とし穴への警告を含むエントリを作成しました。
ルール、その証拠、そして回避すべき落とし穴という形式は、後でチェックする際の基準になります。
Claudeが保持することを選択するもの
ポケモンでの比較が、投稿の中で最も明確な例です。ゲーム開始から約10,000ステップの時点で、ある旧モデルは225のフォルダにわたって413の記憶ファイルを書き込み、バッジを1つ獲得していました。一方、新モデルは2つのフォルダに9つのファイルを書き込み、さらにglobal.mdというトップレベルのファイルを1つ作成し、バッジを4つ獲得しました。
違いは、各モデルが何を保存する価値があると判断したかにありました。旧モデルはすべての戦闘、アイテム、キャラクターを記録していましたが、投稿ではそれがなぜ悪影響を及ぼしたかを説明しています。「Sonnet 3.7の詳細な記録は、絶えず古くなっていった」ためです。
新モデルは、ゲーム画面に表示されない情報を保存しました。投稿ではその区別を次のように述べています。「戦略、計画、検証済みのルールに関する記憶ファイルは、Claudeがそれらを導き出した場合にのみ存在し、Claudeが書き留めない限り消えてしまう」。プレイヤーの所持金やマップ上の位置などは、毎ターン画面から読み取れるため、それらを保存するのは冗長です。
Claude Codeのドキュメントも、自動記憶について同様の線を引いています。自動記憶は、ユーザーの好み、修正、および「コードから導き出せないプロジェクトのコンテキスト」のための場所であると説明されています。コード、README、またはビルドファイルに存在する事実は、必要な時に直接読み取ることができます。それらをコピーしたメモは、ソースから乖離してしまう可能性があります。
Claudeに「記憶の目的」を伝え、「使い方」は伝えない
制御に関する投稿のガイダンスは簡潔です。「Claudeに記憶が何のためにあるかを伝えることは役立つが、それをどう使うかを指示しない方が良いことがわかった」としています。
Anthropicは何を書くべきかについての特定のルールをテストしました。失敗したことだけを記録するようにルールで指示した場合、強力なモデルは記憶によって得られていた利益の多くを失いました。結論として、「強力なモデルにとっては、事前に固定されたルールを設定するよりも、重要性を判断する自由を与える方が効果的であり、それらのルールはかえってパフォーマンスを弱める可能性がある」と述べています。
旧モデルは異なりました。最初に記憶を読み、理論をテストするようにプロンプトを出すことでスコアが上がりました。フロンティアモデル(最先端モデル)について、Anthropicはデフォルトとして、人間が依頼したときや、明らかに覚える価値があるときにメモを作成するという単純なガイダンスを設定しています。
この発見は、エージェントが記憶に何を書き込むかというルールに関するものです。これは、コーディング作業のためにClaudeに与えるプロジェクト指示(project instructions)を評価したものではありません。もしCLAUDE.mdに「特定の種類のメモだけを保存するように」という行を追加している場合、この研究はその行が本当に役立っているかをテストする理由にはなりますが、あなたの環境でそれが害になるという証明ではありません。
なぜ誤った記憶メモが後で信頼されてしまうのか
この発見を注意深く読んでください。投稿ではそのリスクを直接的に述べています。「Claudeはセッション内で重要だと判断したことに基づいて記憶を書き込むため、最初から間違っているメモや、環境の変化に伴って乖離したメモが、後のセッションでClaudeによって読み取られ、信頼されてしまう可能性がある」のです。
ポケモンのプレイ中、Claudeはあるランドマークに対して山の反対側をメモし、その山を探索済みとしてマークしました。その結果、一方通行の段差を飛び降りて、すでに来たルートに戻ってしまうというミスを何度も繰り返しました。
Anthropicがテストした修正策は「Dreaming(ドリーミング)」でした。これは、元のセッションのトランスクリプト(対話記録)に照らしてメモをチェックするパスです。Claudeは誤ったメモをトランスクリプトと比較し、エラーを見つけ、メモを書き直しました。修正されたメモにより、Claudeは洞窟に戻り、次の街に到達することができました。投稿ではその理由をこう説明しています。「トランスクリプトが、記憶を検証するためのグラウンドトゥルース(正解となる根拠)をClaudeに提供したからである」
これがClaude Codeの自動記憶にとって何を意味するか
Claude Codeの自動記憶は、ローカルマシン上のプレーンなファイルです。ドキュメントによると、/memoryを実行してそれらを閲覧でき、「すべてはプレーンなMarkdownであり、読み取り、編集、削除が可能」です。
ドキュメントには、この研究に直接つながる詳細が1つあります。Claude Codeは、cleanupPeriodDaysの保持期間を過ぎた古いセッションのトランスクリプトを削除しますが、「記憶ディレクトリ内の記憶ファイルはその削除対象から除外される」のです。記憶ファイルは、ユーザーまたはClaudeが編集・削除するまで残ります。
これら2つの事実を並べて考えてみてください。メモは、その元となったセッションのトランスクリプトよりも長生きする可能性があります。もしメモが間違っていた場合、それが間違いであることを示す記録はすでに消えているかもしれません。AnthropicのDreamingパスはその記録に依存していました。ローカルの自動記憶の場合、コードやプロジェクトの現在の状態に照らしてチェックするのはユーザーの役割になります。why Claude Code forgets your correctionsのガイドでは、逆に修正がメモに全く反映されないという失敗について解説しています。
なぜ記憶の一部しか毎セッション読み込まれないのか
投稿では階層構造について説明されています。メモはトップレイヤーに昇格させることができ、エージェントのハーネス(制御機構)はすべてのセッションの開始時にそれをコンテキストに読み込みます。これにより、Claudeはそれらを探す必要がなくなります。しかし、投稿はそのレイヤーに制限を設けています。「注入された記憶は貴重なトークンを消費し、不正確なメモがすべてのセッションに持ち込まれる可能性がある」ためです。
また、メモを読み込んだからといってClaudeがそれに従って行動する保証はないとも付け加え、Claude Code自体のドキュメントを引用して、指示ファイルが長くなると遵守率が低下することを指摘しています。結論として、「記憶階層のトップレイヤーは、比較的小さく保つ必要がある」としています。
投稿では、Claude Codeの自動記憶を同じ設計の例として挙げています。ドキュメントには具体的な数値が記されています。「MEMORY.mdの最初の200行、または最初の25KBのいずれか早い方が、すべての会話の開始時に読み込まれる」。さらに、「そのしきい値を超えるコンテンツは、セッション開始時には読み込まれない」と続きます。
残りの内容はトピックファイルに保存され、Claudeは必要に応じてそれらを読み取ります。MEMORY.mdは、それらを指し示すインデックスとして機能します。
Claude Codeは、Claudeが書き込む際にもこの制限を強制します。MEMORY.mdが制限に近づくと、Claude CodeはClaudeに短縮するように促します。制限を超えても書き込み自体は成功しますが、Claude Codeは「制限を超えた部分は次の読み込み時にドロップされるため、インデックスを書き直すように」というエラーをClaudeに返します。
したがって、あらゆるメモにとっての実践的な問いは「それがどこにあるか」です。MEMORY.mdの最初の200行にある行は、セッション開始時にそこにあります。それより下にある行や、トピックファイル内の詳細は、Claudeが探しに行った場合にのみ存在します。Claude Code auto memoryのガイドでは、これらのファイルがどこにあり、どのように機能をオフにするかを説明しています。
これは、自身で作成する指示ファイルにも当てはまります。ドキュメントでは、CLAUDE.mdファイル1つにつき200行未満にすることを推奨しています。なぜなら「ファイルが長くなるとコンテキストをより多く消費し、遵守率が低下する」からです。サブディレクトリのファイルには独自のカットオフがあり、これについてはsubdirectory CLAUDE.md limitのガイドで扱っています。
複数の書き手が1つのページを共有する場合
後半の実験の一つは見落とされがちですが、エージェント間や人間との間で記憶を共有するすべての人に関連があります。Claudeは一連の契約書からWikiを作成しました。複数のエージェントが、契約条件の1つの共有テーブルに同時に書き込みを行いました。AnthropicがそのWikiから作成された要約を採点したところ、57の採点対象事実のうち41しか残っていませんでした。投稿はその理由を突き止めました。共有テーブルの要約が不十分で、一部が欠落していたのは、「エージェントが互いの作業を上書きしてしまったから」でした。
改善された指示では、各契約書に専用のページを与え、単一のエージェントが書き込むようにしました。「共有テーブルに要約するのではなく、条項を逐語的に引用する」ようにしたのです。この変更により、57の事実すべてが要約に反映されました。
1ページにつき1人の書き手にすることで上書きを回避でき、ソースを引用することで要約で削ぎ落とされる可能性のある詳細を保持できます。
Claude Codeのドキュメントには、「同じgitリポジトリ内のすべてのワークツリーとサブディレクトリは、1つの自動記憶ディレクトリを共有する」と記されています。1つのリポジトリの複数のワークツリーで並行してセッションを実行すると、それらはそのディレクトリを共有します。記憶のドキュメントには、同じファイルへの同時書き込みがどのように処理されるかは記載されていないため、並行作業を行った一日の終わりにMEMORY.mdをチェックする価値はあります。AnthropicのManaged Agentsガイドも、書き手の分割について同様のアプローチをとっており、これについてはthe two memory stores in Claude Managed Agentsの記事で解説しています。
Wikiが役立つ時と、そうでない時
投稿では、Wikiを万能な解決策として提示していません。複数のドキュメントからの事実を必要とする質問では、Claudeは検索単体よりもWikiを使用した方が良い結果を出しました。ほとんどの基準が単一のドキュメントから満たせる法務タスクでは、Wikiによる明確な利益は見られませんでした。別のタスクでは、Wikiが元になったドキュメントよりも大きくなってしまいました。そのケースに対する投稿の評決は、「Claudeは、実質的に何も抽象化されていない、極めて詳細なWikiを作成してしまった」というものでした。また、すべてのメモをチェックすると計算コストがかかる中で、いかにして記憶の正確性を保つかといった未解決の課題もリストアップされています。
人々が最初に試してしまうこと
念のためすべてを保存する。 古くなった巨大な記憶は、検索に時間がかかり、誤解を招く可能性があります。
何を保存すべきかについて厳格なルールを書く。 強力なモデルの場合、固定されたルールはパフォーマンスを弱める可能性があることがAnthropicによって判明しました。
記憶にあるからという理由でメモを信頼する。 メモは最初から間違っている可能性があり、Claudeはそれを後で読み取って信頼してしまうことがあります。
MEMORY.mdを肥大化させる。 最初の200行または25KBを超えた部分は、セッション開始時に読み込まれません。
解決策:読み込まれるレイヤーを小さく、検証可能に保つ
ステップ 1: 自動記憶が保存した内容を確認する
/memoryを実行するか、自動記憶フォルダを開いて、MEMORY.mdとトピックファイルを読みます。各エントリをコードやプロジェクトの現在の状態と照らし合わせ、正しくなくなったものは修正または削除します。トランスクリプトはスケジュールに従ってクリーンアップされるため、元のセッションを見つけられるとは限りません。
ステップ 2: MEMORY.mdを制限内のインデックスに保つ
MEMORY.mdのエントリは1行に抑え、詳細はトピックファイルに移動します。すべてのセッションの開始時にClaudeが必要とするエントリを上部付近に配置します。Claudeがコードから読み取れる内容をコピーしているものは削除します。
ステップ 3: 各ページに1人の書き手を割り当て、決定事項を引用する
複数のセッションやチームメイトが同じメモに追加を行う場合は、各主題に専用のページを与えます。事実がドキュメント、チケット、または決定記録に由来する場合は、要約するのではなく正確な文言をコピーします。
MemoryLakeでのセットアップ
Anthropicの投稿は、エージェントがその瞬間に重要だと思われることに基づいて、自身のために書き込む記憶について述べています。それとは別に、異なる性質を持つもう一つの記憶があります。それは、あなた自身が確認した決定事項や規約です。書き込んだ時点でそれが正しいとわかっており、それを複数のツールや複数のマシンで利用したい場合があります。Claude Codeのドキュメントによると、自動記憶はマシンローカルです。
MemoryLakeは、それらの確認済みエントリを、あなたが管理する一つの場所に保持するための記憶レイヤーです。ChatGPT、Claude Code、Codexなど、接続したアシスタントから利用できます。
エントリはあなた自身が自分の言葉で書き込みます。あなたのMEMORY.md、自動記憶のトピックファイル、CLAUDE.mdファイル、Claudeのチャット、あるいはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。Claude Codeの自動記憶は、Anthropicが説明した通りの仕組みで動作し続けます。
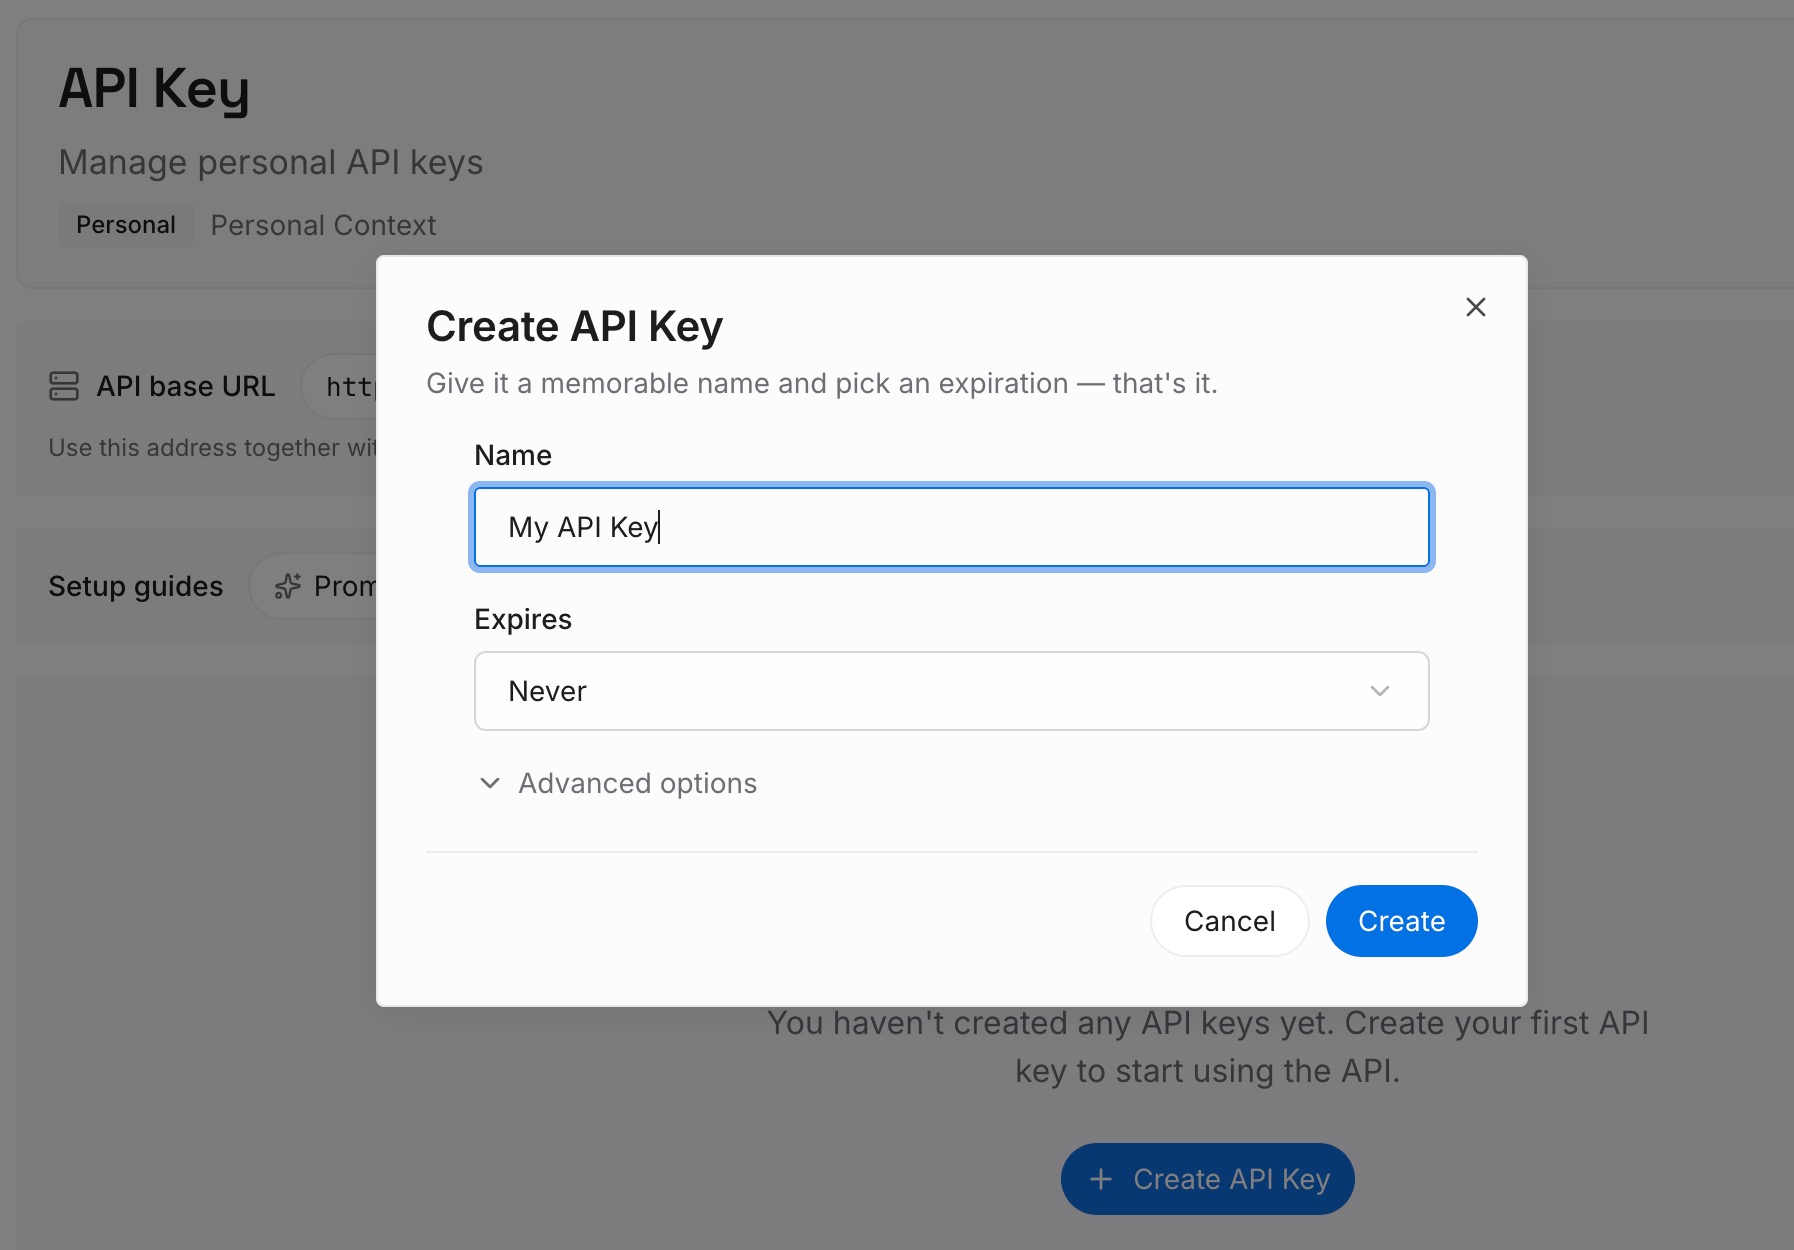
ステップ 1: APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーはMemoryLakeワークスペースに属するもので、Anthropicのアカウントとは別物です。
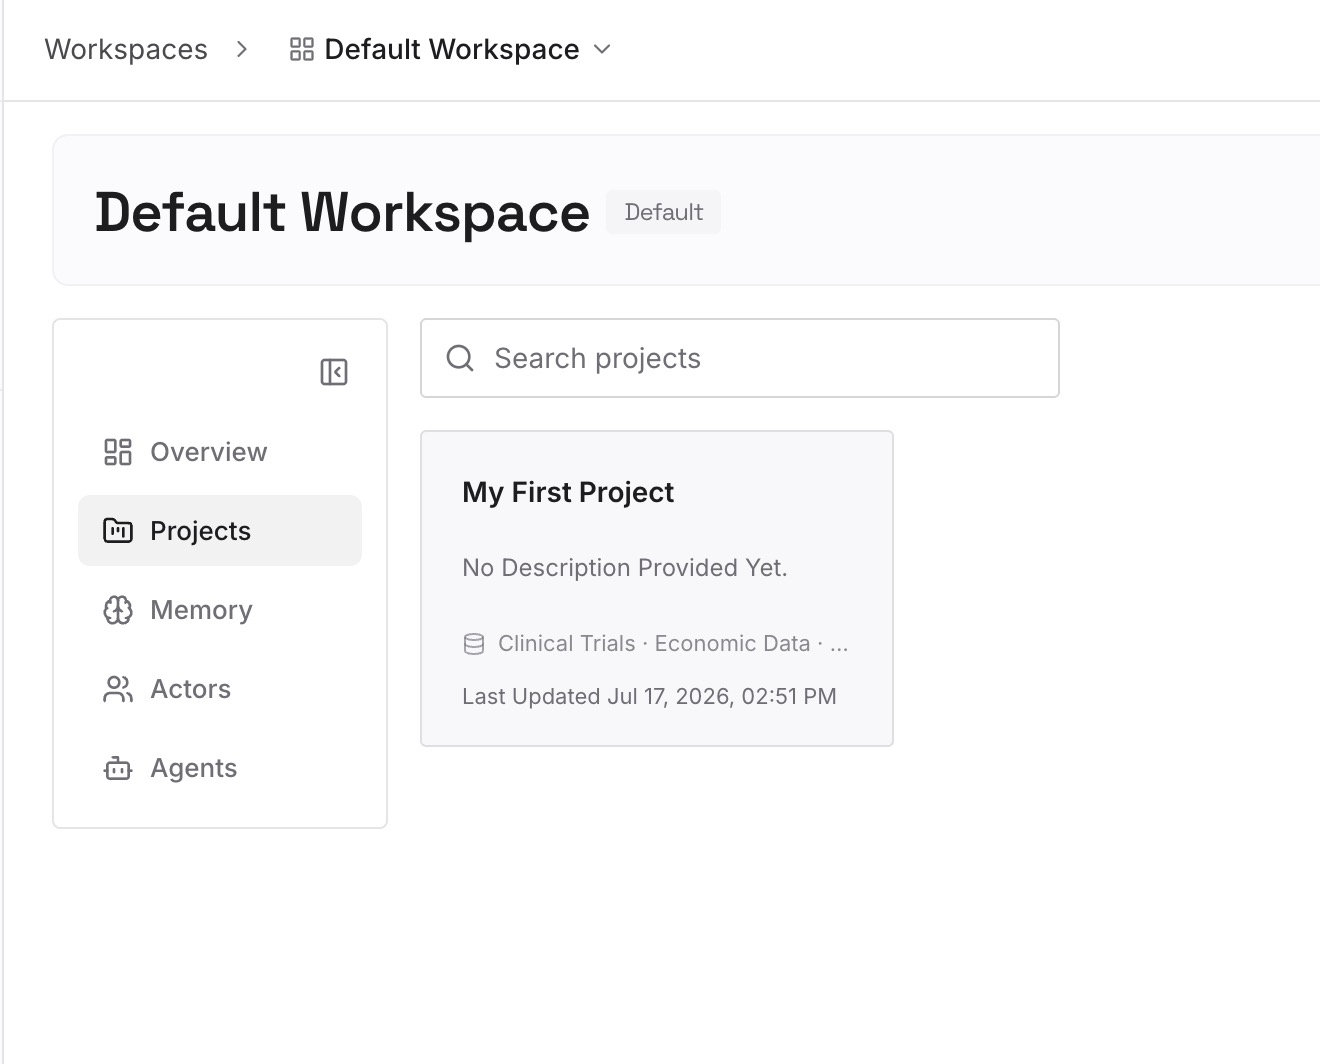
ステップ 2: 最初の記憶をアップロードする
上記のステップ1でチェックし、現在も正しいと確認したエントリから始めます。1つのエントリにつき1つの決定事項とし、ソースを逐語的に引用し、確認した日付を添えます。
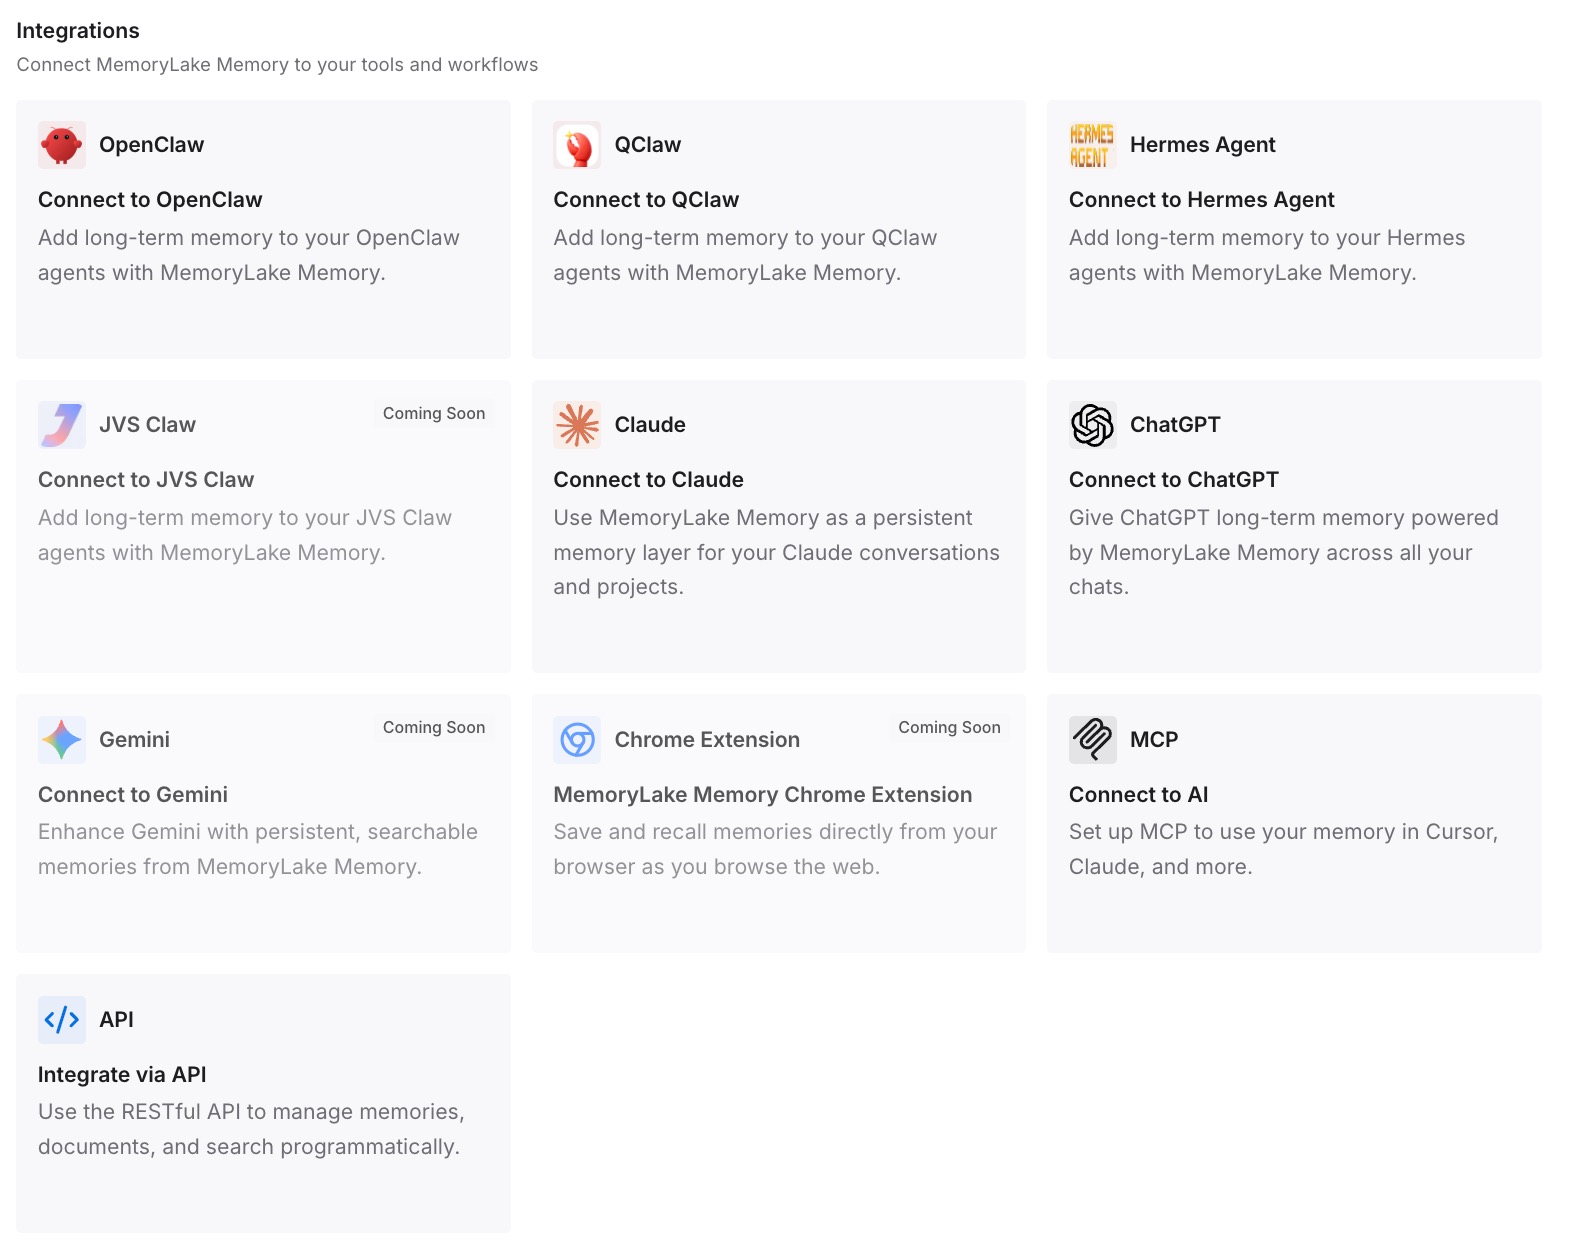
ステップ 3: AIとエージェントを接続する
Claude Codeや、使用している他のアシスタントを接続します。同じ確認済みのエントリが、各マシンおよび各ツールで利用可能になります。
実践で何が変わるか
第一の違いは、インデックスが短くなることです。MEMORY.mdにはポインタ(参照)と、すべてのセッションが必要とする少数の事項だけを保持し、確認済みの決定事項は検索可能な場所に置くことができます。
第二に、真実のソース(source of truth)が明確になります。自動記憶のメモと確認済みのエントリが矛盾する場合、どちらを自分がチェックした後に書いたかがわかります。
第三に、重要な事項に対して書き手が一人になります。あなたが確認した決定事項には、単一の著者が存在することになります。
Claude記憶ファイルのベストプラクティス
Claudeが他で読み取れないものを保存する。 戦略、決定事項、検証済みのルールは記憶に属します。コード内の事実は属しません。
ルールをその証拠と共に書く。 ルール、それが真であると知った経緯、そして回避すべき落とし穴をセットにすると、後でチェックしやすくなります。
メモをソースと照らし合わせてチェックする。 誤ったメモが後のセッションで信頼されてしまう可能性があります。
トップレイヤーを小さく保つ。 MEMORY.mdの最初の200行または25KBだけがセッション開始時に読み込まれます。
1ページにつき1人の書き手を優先する。 複数の書き手による共有ページは、事実が失われる可能性があります。
重要な用語は要約せず、引用する。 正確な文言は詳細を損ないません。
結論
Anthropicの投稿は、独自の評価を用いて、Claudeが何を記憶するかをどのように決定するかを説明しています。メモは予測です。強力なモデルは、固定されたルールを与えるよりも、記憶の目的を伝えた方が良い結果を出します。最初から間違っているメモも後のセッションで読み取られ信頼される可能性があるため、Anthropicは元のトランスクリプトに対するDreamingをテストしました。そして、毎セッション読み込まれるレイヤーは意図的に小さく保たれており、Claude CodeにおいてはMEMORY.mdの最初の200行または25KBを意味します。
自身のセットアップにおいては、3つの習慣に集約されます。自動記憶が保存した内容をソースと照らし合わせてチェックすること、MEMORY.mdを重要なエントリを上部に配置した短いインデックスに保つこと、そして重要な事実には一人の書き手と正確な文言を与えることです。