
Pineconeとは
- クラウドネイティブなベクトルデータベース: Pineconeは、インフラ管理の必要性を排除し、高次元の密ベクトル埋め込みを大規模に保存およびクエリするために特別に設計された、フルマネージドのサーバーレスプラットフォームです。
- 類似性検索に最適化: 高次元空間で数学的に類似したデータポイントを見つけることに優れており、これが標準的な検索拡張生成(RAG)アプリケーションの核心的なバックボーンを形成しています。
- ステートレスな外部ストレージ: PineconeはAIの外部知識ドライブとして機能します。ベクトルクエリに基づいてドキュメントを検索しますが、会話の状態、ユーザーの進捗、または時間の経過とともに変化する事実をネイティブに追跡することはありません。
- 開発者フレンドリーな統合: 大規模言語モデル(LLM)によって生成されたベクトルを取り込み、大規模なデータセットに対して高速な最近傍検索を実行するための、高度に合理化されたAPIを開発者に提供します。
なぜAIエージェントメモリにPineconeの代替ツールを探すのか
- 基本的なベクトル検索の限界: 現代のAIエージェントは、単に類似したテキストチャンクを取得する以上の機能を必要としています。インテリジェントに動作するためには、構造化され永続化されたコンテキスト、時間的推論、そして複雑なエンティティ間の関係マッピングが必要です。
- 状態管理における非効率なコストスケーリング: 純粋なベクトルデータベースにおいて、ステートフルな会話メモリを継続的に更新、統合、上書きすることは、法外なAPIコストと非常に非効率な計算リソースの消費につながる可能性があります。
- ネイティブな競合解決の欠如: 標準的なベクトルストアは、矛盾する事実を自動的に解決しません。ユーザーの好みが変わった場合、開発者がカスタムロジックを構築しない限り、データベースは古い事実と新しい事実の両方を盲目的に返してしまう可能性があります。
- より高レベルな抽象化の必要性: 開発者は、生のベクトル埋め込みを手動で調整するよりも、要約、データ抽出、認知状態の管理を自動的に処理するインテリジェントなメモリエンジンをますます好むようになっています。
Pinecone代替ツールに求めるべき要素
- 永続的なコンテキスト管理: 理想的な代替ツールは、やり取りの論理的な流れを失うことなく、継続的なセッションにわたって関連する事実を自動的に保存、整理、そしてインテリジェントに呼び出すことができる必要があります。
- 認知およびマルチモーダル機能: ドキュメント、生のテキスト、表など、さまざまなデータ形式をシームレスに処理し、それらを統合されたナレッジグラフや認知状態に変換できるシステムを探しましょう。
- 自動化されたメモリ統合: プラットフォームは、トークンの使用量を低く抑えつつピンポイントの精度を維持するために、古い会話履歴をインテリジェントに圧縮し、矛盾する情報を能動的に解決する必要があります。
- 摩擦のない統合エコシステム: 既存のAIワークフローに即座に組み込めるよう、使いやすいSDK、包括的なREST API、またはModel Context Protocol(MCP)統合が提供されていることを確認してください。
2026年におけるAIエージェントメモリ向けPinecone代替ツールベスト10
各プラットフォームの詳細な分析に入る前に、AIエージェントメモリ向けにカスタマイズされた上位10個の代替ツールの比較概要を以下に示します。
| 製品 | 最適な用途 | コア技術 | 価格モデル |
|---|---|---|---|
| 1. MemoryLake | 包括的なAIエージェントメモリ | 永続的なマルチモーダルコンテキスト | 月額$19 |
| 2. Weaviate | スケーラブルなベクトル検索 | オープンソースのベクトルDB | 月額$45 |
| 3. Redis | リアルタイムAIアプリケーション | インメモリデータストア | カスタム |
| 4. LanceDB | 組み込み型ベクトルワークロード | 列指向ベクトルDB | 従量課金制 |
| 5. Neo4j | マルチホップグラフ推論 | グラフデータベース | 月額$65 |
| 6. LlamaIndex | データオーケストレーション | データフレームワーク | 月額$50 |
| 7. Mem0 | パーソナライズされたAIインタラクション | ハイブリッドメモリレイヤー | 月額$19 |
| 8. Zep | 対話型チャットボット | 長期メモリAPI | 月額$125 |
| 9. Supermemory | AIの第二の脳 | ユニバーサルメモリエンジン | 月額$19 |
| 10. Mnemoverse | ツールをまたぐコンテキスト | MCPベースのメモリAPI | 月額$29 |
1. MemoryLake
MemoryLakeは、AIエージェントやアプリケーションが会話、タスク、セッションをまたいでコンテキストを維持できるように設計された永続メモリインフラストラクチャです。すべてのインタラクションをゼロからのスタートとして扱うのではなく、AIシステムが時間の経過とともに関連情報を保存、整理、検索、再利用できるようにします。これには、ユーザーの好み、過去のやり取り、重要な事実、タスクのコンテキスト、その他の長期的な知識が含まれます。MemoryLakeは、パーソナルアシスタントやカスタマーサポートエージェントから、AI駆動のワークフロー、マルチエージェントシステム、インタラクティブなバーチャルキャラクターまで、幅広いAIアプリケーションに適しています。永続的で構造化されたメモリに焦点を当てているため、開発者はより一貫性のあるAI体験を容易に構築できます。
主な機能
- インテリジェントな競合解決: 新しい事実が古い事実と矛盾する場合に自動的に検出し、データを重複させることなくAIの理解を更新します。
- マルチモーダル処理: 複雑なドキュメント、PDF、Excelシート、非構造化テキストからコンテキストをネイティブに理解し、抽出します。
- 完全なメモリの追跡可能性: バージョン管理のようなプロベナンス(起源追跡)で動作するため、呼び出されたすべての事実を正確な元のソースまで遡ることができます。
メリット
- すべてのAIプラットフォームやセッションにわたるコンテキストの喪失を排除します。
- 検索されたデータを圧縮および構造化することで、LLMのトークンコストを大幅に削減します。
- ゼロトラストアーキテクチャにより、最高水準の暗号化でデータのプライバシーを保証します。
デメリット
- 単純なステートレスRAGパイプラインのみを必要とするプロジェクトにとっては、機能が過剰(包括的すぎる)な場合があります。
- 従来のベクトルDB管理から、認知メモリ管理へのマインドセットの転換が必要です。
価格
フリーミウム。Proプランは月額$19から。
2. Weaviate
Weaviateは、データオブジェクトとそれに対応するベクトル埋め込みの両方を保存するために構築された、堅牢なオープンソースのベクトルデータベースです。高度なベクトル検索をすぐに利用できるサポートを提供することで、開発者がスケーラブルなAIアプリケーションを構築できるようにし、高い信頼性を必要とするエンタープライズRAGアーキテクチャで人気の選択肢となっています。
主な機能
- ハイブリッド検索: 密なセマンティック検索とキーワードベースのBM25アルゴリズムをシームレスに組み合わせ、最適な検索精度を実現します。
- モジュール式アーキテクチャ: さまざまなベクトル化モデルやLLMプロバイダーとの統合を、データベースエンジン内で直接サポートします。
- マルチテナンシーのサポート: 同一のデータベースクラスター内で、異なるユーザーやエージェントのデータを効率的に分離します。
メリット
- 大規模なエンタープライズレベルのデータセットに対して高度なスケーラビリティを備えています。
- 非常に柔軟なデプロイオプション(クラウド、オンプレミス、組み込み)を提供します。
- 活発なオープンソースコミュニティと優れたドキュメントが存在します。
デメリット
- セルフホストを選択する場合、大幅なインフラ管理が必要になります。
- ネイティブで高レベルな「エージェントメモリ」のロジックを欠いており、開発者自身が状態管理を構築する必要があります。
価格
月額$45。
3. Redis
もともと超高速なインメモリのキーバリューストアとして世界的に知られていたRedisは、進化を続けています。Redis Stackの導入により、現在は強力なベクトル検索機能が含まれるようになりました。この変革により、Redisは即時のデータ検索と最小限のレイテンシを求めるAIアプリケーションにとって、非常に実用的なリアルタイムデータベースとなっています。
主な機能
- インメモリの速度: リアルタイムのベクトルクエリや会話メモリの更新に対して、ミリ秒未満のレイテンシを実現します。
- 多才なデータ構造: ハッシュ、JSONドキュメント、ベクトルインデックスをすべて1か所に保存できます。
- 高度なフィルタリング: メタデータに基づいた、ベクトル検索の複雑な事前フィルタリングおよび事後フィルタリングをサポートします。
メリット
- エージェントのやり取りにおいて、比類のない動作速度と低レイテンシを提供します。
- 高スループットなエンタープライズ環境で非常に広く普及し、実証されています。
- 既存のRedisユーザーにとって馴染みのある構文であり、導入が容易です。
デメリット
- RAMへの依存度が高いため、非常に大規模なアーカイブデータセットを保存するにはコストがかかる選択肢となります。
- 汎用データベースであり、AI専用に構築された認知メモリエンジンではありません。
価格
カスタム価格。
4. LanceDB
LanceDBは、ベクトル検索用に特別に設計された、開発者フレンドリーなオープンソースの列指向データベースです。Arrowフォーマットに基づいて構築されており、アプリケーションに直接組み込んで実行するか、サーバーレスのクラウドインスタンスとして実行できるというユニークな特徴を持っています。シンプルさ、速度、そして現代のデータサイエンスワークフローとのシームレスな統合を最優先しています。
主な機能
- 組み込み型デザイン: アプリケーションのプロセス内で直接実行されるため、個別のデータベースサーバーを管理する必要がありません。
- マルチモーダル機能: テキスト、画像、音声などの複雑なデータタイプをネイティブかつシームレスに処理します。
- ゼロコピー検索: 列指向データフォーマットを活用し、データを移動させることなく超高速な分析クエリを実行します。
メリット
- 組み込み版はセットアップ不要でデプロイできるため、導入の摩擦が劇的に軽減されます。
- 分析クエリとベクトルワークロードの両方において非常に高いパフォーマンスを発揮します。
- Pythonのデータエコシステム(Pandas、PyArrow)と完璧に統合します。
デメリット
- 歴史のあるデータベースと比較して、コミュニティやエコシステムがまだ小規模です。
- より高レベルなエージェントメモリの抽象化機能は、まだ発展途上です。
価格
従量課金制。
5. Neo4j
Neo4jは世界をリードするグラフデータベースであり、GraphRAGの概念を通じてAI革命をうまく取り入れています。データをフラットなベクトルではなく、相互に接続されたノードとリレーションシップとして保存することで、標準的なベクトルストアが苦手とする複雑なマルチホップ推論タスクをAIエージェントが実行できるようにします。
主な機能
- グラフモデリング: データポイント、エンティティ、過去の事実の間の複雑な論理的関係を明示的にマッピングします。
- Cypherクエリ言語: 相互に接続されたデータに対して、強力で表現豊かなクエリメカニズムを提供します。
- ベクトル検索の統合: ネイティブなグラフ探索と組み込みのベクトル検索を組み合わせ、双方の長所を活かします。
メリット
- マルチホップ推論や論理的なAIワークフローに優れたアーキテクチャです。
- 高度に視覚化されたデータ表現により、エージェントの知識のデバッグが容易になります。
- エージェントのメモリ内に隠されたつながりを発見するのに最適です。
デメリット
- グラフモデリングに慣れていない開発者にとっては、学習曲線が急です。
- シンプルな対話型エージェントにとっては、機能過剰(オーバーキル)でリソースを消費しすぎる可能性があります。
価格
月額$65。
6. LlamaIndex
LlamaIndexは、従来のスタンドアロンデータベースではなく、強力なデータオーケストレーションフレームワークです。カスタムデータソースとLLMの間の究極の架け橋として機能し、インデックス作成、ルーティング、情報検索といった複雑なタスクを処理して、AIエージェントが必要なコンテキストを正確に取得できるようにします。
主な機能
- 豊富なデータコネクタ: API、PDF、SQLデータベースなど、何百もの異なるソースからデータを簡単に取り込みます。
- 高度なインデックス構造: タスクに応じて、ツリー、リスト、キーワード、ベクトルインデックスなど、多様なインデックスオプションを提供します。
- メモリ(記憶)モジュール: 対話型エージェント向けに、組み込みのチャットメモリバッファと要約ロジックを搭載しています。
メリット
- 洗練された多様なRAGパイプラインを迅速に構築するのに非常に優れています。
- 巨大なエコシステムと、信じられないほど活発なオープンソースコミュニティに支えられています。
- 非常に柔軟性が高く、開発者は基盤となるベクトルデータベースを簡単に切り替えることができます。
デメリット
- 主にオーケストレーションレイヤーとして機能するため、基盤となるデータベースを別途用意する必要があります。
- 機能が非常に多岐にわたるため、シンプルなユースケースでは不要な複雑さを招く可能性があります。
価格
月額$50。
7. Mem0
Mem0は、AIアシスタントにパーソナライズされた長期メモリを提供するために特別に構築された、特化型のインテリジェントなメモリレイヤーです。初期のオーケストレーションツールから進化し、ユーザーのやり取りを能動的に管理することで、手動の介入なしにAIエージェントが時間の経過とともによりスマートに、より適応的に、そしてよりパーソナライズされるようにします。
主な機能
- 自動化されたユーザープロファイリング: 終わりのないセッションにわたって、個々のユーザーの好みをインテリジェントに抽出して記憶します。
- ハイブリッドデータストアアーキテクチャ: グラフストレージとベクトルストレージ技術を組み合わせて使用し、豊かな文脈的関係を提供します。
- ドロップイン統合: わずか数行のコードで、開発者はアプリケーションに永続メモリを追加できます。
メリット
- 既存のLLMアプリケーションへの統合が非常に簡単です。
- AIアプリのユーザーパーソナライズとユーザー維持率(リテンション)を大幅に向上させます。
- オープンソースであるため、データを完全に制御できます。
デメリット
- 確立されたインフラの巨人に比べると、まだ比較的歴史の浅いプレイヤーです。
- 非常に特殊なエンタープライズの例外的なユースケースにおいては、深いカスタマイズがわずかに制限される可能性があります。
価格
月額$19。
8. Zep
Zepは、AIアシスタント向けに明示的に調整された長期メモリストアです。対話型AIのバックグラウンドで静かに動作し、事実を自動的に抽出し、古い対話を要約し、クリーンな会話履歴を維持することで、エージェントが議論の文脈を見失わないようにします。
主な機能
- 自動要約: トークンコストを節約しながらコンテキストを維持するために、古いチャット履歴を自動的に圧縮します。
- エンティティおよび事実の抽出: リアルタイムの対話から、主要なエンティティや不変の事実を特定、抽出、保存します。
- ベクトル検索を内蔵: 堅牢なメモリ管理ツールと並行して、基本的なセマンティック検索を処理します。
メリット
- 関連性のある凝縮された要約のみを注入することで、トークンの使用量を劇的に削減します。
- チャットボットアプリケーションに対して、すぐに使える即時のコンテキストを提供します。
- 要約を非同期で処理することにより、レイテンシを削減します。
デメリット
- 複雑なタスク駆動型のワークフローよりも、対話型チャットボットに非常に強く偏っています。
- 保存されたメモリの分析および視覚化機能は、やや基本的です。
価格
月額$125。
9. Supermemory
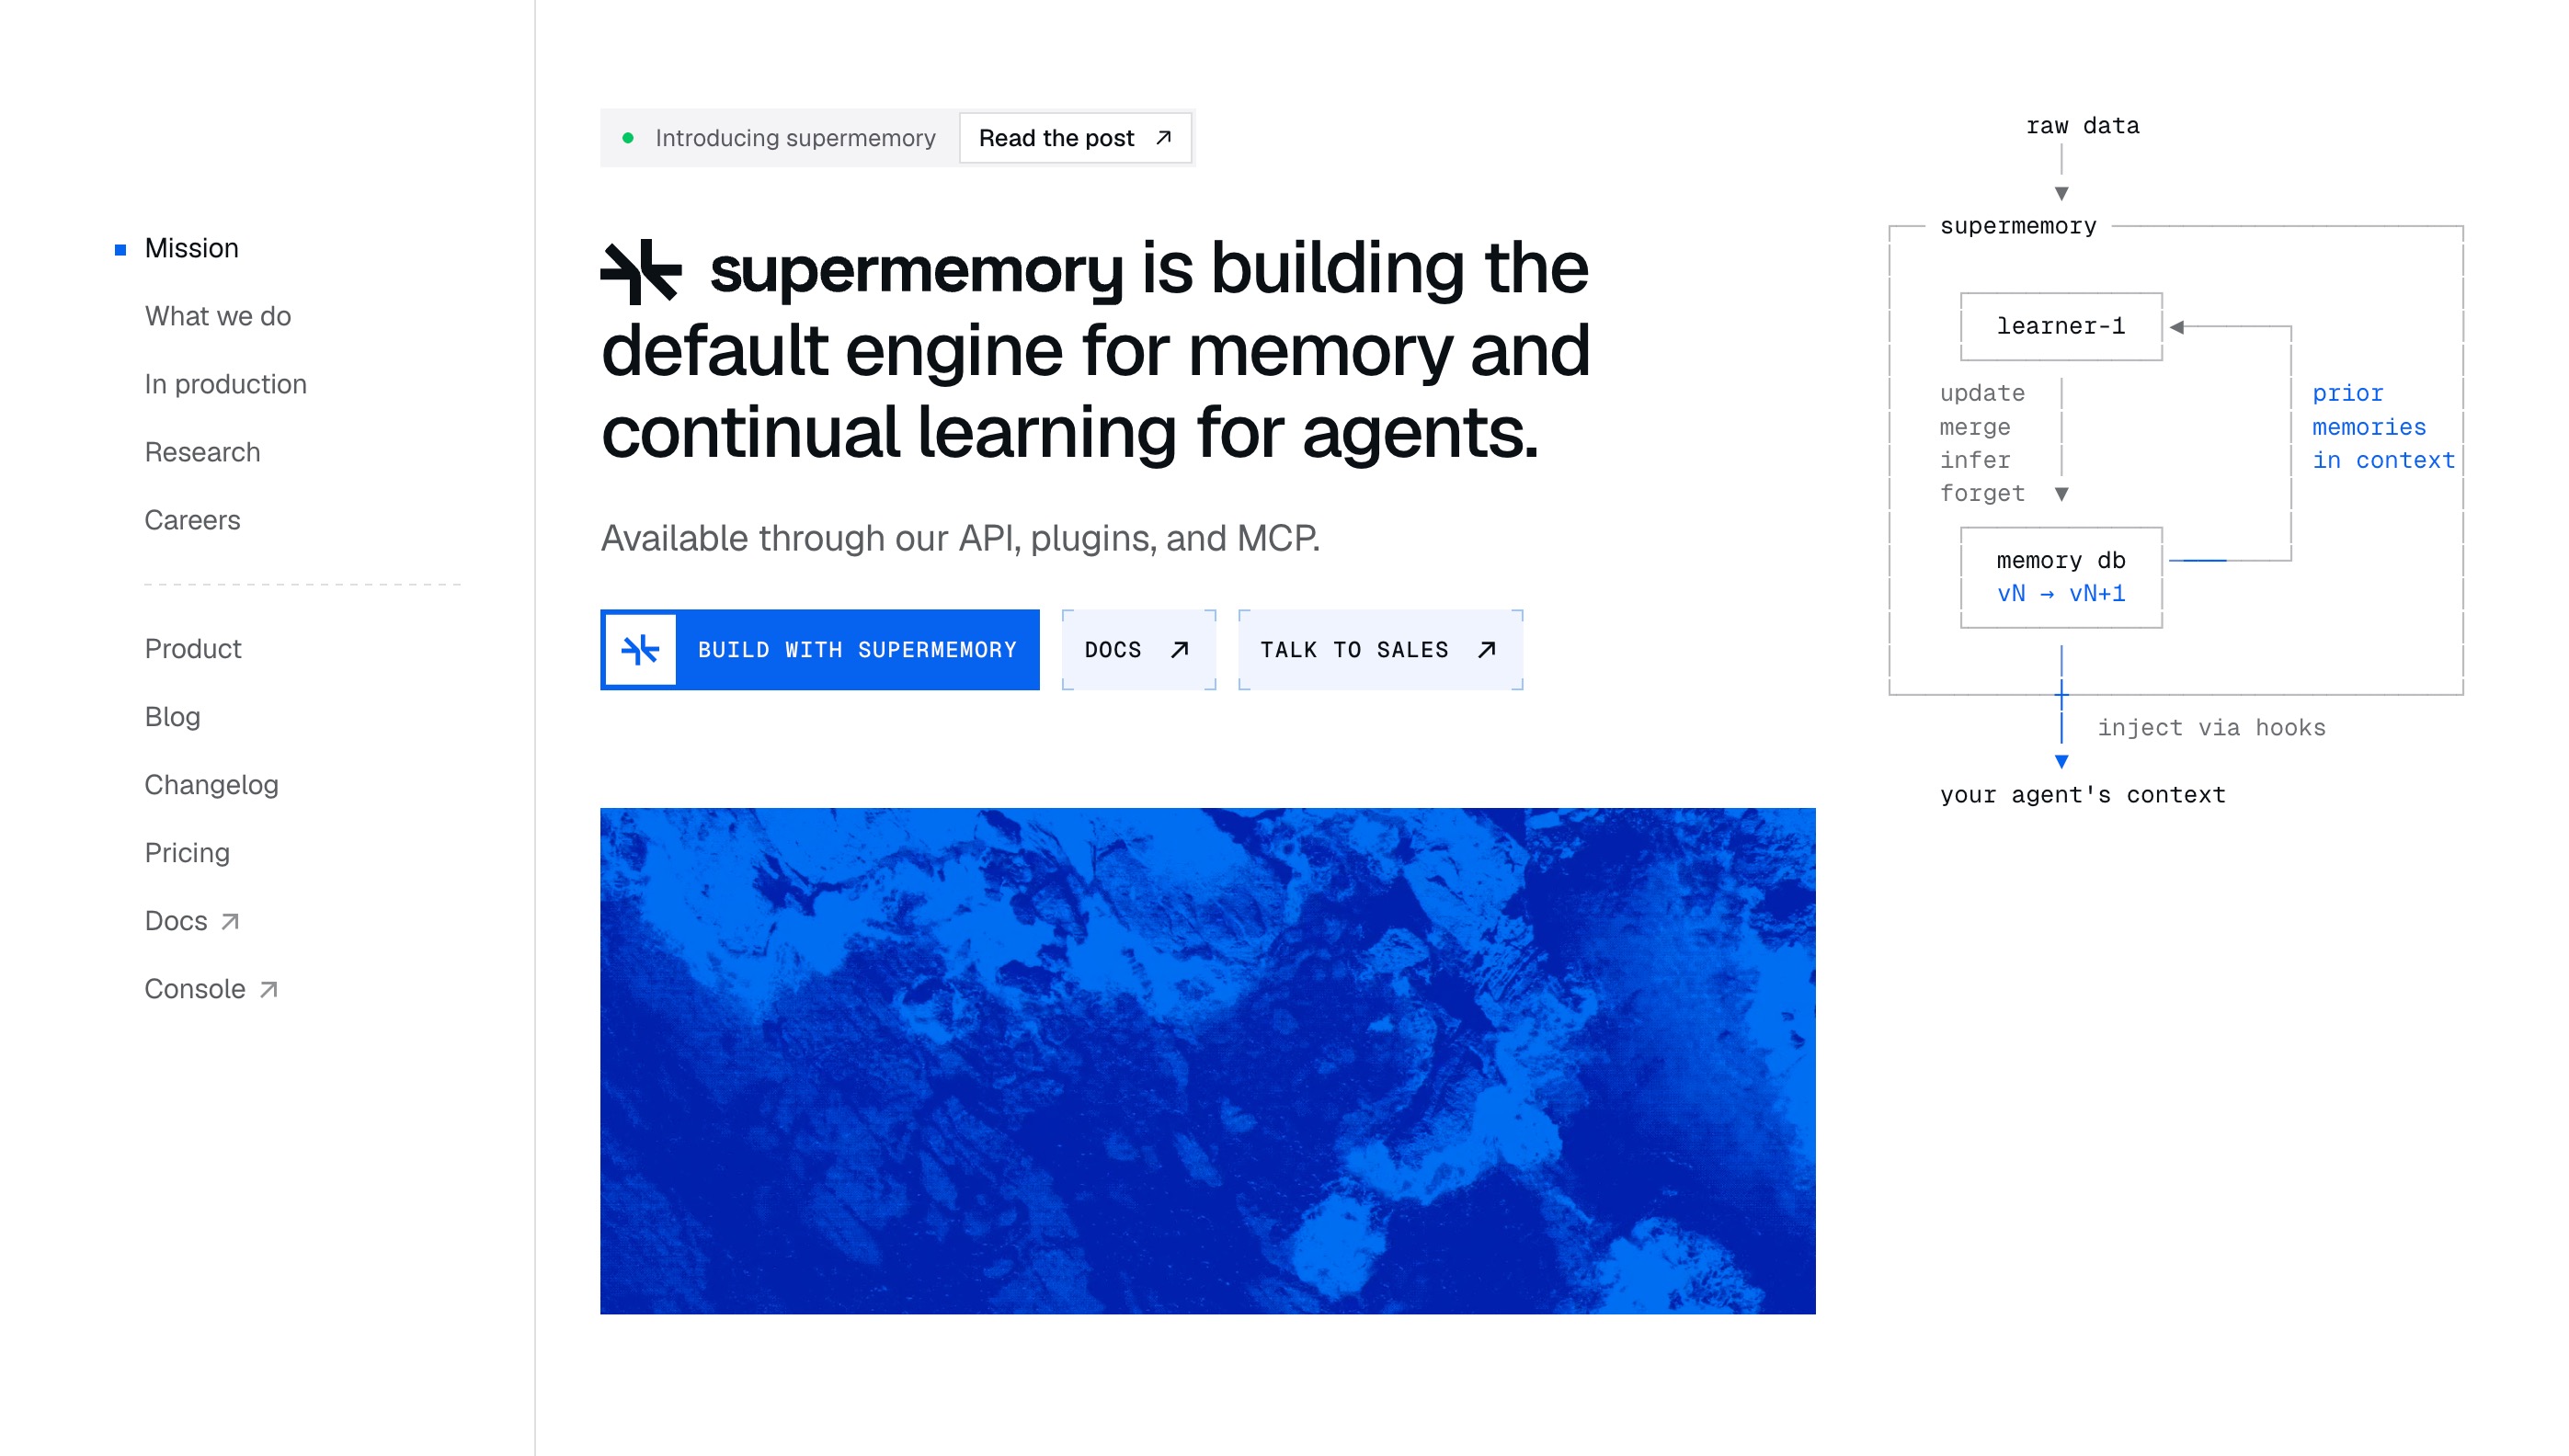
Supermemoryは、オープンソースのAI「第二の脳」およびユニバーサルメモリAPIとして機能します。AIエージェントがさまざまなコンテキストから保存された知識をインテリジェントに整理し、即座に検索できるようにします。整理されていないファイル、チャット、リンクを、検索性が高くポータブルな認知エンジンへと変換します。
主な機能
- ユニバーサルメモリAPI: 複数の異なるAIアプリケーションや拡張機能を、単一の統合されたメモリソースに接続します。
- 文脈的理解: 検索精度を向上させるために、保存されたメモリ間の時間的および因果関係を能動的に評価します。
- マルチプラットフォーム拡張機能: データをAIの脳に直接保存するためのブラウザ拡張機能やツールが付属しています。
メリット
- 個人のAIツールとプロフェッショナルなナレッジベースの両方を構築するのに非常に多才です。
- オープンソースアーキテクチャにより、コミュニティ主導のプラグインや継続的な改善が促進されます。
- 「第二の脳」スタイルのアプリケーションを構築するのに最適です。
デメリット
- セルフホスト版をセットアップして維持するには、多少の技術的知識が必要です。
- プロジェクトの規模拡大に伴い、ドキュメントはまだ成長段階にあります。
価格
月額$19。
10. Mnemoverse
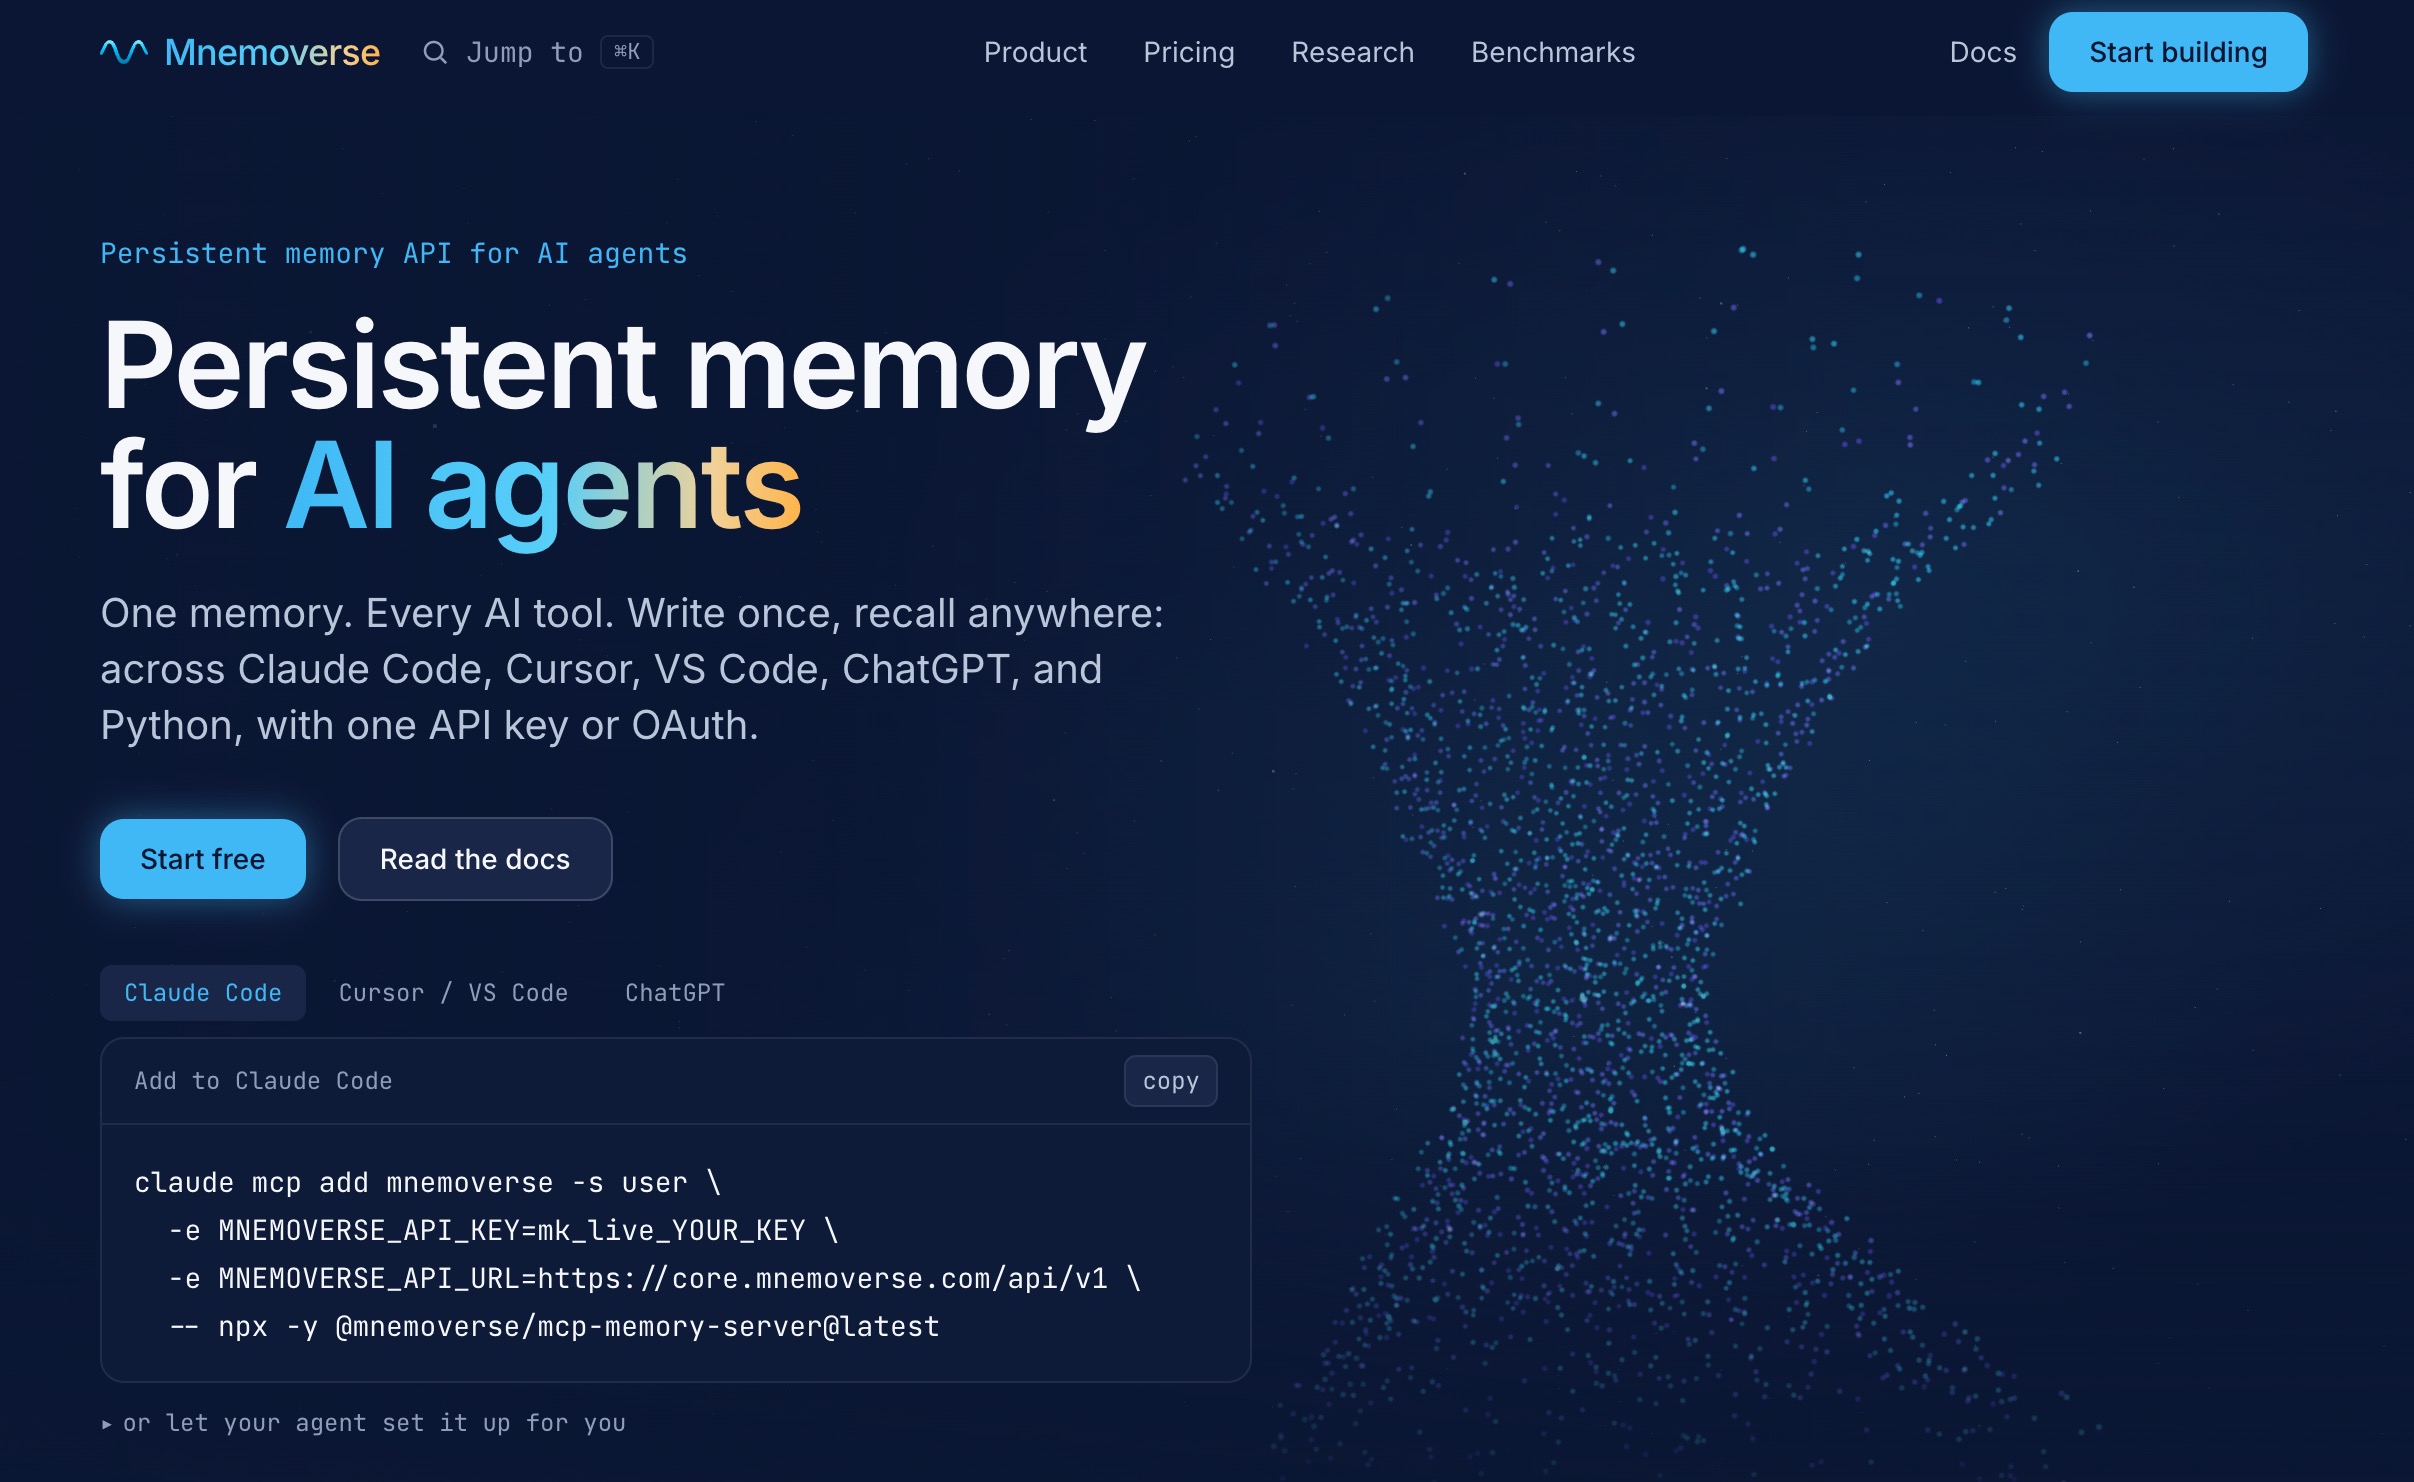
Mnemoverseは、現代のAIエージェント向けに調整された、永続的でツールをまたぐメモリインフラストラクチャを提供します。Model Context Protocol(MCP)を利用することで、コードエディタであれチャットインターフェースであれ、AIワークフローがまったく同じコンテキスト理解を共有できるようにするユニバーサルメモリレイヤーとして機能します。
主な機能
- ツールをまたぐコンテキスト: 単一のAPIキーを介して、Claude、ChatGPT、Cursorなどの主要なAIプラットフォーム間でシームレスに動作します。
- 動的な重要度スコアリング: 暗黙的および明示的なユーザーフィードバックに基づいて、メモリの関連性を自動的にランク付けし、調整します。
- ライブMCP統合: 公式のMCPレジストリを通じて摩擦のないセットアップが可能で、現代のAIクライアントですぐに利用できます。
メリット
- 異なるAIアプリケーション間のデータサイロを破壊し、真の「メモリパスポート」体験を提供します。
- すでにMCPエコシステムを使用している開発者にとって、信じられないほど摩擦のないセットアップが可能です。
- 単なる静的なストレージではなく、適応型学習に重点を置いています。
デメリット
- 有用性は、MCP標準の業界全体での普及状況に多少依存します。
- 高度な学習機能は、彼らのマネージドクラウドインフラストラクチャに依存する必要があります。
価格
月額$29。
適切なPinecone代替ツールの選び方
AIエージェント用のメモリバックエンドを選択する際、決定は具体的なアーキテクチャのニーズに帰着します。唯一の目的が、標準的なRAGパイプライン用に基本的なドキュメント埋め込みを保存することである場合、WeaviateやLanceDBのような堅牢なデータベースは、優れた、高度にスケーラブルなオープンソースの選択肢を提供します。複雑なエンティティ関係やマルチホップの論理的推論を扱う場合、Neo4jは事実上無敵です。車輪の再発明をすることなく、チャットボット用のドロップイン会話メモリを求める開発者にとっては、ZepやMem0のような専用に構築されたラッパーが非常に便利です。
しかし、マルチモーダルなコンテキストをネイティブに処理し、事実の競合を能動的に解決し、シームレスなセッション間の連続性を保証する、完全でインテリジェントなメモリインフラストラクチャが必要な場合、MemoryLakeが究極の選択肢として際立っています。生のデータストレージと真の認知AI理解との間のギャップを埋め、開発者を状態管理の重労働から解放すると同時に、LLMの推論コストを劇的に削減します。
最終的な結論
標準的なベクトルデータベースがAIをここまで進化させてきましたが、自律型エージェントの未来には洗練された認知レイヤーが必要です。Neo4j、Weaviate、Mem0などのツールはすべて、異なるニッチにおいて素晴らしい機能を提供しています。しかし、自然に記憶し進化する、高度でコンテキストを認識するAIアプリケーションの構築を目指すチームにとって、MemoryLakeは決定的な勝者です。メモリを単なるストレージとしてではなく、インテリジェントで競合を解決するインフラストラクチャとして扱うことで、MemoryLakeは開発者が真に永続的で信頼性が高く、コスト効率に優れたAI体験を構築できるようにします。