
TokenEconomizer とは何か
Microsoft の説明によれば、「TokenEconomizer は、エージェントやその基礎となるモデルを変更することなく、リポジトリにおけるエージェントの過去のセッションから学習し、将来のセッションでの無駄を削減するオープンソースプラグイン」です。
これはプラグインであり、Claude Code や Codex の機能ではありません。 Anthropic も OpenAI もこれを標準搭載していません。既に使用しているエージェントに追加するものであり、エージェント自体は変わりません。プロジェクトの README によると、これは Claude Code、Codex、GitHub Copilot CLI、および Pi のためのプラグインであり、他のいくつかのエージェントについても実験的にサポートしています。
リポジトリごとに学習します。 学習の単位は、繰り返し戻ってくるコードベースです。ブログでは、独自の測定結果をもとにその理由を説明しています。一つのリポジトリ内での繰り返しの行動は、他のリポジトリの履歴との一致よりもはるかに一般的でした。一つのプロジェクトでの経験は、主にそのプロジェクトに役立つのです。
したがって、見出しの質問に対する正直な答えは限定的です。Claude Code や Codex が自ら再学習することはありません。しかし、このようなプラグインがセッションで何が起こるかを監視し、次のセッションの開始状態を変更することは可能です。
学習内容:3種類のレッスン
ブログでは3つのメカニズムが説明されています。それぞれが過去のセッションを異なる種類のレッスンに変換します。
マイクロスキル(Micro-skills):リポジトリの仕組みに関する事実。 README では、これらを「セッションが再発見し続けるもの」と表現しています。例えば、「最初に実行しなければならないビルドステップ、ここで機能するコマンドのスペル」、コマンドが必要とする環境変数、あるいは生成されたファイルの場所などです。ブログでは、これらを一行のメモによるリポジトリ固有の知識と呼んでいます。
ツールの整理(Tool pruning):このリポジトリでは決して必要のないツール。 ロードされたすべてのツールの説明は、すべてのリクエストとともに送信されます。履歴からツールが使用されていないことが判明した場合、プラグインはエージェント自身の設定を通じて、以降のセッションからそのツールを除外します。コマンドの実行やファイルの編集のためのコアツールは常に保持されます。
失敗ループへの介入(Failure-loop intervention):ターンが行き詰まったとき。 エージェントが同じ失敗を繰り返す場合、判定モデルが本当に行き詰まっているかどうかを判断します。もしそうであれば、エージェントに別のアプローチを提案する短いメモが送られます。
日常的な意味での「記憶」、つまり一つのセッションから次へと引き継がれる事実は、このうちの最初のものだけです。他の2つは行動に関するレッスンです。3つすべてが同じソースから得られます。ブログにあるように、「TokenEconomizer はセッションのログを読み取り、リポジトリについて知っていることを更新する」のです。
事実が信頼されるタイミングを決定するルール
これは、何かをインストールするかどうかにかかわらず、最も参考にする価値のある設計部分です。
事実は、最初に現れたときに追加されるわけではありません。README にはその閾値が記されています。「事実は、3つのセッションで確認された時点で各セッションの開始時に提示され、後のセッションで矛盾が生じた場合に破棄される。」
README によれば、事実は2つの場所から得られます。「セッションをまたいで繰り返される失敗」と、数セッションごとに最近のセッションをレビューして事実を提案するモデルです。提案だけでは不十分です。エージェントの開始時のコンテキスト(context)に到達する前に、繰り返される証拠によって確認されなければなりません。それまでは、まだ形成途中の事実リストの中に留まります。
ブログでも同じゲートについて独自の言葉で説明しています。メモは「パターンが複数のセッションで確認された後にのみエージェントの開始コンテキストに追加され、後の証拠が矛盾する場合はそのメモを引退させる」としています。
なぜこれが重要なのでしょうか? 自己改善型エージェントを構築する明白な方法は、セッションの最後に結論づけたことを何でも書き留めさせることです。しかし、そのアプローチには既知の弱点があります。一度の幸運な推測や一度の誤った結論が、将来のすべてのセッションに対する永続的な指示になってしまうのです。繰り返しの確認という閾値は、それに対する直接的な回答です。一つのセッションだけでは事実を作り出すことはできません。
README はこれを設計原則として挙げています。「事実は繰り返される証拠からのみ形成され、ツールは使用されない場合にのみ削除され、ループガードはまだ進行中のターンには干渉しない。」
事実が削除されるタイミング
ルールのもう半分も同様に重要です。学習された事実は永続的なものではありません。
後のセッションが事実に矛盾する場合、その事実は破棄されます。チームがあるテストランナーから別のテストランナーに移行した場合、古いコマンドは確認されなくなり、失敗し始めます。するとプラグインはそのメモを引退させます。README には、かつて真実であったからといって事実が永遠にそこに留まることを示唆する内容はありません。
同じ可逆性が他のメカニズムにも適用されます。README の原則は「すべての行動を可逆的に保つ」ことであり、その意味を詳しく説明しています。「後のセッションが矛盾する事実は破棄され、削除されたツールは元に戻すことができ、ループガードはリダイレクトして通知するだけで、ターンを停止するかどうかはユーザーの判断に委ねられる。」
整理されたツールについて、README の説明は簡潔です。「一つのコマンドで元に戻せる。」
行き詰まったターンについて、プラグインの制限は明示的です。リダイレクト後もターンが行き詰まっている場合、README によれば TokenEconomizer は停止方法を教えるだけで、「それ自体がターンを停止することはない」としています。
つまり、学習ループの両端にブレーキがかかっているのです。事実は入るために繰り返しの確認を必要とし、出るために矛盾を必要とします。ツールリストは復元可能です。行き詰まったターンは常にあなたの決定のままです。
学習内容の保存場所
README はこれに直接答えています。「学習内容はあなたのマシンの ~/.tokeneconomizer に保存されます。」
ブログでもこの点が繰り返されています。プラグインは「学習した内容を開発者のマシンに保持する」としています。また、プラグイン自体には API キーが必要ないことも記されています。
これにはいくつかの実用的な結果があります:
- マシンごとである。 自分のノート PC で同じリポジトリを操作しているチームメイトは、自分のセッションから構築された独自のコピーから開始します。
- リポジトリごとである。 あるコードベースで学んだことは、そのコードベースのために保持されます。
- エージェントが既に読み取っているものを介して機能する。 README によれば、「事実はセッション開始時にコンテキストに入り、ツールはエージェント自身の設定を通じて削除されるため、エージェントが新しいツールを学習することに依存しない」とのことです。
事実提案者や判定者など、プラグインが行うモデル呼び出しも、あなた自身のエージェントを通じて実行されます。README によれば、これらは「同じプランまたはログイン」で実行され、そのコストはプラグインのレポートに含まれます。
学習した内容を確認することもできます。プラグインのコマンドには、リポジトリで何を学び何をしたかを表示する status や、「注入する事実と形成中の事実」をリストする microskills が含まれます。Claude Code ではコマンドの前に /tokeneconomizer: プレフィックスを付け、Codex では $tokeneconomizer: を付けます。
デフォルトで有効なものとそうでないもの
記憶(memory)の部分がすぐに機能し始めることを期待している場合、これは重要です。
ツールの整理とループガードはデフォルトでオンになっています。事実を学習する部分であるマイクロスキルはオフになっています。README はその理由を説明しています。「マイクロスキルはデフォルトでオフです。なぜなら、その提案者がモデル呼び出しを追加し、どれだけ節約できるかはリポジトリやそこでの作業内容に依存するからです。」
プラグインの config コマンドを使用して、リポジトリごと、またはすべてのリポジトリに対してオンにします。また、モデル呼び出しを行わず、繰り返される失敗からのみ事実を学習する軽量モードもあります。
Claude Code にはもう一つのオプションがあります。README によれば、「Claude Code では、プラグインはリポジトリの以前のセッションからも学習でき、Claude Code 自身のログを古い順にモデル呼び出しなしで読み取ることができます。これはデフォルトでオフです」。これはプラグインがリポジトリ内のセッションから学習する前にのみ履歴を読み取るため、インストール直後にオンにすることを想定しています。
学習しないこと
README を注意深く読むと、境界線が明確になります。
「なぜか」は学習しない。 マイクロスキルは一行の事実です(このステップを最初に実行する、このコマンドのスペルを使う、など)。設計上の選択の背後にある理由、どのアプローチを取るべきかについての会話、あるいは先月チームが行った決定などは、このメカニズムが捉えるように構築されているものではありません。
一つのセッションからは学習しない。 確認の閾値があるため、今日苦労して学んだ教訓が、このプラグインによって明日のセッションに届くことはありません。繰り返される必要があります。
ツール間で自動的に共有はしない。 コマンドとストレージはマシンごとです。同じリポジトリで一つのタスクに Claude Code を使い、別のタスクに Codex を使う場合、2つのホストが学習内容をどのように共有するかについて README に詳細な記載がないため、同じ事実が見えていると想定しない方が安全です。
指示ファイルを置き換えない。 事実は、CLAUDE.md や AGENTS.md など、エージェントが既にロードしているものと並んでセッション開始時に提示されます。それらのファイルは、チームが合意した規約を置く場所として残ります。
Claude Code には、エージェントが自身のために書き込む独自の組み込みメモリもあります。それがどのように機能するかについては、Claude Code のオートメモリとは何かについてのガイドで解説しています。
テスト済みのバージョン
README には、各エージェントのテスト済みバージョン範囲が記載されています。Claude Code は 2.1.300 から 2.1.310、Codex は 0.153.1 から 0.164.0 です。また、「新しいバージョンはまだテストされていない」と付け加えられています。
両方のエージェントとも、これらの範囲を超えたリリースが出荷されています。これはプラグインがそれらで失敗することを意味するのではなく、作者がテスト済みとしてリストしていないだけです。新しいリリースで試す場合は、数セッション後に status を確認し、期待通りに記録されているか確かめてください。
特に Codex の場合、プラグインのフックは実行前に信頼される必要があり、README によれば、フックは次の Codex セッションから有効になります。
時間の経過に伴う学習に関する研究結果
ブログによると、テストされたすべてのリポジトリでコストが低下し、タスクの成功率は概ね安定していました。このガイドにとってより興味深い発見は、曲線の形状です。「経験が蓄積されるにつれて節約額が増加する。」
リポジトリでの初期セッションは、プラグインが学習している間、コストが高くなる可能性があります。ブログの Claude Code の結果では、すべてのリポジトリが6番目のタスクまでにデフォルトよりも安価になりました。これは、繰り返される証拠を待つ設計から予想される通りです。スロースタートと引き換えに、誤ったレッスンを減らしているのです。
研究者たちはまた、固定された戦略がどこでも機能するわけではないことも発見しました。彼らがテストした他の3つのオープンソースプラグイン(それぞれが固定のコスト削減アプローチを中心に構築されている)は、一部のリポジトリでは役立ちましたが、他では役立ちませんでした。彼らの結論は、コスト制御はリポジトリに適応しなければならないということであり、それがすべてがコードベースごとに学習される理由です。
Anthropic も反対側から同じ緊張関係について書いています。常時稼働型エージェント(always-on agents)に関するガイダンスでは、記憶(memory)はエージェントが簡単に再検索できない内容のみを保持すべきであるとしています。これについては、常時稼働型エージェントとは何かについてのガイドで解説しています。
ユーザーが最初に陥りやすいこと
エージェントが自ら学習することを期待する。 Claude Code や Codex はセッションで再学習しません。セッションをまたいだ学習は、メモリ機能やこのようなプラグインから得られます。
すべてをオンにして事実を待つ。 マイクロスキルはデフォルトでオフです。何も学習されていないと結論づける前に config を確認してください。
各セッションの後にすべての結論を書き留める。 これは、確認の閾値が回避しようとしているアプローチです。
学習された事実は永続的であると想定する。 矛盾する事実は破棄され、整理されたツールは復元可能です。
プラグインが決定事項を保持することを期待する。 保持されるのはリポジトリの仕組みに関する一行の事実であり、選択の背後にある理由ではありません。
解決策:レッスンにその価値を証明させる
ステップ 1: 保持したいレッスンの種類を決める
リポジトリに関する事実(コマンド、セットアップ手順)と決定事項(なぜそのアプローチが選ばれたのか)を分けます。これらには異なる保管場所が必要です。
ステップ 2: レッスンが指示になる前に繰り返しの証拠を求める
プラグインが書くか人間が書くかにかかわらず、すべてのセッションがロードするものに追加する前に、レッスンが複数回有効であることを確認できるまで待ちます。
ステップ 3: すべてのレッスンに出口を用意する
事実が真実でなくなったら削除します。学習された事実や指示ファイルを定期的に見直します。
ステップ 4: 決定事項は自分で書き留める
選択の背後にある理由は、繰り返される失敗としては現れません。将来のセッションで使用できる言葉で、意図的に記録してください。
MemoryLake での設定
TokenEconomizer はリポジトリがどのように振る舞うかを学習します。どのアプローチを選び、どれを除外し、それはなぜかといった、あなたの仕事の背後にある決定事項は、それを知っている誰かが書き留める必要があります。
MemoryLake は、そのようなプロジェクトのコンテキスト(決定、規約、有効性が確認された教訓など)のための記憶レイヤーです。これらはあなたが維持する一つの場所に保管され、ChatGPT、Claude Code、Codex など、接続したアシスタントから利用可能になります。
エントリはあなた自身の言葉で書きます。~/.tokeneconomizer、セッションログ、エージェントの設定、CLAUDE.md や AGENTS.md ファイル、あるいはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。TokenEconomizer と各エージェント独自のメモリは、それぞれの作者が説明している通りに機能します。
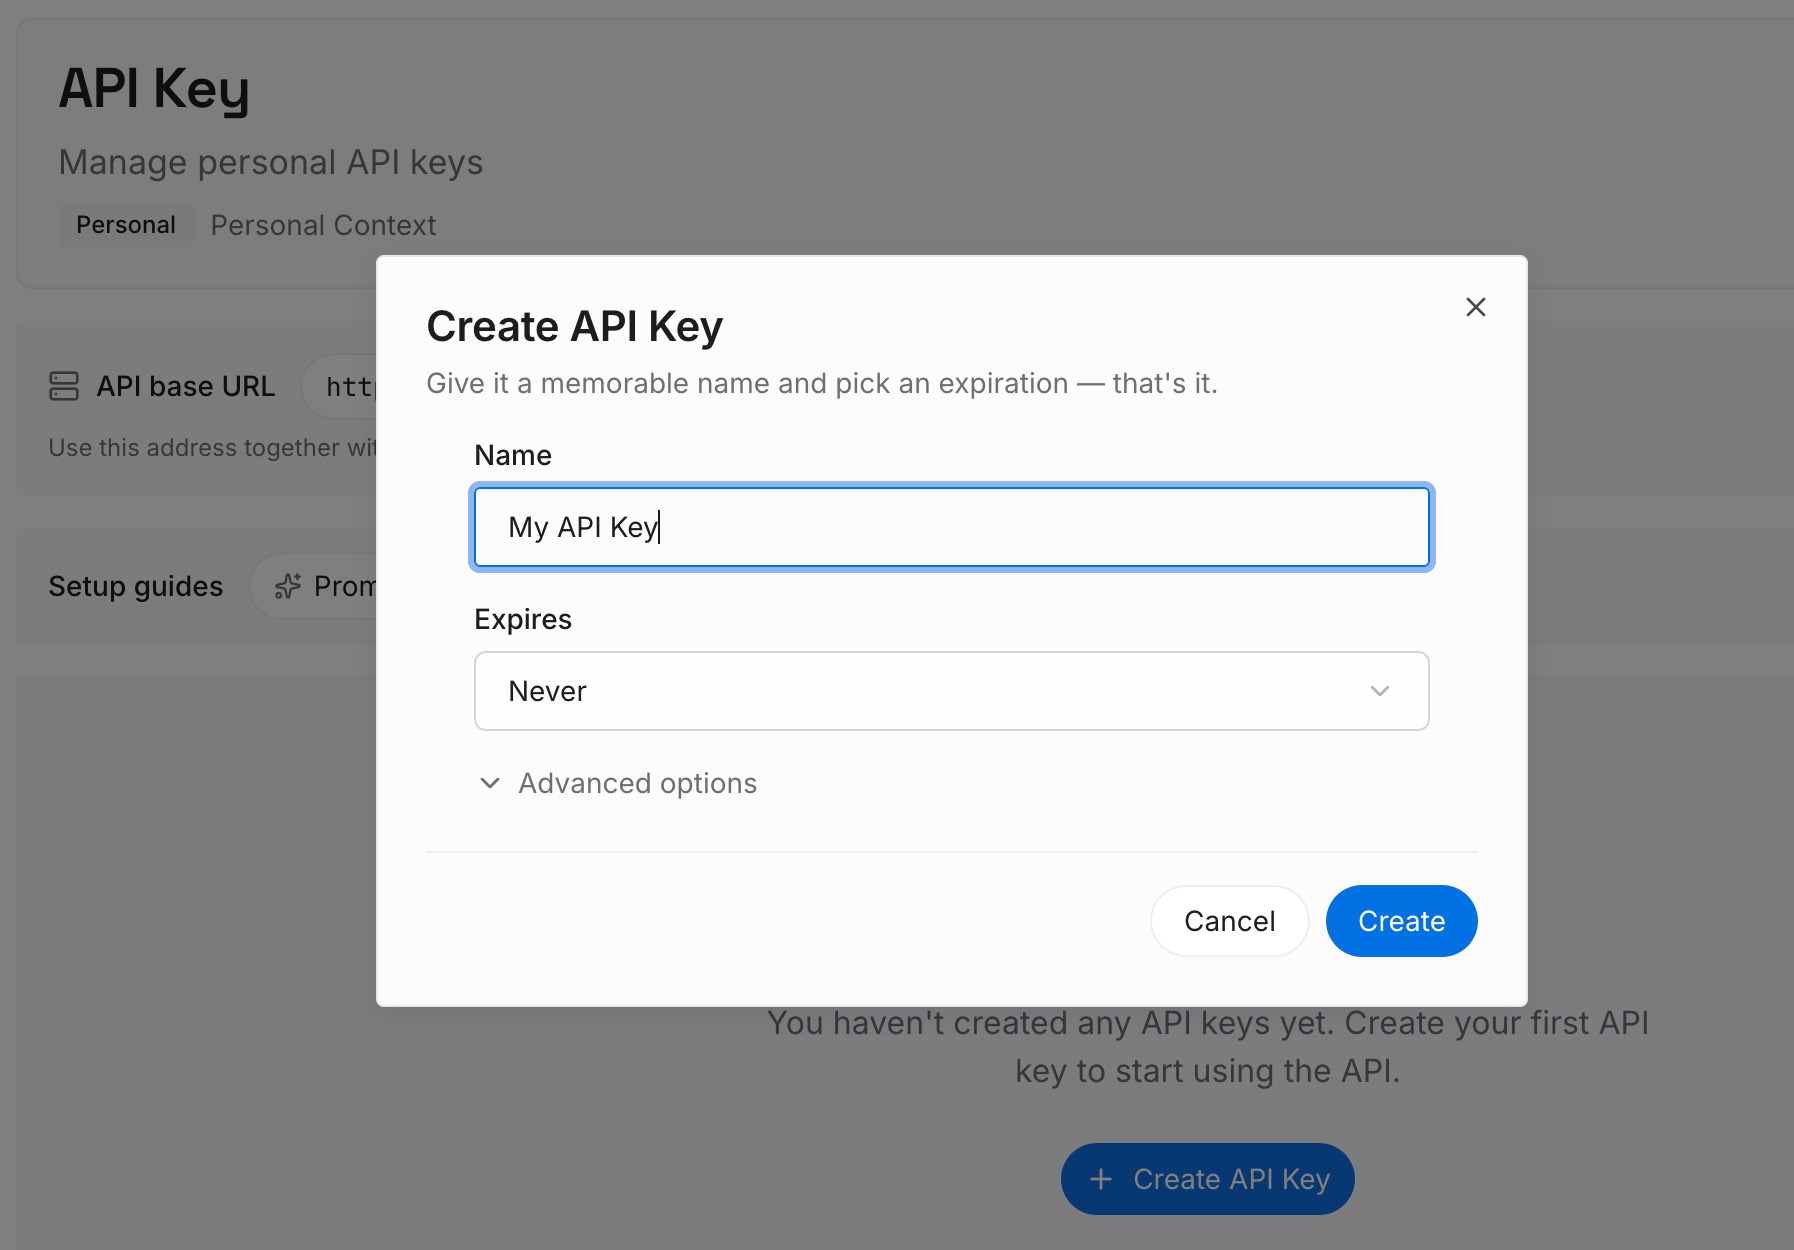
ステップ 1: API キーを作成する
サインインしてダッシュボードからキーを生成します。他の認証情報と同様に、リポジトリの外に保存してください。
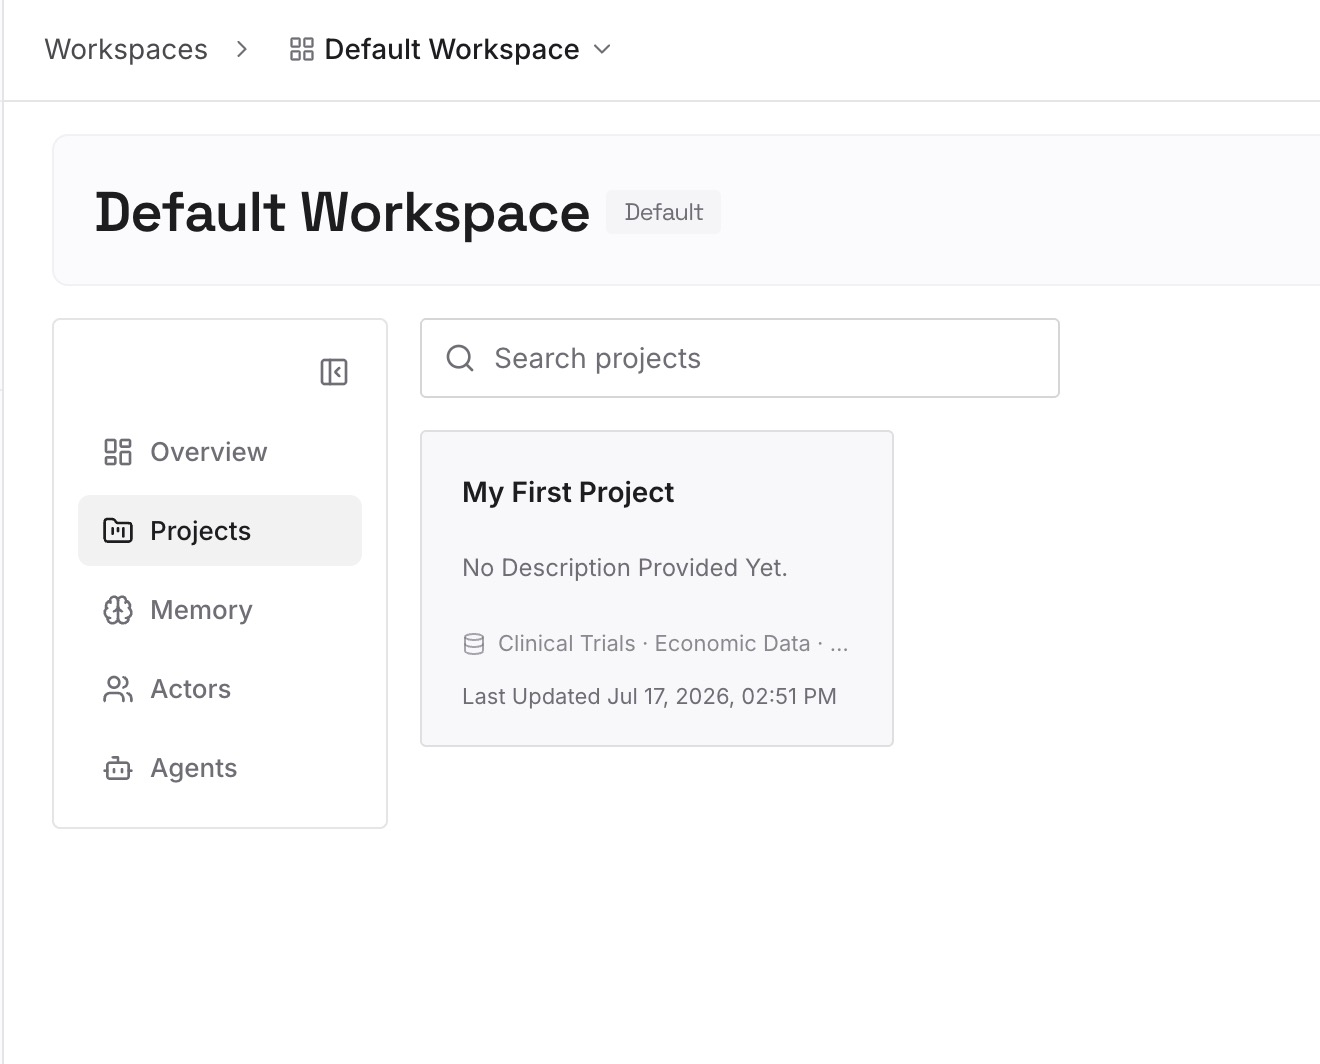
ステップ 2: 最初の記憶をアップロードする
解決策のステップ 4 で書いた内容から始めます。最近のセッションでの決定事項とその理由です。1つのエントリにつき1つの決定事項を、日付とともに記入します。
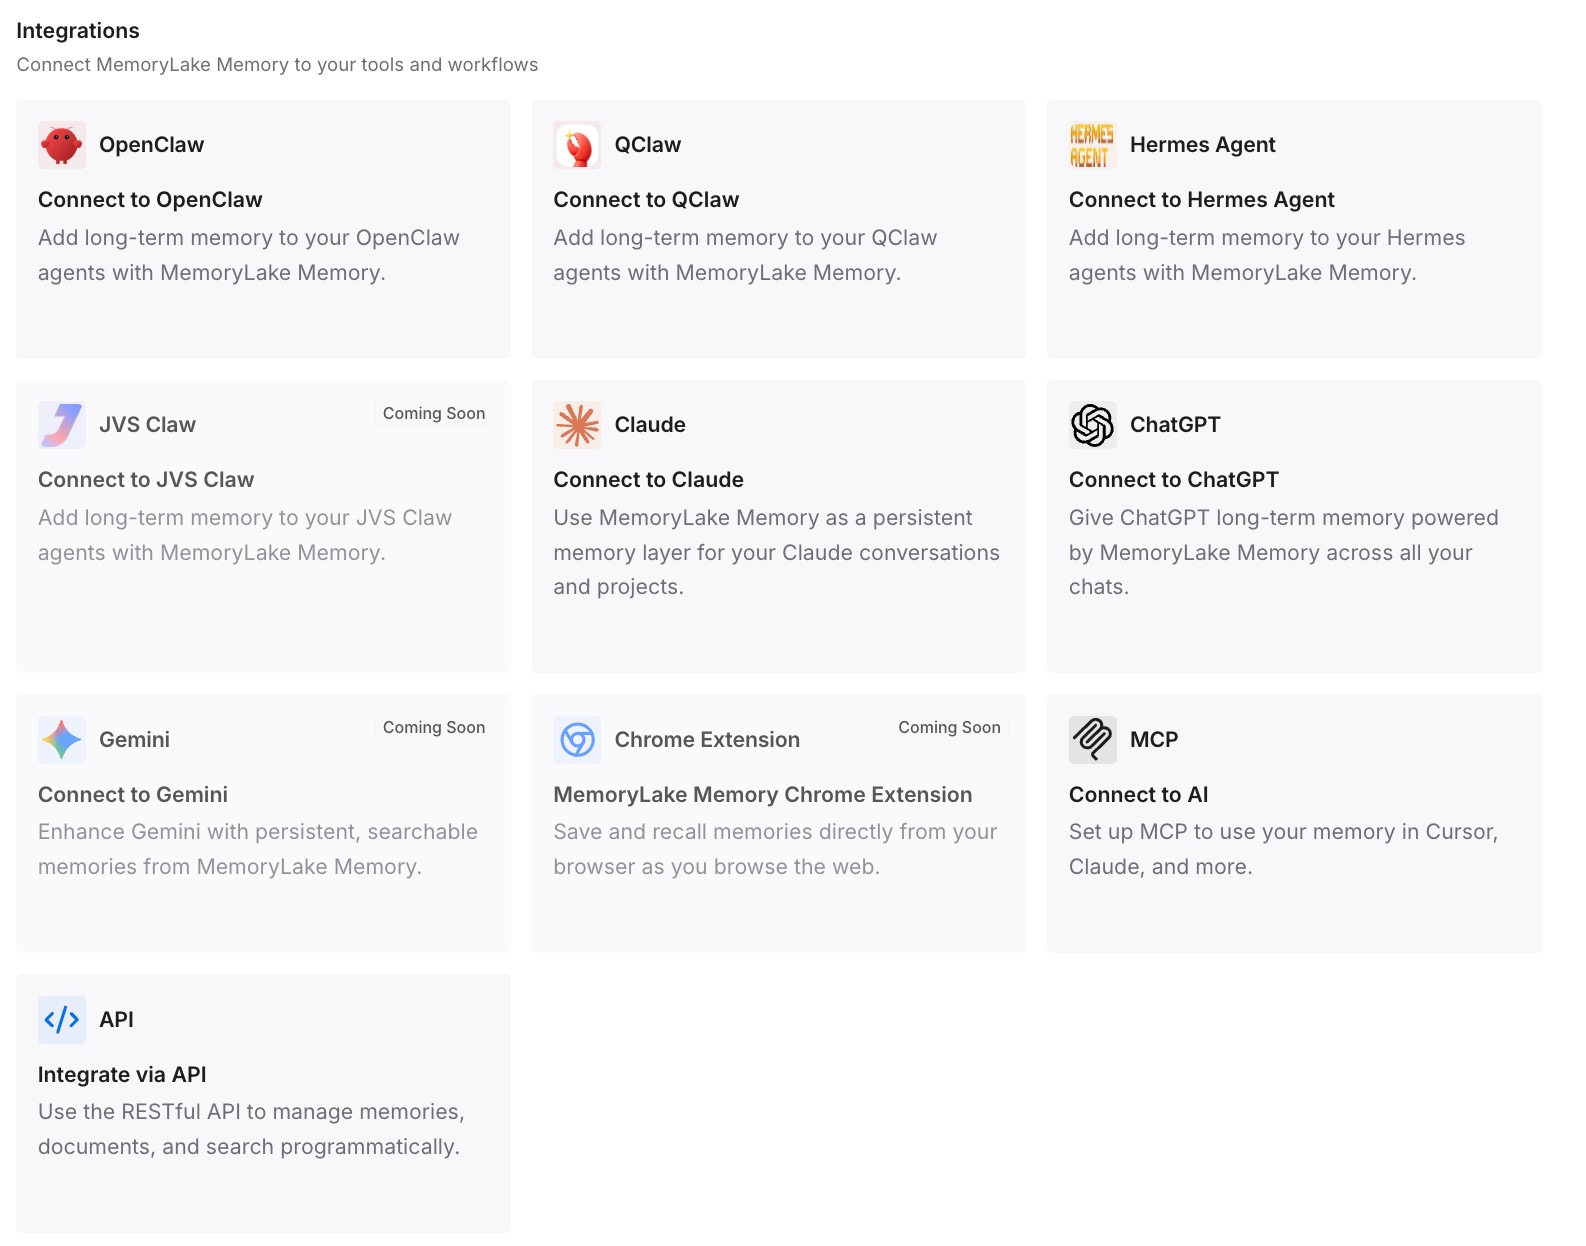
ステップ 3: AI とエージェントを接続する
Claude Code、Codex、および使用している他のアシスタントを接続します。それぞれが同じ決定事項を参照できるようになります。
実践における変化
第一の違いは、より明確な分離です。リポジトリに関する繰り返される事実は自動的に学習され、決定事項は人間によって書かれます。
第二に、誤ったレッスンが減ります。記録する決定事項は、単一のセッションから推測されたものではなく、あなたが確認したものです。
第三に、ツールやマシンを越えた継続性です。仕事の背後にある理由は、一台のノート PC のプラグインデータに縛られません。
自己改善型コーディングエージェントのベストプラクティス
リポジトリごとに学習する。 研究により、経験は主に同じコードベース内で役立つことが判明しています。
信頼する前に確認する。 レッスンは、すべてのセッションがそれをロードする前に、複数のセッションにわたって有効であるべきです。
可逆性を保つ。 学習されたすべての事実には、破棄される方法が必要です。
有効なものを確認する。 TokenEconomizer ではマイクロスキルはデフォルトでオフです。
学習された内容を見る。 プラグインの microskills コマンドを使用して、注入された事実と形成中の事実を確認してください。
規約は指示ファイルに保持する。 CLAUDE.md や AGENTS.md は、合意されたルールのための場所として残します。
決定事項を意図的に記録する。 それらは繰り返される失敗としては現れません。
結論
Claude Code と Codex は自ら再学習しませんが、プラグインによって次のセッションの開始状態を変えることができます。Microsoft の TokenEconomizer は、過去のセッションログからリポジトリごとに学習します。一行の事実、未使用のツール、行き詰まったターンなどです。事実は3つのセッションで確認された後にのみ開始コンテキストに追加され、後のセッションで矛盾が生じた場合に破棄されます。すべてはあなたのマシンの ~/.tokeneconomizer に保持され、事実学習部分はデフォルトでオフになっています。
この設計は、あらゆる自己改善型のセットアップにとって有用なモデルです。繰り返される証拠を要求し、すべてのレッスンに出口を与え、決定の背後にある理由は自分で維持する場所に保管することです。