
Claude を開始する場所が読み込み内容を決定する
最初の決定は最もシンプルでありながら、最大の影響を及ぼします。ドキュメントには次のように記されています。「claude を起動する場所によって、追加の権限付与なしに Claude が読み書きできるファイル、起動時にコンテキストに読み込まれる CLAUDE.md ファイル、および適用されるプロジェクト設定が決まります。」
以下の2つの選択肢が比較されています:
- リポジトリのルートから開始する場合。 Claude はすべてのファイルにアクセスできます。起動時にはルートの CLAUDE.md のみが読み込まれ、サブディレクトリのファイルは必要に応じて読み込まれます。
- サブディレクトリから開始する場合。 Claude は、追加の権限を与えるまでそのサブツリーのみにアクセスできます。起動時には、そのディレクトリの CLAUDE.md と、すべての親ディレクトリの CLAUDE.md が読み込まれます。
ドキュメントでは、タスクが複数のパッケージにまたがる場合はルートから、作業が1つのパッケージに限定される場合はサブディレクトリから開始することを推奨しています。
見落としがちな詳細が1つあります。「.claude/settings.json のプロジェクト設定は、CLAUDE.md ファイルのように親ディレクトリから継承されません。」指示は親ディレクトリからカスケードされますが、設定はされません。
ディレクトリごとに CLAUDE.md ファイルをレイヤー化する
ドキュメントでは、1つのルートファイルが機能しなくなる理由を説明しています。それは「すべてのサブシステムの規約をカバーするために肥大化し、現在のタスクに関係のない指示でコンテキストを浪費するか、あるいは汎用的すぎて役に立たなくなる傾向がある」ためです。
推奨されるのは2つのレベルです:
- ルートの CLAUDE.md: コーディング標準やコミット規約など、どこにでも適用される指示用。
- パッケージまたはサブシステムごとの CLAUDE.md: その領域のスタックに特有の規約用。
ドキュメントの例はその効果を示しています。API パッケージから Claude を開始すると、そのパッケージの CLAUDE.md とルートのものが読み込まれ、「packages/web/ からの指示はコンテキストに含まれません」。
実際にどのファイルが読み込まれたかを確認するには、/context all を実行し、「Memory files」の下のリストを確認してください。
また、ドキュメントではこれらのファイルを最新の状態に保つための3つの方法を挙げています:
- プルリクエストで CLAUDE.md の編集をレビューする。他のドキュメントと同様に扱います。
- 主要なモデルのリリース後に再検討する。古いモデルの制限を回避するための指示は、新しいモデルがそのケースを処理できるようになると、単なるオーバーヘッドになる可能性があります。
- 更新を提案する Stop フックを追加する。Stop フックはセッションの文字起こしへのパスを受け取るため、記憶が新しいうちにスクリプトで CLAUDE.md の変更を提案できます。
オンデマンドで読み込まれるサブディレクトリのファイルには、ルートファイルとは異なるサイズ制限の挙動があります。これについては、Claude Code におけるサブディレクトリ CLAUDE.md の制限に関するガイドで解説しています。
ディレクトリごとの CLAUDE.md か、パススコープのルールか
Claude Code には、ツリーの一部に指示をターゲットにする2つ目の方法があります。それは .claude/rules/ 配下の paths: glob を持つルールファイルです。ドキュメントではこの2つを比較しています。
ディレクトリごとの CLAUDE.md は、コードと同じディレクトリ内に配置されます。そのディレクトリから開始した場合は起動時に、そうでない場合はオンデマンドで読み込まれます。ディレクトリの所有者が独自の規約を維持するチームに適しています。
パススコープのルール は、リポジトリルートの中央の .claude/ フォルダに配置されます。Claude がその glob に一致するファイルを扱うときに読み込まれます。すべての規約を1か所にまとめたいチームや、散在する多くのパスに適用されるルールに適しています。
ルールファイルの仕組みについては、Claude Code のルールとは何かに関するガイドで解説しています。
他のパッケージの指示を排除する
ルートから開始した場合、Claude がその場所のファイルに触れると、各サブディレクトリの CLAUDE.md がオンデマンドで読み込まれることがあります。claudeMdExcludes 設定を使用すると、パスや glob で特定のファイルを指定して「決して読み込まれないように」スキップできます。
ドキュメントでは、他チームのパッケージ、レガシーコード、ベンダー提供のサブツリーなど、決して作業しないディレクトリに対してこれを推奨しています。期待通りに動作するかどうかは、いくつかの詳細によって決まります:
- 静的である。 「除外リストは静的であり、タスクごとの切り替えではありません。」毎日異なるパッケージに集中したい場合は、除外設定を編集するのではなく、そのパッケージから Claude を開始してください。
- パターンは絶対パスに一致する。 相対形式のパターンは
**/で開始し、ツリー内のどこにでも一致するようにします。 - ルールも対象となる。 パッケージのフォルダを除外すると、その配下のすべての CLAUDE.md とルールファイルがスキップされますが、ルートの CLAUDE.md や作業中のパッケージは通常通り読み込まれます。
- スコープがマージされる。 ユーザー、プロジェクト、ローカル、またはマネージドスコープで設定でき、配列はスコープを越えてマージされるため、チームのデフォルトと個人の追加設定が組み合わされます。
- マネージドファイルは依然として読み込まれる。 組織がマネージド CLAUDE.md をデプロイしている場合、それに一致するパターンを指定してもスキップされません。
自分だけに適用される除外設定については、ドキュメントは .claude/settings.local.json を推奨しています。このファイルを手動で作成する場合は、自分で gitignore に追加してください。
Claude が不要なコードを読み込むのを止める
コンテキストを埋めるのは指示だけではありません。ドキュメントには「ファイルの読み込みも、コードベースとともに増大するコストである」と記されています。
Gitignore されたパス。 Claude のコンテンツ検索はデフォルトで .gitignore を尊重するため、node_modules/、dist/、build/ などのパスは検索結果から除外されます。
チェックインされた生成コードやベンダーコード。 コミットされているパスについては、permissions.deny に Read 拒否ルールを追加します。リポジトリの全員に対しては .claude/settings.json に、自分自身に対しては .claude/settings.local.json に、あるいはどこでも強制するにはマネージド設定に記述します。
ドキュメントはこの制限について明確に述べています。「拒否ルールは、自らファイルを開くサブプロセスをカバーしません。」
ランゲージサーバーのルックアップ。 コードインテリジェンスプラグインは Claude をランゲージサーバーに接続するため、「ツリーをスキャンする代わりに」定義へのジャンプや参照の検索が可能になります。ドキュメントによると、これは除外設定や拒否ルールと相性が良いとされています。それらが無関係なコンテンツを排除し、コードインテリジェンスが残った部分を Claude が読み解くのを助けるからです。
必要なものだけをチェックアウトし、ディレクトリを慎重に追加する
ワークツリーの場合、worktree.sparsePaths 設定で git sparse-checkout を使用し、リストされたディレクトリとルートレベルのファイルのみを書き出します。ルートの設定やルールをワークツリー内で利用したい場合は、リストに .claude を含めてください。
1つのパッケージから開始し、兄弟パッケージへのアクセスが必要になった場合、アクセスの許可方法によって読み込まれる内容が変わります。ドキュメントの表は以下の通りです:
additionalDirectories設定: CLAUDE.md、ルール、skills を一切読み込みません。--add-dirフラグまたは/add-dirコマンド: skills を読み込みます。CLAUDE.md とルールは、環境変数CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MDが設定されている場合にのみ読み込まれます。
つまり、兄弟パッケージを追加すると Claude はファイルにアクセスできるようになりますが、必ずしもそのパッケージの規約が読み込まれるわけではありません。兄弟パッケージのルールがタスクにとって重要な場合は、環境変数とともに --add-dir を使用してください。
ディレクトリごとに skills を追加する
Skills は、関連する場合にのみ読み込むべき参照資料に適しています。ドキュメントによると、どのサブディレクトリでも独自の .claude/skills/ 配下に skills を定義し、その領域のコードとともにコミットできます。例:API パッケージには API テストの skill、ウェブパッケージにはコンポーネントパターンの skill。Claude があるパッケージのファイルを操作するとき、そのパッケージの skill を読み込みます。
多くの skills がある場合には注意点があります。Claude は、発見されたすべての skill の名前と説明を読み取って skill を選択し、「選択された skill の全内容のみがコンテキストに読み込まれます」。数が多い場合、一部の skill の説明が完全に失われる可能性があるとドキュメントは述べています。アドバイスとしては、「説明は短く保ち、リクエストに含まれるであろう言葉を先頭に置く」ことです。
どの skills がスコープに入るかは、開始場所によって異なります:
- サブディレクトリから: そのディレクトリの skills、ルートまでのすべての親ディレクトリの skills、およびユーザーとエンタープライズの skills。
- ルートから: ルートの skills に加え、Claude が触れたすべてのサブディレクトリの skills。「これらは数百に蓄積される可能性があります」。
PR 規約やデプロイチェックリストなど、多くのディレクトリで共有される skills については、ドキュメントはルートの .claude/skills/ を推奨しています。
レイヤー化がスケールしなくなったとき
ドキュメントは、ディレクトリごとのファイルがすべてを解決するわけではないことを率直に認めています。「規約は乖離し、ファイルは古くなり、誰もルートを所有しなくなります。」
推奨されるのは、規約や参照コンテンツを常に読み込まれる CLAUDE.md から、オンデマンドで読み込まれるメカニズムに移行することです:
- Skills: 関連する時に読み込まれる参照資料用。
- プラグイン: プラットフォームチームが所有し、マネージド設定を通じて全員にインストールできる skills、フック、コマンドのバージョン管理されたバンドル。プラグインの skills は名前空間を使用するため、ディレクトリごとの skills と衝突しません。
- MCP サーバー: 組織がすでにリポジトリに対してコード検索やリトリーバルインデックスを運用している場合。
規約がプラグイン化されると、不慣れなツリーの一部にいるチームメイトは、どれを適用すべきかわからないかもしれません。ドキュメントは、起動ディレクトリを適切なプラグインにマッピングして推奨事項を出力する SessionStart フックを提案しています。Claude Code は、最初のプロンプトの前にフックの出力を Claude のコンテキストに追加するためです。
パッケージをまたぐ変更
共有型やすべての呼び出し箇所など、複数のパッケージにまたがる変更については、ドキュメントは2つのテクニックを挙げています。1つのセッションで変更全体を Claude に任せることで、各編集の背後にある決定の一貫性を保ちます。そして、まず計画を立てることです。プランモードでは、Claude は計画をファイルに書き込みます。「Claude Code は各コンパクション(圧縮)後にプランファイルを再注入するため、会話履歴が残らない場合でも計画は維持されます」。
人々が最初に試してしまうこと
すべてをルートの CLAUDE.md に入れる。 無関係な指示によってコンテキストコストがかかります。
タスクごとに claudeMdExcludes を編集する。 これは静的な設定です。代わりにパッケージから開始してください。
拒否ルールがすべての読み込みをブロックすると期待する。 自らファイルを開くサブプロセスはカバーされません。
additionalDirectories で兄弟を追加し、その CLAUDE.md を期待する。 その設定では CLAUDE.md や skills は読み込まれません。
長い skill の説明を書く。 多くの skills がある場合、説明がカットされる可能性があります。
解決策:作業中のコードに適した指示を読み込む
ステップ 1: 開始場所を選択する
集中した作業にはパッケージから、パッケージをまたぐタスクにはルートから開始します。
ステップ 2: ディレクトリごとに CLAUDE.md を分割する
リポジトリ全体のルールはルートに、スタック固有の規約は各パッケージに保持し、/context all で確認します。
ステップ 3: 不要なものを除外・拒否する
他チームの指示には claudeMdExcludes を、生成コードやベンダーコードには Read 拒否ルールを使用します。
ステップ 4: 各規約が存在する理由を記録する
指示ファイルは何をすべきかを示します。その背後にある決定事項や、廃止予定のものは、それ自体のための場所が必要です。
MemoryLake でのセットアップ
大規模なコードベースでは、規約は多くのファイルや所有者に分散します。API がなぜクエリビルダーを使用しているのか、なぜレガシーサービスが凍結されているのかといった背後にある決定事項こそ、新しいチームメイトや新しいセッションが問い続ける内容です。
MemoryLake は、アーキテクチャの決定、パッケージの所有権、規約の理由といったプロジェクトコンテキストのための記憶レイヤーです。これらを1か所で管理し、ChatGPT、Claude Code、Codex などの接続されたアシスタントから利用できるようにします。
エントリーはあなた自身の言葉で記述します。CLAUDE.md ファイル、ルールや skills、設定ファイル、セッション、あるいはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。CLAUDE.md の読み込み、除外、skills は Anthropic が説明している通りに動作します。
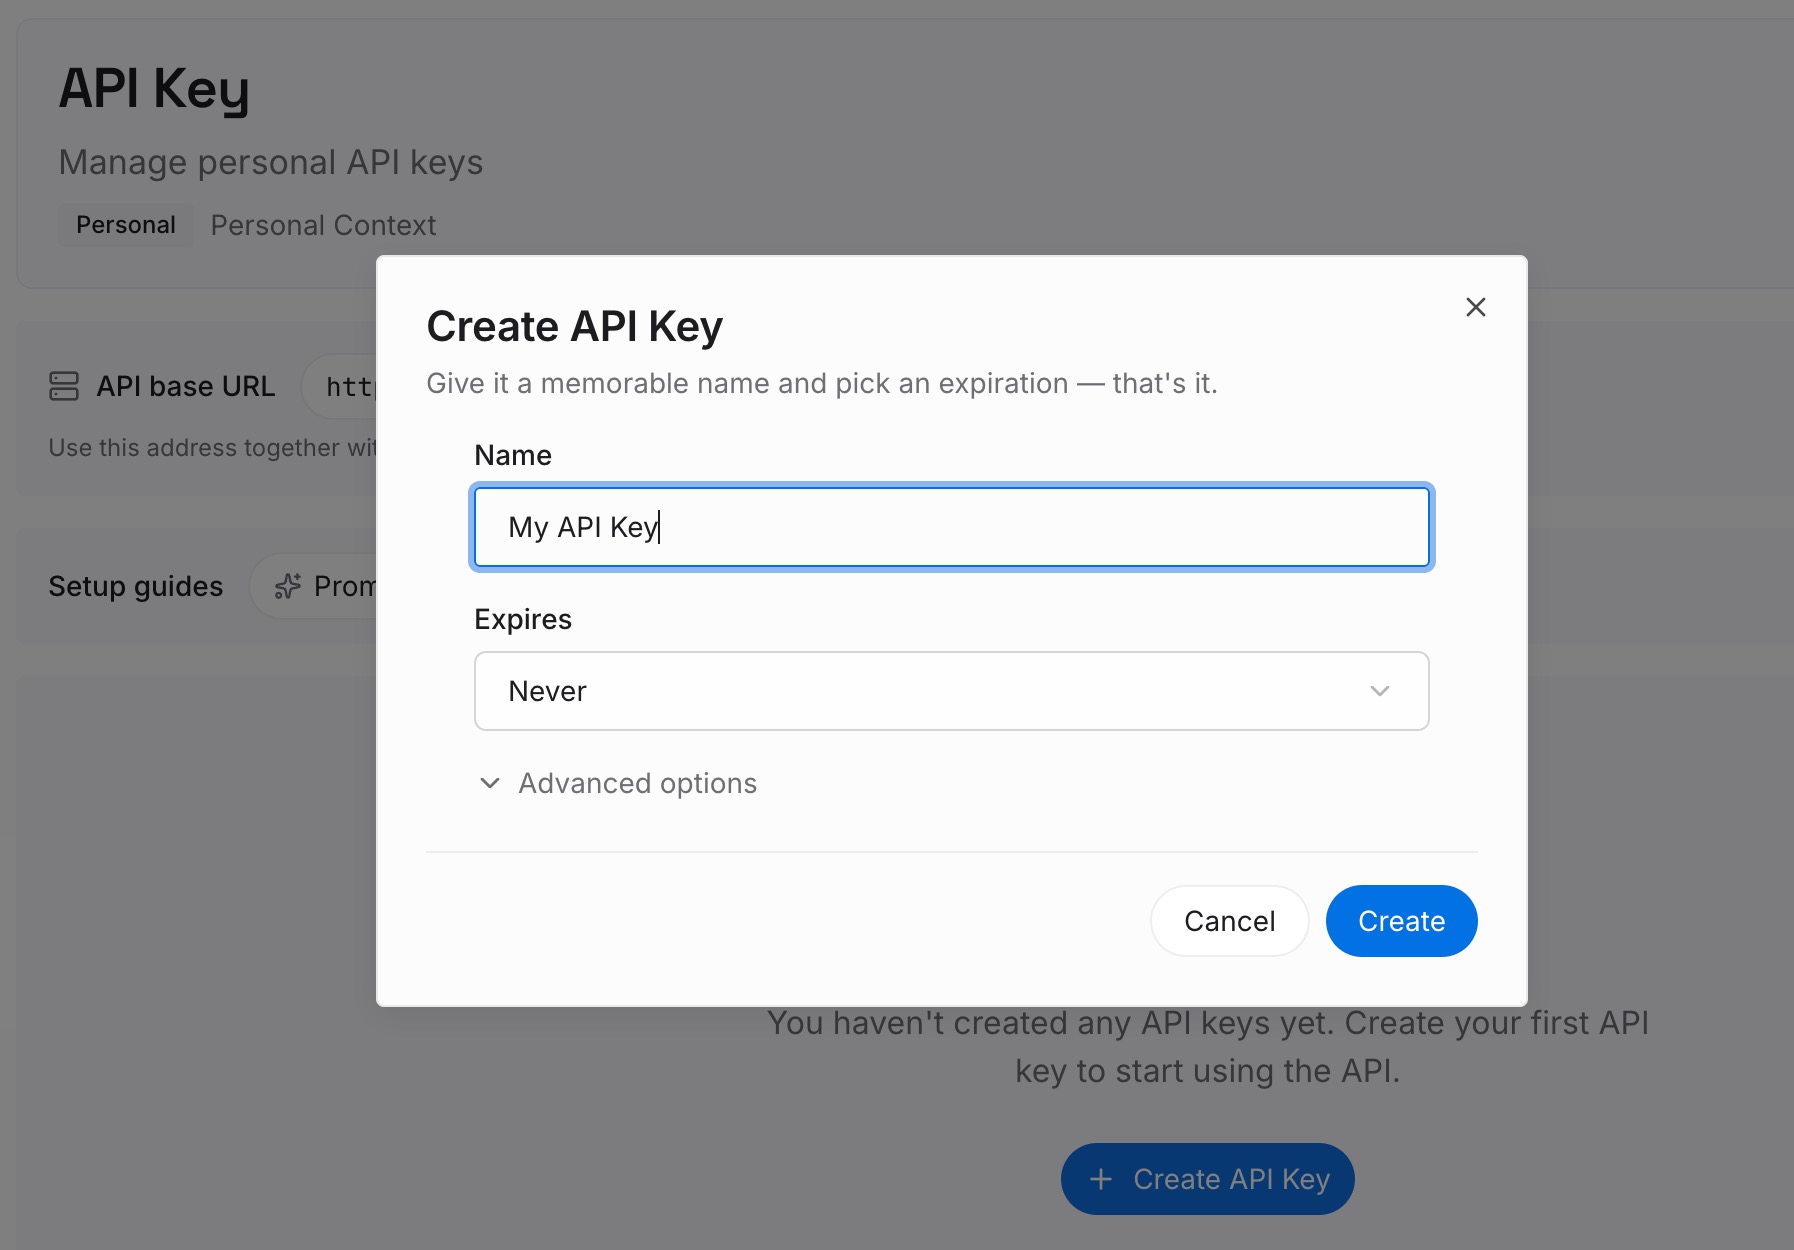
ステップ 1: API キーを作成する
サインインしてダッシュボードからキーを生成します。他の認証情報と同様に、リポジトリの外に保存してください。
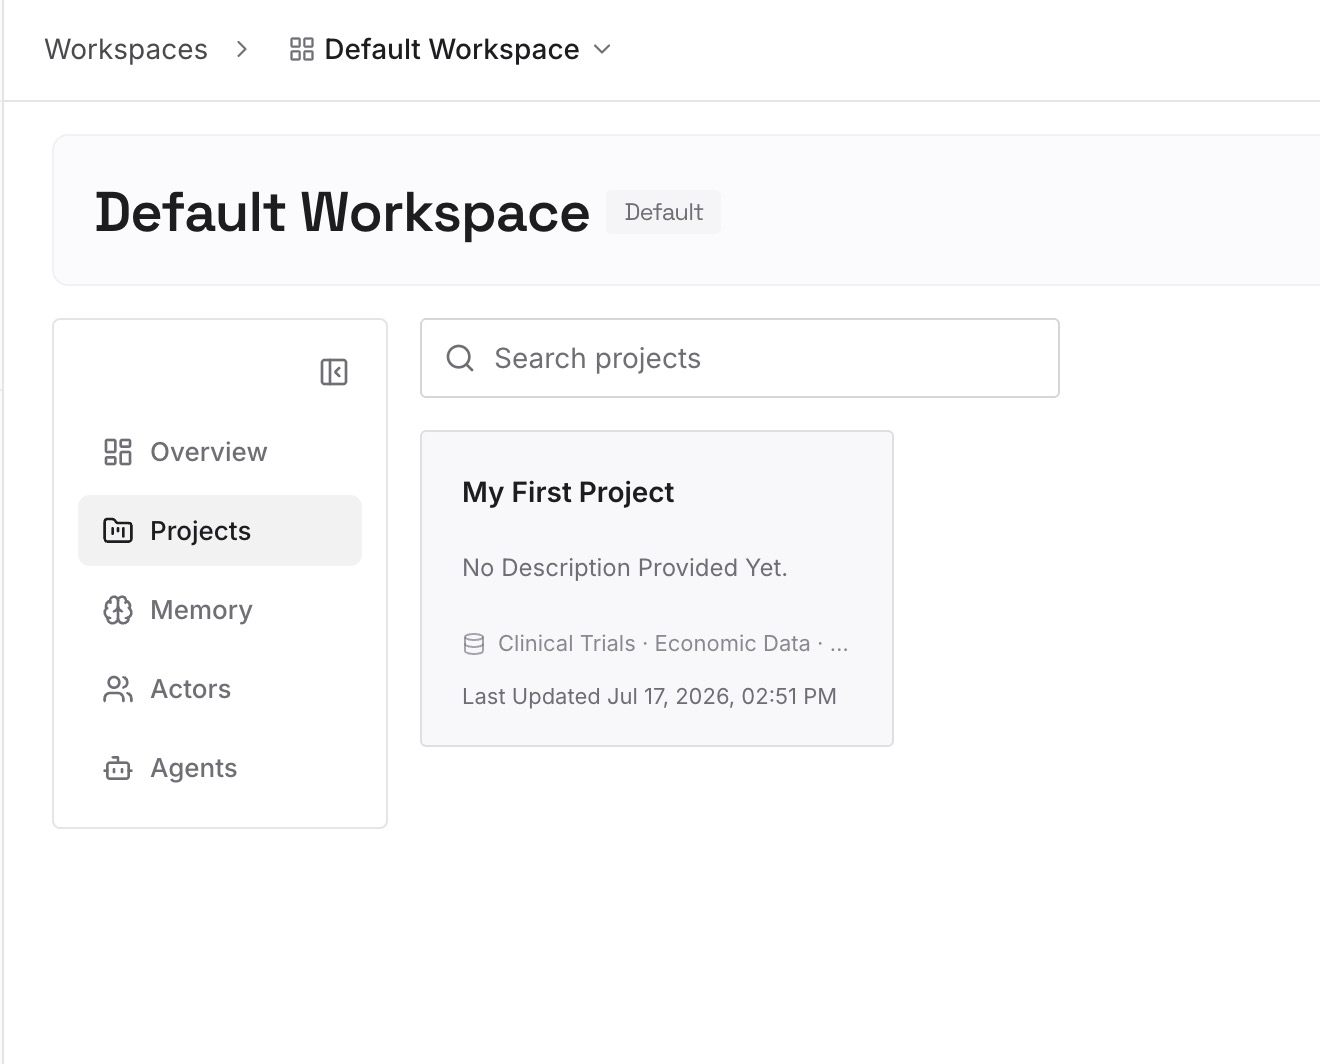
ステップ 2: 最初の記憶をアップロードする
解決策のステップ 4 で書いた内容から始めましょう。規約の背後にある決定事項をパッケージごとにグループ化します。1つのエントリーにつき1つの決定事項と、その所有者を記載します。
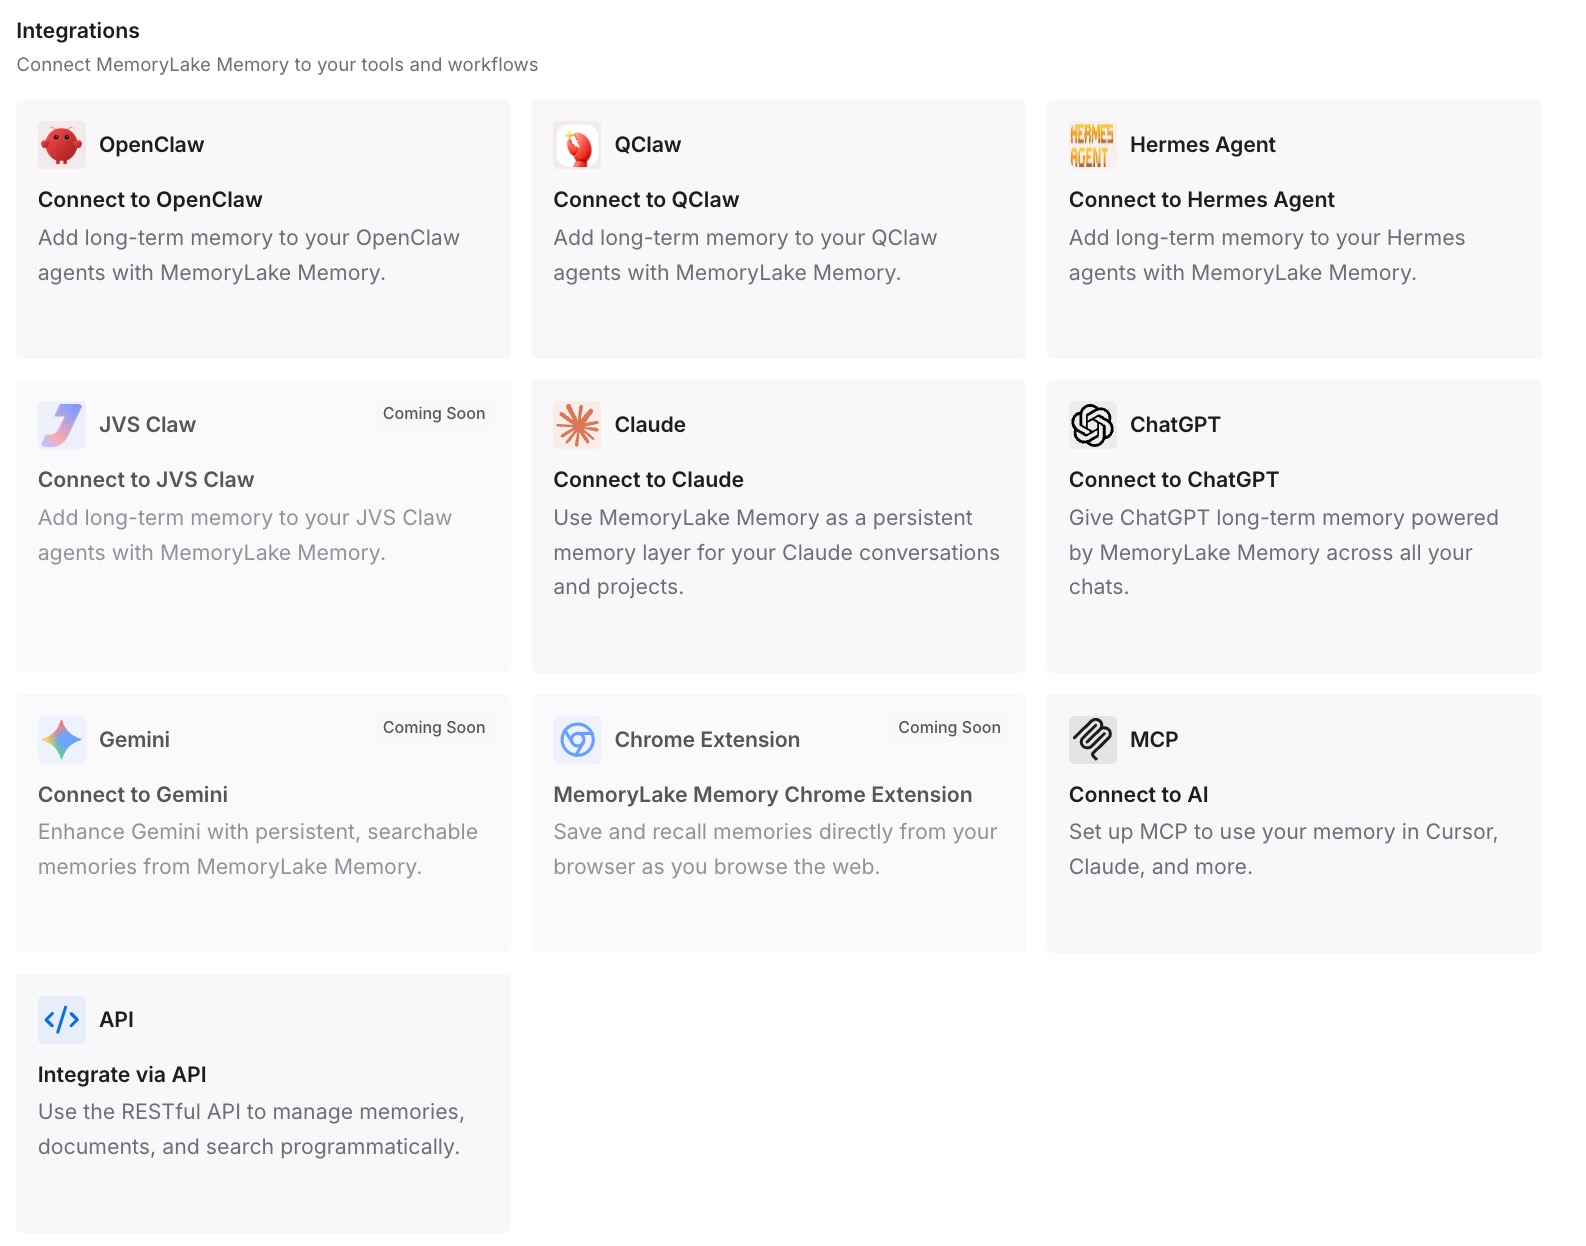
ステップ 3: AI とエージェントを接続する
Claude Code、Codex、および使用している他のアシスタントを接続します。セッションがどのパッケージで開始されても、それぞれが同じ決定事項を参照できます。
実践で何が変わるか
第一の違いは、指示ファイルが小さくなることです。CLAUDE.md は「何をすべきか」に集中でき、その理由は別の場所に保管できます。
第二に、オンボーディングが容易になります。新しいチームメイトは、なぜパッケージがそのように動作するのかという理由を読むことができます。
第三に、ツール間の一貫性です。同じリポジトリで作業する Codex も、同じ決定事項を利用できます。
大規模コードベースにおける Claude Code のベストプラクティス
作業がある場所から開始する。 これにより、どの CLAUDE.md ファイルが読み込まれるかが決まります。
ディレクトリごとに指示をレイヤー化する。 ルートは全体用、パッケージは独自のスタック用。
読み込まれた内容を確認する。 /context all を使用します。
決して触らないものを除外する。 claudeMdExcludes は静的なので、一度設定すれば済みます。
生成コードの読み込みを拒否する。 サブプロセスはカバーされないことを忘れないでください。
skill の説明は短く保つ。 リクエストに含まれるであろう言葉を先頭に置きます。
肥大化した規約を skills やプラグインに移行する。 これらをオンデマンドで読み込みます。
結論
Claude Code は、開始場所に基づいて CLAUDE.md ファイルを読み込みます。ルートからはルートファイルのみ、サブディレクトリからはそのパッケージのファイルとすべての親のファイルが読み込まれ、その他のファイルはオンデマンドで読み込まれます。大規模コードベース向けの Anthropic のガイドでは、ディレクトリごとに指示をレイヤー化し、claudeMdExcludes で作業しないファイルを除外し、生成コードの読み込みをブロックし、skills を提供するパッケージにスコープすることを推奨しています。
ディレクトリごとのファイルがスケールしなくなった場合、ガイドは規約をオンデマンドで読み込まれる skills、プラグイン、または MCP サーバーに移行することを提案しています。それらの規約の背後にある決定事項を、あなたが管理するどこかに保管しておくことで、ファイルとともに乖離してしまうのを防ぎましょう。