
なぜ検証が「どれだけ任せられるか」を決めるのか
記事は次のような重要な指摘から始まります。「検証ループは、より多くの仕事を Claude に委任できるようにするための構成要素である」。これがないと、すべてを自分でチェックしなければならないため、一度に1つか2つの Claude しか動かせないと述べられています。
また、コストについても言及しています。かつてテスト、ベンチマーク、仕様書を書くのは高コストでした。今ではエージェントがそれらを生成でき、一度書けばソフトウェアとして動作するため、追加のトークンを大量に消費することなく頻繁に実行できます。
次に、検証を memory(記憶)に結びつける部分が登場します。記事では、「その結果を使用してタスクに対するエージェントのパフォーマンスを向上させることで」ループを閉じることができるとしています。例として、エージェントがユーザーデータのログをチェックするテストに繰り返し失敗する場合、「将来の問題を避けるために、CLAUDE.md にフックやより明示的なルールを作成できる」と述べています。
これが以下のすべてのテーマです。一度きりの検証結果は一度しか役に立ちません。記録されたルールとなった検証結果は、その後ずっと役に立つのです。
チームが推奨する3つのテストタイプ
記事では、投資する価値のある3つのテストタイプを挙げ、なぜそれぞれがエージェントに誤魔化されにくいのかを説明しています。
エンドツーエンド(E2E)テスト。 「1つのテストタイプに集中しなければならないなら、エンドツーエンドを選んでください」。これらは実際のユーザーフローを記述するもので、機能全体が動くか動かないかのどちらかです。
プロパティベーステスト。 失敗するはずがないと考えるステートメントを記述すると、ライブラリが数千の入力を生成して、そうではないことを証明しようとします。記事の例には、ラウンドトリップ・エンコーディング、不変条件、べき等性、等価性が含まれます。ポイントは、コードを書いたエージェントと同じバイアスを持たずに作成されたエッジケースを使用することです。
ディファレンシャル(差分)テスト。 同じ入力に対して旧システムと新システムを実行します。結果が異なれば、バグか破壊的変更があることになります。これらは、振る舞いが変わるべきではないマイグレーションに適しています。
また、避けるべき2つの失敗モードも挙げています。不安定な(Flaky)テストは、コードを修正する代わりに再実行することをエージェントに学習させてしまいます。遅いテストは実行回数の減少を意味し、問題の特定を困難にします。
/verify が行うこと、そして保存するもの
チームの第一のルールは、テストよりもアプリを動かすことの方が重要だということです。「シミュレーターで試さずに iOS の変更をリリースすることはないでしょう。Claude も同じです」。
それを再現可能にするために、リポジトリ内の .claude/skills/ フォルダに「関連するコードにできるだけ近い場所に verify という名前のスキルを作成する」よう記事は述べています。さらに、Claude は変更をコミットする前に verify スキルを使用することを理解していると付け加えています。
Claude Code には、標準で /verify も同梱されています。スキルのドキュメントでは、これを「テストや型チェックに頼ることなく、コード変更が意図通りに動作することを確認するためにアプリをビルドして実行する方法」と説明しています。これは、プロジェクトのタイプや README、package.json、Makefile などのファイルからプロジェクトの起動方法を推論することで、設定なしで動作します。ドキュメントはその限界についても率直です。「データベース、環境変数ファイル、グラフィカルセッション、多段階のビルドなど、標準的な起動以上のものを必要とするプロジェクトでは、その推論は信頼できなくなります」。これこそが、手順を書き残しておくことが報われる種類のプロジェクトです。
memory に関わる部分は、実行が成功した後に起こります。ドキュメントによると、「/verify は独自のレシピを記録することもできます」。記録されたレシピなしでアプリをビルドして動かさなければならない場合、「成功した手順をリポジトリルートの .claude/skills/verify/SKILL.md(モノリポジトリの場合は触れたパッケージディレクトリ内)に書き込み、後続の実行や他のエージェントが同じ手順に従えるようにします」。
これは小さく、具体的な学習の一種です。最初の成功した実行で起動手順を解明します。それ以降のすべての実行は、再発見する代わりにその手順に従います。さらに2つの詳細が重要です:
- 記録されたスキルが優先される。 「リポジトリルートでは、記録されたスキルが同梱の
/verifyを置き換えます」。 - 無駄な更新をしない。 「Claude は、コマンドの失敗や手順の欠落など、実行が誤った方向に進んだ場合にのみ記録されたファイルを編集するため、セッションごとの差分を気にせずにファイルをコミットできます」。
関連する同梱スキル /run-skill-generator は、意図的にレシピを記録します。ドキュメントによると、これはクリーンな環境からアプリを起動させ、インストールコマンド、環境変数、起動スクリプトをキャプチャし、プロジェクトごとのスキルとしてコミットします。その後、/run、/verify、およびリポジトリ内の他のエージェントはそれに従います。メンテナンスに関するドキュメントのアドバイスは、「プロジェクトごとに一度 /run-skill-generator を実行し、ビルドや起動プロセスが変わった場合に再度実行してください」というものです。
Claude がコミット前に verify スキルを実行するタイミング
ドキュメントにはもう一つの要素が記されています。「verify または simplify という名前のスキルが配置された状態でセッションが開始されると、Claude Code のコミット指示により、ドキュメントやテストの変更を除き、各コミットの直前にそれを実行するよう Claude に伝えます」。これには Claude Code v2.1.286 以降が必要です。
条件は具体的です。スキルはサポートされている場所からロードされる必要があり、リポジトリルートに /verify が記録したレシピもこれに含まれます。同梱の /verify や simplify、プラグインスキル、claude.ai アカウントからのスキルは対象外です。また、Claude がそのスキルを呼び出せる状態にあり、組み込みの git 指示がオンになっている必要があります。
つまり、レシピを記録することは2つのことを同時に行います。起動手順を保存することと、Claude Code に verify という名前のプロジェクトスキルを与え、各コミット前に Claude が行うべき指示を変化させることです。
チェックリスト:過去の各障害に対するトリガー
ここが、記事の中で最も直接的に memory(記憶)について触れている部分です。
「私たちは39項目の信頼性チェックリストを維持しており、各項目には diff から読み取れるトリガー、チェック内容、そしてその背景にあるインシデントや PR が紐付けられています」。
各項目は3つのパートで構成されています:
- トリガー: diff から読み取れるもので、Claude がその項目を適用すべきかどうかを判断できるようにします。
- チェック: 適用されたときに実行する内容。
- 背景にあるインシデントや PR: ルールとともに理由が記録されるようにします。
記事の例は「--resume が古いトランスクリプトをロードする」というものです。セッションストレージやメッセージタイプが変更されたとき、チームは新しいフィールドが安全にロードされるかを問いかけます。なぜなら、古いトランスクリプトにはそのフィールドが存在しないからです。
そして重要な一文:「Claude は diff を読み、トリガーが一致する項目(通常は3〜10項目)のみをチェックします。そのため、誰も過去の障害を暗記しておく必要がありません」。
2つの設計上の選択が際立っています。チェックリストは、すべての変更に対してリマインダーの壁としてロードされるわけではありません。トリガーが一致する項目のみがチェックされます。そして、すべての項目に履歴が付随しているため、それを書いた人がいなくなった後でもルールが理解可能なまま保たれます。
これが、冒頭の例にあったインシデントメモとチェックリスト項目の違いです。メモは誰かが覚えていることに依存していました。チェックリスト項目は、diff が同じ領域に触れたときに発動します。
互いに積み重なるレビューラウンド
記事では、同じように機能する2つ目の習慣について説明しています。「私たちは、すべてをゼロから再チェックするのではなく、以前のラウンドからの context(コンテキスト)や過去の失敗に各パスを向けます。その方が安価で、より多くの発見があります」。
また、チームはレビュアーの数を増やすのではなく、レビュアーの集中力を維持させるようにしています。2人目のより高価なレビュアーを重ねるのではなく、そのコードに対してレビュアーが注意すべきことを記した REVIEW.md を保持しています。
そのファイルは、それが判定する変更から保護されています。「もし変更が、自身を判定するチェック内容を修正できてしまうなら、そのチェックは壊れています」。記事によると、Code Review は常にベースブランチまたはデフォルトブランチから REVIEW.md を読み込み、プルリクエストの変更内容からは読み込みません。
チームのプロセスにおける他のいくつかのルールも、同じロジックに従っています:
- 繰り返される失敗に対してエスカレーションする。 Claude はチェックを実行し、失敗した箇所の修正を試みます。「3ラウンド経ってもチェックが失敗し続ける場合、Claude は停止し、人間を呼びます」。
- 理由を述べる。 チェックがレビュアーを呼び出す際、レビュアーが diff から理由を推測しなくて済むように、なぜ呼び出したのかを明示すべきです。
- 動く標的ではなく、コミットをレビューする。 「古いコミットに対するパスしたレビューには何の意味もありません」。
- 安価なチェックを先に実行する。 Claude はプルリクエストを開く前に、テスト、ビルド、リンターを実行します。記事では、Claude が終了したときにテストを実行するフックを使用してこれを強制できると述べています。フックができることや、どれが Claude に context を追加できるかについては、Claude Code フックとは何かについてのガイドで詳しく解説しています。
スタンプとゲート:各コミットがどのように検証されたかを記録する
チームは検証結果をコミット自体に記録しています。「自社のリポジトリでは、各コミットにどのように検証されたかのスタンプを押しています」。スタンプには "none" と記すこともできるため、チームは検証されていないコミットをクエリで探すことができます。
また、セッションに /code-review や /verify が含まれていない場合にコミットをブロックできるコミットゲートも構築しました。これには off、observe(観察)、enforce(強制)のモードがあります。observe モードでは、ブロックされたであろう内容をログに記録し、誤検知を先にレビューできるようにします。enforce モードでは、コミットに検証されなかった理由の説明を付与でき、セッション内で2回コミットがブロックされた後は、「Claude が立ち往生しないように」次のコミットが通るようになっています。
これらはチーム独自のツールであり、ブログ記事で紹介されているものです。記事では、スタンプやゲートを Claude Code のオンオフ可能な機能としては提示していません。
見逃されたバグがいかにしてルールになるか
記事の最後のセクションは、見逃しを memory(記憶)に変えることについてです。Claude Code のリポジトリでは、チームは2つの方法を使用しています。
1つ目は、人間のレビューコメントや PR のリバートからパターンを抽出することです。ルールとして検討されるためには、パターンが「少なくとも2つの PR で発生し、diff から識別可能である」必要があります。3つのエージェントがそれを論破しようと試み、人間が PR でレビューして承認します。
2つ目は、既知のインシデントに関連付けられた PR に対して3つのバグ発見器をリプレイさせることです。少なくとも2つがバグを見つければ、それは検出可能です。もし小さな diff でバグが見逃されたなら、それは REVIEW.md のルールにする価値のあるギャップです。
不安定なテストも同様の扱いを受けます。Claude はそれらをスキップしたり、sleep を入れたり、パスするまでリトライしたりすることはできません。根本原因を見つけられない場合、「テストを削除し、その理由を書き残します」。
そして、ルール自体にもメンテナンスが必要です。「ルールもクリーンアップが必要です」。テストスイート、検証ステップ、.md ファイルは、放っておけば増え続けるだけなので、チームは定期的にそれらを整理しています。
記事の締めくくりのアドバイスは、これらを一つにまとめます。検証レイヤーを他のシステムと同じように扱い、「何かを見逃したときは教訓を書き留めて二度と起こらないようにし、それらの教訓が実行する価値を保てるよう剪定(プルーニング)すること」です。
人々が最初に試してしまうこと
インシデントメモを書いて、誰かが覚えていることを期待する。 チームのチェックリストは、各教訓を diff 内のトリガーに紐付けています。
2人目のレビュアーを追加する。 記事では、REVIEW.md を使ってメインのレビュアーを調整することを推奨しています。
毎回 /verify に起動方法を再発見させる。 レシピを .claude/skills/verify/SKILL.md に記録させることができます。
あらゆる見逃しをルールにする。 チームは、少なくとも2つの PR でパターンがあり、diff から読み取れ、人間の承認があることを条件としています。
すべてのルールを永遠に保持する。 ルールは定期的に剪定されます。
解決策:検証結果を次のセッションで使える形にする
ステップ 1: アプリの実行方法を記録する
/run-skill-generator を使用するか、/verify にレシピを記録させ、その結果をコミットします。
ステップ 2: 各教訓にトリガーを与える
バグが発生したときは、diff の何がそれをトリガーすべきか、そしてその背景にあるインシデントを添えてルールを書きます。
ステップ 3: ルールを判定対象の変更から手の届かない場所に置く
レビュー対象の変更によって編集できない場所にレビュー用ルールを配置します。
ステップ 4: ルールの背後にある推論を書き留める
トリガーはルールがいつ適用されるかを示します。その背後にある決定事項や、それを引き起こしたインシデントには、永続的な保管場所が必要です。
MemoryLake でのセットアップ
チェックリストの項目が機能するのは、そこに履歴が伴っているからです。プロジェクトの背後にある決定事項についても同じことが言えます。なぜそのチェックが存在するのか、どのアプローチが試され、ボツになったのか、そしてインシデントから何を学んだのか。
MemoryLake は、決定事項、インシデントからの教訓、ルールの背後にある理由など、プロジェクトの context のための memory レイヤーです。これらを一箇所で管理し、ChatGPT、Claude Code、Codex などの接続されたアシスタントから利用できるようにします。
エントリーはあなた自身の言葉で書きます。あなたのスキル、REVIEW.md や CLAUDE.md ファイル、セッション、コミット、あるいはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。/verify や Code Review は、Anthropic が説明している通りに動作します。
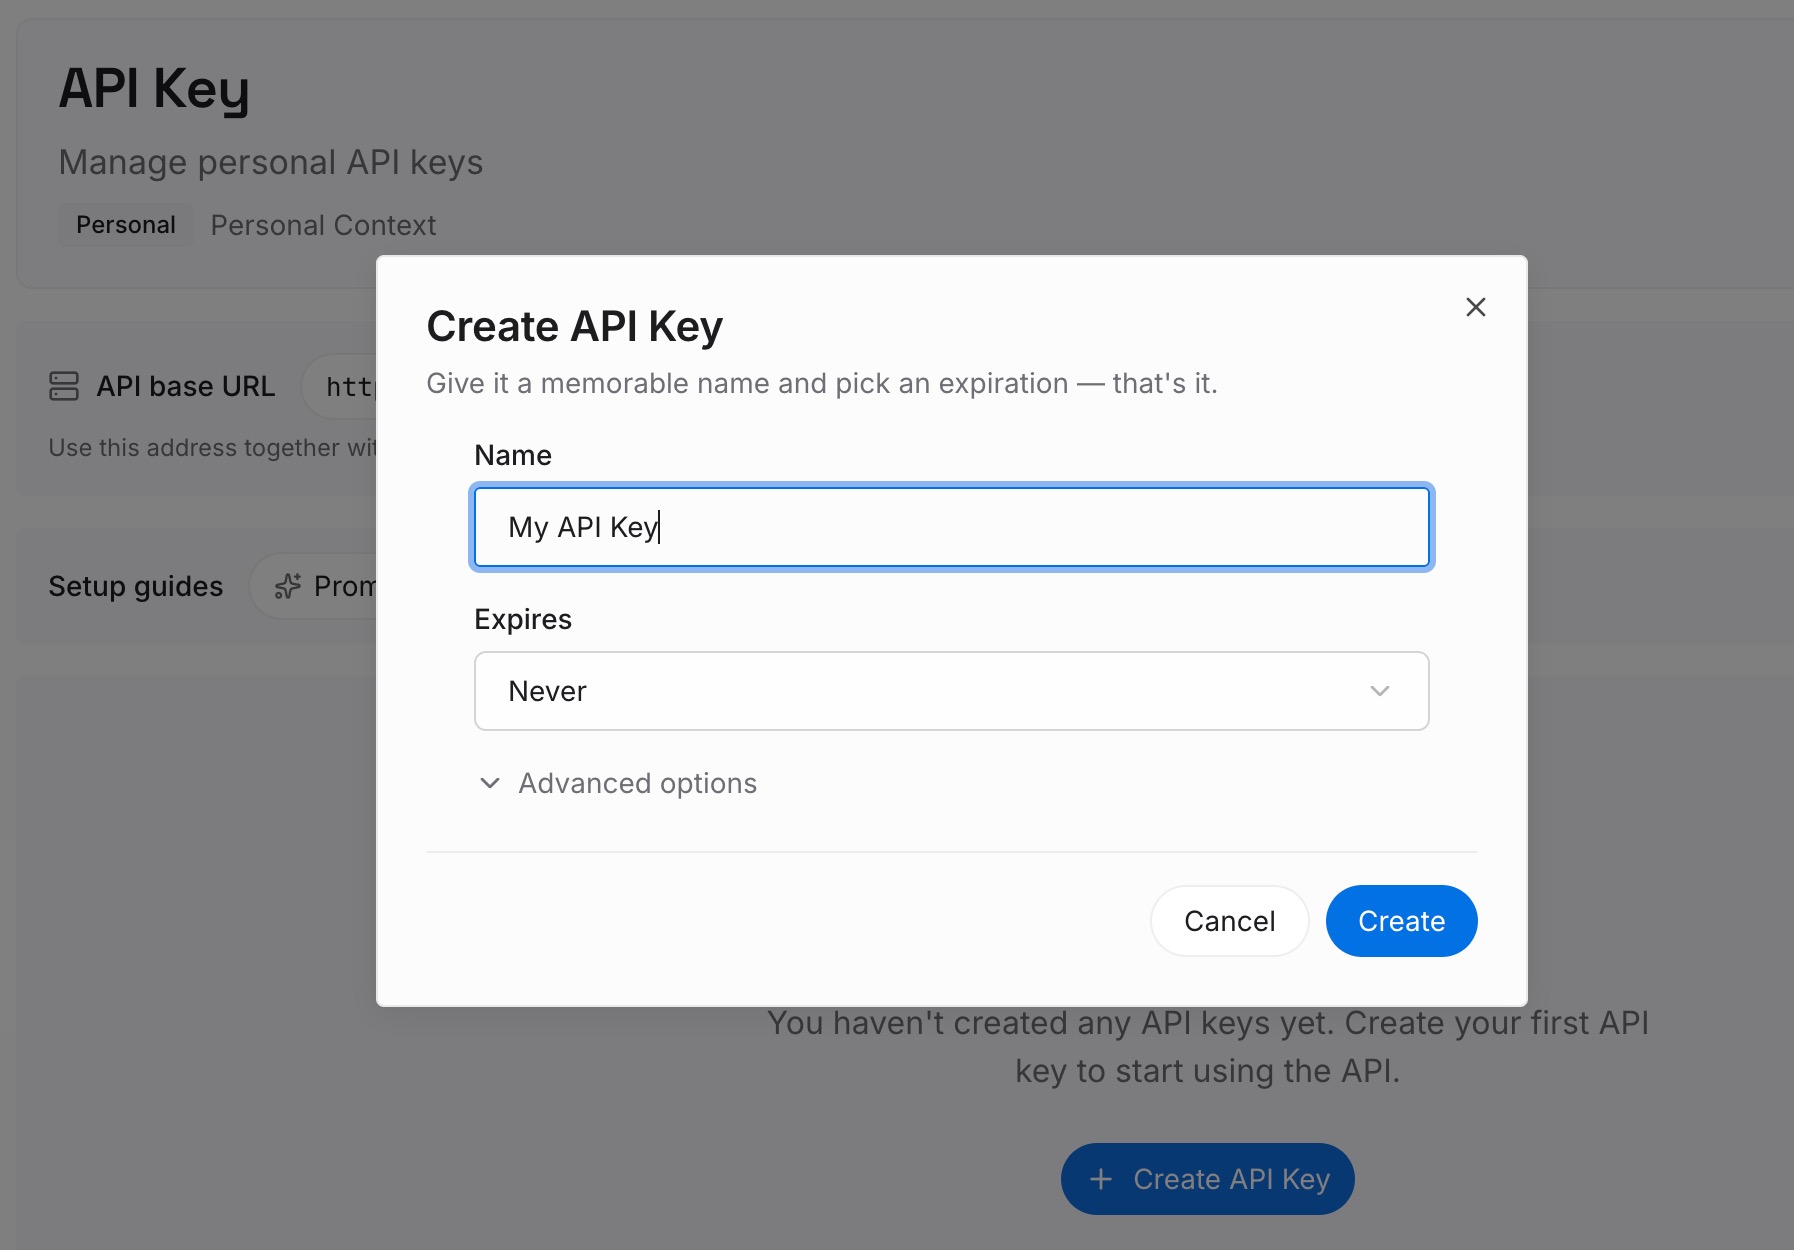
ステップ 1: API キーを作成する
サインインしてダッシュボードからキーを生成します。他の認証情報と同様に、リポジトリの外に保存してください。
ステップ 2: 最初の memory をアップロードする
解決策のステップ 4 で書いた内容から始めましょう。ルールの背後にあるインシデントと、それぞれから学んだ教訓です。1つのエントリーに1つの教訓を、日付とともに記載します。
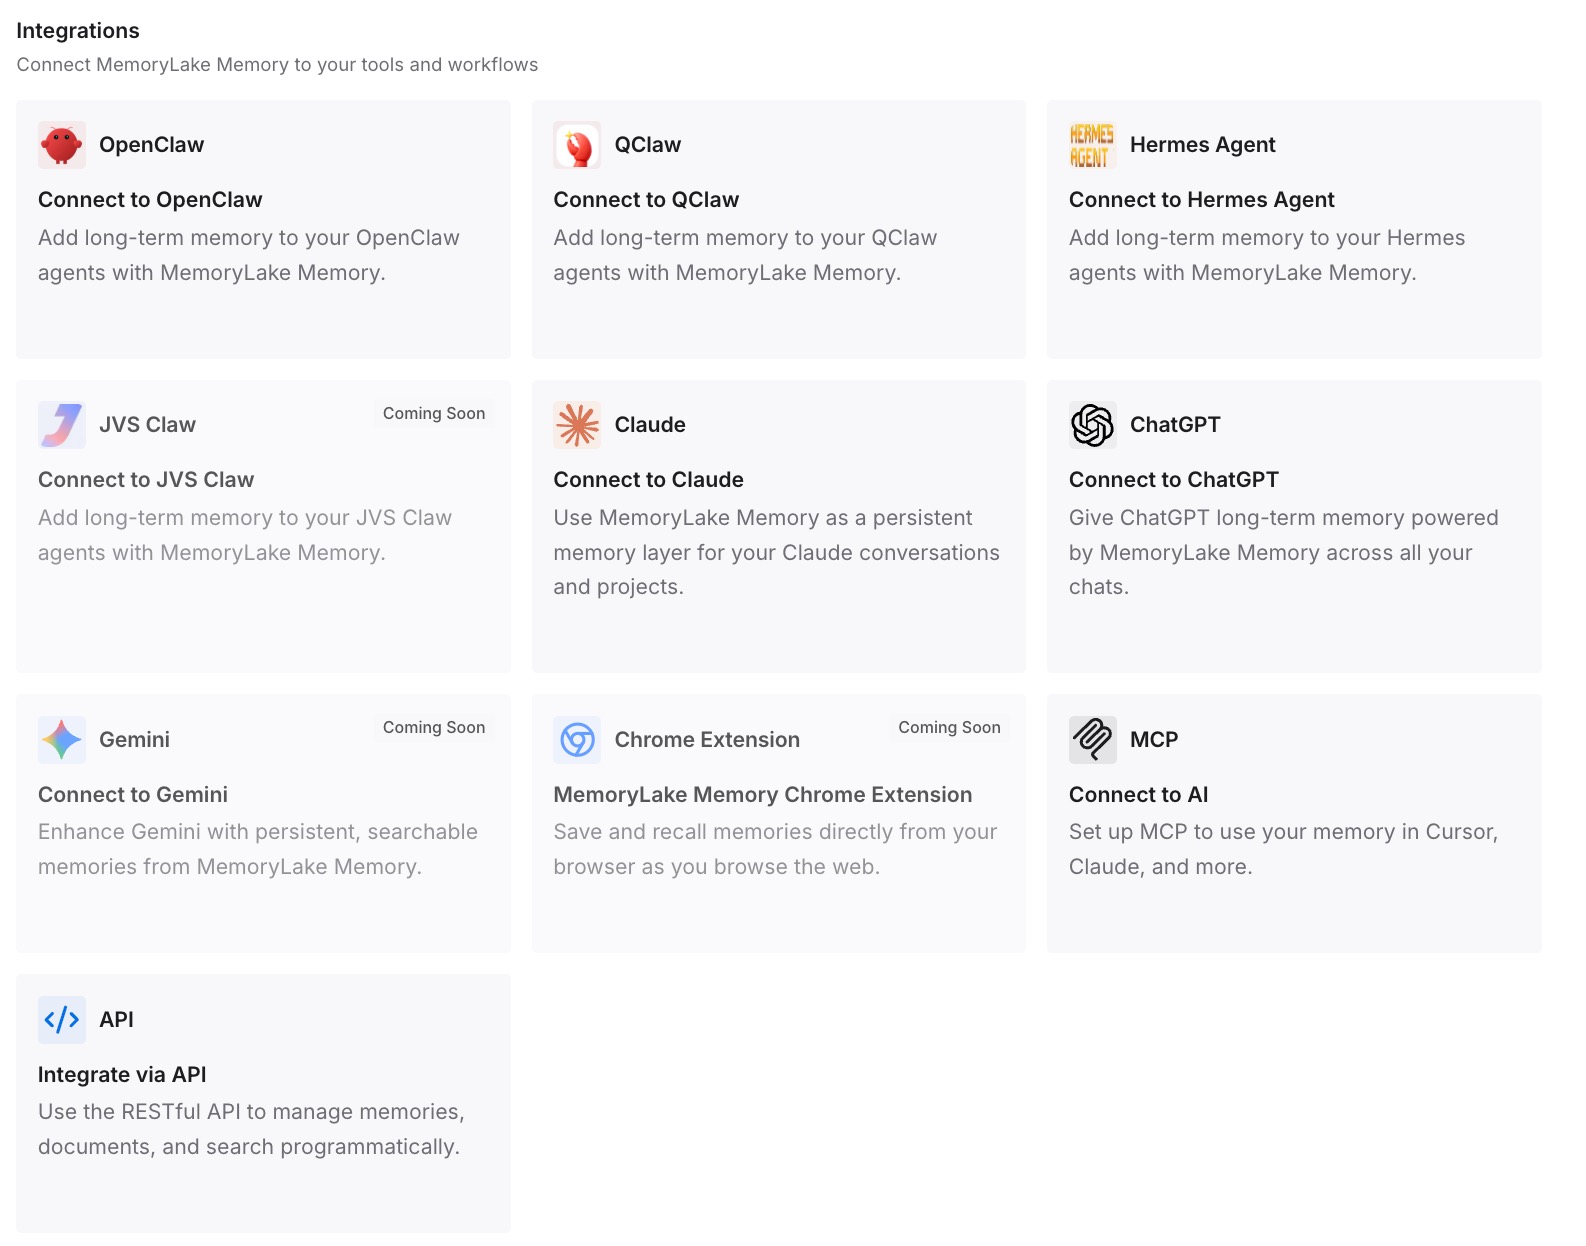
ステップ 3: AI とエージェントを接続する
Claude Code や、使用している他のアシスタントを接続します。新しいセッションやチームメイトのアシスタントも、同じ教訓を活用できるようになります。
実践で何が変わるのか
第一の違いは、教訓がそれを学んだ人よりも長生きすることです。ルールの理由が書き残されます。
第二に、再発見が減ります。記録されたレシピと記録された決定事項の両方が、次のセッションで同じことを解明する手間を省きます。
第三に、ツール間で context が共有されます。同じプロジェクトに取り組む Codex や他のアシスタントも、同じ教訓を利用できます。
Claude の成果を検証するためのベストプラクティス
アプリをエンドツーエンドで実行する。 チームはこれをテストよりも重要視しています。
起動レシピを記録する。 動作したら .claude/skills/verify/SKILL.md をコミットします。
ルールにトリガーを与える。 diff が触れた部分のみをチェックします。
ルールに履歴を添付する。 各項目にインシデントや PR を紐付けておきます。
以前のラウンドを基に構築する。 各パスを過去の失敗に向けます。
繰り返される失敗の後はエスカレーションする。 チームは3ラウンド後に人間を介入させます。
ルールを剪定する。 ルールは放っておくと増える一方です。
結論
Claude Code チームの検証プロセスは、テストと同じくらい memory(記憶)に関するものです。/verify は成功した手順を .claude/skills/verify/SKILL.md に記録でき、後続の実行や他のエージェントがそれに従えるようにします。チームの信頼性チェックリストは、各教訓にトリガー、チェック、背景となるインシデントを与え、Claude は diff が一致する項目のみをチェックします。レビューラウンドは過去の失敗を指し示し、見逃されたバグは繰り返され、人間が承認した後にのみルールとなります。
共通しているのは、教訓は次のセッションが見つけられる場所に、理解を保つのに十分な履歴とともに書き残されなければならないということです。