
Codex 0.165.0 で何が変わったのか
リリースノートの「新機能」セクションには、memory に関する2つの項目が挙げられています。
- 新規プロファイルでは Memory v2 がデフォルトになります。
- Codex は外部エージェントからの memory を v2 にインポートできるようになります。
これらの背景にあるプルリクエスト(PR)には、リリースノート以上の詳細が記されています。「Default fresh memory profiles to v2」というタイトルの最初の PR では、その理由を次のように述べています。「v1 の memory ワークスペースを持たないプロファイルには、v2 を使用する前に保存または統合すべきレガシーなコンテキストが存在しないためです。」
2つ目の PR では、以前の問題点が説明されています。「以前の外部エージェント memory のインポートは v1 ワークスペースへの書き込みと v1 の統合キューイングのみを行っていたため、v2 パイプラインにはインポートされたリソースが反映されない状態でした。」
つまり、このリリースまでは、v2 パイプラインを実行しているマシンで他のエージェントから memory をインポートしても、その内容は v2 に届いていませんでした。バージョン 0.165.0 はそのギャップを埋めると同時に、引き継ぐべき古い memory を持たないマシンの起点を v2 に設定しました。
変わらない点
バージョンの詳細に入る前に、今回のアップデートで変更されない点を確認しておきましょう。
Memory は依然としてデフォルトでオフです。 Codex のドキュメントには「ローカルの Codex memory はデフォルトでオフになっています」とあります。ChatGPT デスクトップアプリの「Settings > Personalization」にある「Enable Codex memories」、または config.toml の機能フラグで有効にする必要があります。バージョンの変更は、memory がオンになって初めて意味を持ちます。
Memory は依然としてローカルです。 ドキュメントには「ローカルの Codex クライアントは、個別のローカル memory ストアとコントロールを使用する」とあり、ChatGPT ウェブ版は代わりに ChatGPT の memory を使用すると記されています。リリースノートには、両者をリンクさせるような記述はありません。
ファイルは依然として「生成された状態」です。 OpenAI のガイダンスは変わっていません。「これらのファイルは生成された状態(generated state)として扱ってください。トラブルシューティングや Codex ホームディレクトリを共有する前に検査することは可能ですが、主要な操作手段として手動で編集することに依存しないでください。」
チャットごとの制御も同様です。 /memories コマンドは、現在のチャットが既存の memory を使用できるか、また将来の memory に寄与するかを制御します。「チャットレベルの選択によって、グローバルな memory 設定が変更されることはありません。」
お使いのマシンが使用している memory バージョン
Codex に付属する設定スキーマでは、バージョンの設定について次のように説明されています。「memory パイプラインを選択します。memory が有効な場合、新規プロファイルはデフォルトで v2 になります(dual-write が明示的に無効化されている場合を除く)。既存の v1 プロファイルはデフォルトで v1 になります。」
PR には、Codex が適用する正確なテスト条件が記されています。「memory が有効で、かつ memories ディレクトリが存在しない場合に v2 を選択する。」また、変更を加えないケースについても列挙されています。「明示的な memories.version 設定、memories.dual_write = false によるオプトアウト、および既存のワークスペースやファイルシステムチェックのエラー時における v1 デフォルト設定は維持されます。」
平たく言えば、memory がオンのとき、Codex は Codex ホームディレクトリを確認します:
memoriesディレクトリがまだ存在しない場合: Codex はそのプロファイルを新規とみなし、v2 を使用します。memoriesディレクトリが既に存在する場合: Codex は v1 を維持し、構築済みの memory を引き続き使用します。- 自分でバージョンを設定している場合: Codex はその設定を尊重します。
- ファイルシステムを確認できない場合: v1 にフォールバックします。
決定要因は Codex をインストールした日付ではなく、ディレクトリの有無です。数ヶ月前にインストールしていても、memory を一度も有効にせず memories ディレクトリがない場合は、PR のルールに従い、有効化した時点で v2 が適用されます。
dual-write とは何か
スキーマには2つ目の設定 memories.dual_write があり、「v1 が選択されている間、両方のバージョンを生成します。カットオーバー後は v2 が単独で動作します」と説明されています。
これは移行プロセスを示しています。v1 を使用しているマシンでも、並行して v2 の memory を構築できるため、v2 に移行した際に既にデータが存在する状態にできます。memories.dual_write を false に設定することは、デフォルト設定が尊重する選択肢の一つであり、その場合、新規プロファイルがデフォルトで v2 に移行することはありません。
memories.version も memories.dual_write も、まだ Codex の設定リファレンスには登場していません。これらはスキーマと PR から判明した情報であるため、今後変更される可能性がある現在の挙動として扱ってください。
各バージョンのファイル保存場所
ドキュメント化されている場所は v1 のストアです。「主要な memory ファイルは ~/.codex/memories/ 下にあり、要約、永続的なエントリ、最近の入力、および以前のチャットからの裏付けとなる証拠が含まれます。」
v2 のワークスペースは別のディレクトリです。インポートに関する PR では、「選択されたリソースを常に memories_v2 にインポートする」と名前で言及されています。CODEX_HOME で Codex ホームを移動している場合、両方のディレクトリは ~/.codex ではなく、その指定先に配置されます。
リセットに関する小さな変更もあります。PR によると、「存在しない memory ワークスペースのリセットをノーオペレーション(何もしない)にすることで、未使用の v1 ディレクトリが作成されないようにした」とのことです。新しいマシンで memory をリセットしても、Codex がプロファイルを v1 だと誤認させるような空の memories フォルダが残ることはなくなりました。
インポートされた Claude Code Memories の保存先
Codex のインポートフローは、他のエージェントの設定や最近の作業内容を ChatGPT デスクトップアプリや Codex CLI に取り込みます。インポートのドキュメントには、移行可能な項目がリストされています。指示ファイルは AGENTS.md に、設定は config.toml になり、memory の行には「Claude Code からのプロジェクト memory を、保存先として Memories へ」と記されています。
インポートに関する PR では、それらの memory に何が起こるかが説明されています:
「選択されたリソースを常に memories_v2 にインポートする。また、v1 が選択されているかレガシーワークスペースが存在する場合は memories も更新する。」
つまり:
- v2 プロファイルの場合、インポートされた memory は
memories_v2に入ります。 - v1 プロファイルの場合、両方に入ります。Codex は現在使用しているパイプラインのために
memoriesに書き込み、将来のためにmemories_v2にも書き込みます。
インポート後、Codex は変更した各ワークスペースに対して統合(consolidation)パスをキューに入れます。PR によると、「更新された名前空間ごとに個別に統合をエンキューする」とし、インポートされた memory を統合するための指示を「アクティブなパイプラインの出力形式」に適応させます。インポートされた memory は、そのままコピーされるファイルではなく、Codex が独自の memory 形式に折り畳むための「素材」として扱われます。
同リリースの3つ目の PR では、インポートと統合パスが同じワークスペースを同時に変更することを防いでいます。保存先が使用中の場合、Codex は「保存先がロックされている場合はリトライ可能なビジーエラーを返し、ワークスペースがビジーな場合は統合をスキップする」ようになります。インポートでビジー報告が出た場合は、少し待ってから再実行してください。PR のテストでは、この状況でデータが中途半端に書き込まれることはないことが確認されています。
インポートが関与しないもの
インポートのドキュメントには、「インポートによって既存のエージェント設定が変更または削除されることはありません」とあります。Claude Code の memory ファイルは元の場所に残ります。
CLI のインポートには、計画を立てる前に知っておくべき制限もあります。「Codex CLI は、過去30日間の最大50件のチャットをインポートします。」また、/import は「タスクの実行中、リモートセッション中、またはローカルのアプリサーバーデーモンに接続している間は利用できません。」デスクトップアプリでは、「Settings > Import」で自動更新をオンにすることで、インポートした作業内容を元のエージェントと同期させ、インポート履歴を確認できます。より広範な移行については、Claude Code から Codex への移行ガイドで、指示、MCP サーバー、スキルについて解説しています。
ドキュメントにまだ記載されていないこと
リリースノート、スキーマ、PR はいずれも v2 について記述していますが、Codex ドキュメントの memory ページでは依然として ~/.codex/memories/ 下の単一ストアについて説明されています。
そのため、以下の点が不明確なままです:
- v2 が memory の品質をどう変えるか。 PR では v2 ファイルの保存先や使用タイミングについては述べられていますが、memory の内容がどのように異なるかについては触れられていません。
- v1 マシンがどのように v2 へ移行するか。 スキーマには「カットオーバー」への言及がありますが、リリースノートにもドキュメントにも、それがいつ、どのように発生するかは記されていません。
- デスクトップアプリにバージョンが表示されるか。 ドキュメントにある Personalization 設定には、バージョンに関する記述はありません。
ドキュメントが更新されるまでは、Codex ホーム内のフォルダが、お使いのマシンが何を使用しているかを示す最も直接的なサインです。今回のリリースのもう一つの PR では、アプリがチャットの memory 要約を「スレッドの解決済み memory バージョン」から読み取る実験的な方法が追加されており、「別のバージョンへのフォールバック」は行われません。これは開発者向けのインターフェースですが、2つのバージョンが統合されるのではなく、切り離して管理されていることを裏付けています。
よくある勘違い
アップデートで memory がオンになったと思い込む。 そうではありません。memory は有効にするまでオフのままです。アップデートは、有効にしたときに「どのバージョンになるか」を決定するだけです。
すべてのマシンが v2 に移行したと思い込む。 既存の memories ディレクトリがないプロファイルのみが v2 で開始されます。v1 の memory を持つマシンは、デフォルトで v1 のままです。
Codex の記憶を修正するために memory ファイルを編集する。 OpenAI はこれらを「生成された状態」として扱うよう求めています。2つのワークスペースがある場合、一方のフォルダを手動で編集しても、アクティブなパイプラインが読み取る内容とは異なる可能性があります。
インポートされた memory が一言一句そのまま表示されると期待する。 それらは Codex 独自の形式で統合プロセスを経て保存されます。
Codex ホームを新しいコンピュータにコピーして、同じバージョンになることを期待する。 コピーしたフォルダの内容によって決まります。Codex を新しいコンピュータに移行するガイドで、何を持っていくべきかを確認してください。
解決策:バージョンの確認、意図的なインポート、ルールの分離
ステップ 1:memory をオンにする前後に Codex ホームを確認する
CODEX_HOME を設定していない限り ~/.codex である Codex ホームを開き、どの memory フォルダが存在するか確認してください。memories フォルダがあれば v1 ワークスペースです。memories_v2 フォルダがあれば、v2 を使用しているか、dual-write またはインポートによって作成された v2 ファイルが存在することを意味します。
一度も memory を使用したことがないマシンでこれから有効にする場合は、v2 になることを想定してください。当面の間、ドキュメント化されている v1 の挙動を維持したい場合は、PR のルールに従い明示的な memories.version 設定が尊重されますが、このキーはまだ設定リファレンスにないため、依存する前に使用しているバージョンのリリースノートを確認してください。
ステップ 2:インポート前に内容を精査する
Claude Code は独自の自動 memory を ~/.claude/projects/<project>/memory/ 下にプレーンな Markdown として保持しており、MEMORY.md というインデックスがあります。インポートを実行する前に、プロジェクトのフォルダを開いて内容を読んでください。そこにある古い情報は、Codex が自身の memory に統合する素材になります。
その上で、必要なものだけをインポートしてください。CLI では、ローカルセッションから /import を実行し、Claude Code を選択します。デスクトップアプリでは、「Settings > Import」を開きます。ワークスペースがビジーであると表示された場合は、少し待ってから再試行してください。
ChatGPT 側からコンテキストを持ち込む場合は、ChatGPT の memory を Codex に移行するガイドで、その経路がなぜ異なる仕組みなのかを確認してください。
ステップ 3:必ず適用すべきルールは AGENTS.md に置く
memory のドキュメントにはこう明記されています。「チームで必要なガイダンスは AGENTS.md やチェックインされたドキュメントに保持してください。memory は役立つ想起レイヤーとして扱い、常に適用されるべきルールの唯一の情報源とはしないでください。」
バージョンの変更は、このアドバイスを再確認する良い機会です。ある慣習が Codex の memory や Claude Code の自動 memory にしか存在しない場合は、それを AGENTS.md やリポジトリのドキュメントに書き込んでください。そうすれば、すべてのセッションとすべてのバージョンで同じように読み取られます。Codex が AGENTS.md のルールをスキップするのを防ぐガイドでは、Codex がそれらのファイルをどのように見つけるかを解説しています。
MemoryLake でのセットアップ
Codex には 2 つのローカル memory ワークスペースがあり、Claude Code にはプロジェクトごとに独自の memory フォルダがあります。それぞれが各ツールによって、そのツールの形式で、特定のマシン上に生成されます。すべてのエージェントに共通して守らせたい決定事項は、マシンがどのパイプライン上にあるかに依存しない場所に置く必要があります。
MemoryLake は、そのようなコンテキストを一つのリストとして維持し、Codex や、接続している Claude Code、ChatGPT などの他のアシスタントから利用できるようにする memory レイヤーです。
エントリは自分自身の言葉で書き込みます。~/.codex/memories/、memories_v2、Claude Code の自動 memory、インポートされた設定、あるいはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。Codex 自身の memory は、OpenAI が説明している通りの動作を続けます。
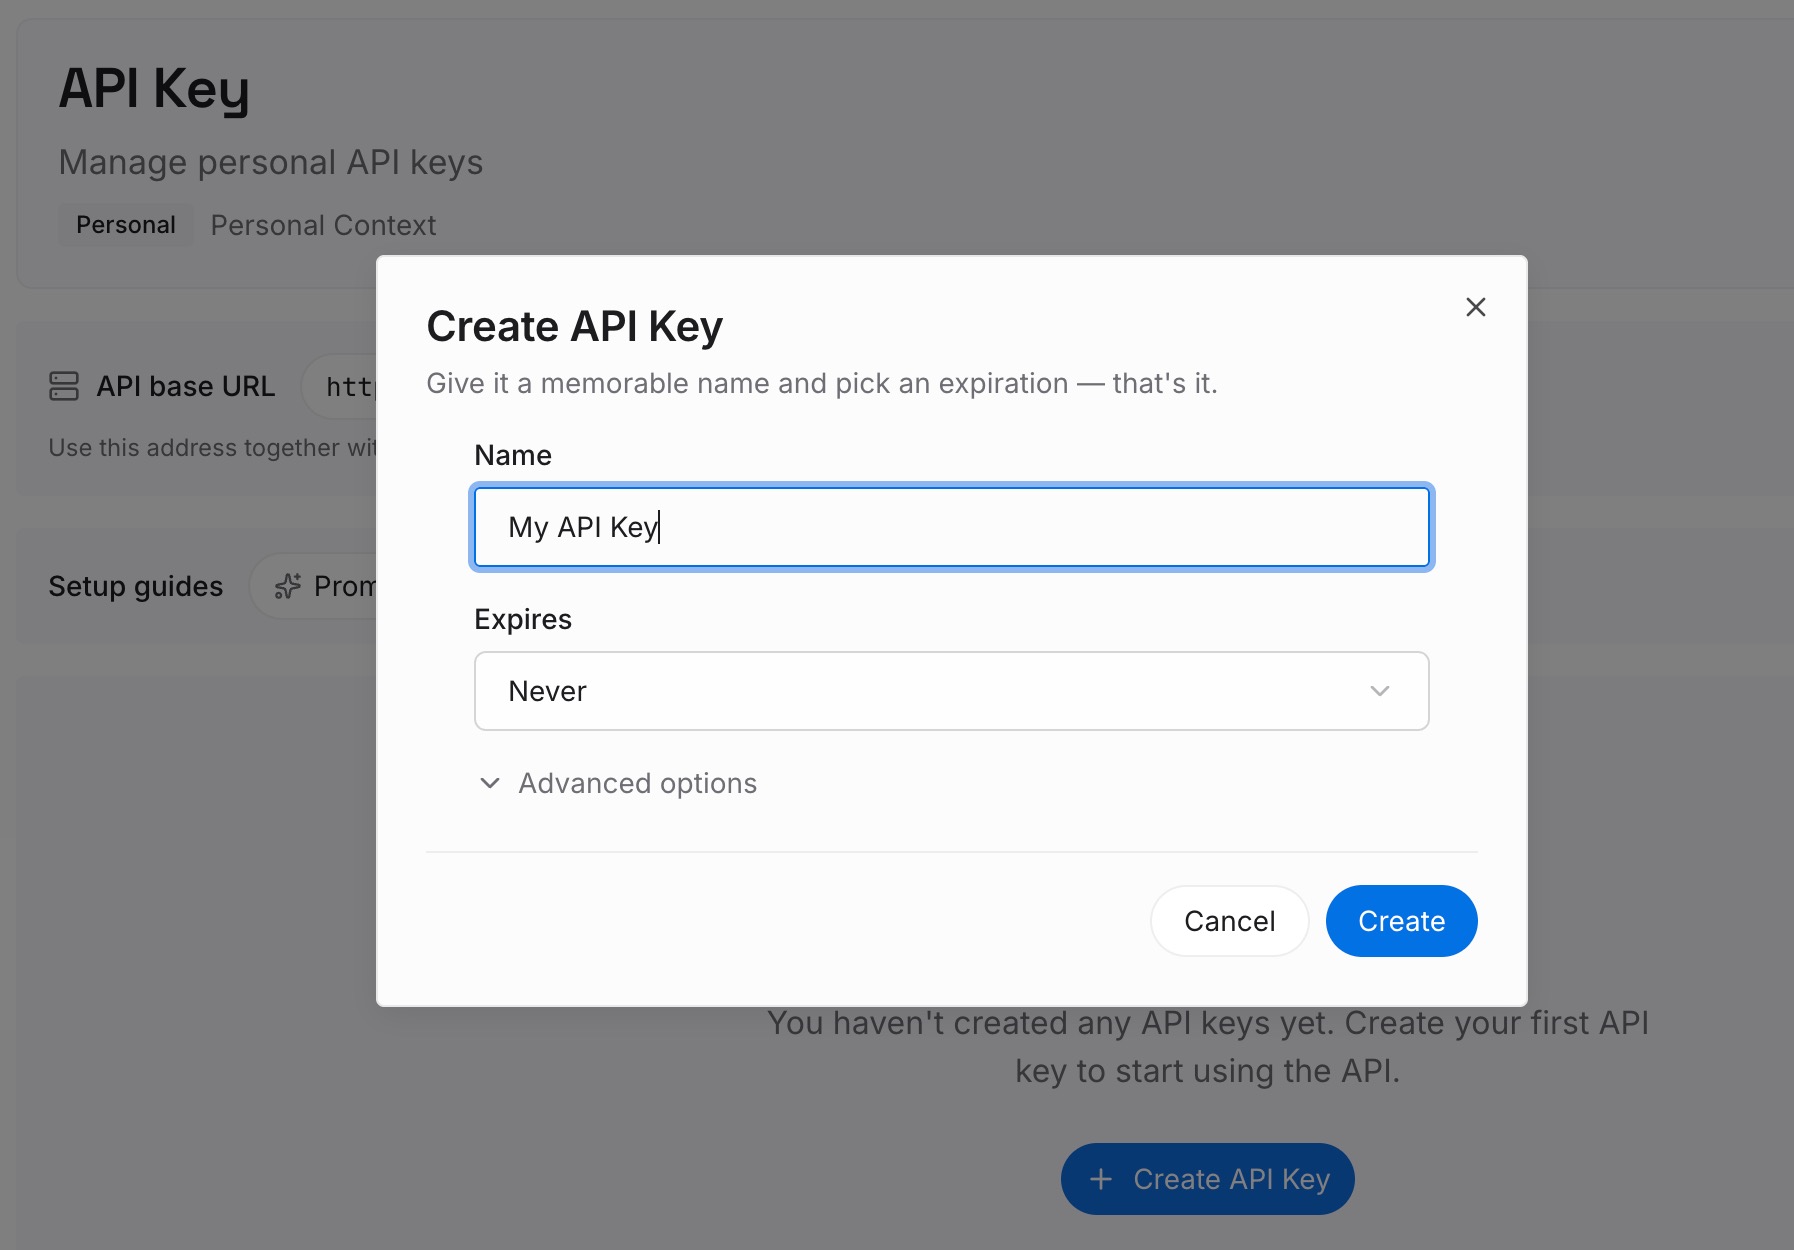
ステップ 1:API キーを作成する
サインインしてダッシュボードからキーを生成します。このキーは MemoryLake ワークスペースに属するもので、ChatGPT アカウントや Codex の設定とは別物です。
ステップ 2:最初の memory をアップロードする
解決策のステップ 2 で確認した内容、つまり Claude Code の memory から引き継ぐ価値のある慣習、決定事項、既知の落とし穴から始めましょう。1つのエントリに1つのポイントを絞り、日付を入れ、適用されるリポジトリのラベルを付けます。
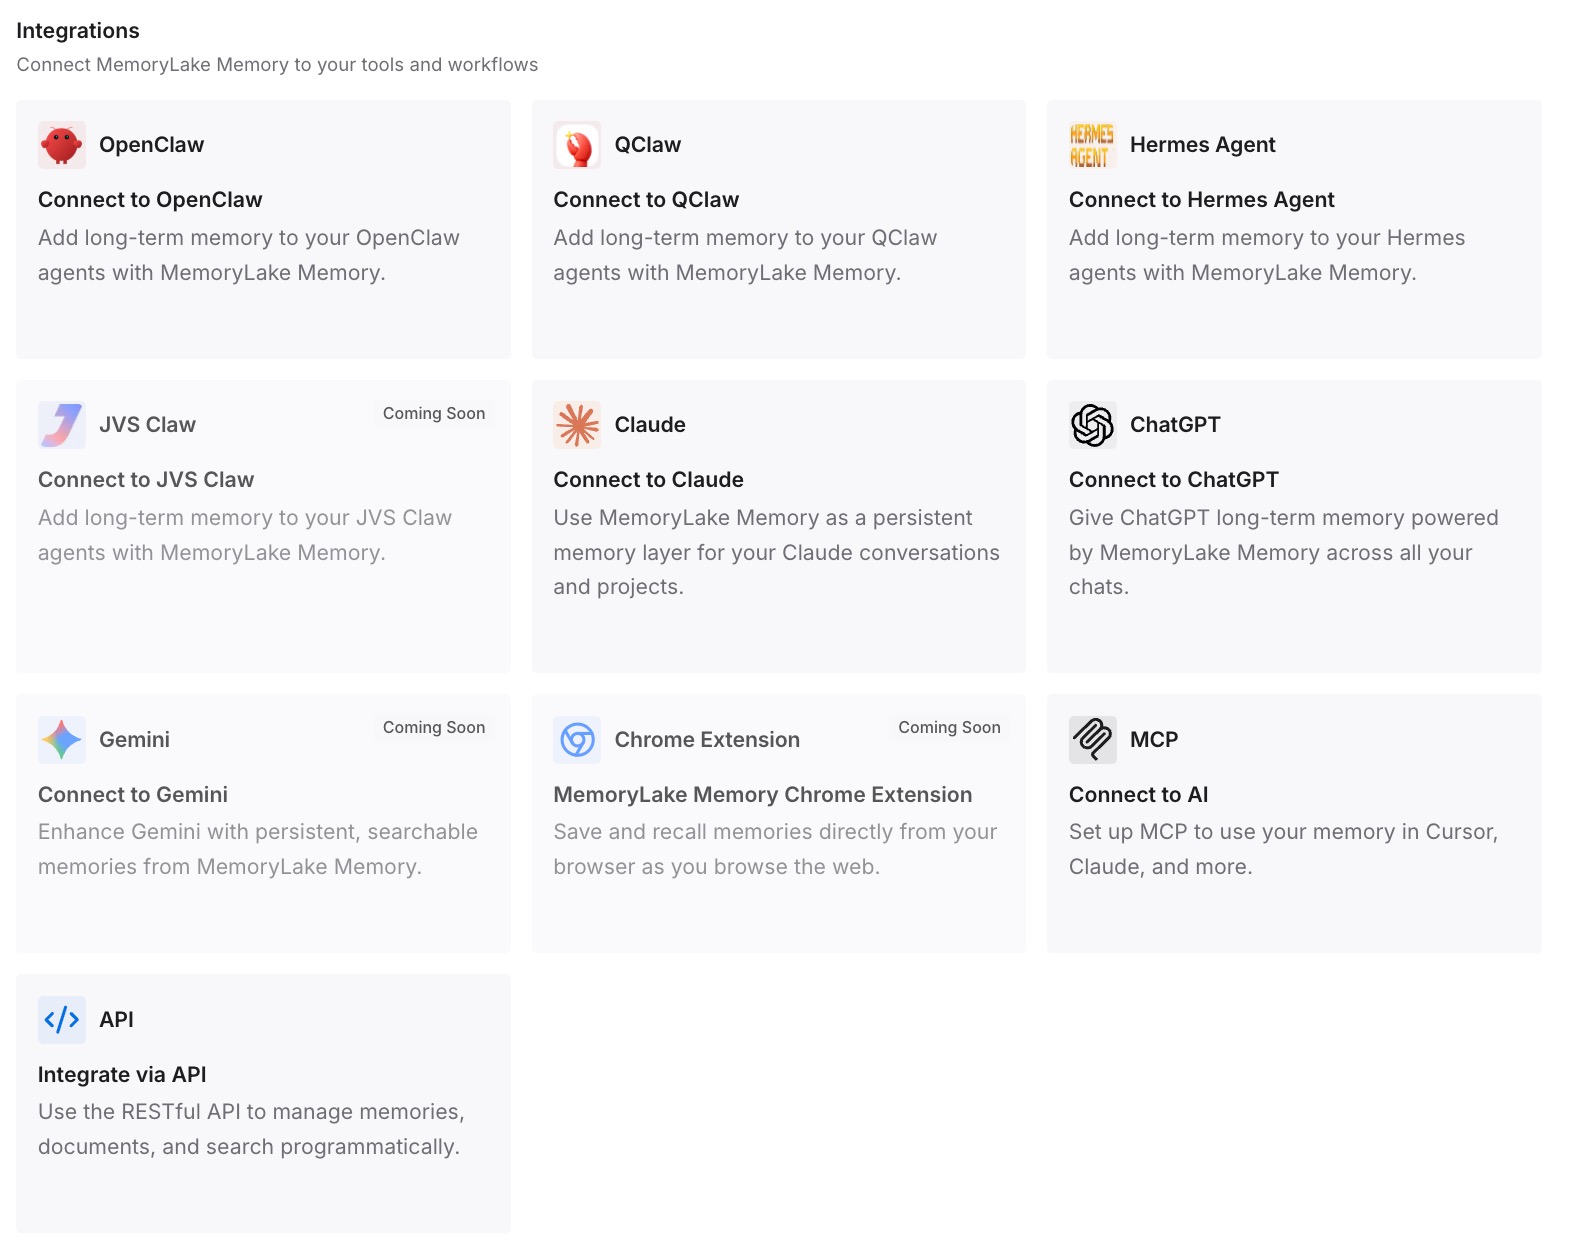
ステップ 3:AI とエージェントを接続する
Codex や、使用している他のアシスタントを接続します。信頼しているコンテキストは、マシンの memory バージョンが変わったり、ツールを切り替えたりしても変わりません。
実務上の変化
第一の違いは、自分が見ているストアがどれかを把握できることです。memories フォルダと memories_v2 フォルダは別物であり、アップデートはディスク上の既存の状態によってどちらかを選択します。
第二に、インポートが謎ではなくなります。v1 では両方のワークスペースに入り、v2 では一方に入ります。いずれにせよ、Codex はそれらを自身の形式で書き換えます。
第三に、依存しているルールがバージョンに左右されなくなります。それらは AGENTS.md やドキュメントにあり、Codex は memory パイプラインに関係なくそれらを読み取ります。memory ではなくチャット履歴を探している場合は、見つからない Codex チャット履歴を探すガイドで保存場所を確認してください。
0.165.0 以降の Codex memories ベストプラクティス
Codex ホームで memories と memories_v2 を確認する。 フォルダが現状を物語っています。
既存のマシンで v2 だと思い込まない。 v1 ワークスペースがあれば、デフォルトで v1 が維持されます。
Claude Code の memory ファイルをインポート前に読む。 古いメモは古い memory になります。
ワークスペースがビジーと報告されたらインポートを再実行する。 リトライを前提とした設計になっています。
生成されたファイルには手を触れない。 代わりに /memories、Personalization 設定、またはリセットを使用してください。
必要なルールは AGENTS.md に置く。 memory はあくまで想起レイヤーです。
リリースノートを注視する。 ドキュメントにはまだ v2 の記載がないため、リリースノートが最も早い情報源になります。
結論
Codex 0.165.0 では、v1 memory ワークスペースを持たないプロファイルのデフォルトが memory v2 になり、Claude Code からインポートされた memory も v2 に送られるようになりました。既に v1 memory を持っているマシンはデフォルトで v1 のまま維持され、そこでのインポートは両方のワークスペースに書き込まれます。memory は依然としてデフォルトでオフ、ローカル保存であり、手動で編集すべきではない生成ファイルです。
Codex ホームにどのフォルダが含まれているかを確認し、インポート前に Claude Code の memory を精査し、常に適用されるべきルールは AGENTS.md に保持するようにしてください。