
Codexにおけるウェブ検索の仕組み
Codexにはウェブ検索ツールが組み込まれています。OpenAIのドキュメントには警告付きで次のように説明されています。「ChatGPTにはファーストパーティのウェブ検索ツールが含まれています。すべてのウェブ検索結果は信頼できない入力として扱ってください。」
Codexがいつ検索を行ったかを確認できます。ドキュメントによると、「検索は対話型トランスクリプトおよび codex exec --json の出力に web_search アイテムとして表示されます。」 IDE拡張機能でも、検索アクティビティはチャットトランスクリプトに表示され、ドキュメントには「拡張機能は接続されているCodexホストの検索モードを使用します」と記されています。
重要なのは、結果がどこから来ているかです。それは検索モードによって決まります。
キャッシュ検索とは何か
Codexの設定ドキュメントでは、デフォルト設定について詳しく説明されています。「キャッシュはOpenAIが管理するウェブ結果のインデックスです。そのため、キャッシュモードはライブページを取得する代わりに、インデックス済みの結果を返します。これにより、任意のライブコンテンツからのプロンプトインジェクションへの露出を減らすことができます。」
つまり、キャッシュモードでは、Codexは質問した瞬間にそのページを訪問しているわけではありません。インデックスから結果を読み取っています。これが冒頭の例の原因です。非常に最近公開または更新されたページは、まだ反映されていない可能性があります。
このトレードオフは意図的なものです。ライブページには、エージェントを操作するために書かれた指示が含まれている可能性があります。インデックスを使用することでその露出を減らせますが、ドキュメントではリスクを「排除」するのではなく「軽減」すると慎重に表現されています。
4つの検索モード
Codexの設定リファレンスには、web_search 設定の4つの値がリストされています。ドキュメントではそれぞれ次のように説明されています。
- Cached(キャッシュ)はデフォルトです。ウェブ検索キャッシュから結果を提供します。
- Indexed(インデックス済み)は、検索インデックスがリクエストをゲートする場合にのみ、外部ウェブアクセスを許可します。
- Live(ライブ)は、ウェブから最新のデータを取得します。ドキュメントによると、これは
--searchフラグと同じ動作です。 - Disabled(無効)は、ウェブ検索ツールをオフにします。
デフォルトには1つの例外があります。ドキュメントには「Codexがフルアクセスで実行される場合、ウェブ検索はデフォルトでライブ結果になります」とあります。したがって、フルアクセスでCodexを実行している場合は、何も設定しなくてもすでにライブ結果を取得している可能性があります。
キャッシュ結果で十分な場合
日常的な多くの作業において、インデックスで十分です。
- 定評のあるライブラリ関数の仕組みを調べる。
- 頻繁に変更されないドキュメントページを探す。
- 設計上の決定のための背景調査を行う。
- すでに一定期間書かれているアプローチを比較する。
これらのケースでは、インデックスに必要な情報が含まれている可能性が高く、ライブコンテンツへの露出を低く抑えることができます。
ライブ結果に切り替えるべきタイミング
ドキュメントのガイダンスは簡潔です。「タスクが最新の情報に依存する場合は、ライブ検索を使用してください。」
これには以下のようなタスクが含まれます。
- 今日公開されたリリースの確認。
- ステータスページやインシデントレポートの現在の状態の確認。
- 頻繁に更新される変更履歴(changelog)の参照。
- 修正や非推奨化が反映されたことの確認。
単発の実行には、CLIフラグがあります。ドキュメントには「CLIで --search を渡すと、1回の実行に対してライブ結果を取得します」とあります。これにより、デフォルト設定は変更されません。
恒久的な変更を行うには、設定ファイルでモードを設定します。ドキュメントでは、config.toml で web_search の値を live に設定するか、ツールをオフにするには disabled に設定するよう指示されています。
モードの変更方法
設定はCodexの設定ファイルに記述します。Codexの設定ドキュメントには、値が解決される優先順位(高い順)がリストされています。
- CLIフラグおよび
--configによるオーバーライド。 - プロジェクト設定ファイル(
.codex/config.toml)。作業ディレクトリに近いものから優先(信頼されたプロジェクトのみ)。 --profileで選択されたプロファイルファイル。- ユーザー設定(
~/.codex/config.toml)。 - クラウド管理のデフォルト(ワークスペースに配信されている場合)。
- システム設定(存在する場合)。
- 組み込みのデフォルト。
したがって、プロジェクトごとに独自の検索モードを設定したり、プロファイルによって特定の作業の種類ごとに切り替えたり、単一のコマンドで両方を上書きしたりできます。プロジェクトが「信頼されていない」とマークされている場合、ドキュメントによるとCodexはプロジェクトローカルの設定を含むプロジェクトスコープの .codex/ レイヤーをスキップします。
Codexを長期間使用している場合は、古い設定を確認してください。設定リファレンスでは、[features] 配下の web_search_cached や web_search_request などのレガシーなトグルは非推奨としてリストされています。トップレベルの web_search 設定が未設定の場合、これらは依然としてキャッシュまたはライブにマッピングされますが、web_search を直接設定する方がモードが明確になります。
ウェブ検索が従わないネットワークルール
これはタイトルにある詳細であり、Codexのネットワーク制限を設定している場合に重要になります。
ドキュメントには次のように記載されています。「ウェブ検索はホストされたツールであり、サンドボックス化されたローカルコマンドのネットワークとは分離されています。パーミッションプロファイルのネットワークプロキシやドメイン許可リスト(allowlist)は使用せず、コマンドのネットワークアクセスが無効な場合でも利用可能なままになることがあります。」
つまり、2つの独立したシステムが存在します。
- コマンドネットワーク: パッケージのインストールや
curlなど、Codexが実行するコマンドがネットワークに到達できるか、どのプロキシを経由するか、どのドメインにアクセスできるかを決定するサンドボックスルール。 - ウェブ検索: 独自の設定を持つホスト型ツール。
コマンドのネットワークアクセスをオフにしても、ウェブ検索はオフになりません。コマンド用のドメイン許可リストは、検索が返すサイトを制限しません。
ウェブ検索には独自のドメインフィルタがあります。設定リファレンスでは、tools.web_search のオブジェクト形式について、「検索コンテキストのサイズ、許可された検索ドメイン、およびおおよそのユーザー位置を設定できる」と説明されています。また、これらのフィルタは「サンドボックス化されたコマンドのネットワークドメインルールとは別個のものであり、コネクタや MCP サーバーを制限するものではない」と付け加えられています。
ウェブ検索のページでも、逆の視点から同様のことが述べられています。「検索ドメインフィルタは、ローカルコマンドのトラフィック、アプリ、コネクタ、または MCP サーバーを制限しません。」
両方を制限したい場合は、両方の設定が必要です。Codexがサンドボックス外でどのコマンドを実行できるかを決定する方法については、Codex rules のガイドで詳しく解説しています。
管理者による検索モードの制限方法
管理環境向けに、OpenAIのドキュメントは allowed_web_search_modes という要件に言及しています。設定リファレンスでは、これを web_search に許可される値として説明しており、「disabled は常に許可されます。空のリストは実質的に disabled のみを許可します」と付け加えています。
つまり、組織は例えばキャッシュと無効は許可するが、ライブは許可しないといった設定が可能です。ドキュメントでは、コマンドネットワークポリシーを allowed_web_search_modes、承認済み MCP サーバー、およびアプリ、プラグイン、ブラウザ、または Computer Use の機能要件などの制御と組み合わせることを推奨しています。
ウェブ版の ChatGPT では、ドキュメントに「ワークスペースの設定で検索が利用可能かどうかを制限できる」と記されています。
ウェブ検索とCodexメモリの相互作用
Codexは、以前のチャットからの有用なコンテキストをローカルのメモリ(memories)に変換できます。その設定リファレンスには、メモリと検索を接続する設定が含まれています。
メモリのドキュメントでは、memories.disable_on_external_context について次のように説明されています。「true の場合、MCP ツールの呼び出し、ウェブ検索、またはツール検索などの外部コンテキストを使用したチャットをメモリ生成から除外します。」設定リファレンスによると、これはデフォルトで false です。
したがって、デフォルトでは、ウェブ検索を使用したチャットも、他の対象チャットと同様にメモリ生成に寄与する可能性があります。外部コンテンツを取り込んだチャットがCodexの記憶を形成するのを避けたい場合は、このオプションを true に設定してください。ドキュメントには、古いキー名である memories.no_memories_if_mcp_or_web_search もエイリアスとして引き続き受け入れられると記されています。
これは、検索結果が「信頼できない入力」である場合に特に重要です。ウェブページを読み込んだチャットは、その内容の一部がプロジェクトの外部から来たチャットであることを意味します。
プロンプトインジェクションに関する注意
設定ドキュメントの検索に関するセクションは、次のような警告で締めくくられています。「Codexでネットワークアクセスやウェブ検索を有効にする際は注意してください。プロンプトインジェクションにより、エージェントが信頼できない指示を取得し、それに従ってしまう可能性があります。」
キャッシュモードがデフォルトなのは、その露出を減らすためです。ライブモードは、鮮度がより重要な場合のために用意されています。どちらのモードであってもウェブコンテンツが信頼できるものになるわけではないため、Codexが結果をどう扱うか、特にそれに基づいてコマンドを実行する前には必ず確認してください。
よくある誤解と試行
検索結果に今日の変更が反映されることを期待する。 ローカルチャットはデフォルトでキャッシュされたインデックスを使用します。
検索を止めるためにコマンドのネットワークアクセスをオフにする。 ウェブ検索は別個のものであり、利用可能なままになる可能性があります。
検索を制限するためにコマンドのドメイン許可リストを使用する。 検索には tools.web_search に独自のドメインフィルタがあります。
古い機能トグルをそのままにしておく。 代わりにトップレベルの web_search 値を設定してください。
検索がメモリに影響しないと思い込む。 デフォルトでは、ウェブ検索を使用したチャットもメモリ生成に利用される可能性があります。
解決策:タスクごとに検索モードを選択する
ステップ 1: キャッシュをデフォルトにする
背景調査や安定したドキュメントの参照にはインデックスを使用します。
ステップ 2: 時間に敏感な確認にはライブを使用する
単発の実行には --search を渡すか、そのような作業に使用するプロファイルでライブを設定します。
ステップ 3: 検索制限をネットワーク制限とは別に設定する
検索ドメインには tools.web_search を使用し、コマンドトラフィックにはサンドボックス設定を使用します。
ステップ 4: 検証した内容を記録する
ライブ検索でバージョン、修正、または非推奨化を確認したら、その結果と日付を書き留めておきます。
MemoryLakeでの設定
ウェブ検索はある一瞬の疑問に答えるものです。そこから学んだこと(どのバージョンで修正が導入されたか、どのAPIが非推奨になったか、チームがどのソースを信頼しているかなど)は、検索が終わった後も役立つプロジェクトのコンテキストです。
MemoryLake は、検証済みの事実、決定事項、その背景にあるソースなど、そのようなプロジェクトコンテキストのためのメモリレイヤーです。これらを一箇所で管理し、ChatGPT、Claude Code、Codexなど、接続したアシスタントから利用できるようにします。
エントリは自分自身の言葉で記述します。Codexのチャット、検索結果、config.toml、Codexのメモリ、またはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。Codexのウェブ検索はOpenAIが説明している通りに動作します。
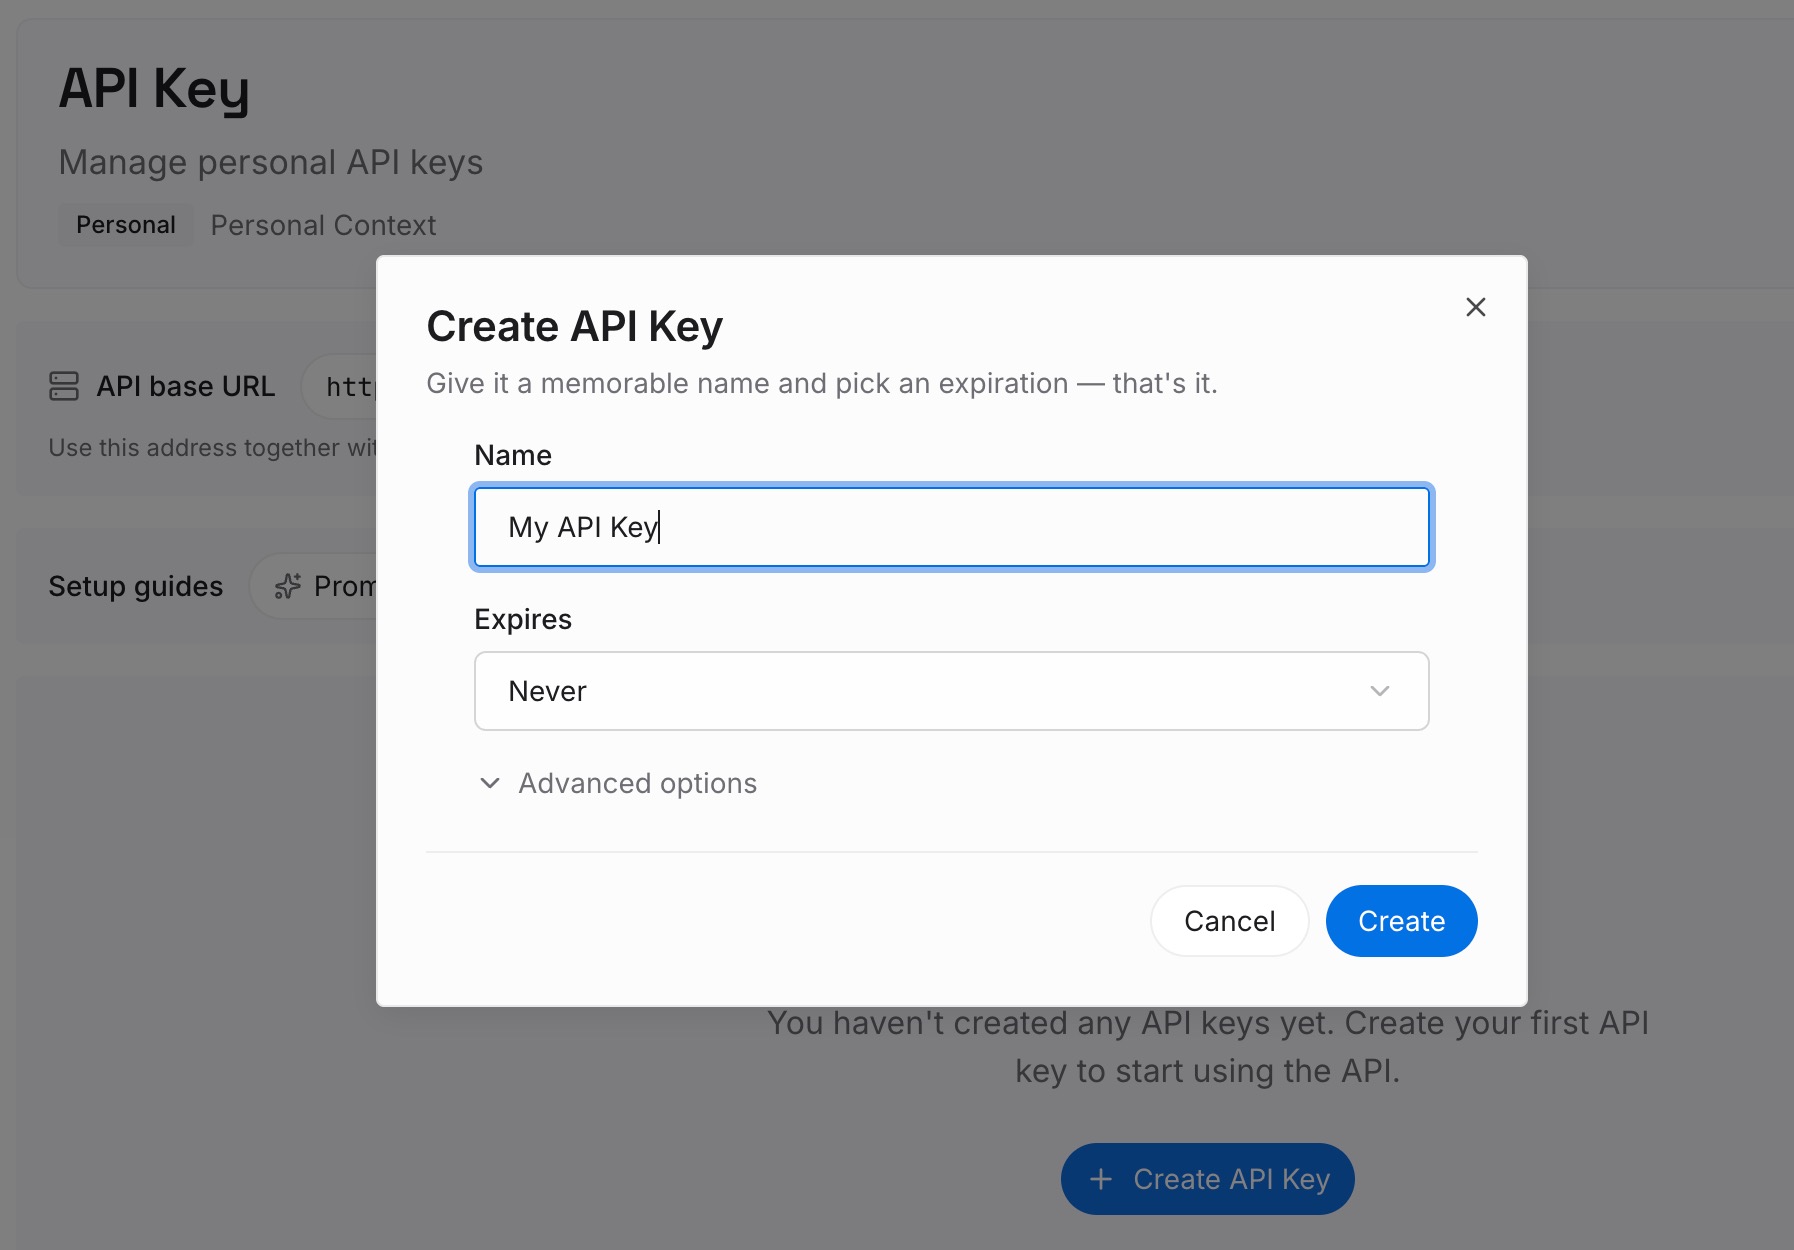
ステップ 1: APIキーを作成する
サインインしてダッシュボードからキーを生成します。他の認証情報と同様に、リポジトリの外に保管してください。
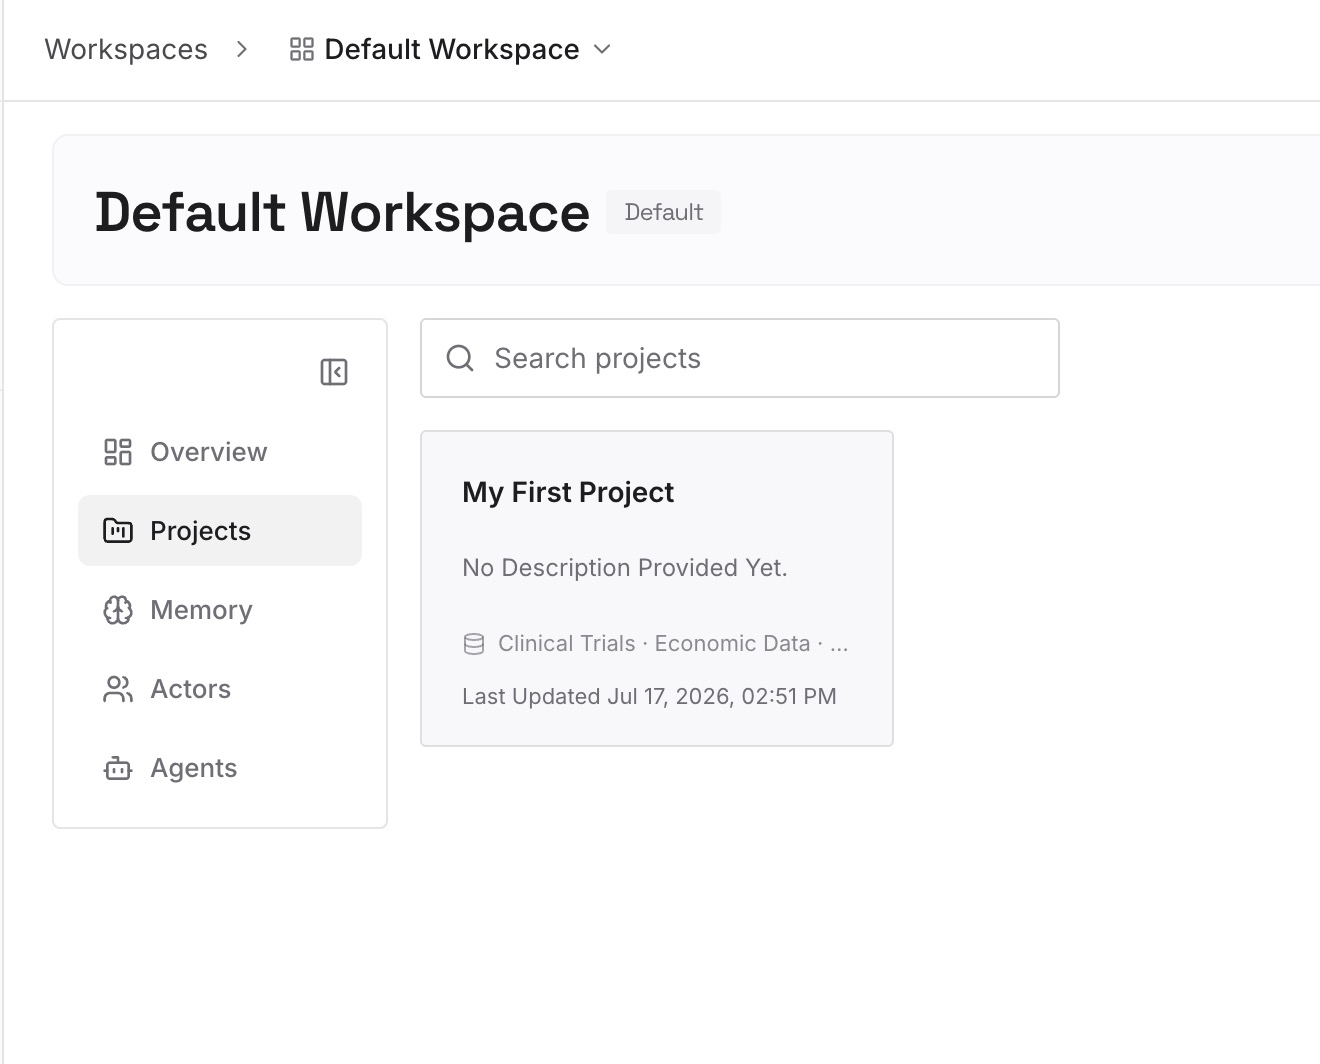
ステップ 2: 最初のメモリをアップロードする
解決策のステップ4で書いた内容、つまり検証した事実とその時期から始めましょう。1つのエントリにつき1つの事実を、ソースと共に記載します。
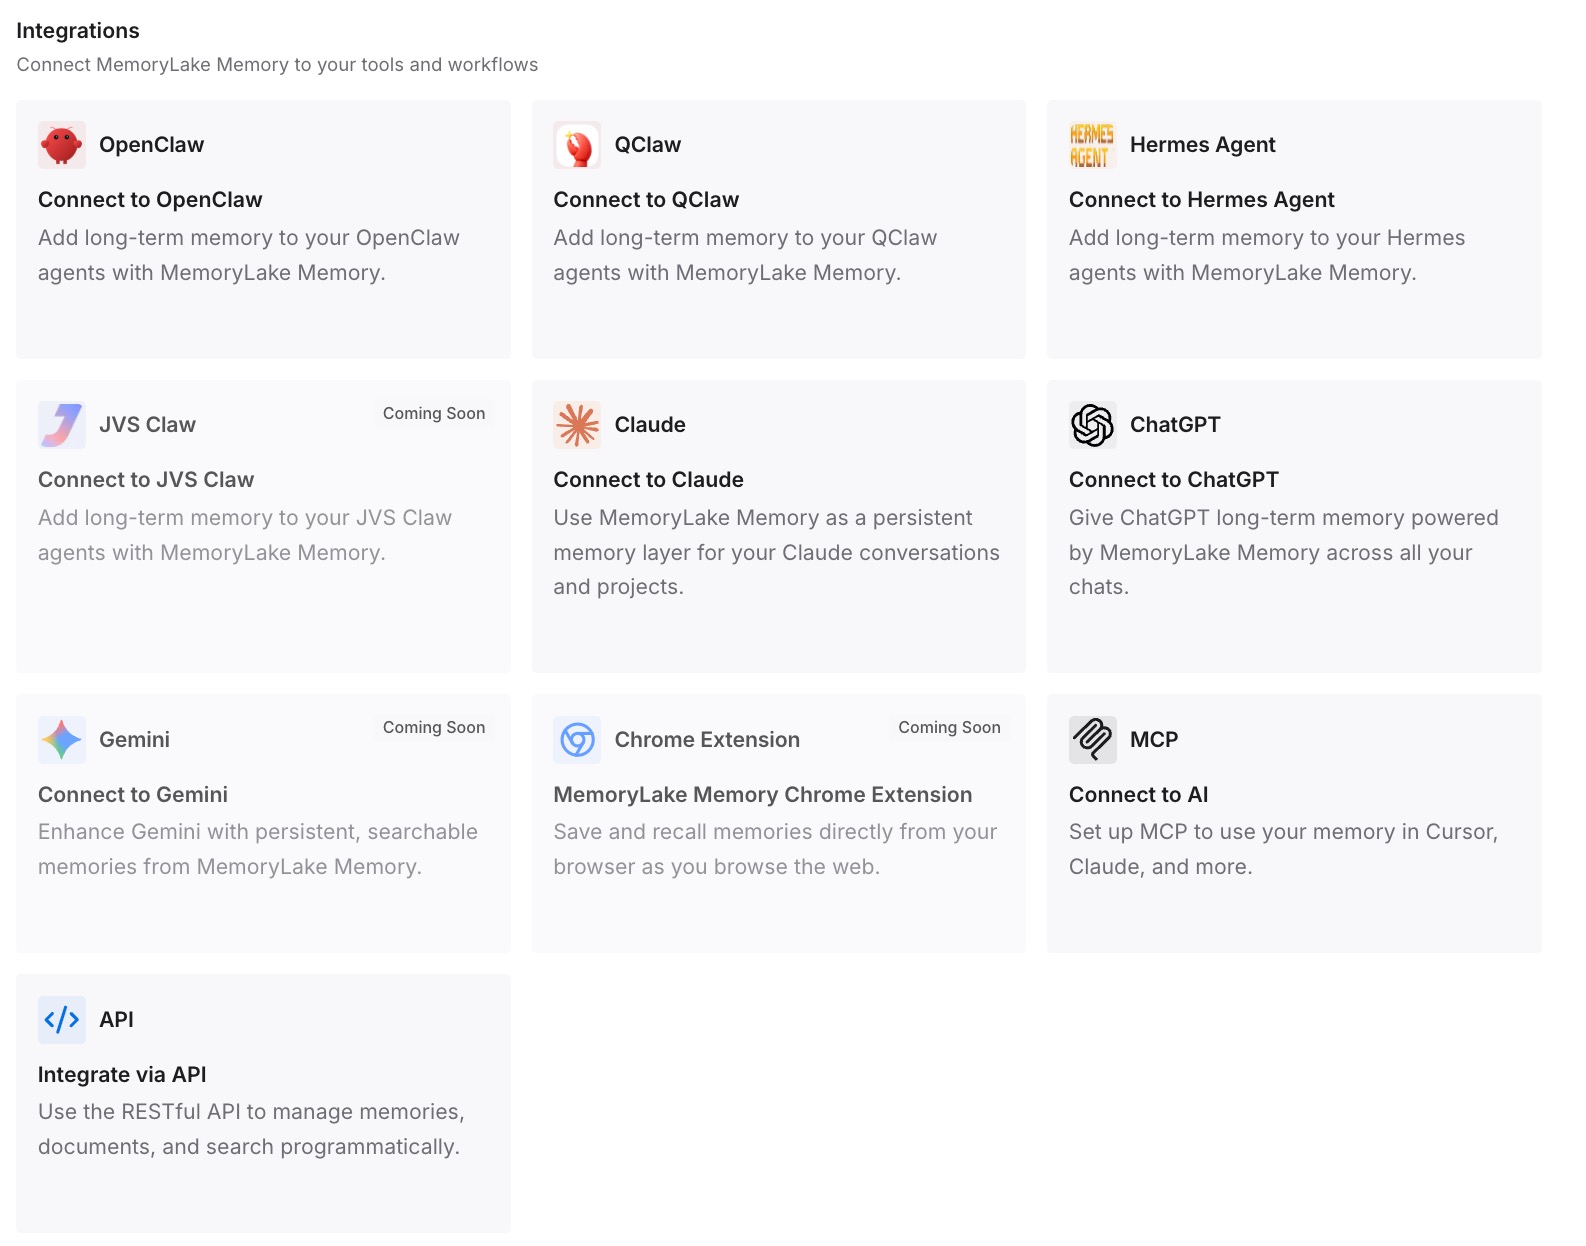
ステップ 3: AIとエージェントを接続する
Codex、Claude Code、および使用している他のアシスタントを接続します。それぞれが、再度検索することなく同じ検証済みの事実を参照できます。
実務における変化
第一の違いは、繰り返しの検索が減ることです。一度検証した事実は、次回からすぐに利用可能です。
第二に、出所(プロバナンス)が明確になります。各エントリには、その事実がいつどこから来たのかが記されています。
第三に、ツール間での一貫性です。Codexでも他のアシスタントでも、同じ検証済みの事実を利用できます。
Codexウェブ検索のベストプラクティス
キャッシュをデフォルトに保つ。 ライブコンテンツへの露出を減らせます。
単発の鮮度確認には --search を使用する。 デフォルト設定は変更されません。
繰り返しのライブ作業にはプロファイルを使用する。 適用される場所でモードを設定してください。
検索ドメインを個別に制限する。 コマンドネットワークルールは検索には適用されません。
レガシーなトグルを確認する。 トップレベルの web_search 設定を優先してください。
メモリ生成について決定する。 検索されたチャットを除外したい場合は memories.disable_on_external_context を使用してください。
結果を信頼できないものとして扱う。 それに基づいて行動する前に内容を確認してください。
結論
Codexのウェブ検索は、ローカルチャットではデフォルトでOpenAIが管理するキャッシュされたインデックスを使用します。これによりプロンプトインジェクションへの露出は抑えられますが、非常に新しいページが反映されていない可能性があります。ライブモードは、config.toml の web_search または1回限りの --search フラグで設定でき、最新のデータを取得します。また、フルアクセスセッションはデフォルトでライブになります。
ウェブ検索はサンドボックスのコマンドネットワークとは別のホスト型ツールであるため、ネットワークプロキシやコマンドドメイン許可リストを使用せず、コマンドのネットワークアクセスがオフでも利用できる場合があります。独自のドメインフィルタを持ち、管理者は許可されるモードを制限できます。また、デフォルトでは、memories.disable_on_external_context を true に設定しない限り、検索を使用したチャットもメモリ生成に寄与します。