
なぜ2つの仕組みが互換性があるように感じられるのか
表面上、これらは重複しています。なぜなら、どちらも説明(description)に基づいてエージェントによって選択される可能性があるからです。
ルールの側では、Cursorは4つの適用モードをドキュメント化しています。Always Apply(「すべてのチャットセッションに適用」)、Apply Intelligently(「説明に基づいてエージェントが関連していると判断したとき」)、Apply to Specific Files(「ファイルが指定されたパターンに一致するとき」)、および Apply Manually(「チャットで @ メンションされたとき」)です。その根底にある仕組みはさらにシンプルに説明されています。「alwaysApplyがtrueの場合、ルールはすべてのチャットセッションに適用されます。そうでない場合、ルールの説明がCursor Agentに提示され、適用すべきかどうかが判断されます。」
スキルの側でも、選択に関する説明はほぼ同じように聞こえます。「Cursorが起動すると、スキルディレクトリからスキルを自動的に検出し、エージェントが利用できるようにします。エージェントには利用可能なスキルが提示され、コンテキストに基づいてそれらがいつ関連するかを判断します。」それを駆動するフロントマターのフィールドも同様に説明されています。descriptionは「エージェントが関連性を判断するために使用されます」となっています。
したがって、どちらも説明によって選択可能であり、どちらもファイルスコープに設定できます。スキルには paths フィールドがあり、「設定されると、エージェントが一致するファイルを操作するときにのみスキルが表示されます」となっており、これはルールのglobsと同じアイデアです。スキルはピン留めして閉じることもできます。disable-model-invocationが「trueの場合、スキルは /skill-name を介して明示的に呼び出されたときにのみ含まれます。エージェントはコンテキストに基づいて自動的に適用することはありません。」
これらが真に異なるのは、それぞれが何を保持できるか、そしていつ読み込まれるかという点です。
ルールはプロンプトに入るテキストです。そもそもなぜルールが存在するのかというCursorの枠組みは、根本的な問題を言い当てているため、引用する価値があります。「大規模言語モデルは、補完(completion)間で記憶を保持しません。ルールは、プロンプトレベルで永続的かつ再利用可能なコンテキストを提供します。」
スキルはパッケージです。「スキルは、ドメイン固有のタスクを実行する方法をエージェントに教える、ポータブルでバージョン管理されたパッケージです。スキルには、エージェントがツールを使用して実行できるスクリプト、テンプレート、および参照を含めることができます。」そして、これはCursor固有のものではありません。「スキルは、Agent Skills標準をサポートする任意のエージェントで動作します。」
この最後の一文こそが、決定を左右する部分です。これらのフォーマットのうち、一方はあなたと共に持ち運ぶことができ、もう一方はCursor独自の構造です。ポータビリティは、チームがエージェント間を移動するたびに同じ疑問が再浮上する理由でもあります。例えば、migrating Cursor rules into Codex(CursorルールからCodexへの移行)などがその例です。
人々が代わりに試みること(そしてその落とし穴)
すべてに対してコンバーターを実行する。 コマンドが存在するため、Cursorがすでにあなたに代わって決定を下してくれたように見えます。しかし、これは対象となる動的ルールとスラッシュコマンドを変換するものです。この「対象となる」という言葉には重要な意味があり、常に適用される規約は、パッケージ化を待っている複数ステップの手順ではありません。
すでに動作しているため、すべてをルールとして維持する。 擁護の余地はありますが、ドキュメントが指摘するコストが発生します。ルールは開始時にモデルコンテキストに入ります。Cursor自身のベストプラクティスも、ルールの肥大化を抑制しています。「ルールは500行未満に抑える」、「大きなルールは複数の構成可能なルールに分割する」、「内容をコピーするのではなくファイルを参照する。これによりルールを短く保ち、コードの変更に伴ってルールが古くなるのを防ぐ」。
.rulesディレクトリにプレーンなMarkdownファイルを置く。 これは、最も明確にドキュメント化されている間違いであり、Cursorは現在それをはっきりと説明しています。「プロジェクトルールは .mdc 拡張子を使用する必要があります。.cursor/rules 内のプレーンな .md ファイルは、説明、globs、およびalwaysApplyを指定するフロントマターがないため、ルールシステムによって無視されます。」ドキュメントには代替案も示されています。「プレーンなMarkdownを好む場合は、代わりに AGENTS.md を使用してください。」そのファイルに集約すべきかどうかはそれ自体の決定であり、moving a CLAUDE.md into AGENTS.md(CLAUDE.mdからAGENTS.mdへの移行)で詳しく説明しました。
ホームディレクトリにあるスキルが作業環境に追従すると仮定する。 ほとんどの場合、追従しません。Cursorはその境界を明記しています。「Cursorは、~/.agents/skills/ や同期されていないローカルスキルを、Cloud Agents、Agents WindowのリモートSSHセッション、またはセルフホストされたワーカーにコピーしません。」ドキュメントは、これらのケースの1つに対する解決策を提供しています。「セルフホストされたワーカーでは、リポジトリのプロジェクトスキルを使用するか、ワーカーイメージにスキルを組み込んでください。」
エージェントが何かを間違えるたびに、さらにルールを追加する。 Cursorのガイダンスは、意図的に慎重なアプローチを促しています。「シンプルに始めてください。エージェントが同じ間違いを繰り返していることに気づいた場合にのみ、ルールを追加してください。」避けるべきことのリストも同様に的を射ています。「スタイルガイド全体をコピーすること:代わりにリンターを使用してください」、「考えられるすべてのコマンドを文書化すること」、「めったに適用されないエッジケースの指示を追加すること」、「コードベースにすでに存在するものを重複させること」。ルールが積み重なると、when Cursor forgets your project rules(Cursorがプロジェクトルールを忘れるとき)で説明されているような乖離が生じやすくなります。
スキルをエージェントの記憶(memory)として扱う。 スキルはパッケージ化された手順であり、チームが決定したことの記録ではありません。この区別は見た目以上に重要であり、why agent skills aren't memory(なぜエージェントのスキルは記憶ではないのか)で詳しく説明しています。
解決策:新しいフォーマットかどうかではなく、そのアイテムが「何であるか」で分割する
ほぼすべてのケースを決定する質問が1つあります。それは、「これは常に真であるか」、それとも「実行する何かであるか」です。
ステップ 1: 各アイテムを「常に真」、「ファイルスコープ」、「手順」に分類する
常に真(Always true)なものは、alwaysApply をオンにしたルールに属します。著作権ヘッダー、変更を提案する前にソースファイルを読み込む指示、決して編集してはならないディレクトリなど、Cursor自身の「常に適用される」例はまさにこの種のリストです。これらはトークン消費が少なく、見落とした場合の代償が大きいため、エージェントに関連性を判断させたくないものです。
ファイルスコープ(File-scoped)はどちらでも構いませんが、率直な決定打となるのはポータビリティです。globsを持つルールと、paths を持つスキルは同じ役割を果たします。その規約が他のエージェントでも重要になる可能性が高い場合、持ち運び可能なスキルフォーマットを選択すべきです。
手順(Procedural)はスキルに属します。ここでコンバーターが真価を発揮します。ステップ、記入するテンプレート、実行するスクリプト、または添付された参照資料があるものはすべて、スキルフォーマットが想定しているものです。スキルは「エージェントがツールを使用して実行できるスクリプト、テンプレート、および参照」を保持し、必要なときにのみロードできます。これをルールに詰め込むと、今日のタスクにそれが関係しているかどうかにかかわらず、手順全体がプロンプトに居座ることになります。
Cursor自身のレポジトリスコープは、その意図を示す有用なヒントです。「ネストされたプロジェクトディレクトリ内のスキルは、そのディレクトリ内のファイルに自動的にスコープされます。」したがって、適用対象のパッケージの横に配置されたスキルは、設定なしでスコープされます。これは、scoping instructions to files(指示をファイルにスコープする)で検討したのと同じファイルの局所性(file-locality)の原則です。
ステップ 2: 誰が各アイテムを選択するかを決定し、それを示すフィールドを設定する
各アイテムについて、誰がそれを選択すべきかを書き留めます(常にロード、エージェントが選択、ファイル一致、または手動呼び出し)。次に、それに一致するフィールドを設定します。デフォルト設定は両者で異なるためです。
ルールの場合、常時の場合は alwaysApply: true、エージェント選択の場合は description、ファイル一致の場合は globs、手動の場合はどちらも設定しません。Cursorは、説明もglobsもないルールは「チャットでルールを @ メンションしたときにのみ含まれる」と指摘しています。
スキルはデフォルトでエージェント選択です。Cursorが利用可能なスキルを提示し、エージェントが説明から関連性を判断するためです。手動専用にするには、disable-model-invocation を設定します。ファイルスコープにするには、paths を設定します。また、呼び出し時の挙動にも注意してください。スラッシュで呼び出されたスキルは「1つのメッセージに添付される」ため、セッション全体で有効にしたいスキルは、1ターンだけ有効にしたいスキルとは異なるセットアップになります。
遵守すべき命名規則が1つあります。スキルの name は「小文字、数字、ハイフンのみ」であり、「親フォルダー名と一致している必要」があります。
ステップ 3: 各規約が存在する理由を、どちらのフォーマットも管轄しない場所に書き留める
ルールもスキルも指示を保持します。どちらも、その指示の背後にある議論を記録するのには適していません。Cursor自身の推奨事項も、これらのファイルからコンテンツを押し出す方向(コピーする代わりにファイルを参照する、標準的な例を指し示す、ルールを短く保つなど)を向いています。
そこにギャップが生じます。「カラムの型をインプレースで変更してはならない」というのはルールです。しかし、なぜか(どのマイグレーションが、何月に壊れ、その後チームが何に合意したのか)こそが、次の四半期に誰かがそのルールを削除するのを防ぐ要因になります。両方のフォーマットよりも長生きする場所にそれを置いてください。
MemoryLakeでのセットアップ
ルールとスキルは、エージェントがどのように振る舞うべきかという問いに答えます。しかし、これらはチームが何を決定し、なぜそうしたのかを保存する場所としては不向きです。それにもかかわらず、人々はそこに保存しようとしがちです。MemoryLakeは、それらの決定事項を意図的に書き込むためのストアであり、特定のエディタの設定から切り離され、接続するすべてのアシスタントから読み取ることができます。エントリーはあなた自身の言葉で自分で書き込みます。Cursorのシステムや他のベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。あなたのルール、スキル、リポジトリは完全に独自の管理下に置かれたままです。
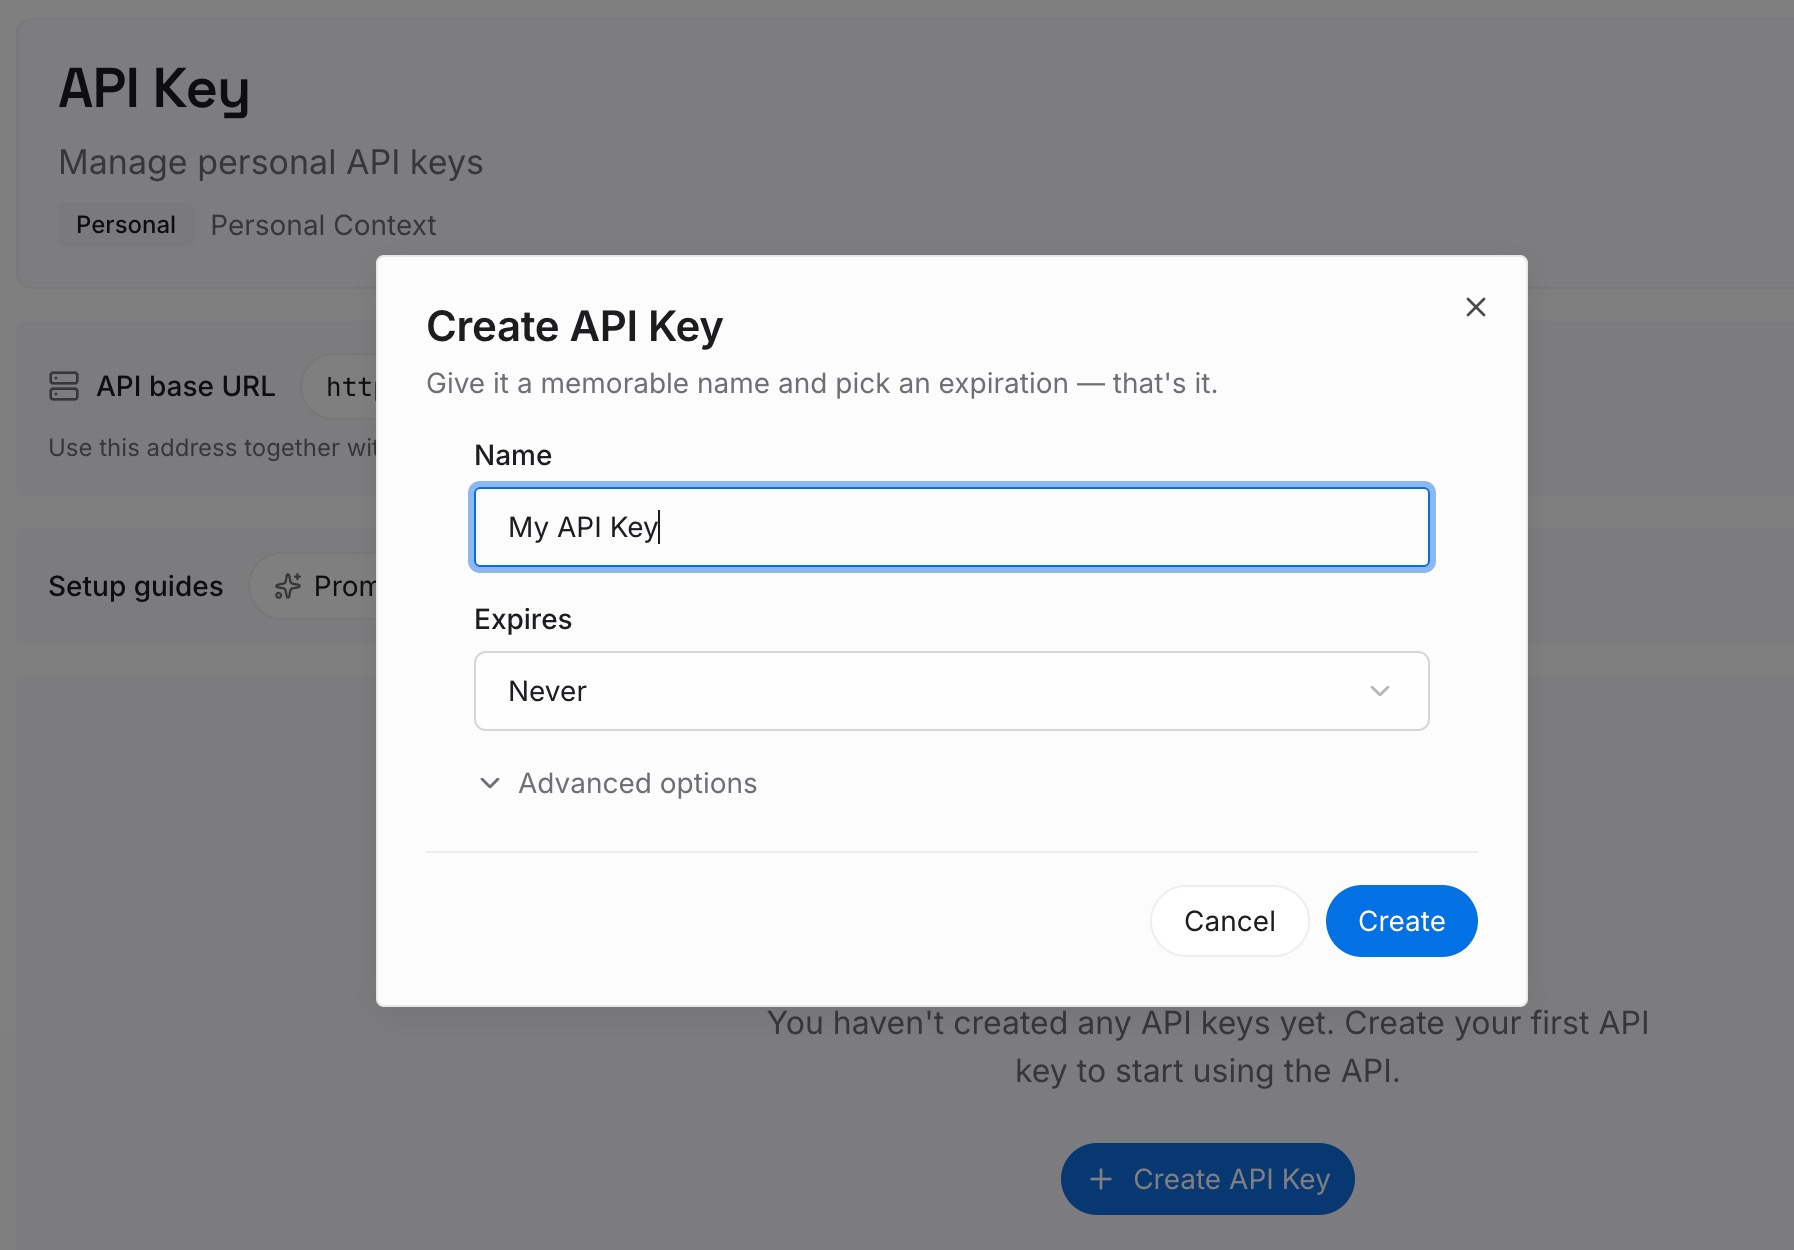
ステップ 1: APIキーを作成する
ダッシュボードからキーを生成します。これにより、Cursor、ターミナルエージェント、およびチャットアシスタントが、それぞれ推論のコピーを個別に保持することなく、同じ事実のセットにアクセスできるようになります。
ステップ 2: 最初の記憶(memories)をアップロードする
ルールの背後にある決定事項から始めましょう。除外されたアプローチとその理由、規約が存在する目的となったインシデント、特定のサービスに触れる前に尋ねるべき担当者などです。ルールファイルは指示を伝えますが、その理由を伝えることはほとんどありません。
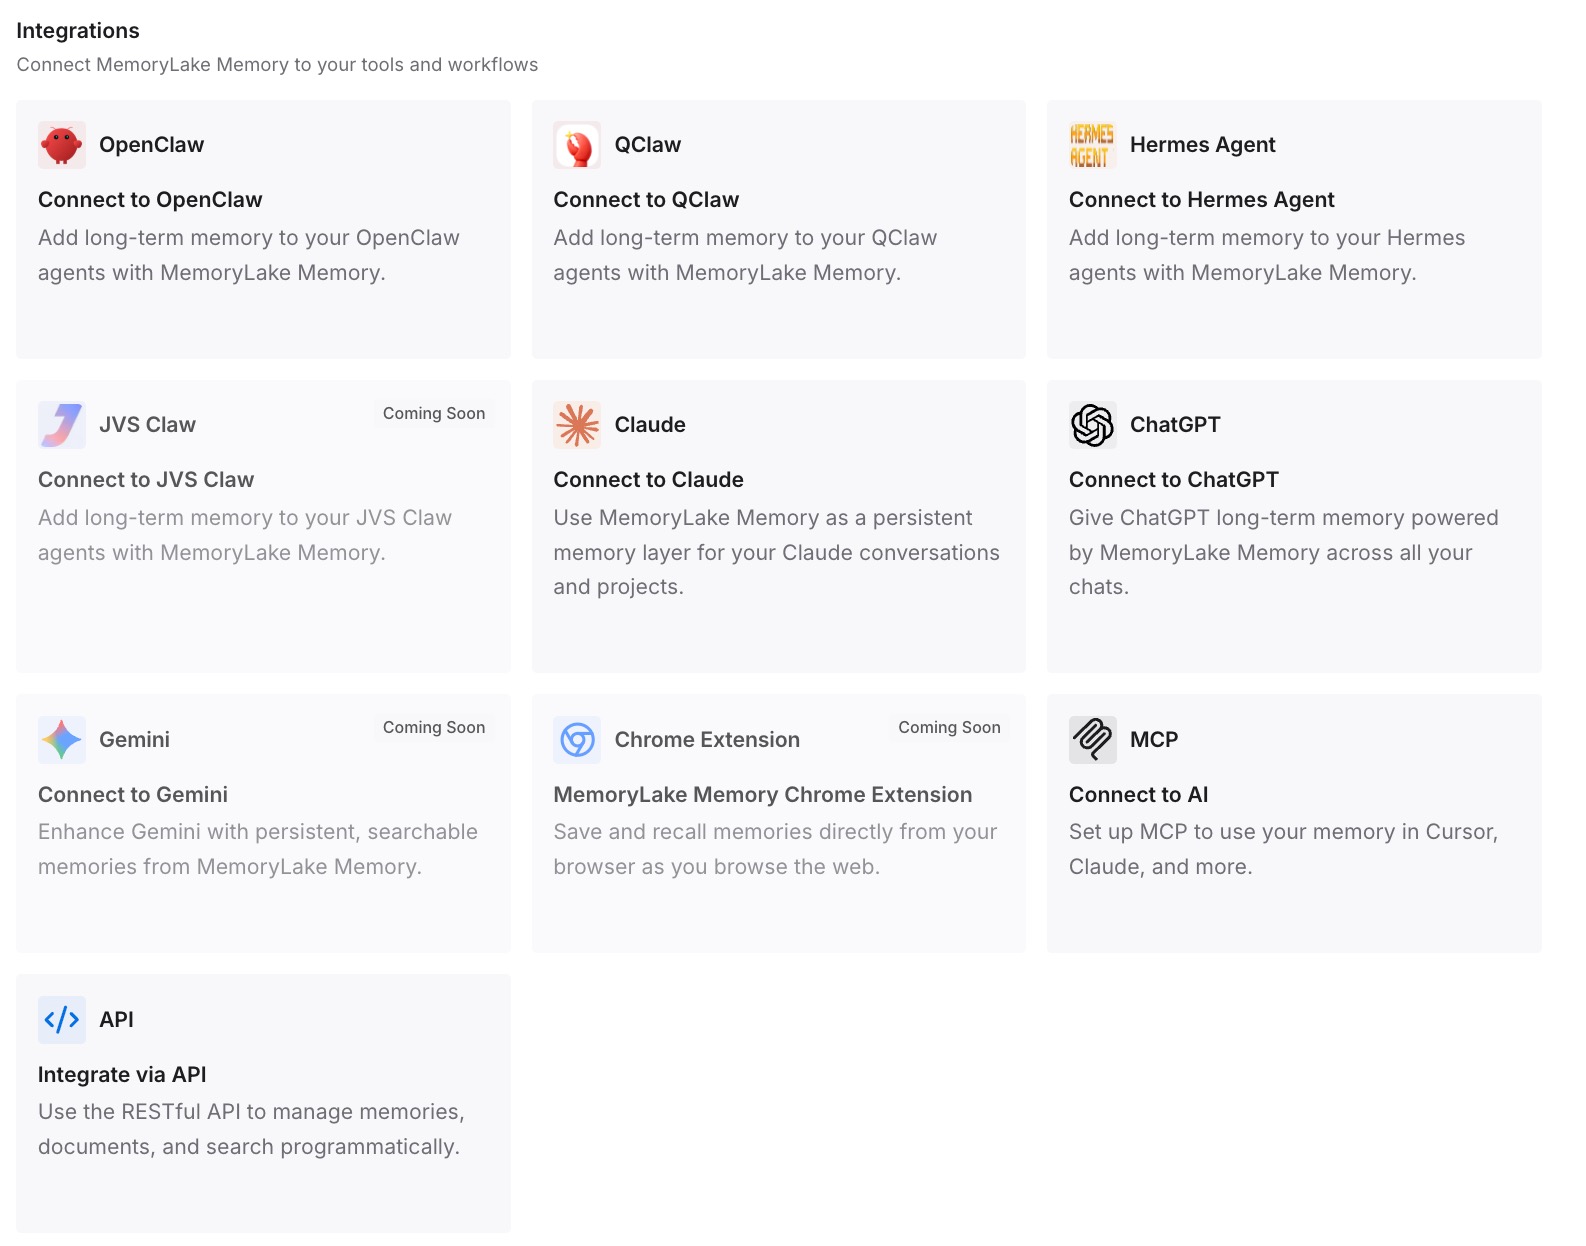
ステップ 3: AIとエージェントを接続する
設定ファイルから推論する代わりに、セッションの開始時にそれらの事実がロードされるように、ツールをこのレイヤーに向けます。次に、実際に効果を証明するテストを実行します。別のアシスタントに、決定事項の1つについて尋ねてみてください。もし回答が得られれば、あなたの推論は特定のエディタのファイルフォーマットに縛られなくなったことになります。
実務で何が変わるのか
最初の変化は、コンバーターに何を投入すべきかがわかるため、安全に使用できるようになることです。ステップ、スクリプト、またはテンプレートを伴う手順を投入し、常に適用される規約はそのまま残します。
2つ目は、プロンプトが小さくなることです。alwaysApply がオンになっているものはすべてセッションごとに読み込まれますが、スキルに移行された手順はオンデマンドでロードされます。これが実際の機械的なメリットであり、適切なものを移行した場合にのみ得られます。
3つ目は、.mdc の要件によって誰かの午後が丸々潰れることがなくなる点です。ルールディレクトリ内のプレーンな .md ファイルはルールシステムによって無視されますが、Cursorは現在、解決策と同じ段落でそのことを明記しています。
4つ目は、リモートやクラウドでの実行で不意を突かれることがなくなる点です。同期されていないローカルスキルや ~/.agents/skills/ は、Cloud Agents、リモートSSHセッション、またはセルフホストされたワーカーには届かないため、クラウド実行が依存するものはすべてリポジトリに属します。
5つ目は、ポータビリティが「後から気づくもの」ではなく「自ら選択するもの」になる点です。スキルは標準をサポートする任意のエージェントで動作すると説明されていますが、ルールはCursor独自の構造です。コンテキストがどのフォーマットにあるかを把握しておくことは、移行と書き直しの違いを生みます。これは、別のベンダーが反対側からドキュメント化しているのと同じ問題です。例えば、which Copilot instructions file gets read(どのCopilot指示ファイルが読み込まれるか)などがその例です。
Cursorルールとスキルを分割するためのベストプラクティス
常に適用するリストは短く、絶対的なものに留める。 これらはすべてのセッションで読み込まれるため、すべての行が実際のタスクと競合します。
すべての説明(description)には「何(what)」だけでなく「いつ(when)」を記載する。 どちらの側でも、説明はエージェントが関連性を判断するために使用するものです。
クラウド実行に必要なスキルはリポジトリに置く。 プロジェクトレベルのスキルディレクトリは移動しますが、同期されていないローカルのものはローカルマシンに留まるとドキュメント化されています。
1つの手順につき1つのスキルを、専用のフォルダーに配置する。 スキルのアイデンティティは SKILL.md を含むフォルダーから得られ、その上のカテゴリフォルダーは整理目的のみに使用されます。
可能であれば、globリストの代わりにネストを使用する。 パッケージディレクトリ内のスキルは、そのディレクトリに自動的にスコープされます。
拡張子のルールを遵守する。 プロジェクトルールには .mdc を使用し、プレーンなMarkdownは代わりに AGENTS.md に配置します。
推論(理由)は別の場所に保管する。 独自の履歴まで保持するルールファイルは短く保つことができなくなります。そして、短さこそがルールを機能させる鍵です。
結論
Cursorは両方の仕組みを明確にドキュメント化していますが、それらを同じページには掲載していません。ルールはプロンプトレベルのコンテキストであり、モデルコンテキストの開始時に含まれ、4つの適用モードがあり、プロジェクトルールには .mdc 拡張子を使用するという厳しい要件があります。スキルは、スクリプト、テンプレート、参照を保持し、リソースをオンデマンドでロードし、Agent Skills標準をサポートする任意のエージェントで動作する、ポータブルでバージョン管理されたパッケージです。
仕分けの問いは、機能比較が示唆するよりもシンプルです。常に真である規約は、関連性を判断させたくないため、常に適用されるルールとして残します。ステップや添付ファイルを伴う手順は、オンデマンドロードの目的そのものであるため、スキルになります。ファイルスコープのガイダンスはどちらでもよく、ポータビリティが合理的な決定打となります。
付箋に書いておく価値のある2つの境界線があります。.cursor/rules 内のプレーンな .md はルールシステムによって無視されること、そして同期されていないローカルスキルは Cloud Agents、リモートSSHセッション、またはセルフホストされたワーカーには届かないことです。
そして、どちらのフォーマットもサポートしていないステップを1つ実行してください。各規約が存在する理由を、ルールファイルやスキルパッケージではない場所に記録し、次にそのルールを読む人がその理由も発見できるようにしてください。