
作成したKnowledgeアイテムが一度も表示されない理由
まずは取得(リトリーバル)モデルから始めましょう。これは、通常の指示ファイルの仕組みとは正反対だからです。Cognition自身のヒントにも直接書かれています。「Devinは、最初からすべてを一度に読み込むのではなく、関連性がある時にKnowledgeを取得します。取得トリガーがコンテンツと高い関連性を持つようにしてください」
つまり、トリガーの説明は単なるメタデータではありません。それは「ゲート(門番)」なのです。オンボーディングガイドでも、優れたトリガーの形を具体的に示しながらこの点が繰り返されています。「Knowledgeは、設定したトリガーに基づいて取得されます。トリガーが具体的であるほど(例:どのファイル、リポジトリ、またはタスクの種類にKnowledgeが適用されるか)、取得の精度が向上します」
これは、すべてのプロンプトに連結されるルールファイルとは本質的に異なる設計であり、失敗の現れ方も異なります。ルールファイルが長すぎると効果が薄れますが、Knowledgeアイテムのトリガーが曖昧だと、完全にスキップされます。このカテゴリ全体で指示ファイルが静かに無視されてしまう理由は、関連する問題であり、エージェントが指示ファイルを無視する理由 で取り上げました。
アイテムがセッションに届かない理由は、ドキュメント化されているものだけでさらに3つあります。
どこにも固定(Pin)されていない。 Cognitionは固定をオーバーライド(強制適用)として説明しています。「リポジトリに固定しない場合:Knowledgeは、Devinが現在のコンテキストに関連していると判断した時にのみ取得されます。」特定のリポジトリに固定すると、挙動は完全に変わります。「その特定のリポジトリでDevinが作業している時は、常にそのKnowledgeが使用されます。」すべてのリポジトリに固定すると、「Devinがいずれかのセッションで作業しているすべてのリポジトリに、そのKnowledgeが自動的に適用されます。」オンボーディングガイドでは、この決定ルールを明示しています。「Devinがセッションで作業している時にいつでもKnowledgeノートを取得させたい場合は、必ずすべてのリポジトリに固定してください」
無効化されている(フォルダによる可能性あり)。 アイテムはユーザーごとにオフにできます。「各Knowledgeアイテムは、ユーザーごとに個別に有効または無効にできます。Knowledgeアイテムを無効にすると、組織から削除されることなく、あなたのセッションでDevinがそれを取得するのを防ぎます。」フォルダもそのスイッチを継承します。「フォルダが無効化されると、その中のすべてのKnowledgeアイテムがあなたのセッションで無効になります。」そのアイテムが機能しているのを見ている同僚は、あなたと矛盾しているわけではありません。彼らは異なる有効化設定を持っているだけです。
想定と異なるスコープにある。 新しいアイテムはデフォルトで1つのレベルに設定されます。Organization Knowledge(組織ナレッジ)アイテムは「組織のすべてのメンバーに表示され、新しいKnowledgeアイテムのデフォルトのスコープです。」Enterprise Knowledge(エンタープライズナレッジ)アイテムは「エンタープライズ内のすべての組織に適用」され、スコープを昇格させるには権限が必要です。「昇格にはエンタープライズナレッジ管理権限が必要であり、エンタープライズに属する組織内のユーザー作成Knowledgeアイテムでのみ利用可能です。」
何かを書く前にもう一つ知っておくべきことがあります。一部のKnowledgeは、あなたが作成しなくても最初から存在しています。「Devinは、接続されたリポジトリの既存のREADME、ファイル構造、およびコンテンツに基づいて、リポジトリのKnowledgeを自動的に生成します。」ただし、アクセス権に関する注意書きがあります。「Devinにリポジトリへのアクセス権を与えない場合、関連するKnowledgeは生成されません。」Cognitionの最初のオンボーディングステップは、その内容を確認することです。「自動生成されたKnowledgeを確認し、(a) 網羅性と (b) 正確性を検証してください。」
さらに、Devinは提案を続けます。「Devinは、チャットでのフィードバックに基づいて、記憶すべきKnowledgeを自動的に提案します。」編集や却下はあなた自身で行うことができ、「新しいKnowledgeアイテムの提案に加えて、既存のKnowledgeアイテムの更新を提案することもできます。」
代わりに試されがちなこと
すべてを網羅した1つの長いKnowledgeアイテムを書く。 気持ちは分かりますが、これは取得モデルに対して2重に不利に働きます。Cognitionのガイダンスは逆です。「1つのワークフローまたはアクションに焦点を当てた、具体的なKnowledgeを作成してください。DevinはKnowledgeのコンテンツ全体を読み取るため、すべてを関連性のある最新の状態に保ってください!」そして「可能な限り、Knowledgeをより小さなものに分割してください。」1つのオムニバス形式のアイテムには、その中のすべてをどうにかして説明する1つのトリガー説明が必要になってしまいます。
コンテンツをプレイブック(Playbook)に移動する。 プレイブックは異なるツールであり、Cognitionはその切り分けについて非常に直接的に述べています。「ほとんどのベストプラクティス、スタイルガイド、またはその他のプロジェクト固有の指示は、Knowledgeを使用してDevinと共有する必要があります。プレイブックを作成する前に、Knowledgeに関するドキュメントを読んで、どちらの方法がニーズに適しているかを理解することをお勧めします。」彼らの言葉を借りれば、プレイブックは「繰り返されるタスクのためのカスタムシステムプロンプトのようなもの」であり、セッションの開始時に添付します。また、それが簡単な選択肢ではないことも指摘しています。「現在、プレイブックの作成にはスキルが必要です。」
リポジトリ内のMarkdownファイルにすべてを記述する。 合理的な直感ですが、ファイル拡張子のゲートに突き当たります。Devinは「.rules、.mdc、.cursorrules、.windsurf、CLAUDE.md、AGENTS.mdを含む、コードベース内の専用ファイルに基づいてKnowledgeを自動的に取得および更新します」が、次のような制限があります。「Devinは、.mdのようなより一般的なファイルタイプを自動的に取得することはありません。」規約に沿って命名されたファイルは、単に「notes」と名付けられたファイルとは異なる挙動を示します。
毎回プロンプトで指示を繰り返す。 これは問題を覆い隠す回避策です。機能してしまうため、誰もトリガーを修正せず、繰り返しがいつまでも終わらなくなります。何がKnowledgeに属するべきかについてのCognition自身のアドバイスは、まさにその裏返しです。「プロンプトやプレイブックの中で、定期的に繰り返していることに気づいた要素を含めることをお勧めします。」
セッションが単にコンテキストを見失ったと仮定する。 実際にそうなることもありますが、それは異なる性質を持つ別の問題であり、Devinがタスクのコンテキストを忘れる時 で説明されています。一度も取得されなかったKnowledgeアイテムは、失われる以前に、最初からセッション内に存在していません。
Knowledgeをスキル(Skills)に置き換える。 これも実際のトレードオフを伴う現実的な選択肢であり、Devinの記憶をスキルに移行する でマッピングしました。これは取得に関する問いを排除するのではなく、移動させるだけです。
解決策:重要な部分で取得を決定論的にし、一度検証する
3つのステップがあります。最初の2つは10分で完了し、機能全体を確率的なものから予測可能なものへと変えることができます。
Step 1: Sort your items into triggered and always-on
手持ちのアイテムを確認し、アイテムごとに1つの質問を投げかけてみてください。「これは特定の種類のタスクに適用されるものか、それともリポジトリ内のすべてのセッションに適用されるものか?」
タスク固有のアイテムはトリガーを維持し、より明確な説明を与えます。優れたトリガーが何を指し示すべきか(どのファイル、どのリポジトリ、またはどのタイプのタスクか)について、Cognition自身のヒントに従ってください。「デプロイ(Deployment)」はカテゴリです。「infraリポジトリ配下のリリースパイプラインまたはデプロイスクリプトに触れるすべての作業」がトリガーです。
リポジトリ全体のアイテムは、代わりに固定(Pin)します。特定のリポジトリに固定すると、Devinがそのリポジトリで作業する際に常にそのアイテムが使用されるようになり、トリガーを考慮する必要がなくなります。「すべてのリポジトリに固定」は、本当にどこにでも適用されるごく一部のルールに限定してください。そこに固定されたすべてのアイテムは、すべてのセッションで読み込まれるためです。
手動で呼び出したい一握りのアイテムについては、プロンプトに入力する「!で始まる短い識別子」であるマクロを割り当てます。Cognitionは、マクロは「文字、数字、ハイフンのみを含めることができ、組織内で一意である必要があります」と説明しています。
Step 2: Run one session and read Accessed Knowledge
これは検証ステップであり、実際に機能が存在します。Cognitionはこれをドキュメント化しています。「Devinはセッション内で使用したKnowledgeを教えてくれます」— セッションチャットの「Accessed Knowledge」という見出しの下に表示されます。
作成したアイテムが対象とするタスクを選んで実行し、確認してください。アイテムがリストされていれば、トリガーは機能しています。リストされていなければ、Knowledge自体の問題ではなくトリガーの問題であることが分かります。この区別ができるようになれば、他のすべてを修正可能になります。その後、明らかな要因を確認します。そのアイテムはあなたに対して有効になっているか、そのフォルダは有効か、想定したスコープにあるか、などです。
ルールトリガーモードは、単なる癖ではなく、エージェント設定の標準的な要素になりつつあります。別のベンダーが同じ選択をどのようにモデル化しているかを比較することは、直感を養う手っ取り早い方法です。私たちは ルールトリガーモードの選択 でその一つを提示しました。
Step 3: Keep the reasoning where retrieval cannot decide its fate
Knowledgeはコーディングエージェントのための取得レイヤーであり、その役割を十分に果たします。しかし、規約の背後にある決定(最初に何を試し、何が壊れ、なぜそのルールが存在するのか)は、タスクによってトリガーされるものではありません。これらは、半年後にあなた自身が、おそらく別のツールで読み返したいと思うような内容です。
これらは、取得ルールが支配しない場所に保管してください。アイテムのコンテンツ内で理由が暗黙的にしか示されていない規約は、次の担当者によって簡単に覆されてしまうでしょう。
MemoryLakeでの設定方法
永続的な情報は、トリガーの説明によって制限されない場所を必要としています。MemoryLakeは、それらの決定事項を意図的に書き込むためのストアであり、単一のエージェントの取得ルールから切り離され、接続するすべてのAIアシスタントから読み取ることができます。エントリーはあなた自身の言葉で書き込みます。Cognitionのシステムや他のベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。あなたのKnowledgeアイテム、プレイブック、リポジトリは、完全にそれぞれの管理下に置かれたままになります。
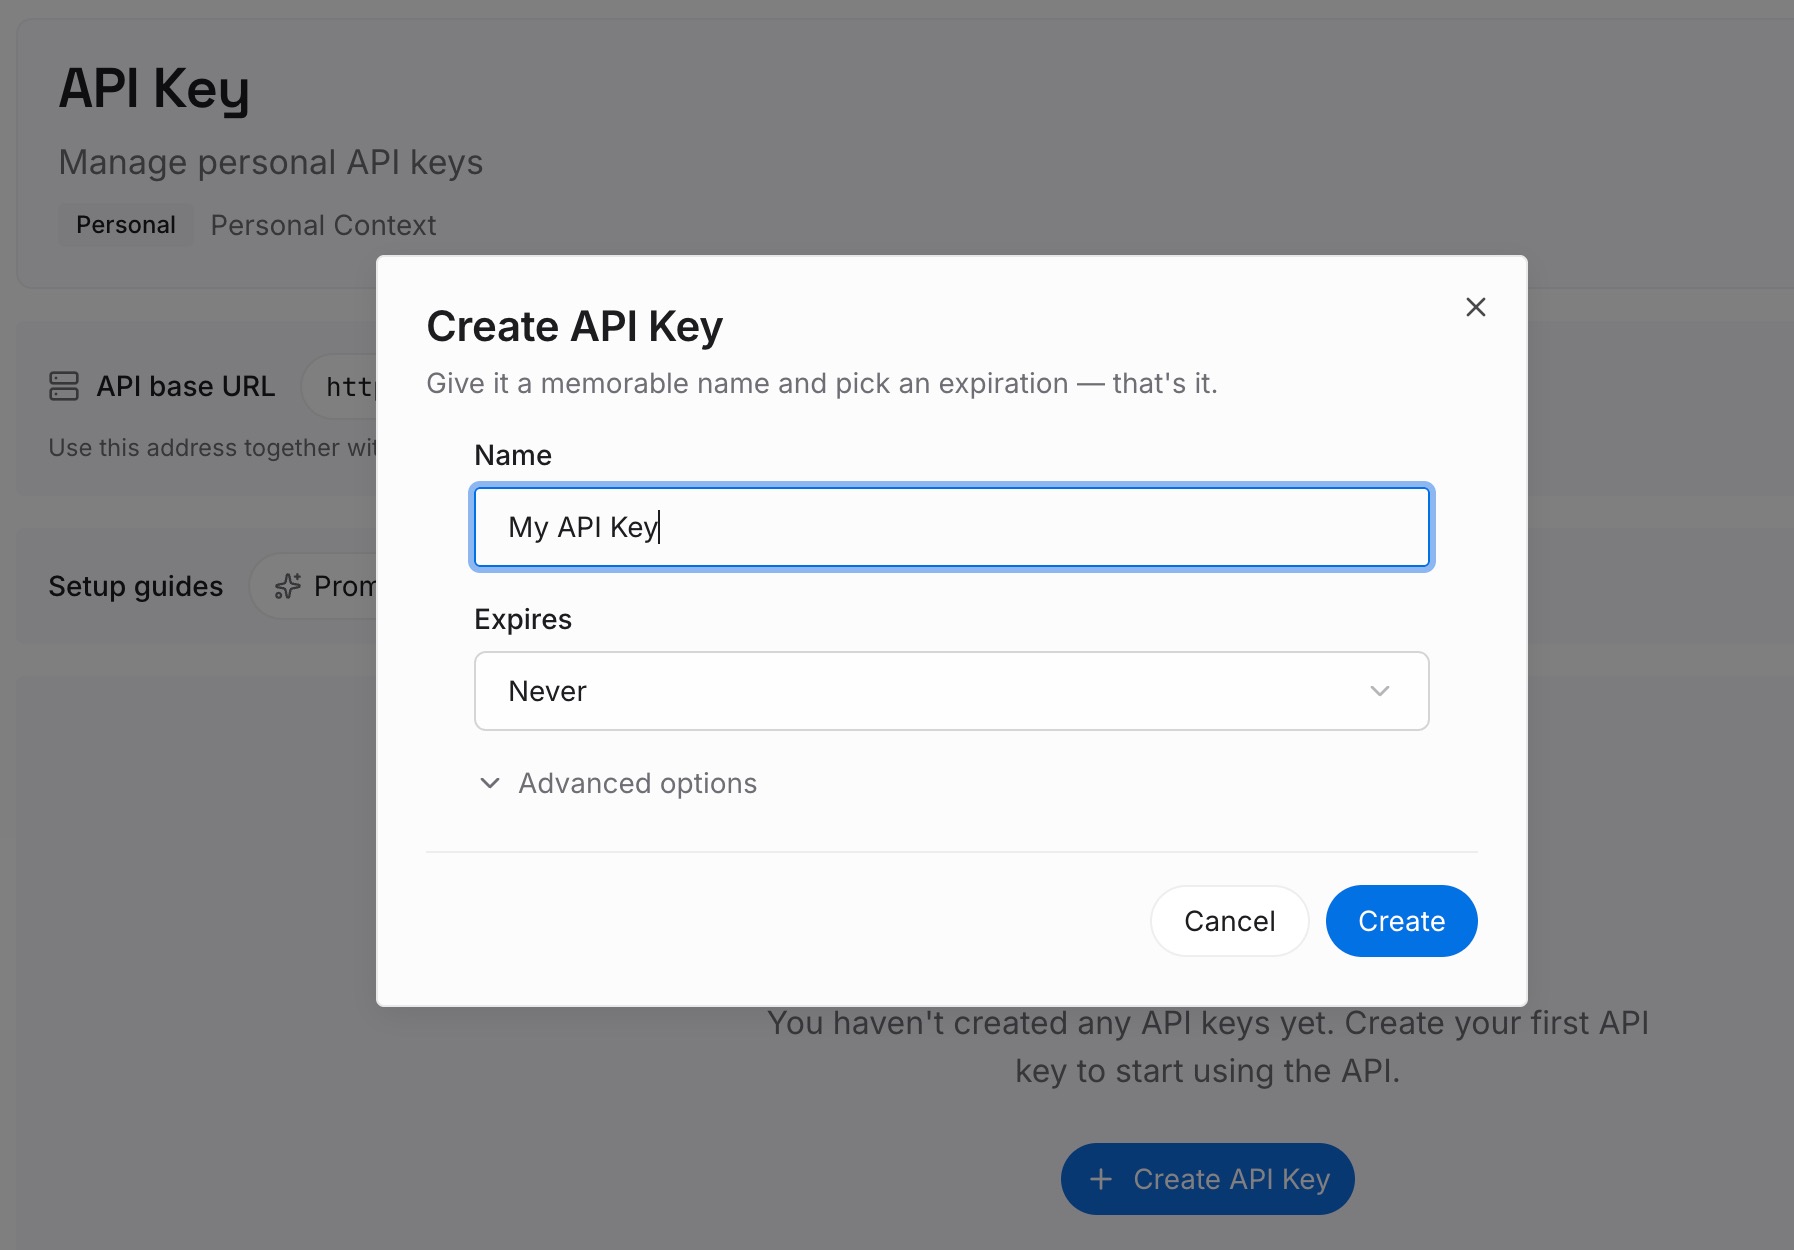
Step 1: Create an API key
ダッシュボードからキーを生成します。これにより、クラウドエージェント、ターミナルアシスタント、チャットクライアントが、それぞれ独自のバージョンを保持することなく、同じ事実のセットにアクセスできるようになります。
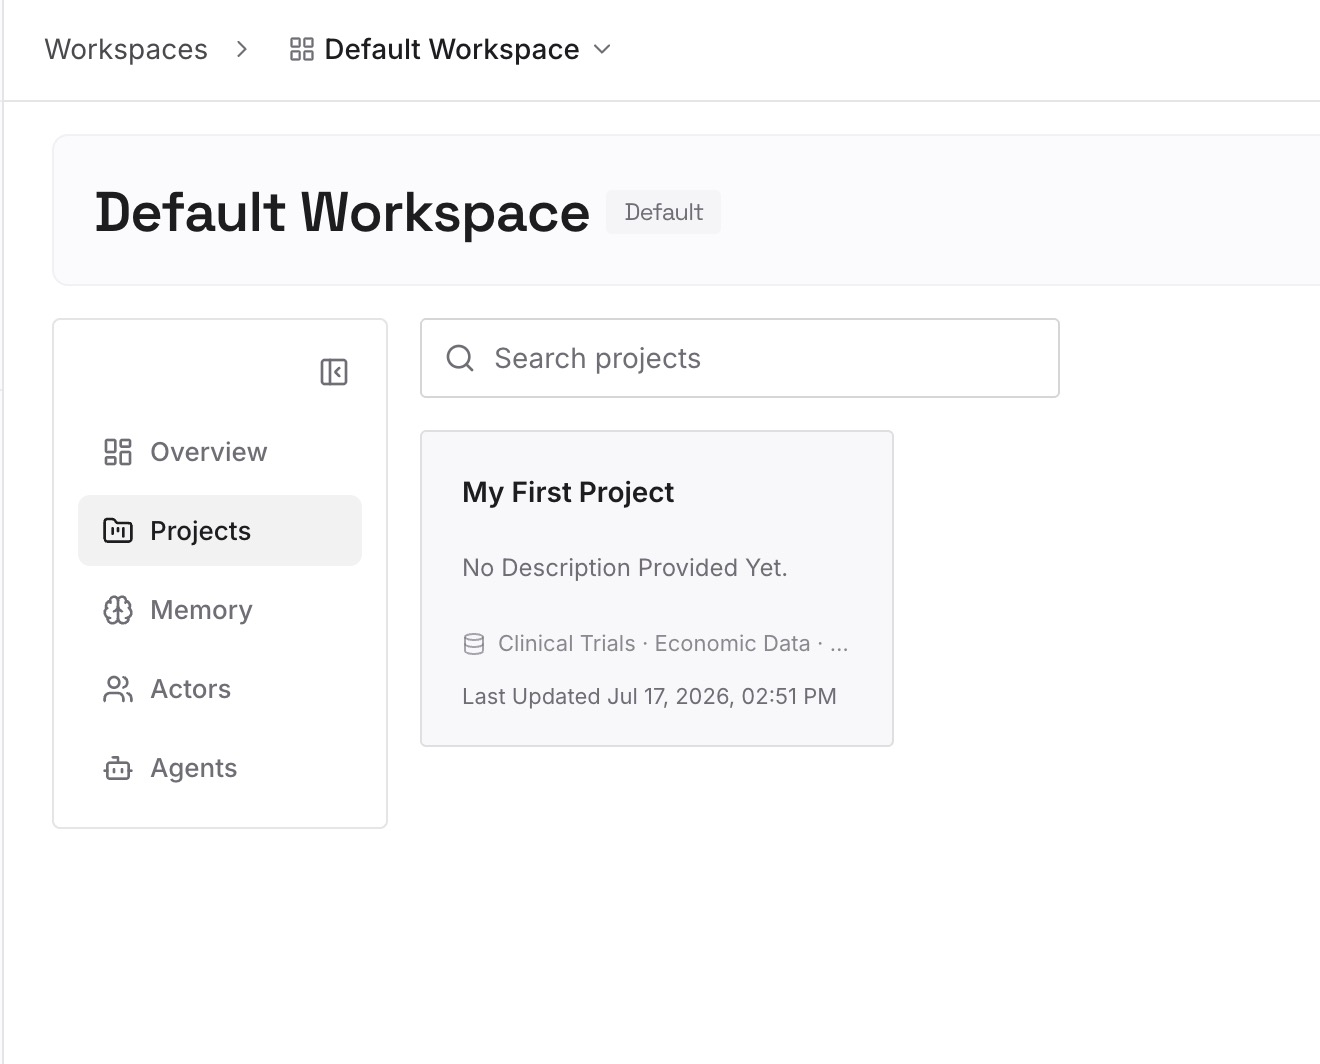
Step 2: Upload your first memories
ルールそのものよりも、その理由から始めましょう。なぜデプロイ順序がそのようになっているのか、どのアプローチがどのような理由で除外されたのか、誰がサービスを所有し、彼らに何を伝える必要があるのか。Knowledgeアイテムは指示を伝えますが、その議論(背景)を伝えることはほとんどありません。そして、指示が上書きされるのを防ぐのは、まさにその議論(背景)なのです。
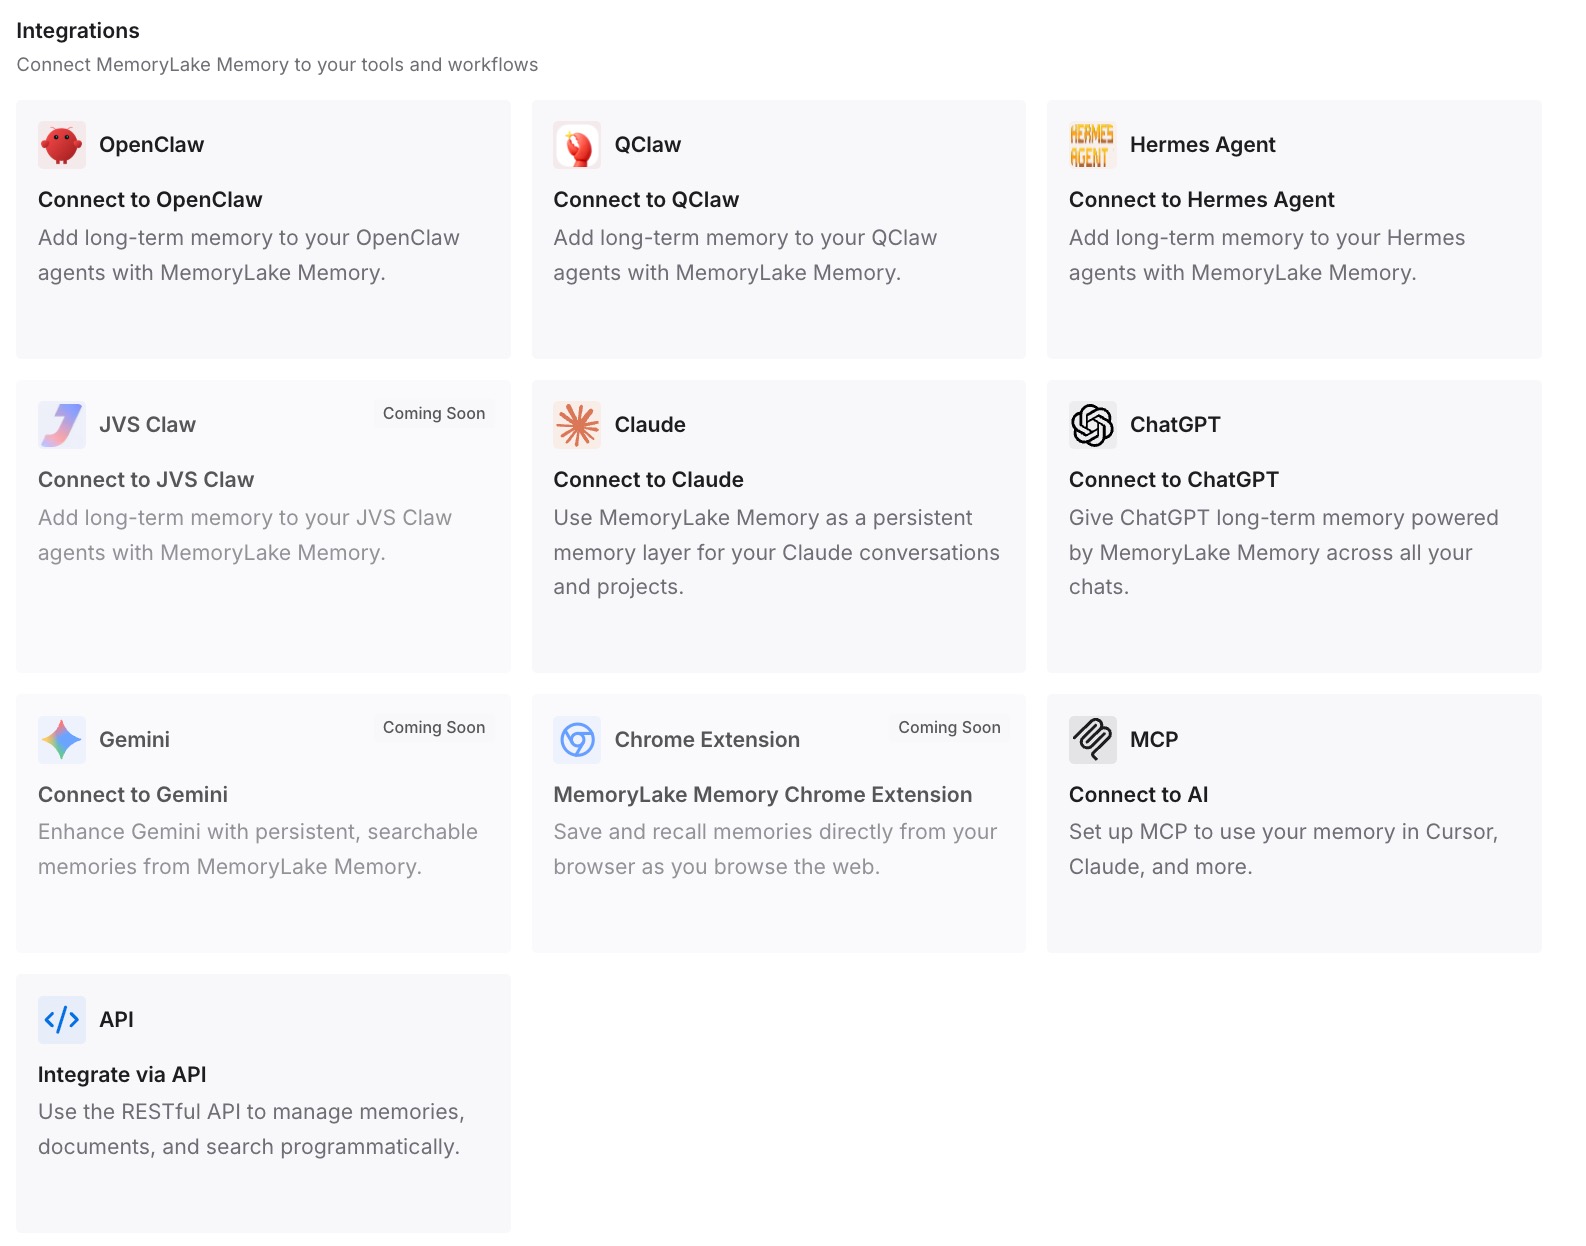
Step 3: Connect your AI & agents
ツールをこのレイヤーに向けることで、説明が一致したかどうかに依存せず、作業開始時にそれらの事実が読み込まれるようになります。そして、唯一意味のある方法でテストしてください。別のAIアシスタントに、その決定事項の1つを尋ねてみてください。もし答えが返ってくれば、あなたの推論はもはや特定のベンダーの取得パスの中だけに閉じ込められてはいません。
実務で何が変わるのか
最初の変化は、「Devinが自分のKnowledgeを無視した」という主張が検証可能になることです。Accessed Knowledgeは、何が使用されたかを教えてくれます。アイテムが取得されたか、されなかったかのどちらかであり、それぞれ修正方法が異なります。
2つ目は、固定(Pin)が、単にスキップしたフィールドではなく、意図的な選択になることです。リポジトリに固定すれば、そこで常に適用されるルールについて、取得されるかどうかの運任せではなくなります。
3つ目は、アイテムが短くなることです。取得がコンテンツを説明するトリガーに依存するようになると、1つのワークフローにつき1つのアイテムという構成が自然な形になり、Cognitionもまさにそれを推奨しています。
4つ目は、自動生成および自動提案されるKnowledgeが単なるノイズではなくなることです。DevinはREADME、ファイル構造、リポジトリのコンテンツからリポジトリのKnowledgeを生成し、チャットのフィードバックから新しいアイテムを提案します。両方を確認することはメンテナンスであり、それを怠れば、誰も読まないアイテムの山ができてしまいます。
5つ目は、永続的な推論がファイルの拡張子やスコープのレベルに依存しなくなることです。複数のツールにまたがって重要となる資料は、あなたに追従するレイヤーに属すべきです。これについては プロジェクト文書をAIの記憶に変換する で詳しく説明しています。
Devin Knowledgeのベストプラクティス
コンテンツを書く前にトリガーを書く。 アイテムがいつ取得されるべきかを説明できない場合、そのアイテムはおそらく2つのアイテムに分割すべきです。
1つのアイテムにつき1つのワークフロー。 Cognitionのガイダンスは、1つのワークフローまたはアクションを対象とし、可能な限り分割することです。取得されたアイテムは、その全体が読み込まれるためです。
無条件のものは固定(Pin)する。 リポジトリ全体の規約が、セッションごとに常に関連性の競争にさらされるべきではありません。
リポジトリ内コンテキストには専用のファイル拡張子を使用する。 Devinは指定された専用ファイルのリストから取得し、一般的なMarkdownを自動的に取得することはないため、拡張子は設計の一部です。
書き直す前に有効化設定を確認する。 他の人にとっては機能しているアイテムが自分には機能しない場合、ユーザーごとの無効化やフォルダレベルの切り替えが最も単純な原因です。
提案をそのまま受け入れず、確認する。 Devinは新しいアイテムと既存のアイテムの更新の両方を提案します。保存する前に編集できるようになっているのには理由があります。
議論(背景)はアイテムの外に置く。 指示はKnowledgeに置きますが、それが存在する理由は、すべてのツールが読み取れる場所に置くべきです。
結論
DevinのKnowledgeシステムは、十分にドキュメント化されていますが、少し直感に反する部分があります。アイテムはセッション開始時に読み込まれるのではなく、作業がトリガーに関連している時に取得され、すべてのアイテムにトリガーの説明が必要です。この1つの設計上の決定が、うまく書かれたアイテムが無視されたように見えるケースのほとんどを説明しています。
Cognitionは、取得に依存するのをやめる方法もドキュメント化しています。アイテムを特定のリポジトリに固定すれば、Devinがそこで作業する際に常に使用されます。すべてのリポジトリに固定すれば、すべてのセッションに適用されます。マクロを割り当てれば、名前で呼び出すことができます。そして、セッションチャットのAccessed Knowledgeビューは、Devinが実際に何を使用したかを教えてくれるため、疑念を確信に変えることができます。
覚えておくべき2つの境界線があります。Devinは、一般的なMarkdownからではなく、特定の専用ファイルのリストから自動的にKnowledgeを取得すること、そしてユーザーごとまたはフォルダごとの無効化設定により、同僚のセッションとあなたのセッションで同じセットが実行されているとは限らないことです。
アイテムを「トリガー型」と「常時オン型」に分類し、それぞれ1つずつAccessed Knowledgeで検証し、ルールの背後にある推論は、取得トリガーによって表示されるかどうかが左右されない場所に保管してください。