
Cognitionが実際に発表した内容
製品発表では、Memoryを「セッションをまたいで、あなたの好みの作業方法に関する有用な学習内容(設定、行った修正、プロジェクトやワークフローについて学んだ教訓など)を引き継ぐ」方法と説明しています。X(旧Twitter)上で、Cognitionはより簡潔に「セッションを通じて、Devinはあなたの好みの作業方法に関するメモリグラフを構築します」と述べています。
ドキュメントではストレージについて説明されています。「あなたのメモリはメモリドライブに保存されます。これはMarkdown形式のメモを保持する永続的なGitリポジトリです。」短い MEMORY.md ファイルが一般的な設定とインデックスを保持し、その他のメモはプロジェクトやトピックごとのフォルダに配置されます。
また、3つのパートからなるループについても説明されています。第1のパートでは、「各セッションがドライブの独自のチェックアウトを取得し、コンテキストとして MEMORY.md を受け取ります。」Devinは、タスクで必要になった場合にのみ、他のメモを検索して読み込みます。第2のパートでは、あなたがDevinを修正したり、Devinが再利用可能な何かを導き出したりしたときにメモを編集します。各エントリは、それが学習されたセッションへのリンクを含む1行の箇条書きになります。第3のパートでは、Devinがコミットし、他のセッションからの変更をマージして保存します。並行するセッションが同じドライブに書き込むことができ、ブログには「編集の競合は、暗黙的に上書きされるのではなく、解決のために表面化されます」と記載されています。
見落としがちなタイミングの詳細として、「新しいメモリは将来のセッションに適用され、それを書き込んだセッション自体には適用されません」という点があります。
そして、オープン標準があります。ドキュメントによると、Devinのメモリは「エージェントのメモリを MEMORY.md をエントリポイントとするGitリポジトリとして扱うオープン仕様であるAgent Memory Repoに基づいて構築されている」とのことで、「独自の自動エージェントでも同じフォーマットを使用できます」と付け加えられています。
これによって何が変わり、何が変わらないのか
Devinは、定められた制限の範囲内で何を保存するかを決定します。 ドキュメントには表が含まれています。保存されるもの:設定、修正、あなたが提示した理由を伴う決定事項、およびリポジトリに関する注意点。保存されないもの:「セッションの要約」、「PR番号やステータスなどのタスク状態」、「再発見が容易なもの」、「シークレットや資格情報」。ブログでは同じ考え方を別の表現で「メモリはセッションの要約ではありません」と説明しています。
Dreamingは追加、マージ、そして削除を行います。 「Dreamingは、Devinを使用しているときに1日に1回程度実行されるバックグラウンドセッションです。」重複するメモを統合し、キャプチャされていなかった教訓を追加し、インデックスを再編成します。また、「一時的な詳細や、どのセッションでも使用されなかった古いメモを削除します。」ブログでも、このステップを「どのセッションでも使用されなかった古いメモリレコード」の削除としてリストアップしています。Cognitionは、「ソースリンクと明示的な設定は保持されます」と注記しています。
Memoryは個人用です。 これがチームにとって最も重要な一文です。「メモリは、各組織内においてあなた個人に帰属します。チームメイトや組織と共有されることはありません。」ブログでは、これを設計上の選択肢として「組織の共有指示になるのではなく、あなた個人に帰属するものです」と表現しています。
自動化処理はメモリの対象外です。 「自動化によって開始されたセッションは、あなたのメモリを読み書きしません。」スケジュール、Slackトリガー、またはWebhookからDevinが開始するワークフローは、あなたの個人用メモなしで実行されます。
管理はDevinを通じて行います。 「Customize」から「Memory」を選択することで、メモリファイルを参照し、各Dreamingセッションが何を変更したかを確認できます。ただし、「アプリ内ではメモリファイルは読み取り専用です。」何かを変更したい場合は、セッション内でDevinに直接、設定を忘れるように、あるいはルールを覚えるように指示します。
オフにしてもメモは保持されます。 Memoryはデフォルトで有効になっています。個人用メモリをオフにすると、「Devinはメモリの読み書きを停止しますが、再度オンにすれば既存のメモは保持されます。」管理者が組織全体でオフにした場合、「Dreamingは実行されず、Memoryタブは非表示になります。既存のメモは削除されません。」
チーム向けのガイドラインには専用の場所があり、移行が進んでいます。 共有の指示について、Devinはskillsを推奨しています。skillsのページには「skillsは意図的に記述する手順である」とあり、プラグイン内のskillsは「個人、組織、またはエンタープライズのスコープでインストール可能」です。Devinの従来のKnowledge機能には、現在「Knowledgeは非推奨となり、将来のアップデートで削除されます」というバナーが表示されています。既存のKnowledgeは自動的にskillsに移行されています。Devin Knowledgeのガイドで説明されている方法でトリガーを設定していた場合、それらはskillsとして移行されると考えてください。
これは、CognitionのローカルエージェントであるDevin Desktopとも異なります。Devin DesktopのCascade時代のメモリについては、DevinのCascade限定メモリをskillsに移行するで説明されています。ここで説明しているメモリドライブは、devin.ai上のDevinに属するものです。
人々が誤解しがちな点と、その真実
「Devinはチームが決定したことを記憶している」という誤解。 Devinは、あなたと共同作業をする中で学んだことを記憶します。チームメイトのDevinは独自のドライブを持っています。あなたが先週Devinに説明した決定事項は、あなたのメモリにはありますが、彼らのメモリにはありません。
オープン仕様のチームユースケースを、Devinのメモリの仕様として読み違えること。 仕様書には、チームメモリがユースケースとして「顧客、プロセス、ツールに関する知識の共有(特にコードリポジトリを持たないチーム向け)」と記載されています。これは、このフォーマットがサポートできる内容を説明しているに過ぎません。そこでも共有はオプトイン方式です。仕様書の1つのセッションに2人が参加する例では、「Bobのメモリは、彼がセッションとの共有を選択した場合にのみクローンされる」とあり、各リポジトリは「独自の所有権、権限、履歴」を保持します。Devinの製品ドキュメントでは、自身のメモリは個人用であると説明されており、チーム向けのガイドラインはskillsを経由します。
「Devinが一度学んだことは、来月もそこにある」という誤解。 Dreamingは、どのセッションでも使用されなかったメモを削除します。これによりメモリのフォーカスが維持されますが、移行が中止された理由やコンプライアンスレビューで求められた内容など、めったに必要とされない重要な決定事項が、次に必要になるまでの間に整理(プルーニング)されてしまう可能性があります。
スケジュール実行が、あなたのセッションでDevinが学んだことの恩恵を受けられると期待すること。 自動化処理は個人用メモリを読み書きしません。
「Gitフォーマットだからメモリをどこにでも持ち運べる」という誤解。 仕様書の試用手順自体に、「クラウドセッションや別のマシンでセッション間でメモリを引き継ぐには、プライベートなリモートリポジトリやその他の永続ストレージが必要である」こと、およびスタンドアロン版には「自動起動やスケジュールされたDreamingは含まれていない」ことが記載されています。フォーマット自体はポータブルですが、その周囲の動作はそれを実装する各エージェントに依存します。
これらは批判ではありません。 1人の開発者と並行して作業するエージェントにとって、個人用で自己整理を行うメモリは合理的な設計です。重要なのは、それがどのようなコンテキストを保持しているかを理解し、それ以外のものは別の場所に配置することです。
解決策:個人に関することはDevinに学ばせ、チームに関することはチームが読める場所に置く
ステップ 1:Devinに学ばせるべき「個人用」と、チームが必要とする「チーム用」を分類する
自分がDevinに伝えていることをリストアップし、それを分類します。
個人のコンテキストはDevinのメモリに属します。アップデートの書き方の好み、好みのツール、あなた自身のスタイルを反映した修正などです。作業を進めながらDevinにこれらを学習させ、間違えた場合はセッション内で修正します。
チームのコンテキストには別の場所が必要です。全員が使用するビルドやテストのコマンド、アーキテクチャの境界、リリースのルール、そしてその背後にある理由などです。チームメイトのセッションや自動実行に適用すべき内容であれば、個人用メモリは不適切な場所です。
有効なテスト方法として、「同僚が明日同じリポジトリでセッションを開始した場合、これが必要になるか?」と自問してみてください。もし「はい」であれば、それはチームのコンテキストです。
ステップ 2:手順はskillsやリポジトリファイルに記述し、理由も併記する
Devin自身のガイダンスでは、skillは「手順を提供し、メモリはそれをあなたの作業に適用するためのコンテキストを提供する」とされています。そのため、再現可能な手順は、リポジトリ内の .agents/skills/ や、プラグインを介した組織スコープのskillsとして記述します。リポジトリの規約は、Devinが読み取る AGENTS.md などのファイルに保持します。
手順を書くときは、その理由も含めてください。マージ前に統合テストスイートを実行するようにDevinに指示するskillは実行されます。さらに、なぜそれを行うのか、前回それをスキップしたときに何が起きたのかを説明するskillは、次のリファクタリングを乗り越えて生き残ります。skillsとメモリは異なる目的を果たします。この違いについては、なぜエージェントのskillsはメモリではないのかで詳しく解説しています。
その後、移行される古いKnowledgeアイテムを確認してください。それぞれが意図したスコープに配置されていること、そして動作しなくなったトリガーの中に重要な情報が取り残されていないことを確認します。
ステップ 3:めったに発生しないが失ってはならない決定事項を書き留める
一部のコンテキストは、最近の使用頻度に依存させるには重要すぎます。なぜサービスが分割されたのか。どのベンダーがなぜ却下されたのか。顧客契約で何が求められているのか。これらは年に数回しか発生しないため、まさに整理(プルーニング)処理によってクリーンアウトされる対象となります。
これらは、日付とソースを明記して、意図的に管理する記録として保持してください。Devinのエントリはすでに取得元のセッションにリンクバックしていますが、これはメモリの出所(provenance)で詳しく説明されている優れた習慣です。ご自身で管理する決定事項にも、これと同じ習慣を適用してください。
めったに使われない決定事項が関連してくる場合は、セッション内で明示的に提示します。そうすればDevinはそれを使用でき、あなた個人にとって重要であれば、再びメモリに保存されます。
MemoryLakeでの設定方法
ステップ3では、個人のエージェントに依存すべきではない、チーム用および長期保存用のコンテキストレイヤーについて説明しました。MemoryLakeは、まさにそのために構築されています。一度書き込めば、それを必要とする人々やエージェント間で共有できる長期メモリです。
エントリはあなた自身の言葉で直接書き込みます。Devin의メモリドライブ、あなたのskills、またはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。
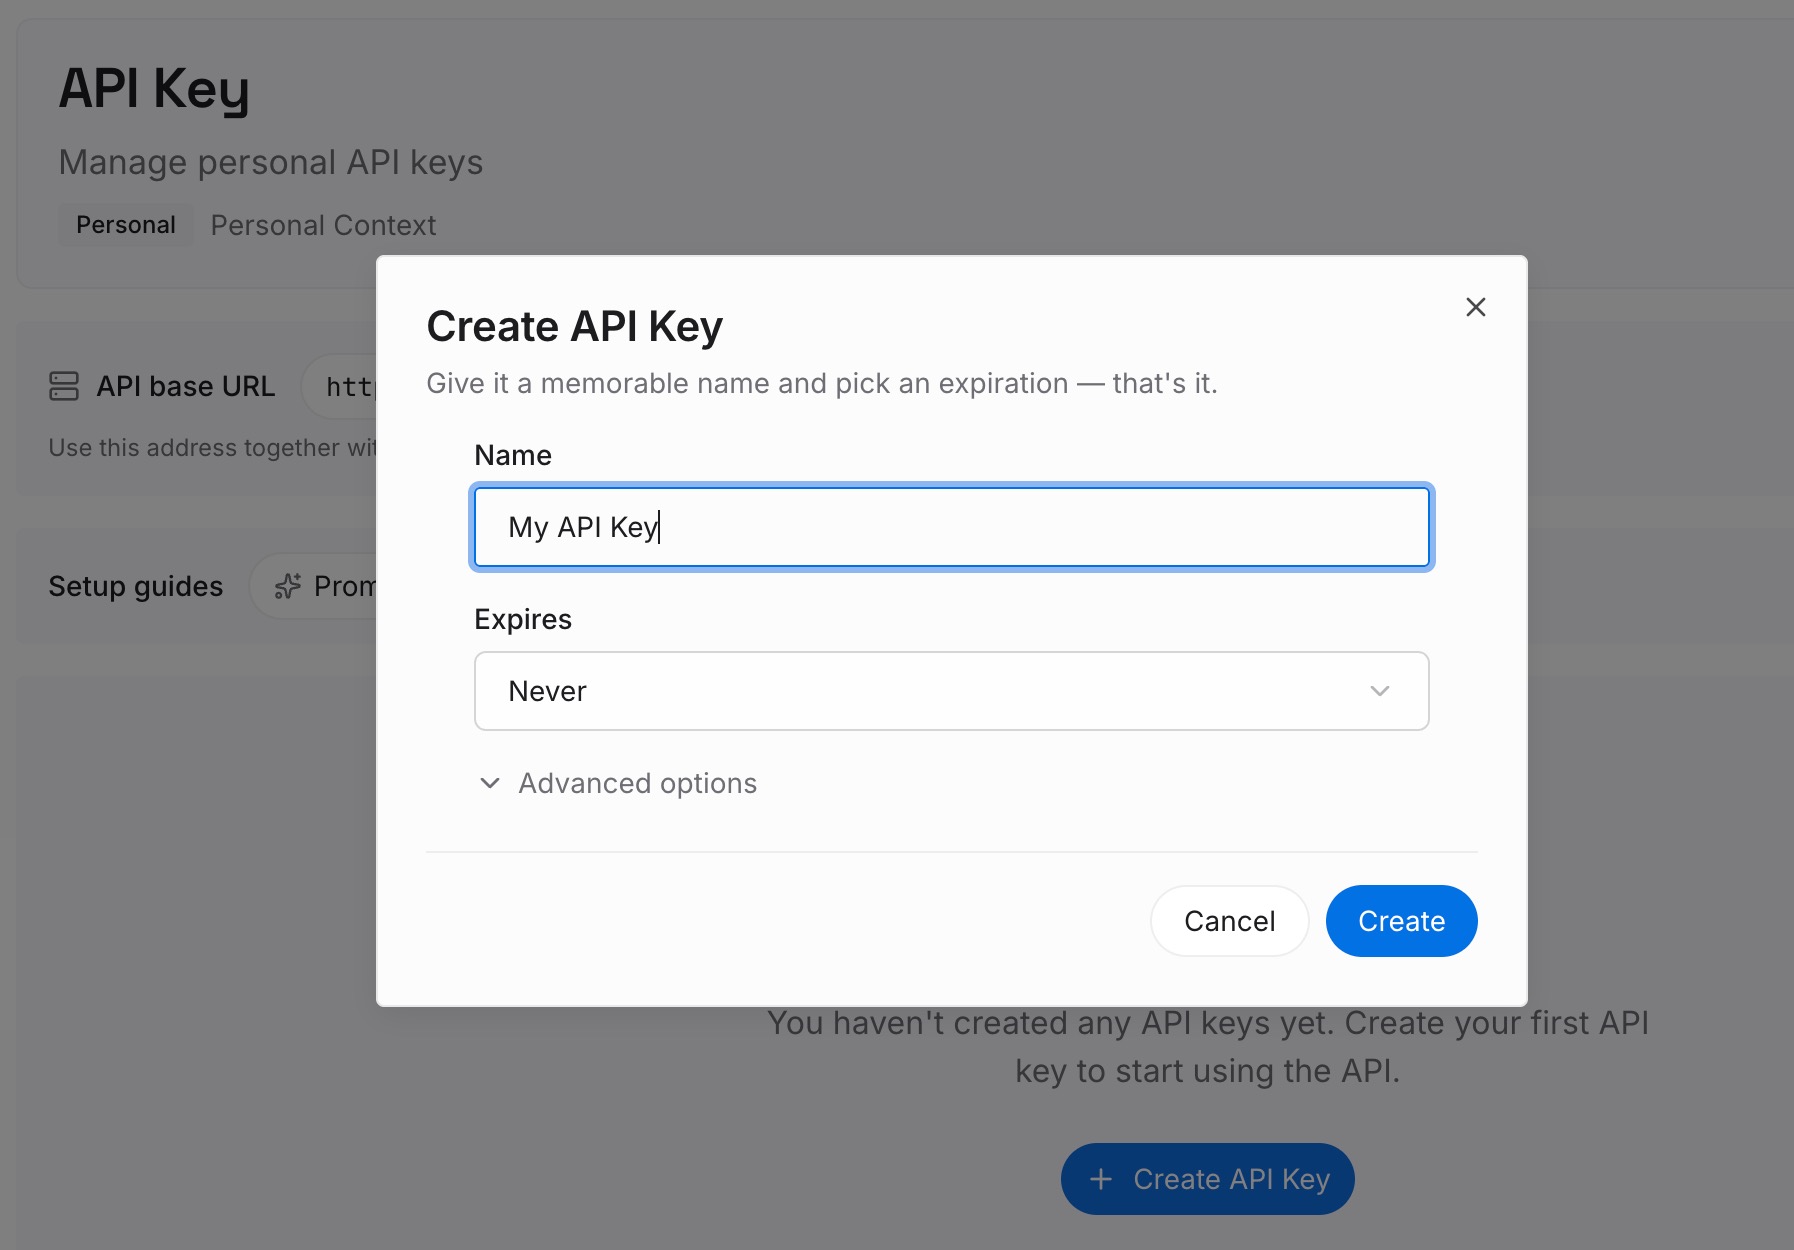
ステップ 1:APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーは、Devinの組織とは無関係に、あなたのMemoryLakeワークスペースに属します。
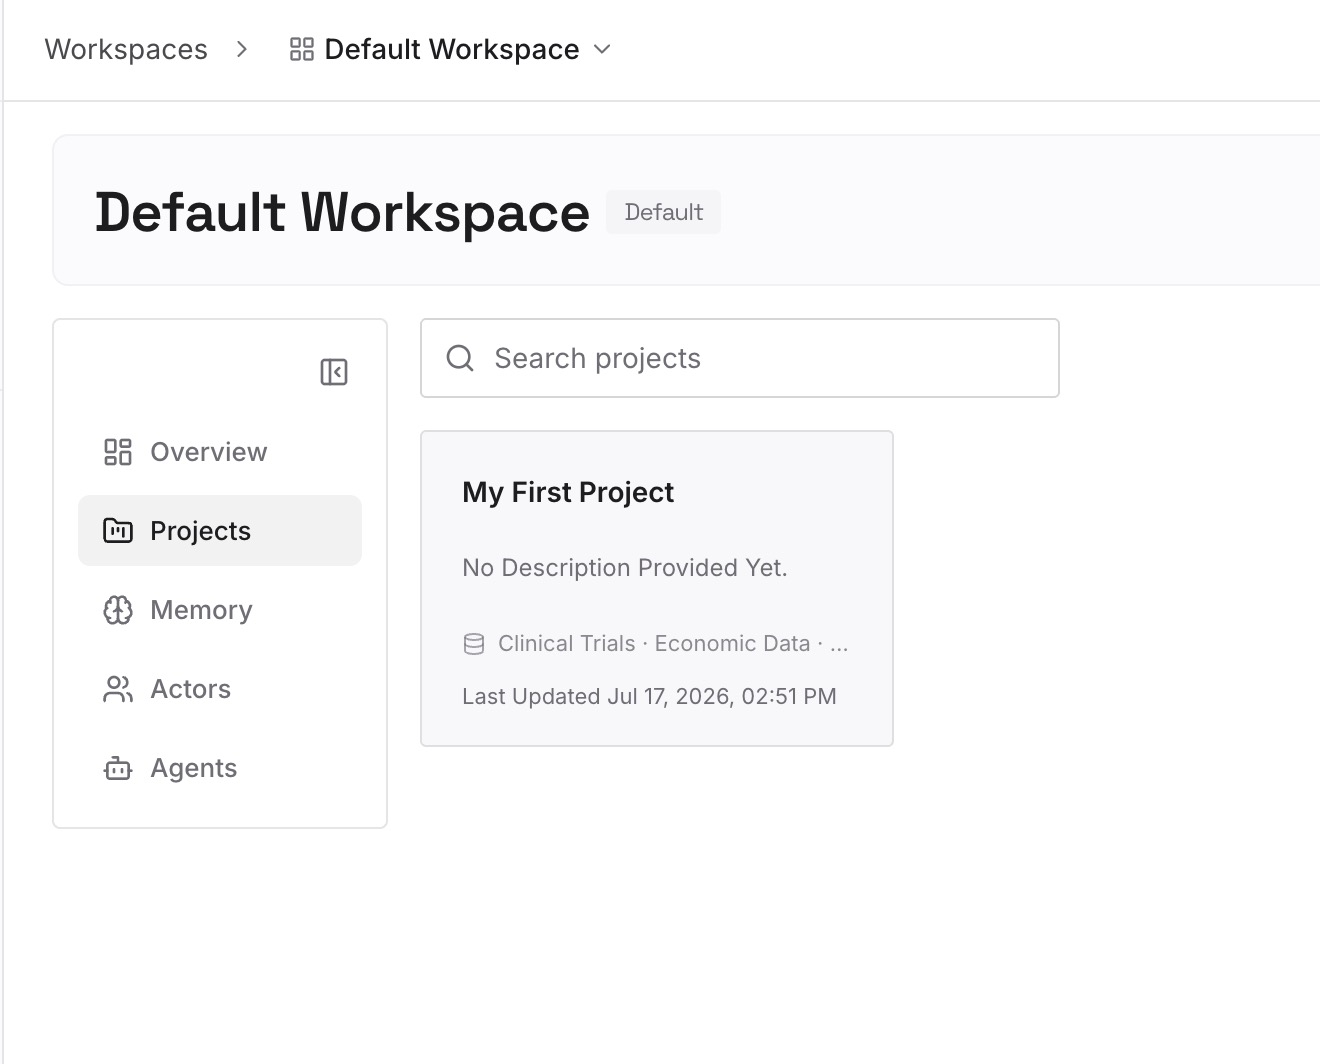
ステップ 2:最初のメモリをアップロードする
ステップ3の決定事項(日付と理由が記載された、まれだが重要なもの)から始めます。ステップ1のチームコンテキストのうち、skillに自然に収まらないものを追加します。
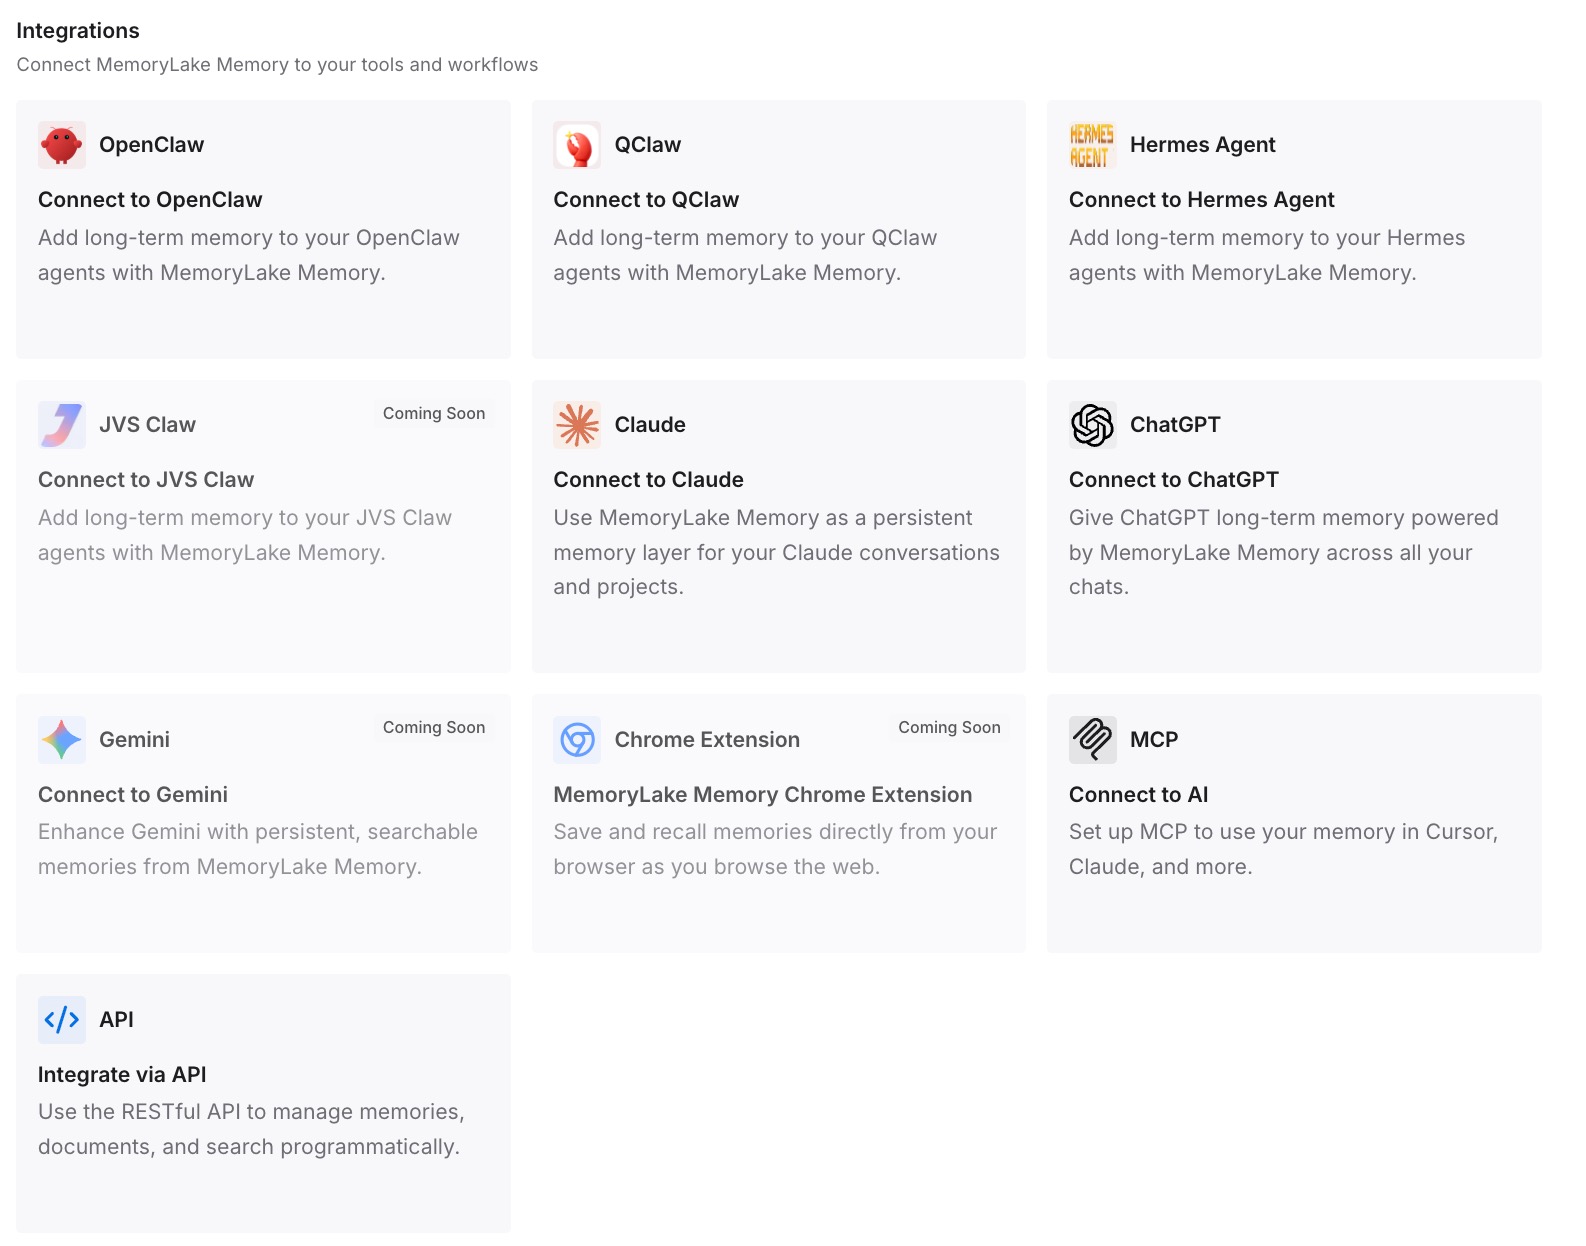
ステップ 3:AIとエージェントを接続する
Devinや、チームが使用している他のエージェントを接続します。これにより、同じ決定事項がすべてのチームメイトやツールで利用可能になり、誰の個人用メモリも持たずに開始される実行でも利用できるようになります。
実務で何が変わるのか
第1の違いは、Devinのメモリがその得意分野に専念できる点です。個人の設定や修正は、誰もメンテナンスすることなく蓄積され、Dreamingがそれらを整理してくれます。
第2に、チームのコンテキストが「誰がセッションを実行したか」に依存しなくなります。手順はskillsに、規約はリポジトリに、長期的な決定事項は共有レコードに保存されます。チームメイトのセッションも自動実行も、同じ土台から開始されます。より広範なセットアップについては、チーム向けの共有AIメモリの設定方法を参照してください。
第3に、整理(プルーニング)がリスクではなくなります。めったに必要とされない重要な決定事項が別の場所に書き留められていれば、Dreamingが未使用のメモを削除することは、損失ではなく単なる整理整頓になります。
第4に、何が移動するのかが明確になります。メモリフォーマットはオープンですが、チームの知識が1人のエージェントに依存して移動する必要はありません。複数のエージェントを並行して実行しているチームは、より大きな規模で同じ問題に直面します。これについては、マルチエージェントシステム向けの共有メモリソリューションで議論されています。
Devinメモリのベストプラクティス
Devinにあなたの個人的な設定を学習させる。 それこそがメモリの目的です。
セッション内でメモリを修正する。 アプリ上ではメモリファイルは読み取り専用として表示されます。Devinに忘れるか覚えるかを指示してください。
チームの手順はskillsに配置する。 メモリは個人用です。skillsは組織スコープで設定できます。
移行されたKnowledgeを確認する。 各アイテムが適切なスコープのskillとして配置されていることを確認します。
自動化処理には明示的に指示を与える。 スケジュール実行やトリガー実行では、個人用メモリは使用されません。
まれな決定事項は耐久性のある場所に保管する。 Dreamingは、どのセッションでも使用されなかったメモを削除します。
前提を置く前に設計を比較する。 ClaudeのDreamingメモリシステムが示すように、他のアシスタントもバックグラウンドでメモリを統合するようになっていますが、それぞれ境界線の引き方が異なります。
結論
Devinの新しいメモリは、その目的に対して非常によく設計されています。設定、修正、教訓をGitリポジトリ内の短いメモとして保存し、それぞれをソースにリンクさせ、統合、追加、削除を行う日次のDreaming処理を実行します。Cognitionはこのフォーマットを公開したため、他のエージェントもこれを利用できます。
ドキュメントではスコープが明確に示されています。メモリは「各組織内においてあなた個人に帰属」し、自動化処理はそれを読み書きせず、Dreamingはどのセッションでも使用されなかったメモを削除します。チーム向けのガイドラインはskillsに属し、Devinの従来のKnowledge機能はそこへ移行されています。
したがって、Devinにはあなた自身について学習させ、チームの手順はskillsやリポジトリファイルに配置し、めったに発生しないが失ってはならない決定事項は、チーム全体がアクセスできる記録として保持するようにしましょう。