
xAIが実際に公開した内容
この仕組みは3つの部分で説明されており、それぞれに境界線が設けられています。
キャプチャ(Capture)。「ターンが完了すると、Grokはバックグラウンドでそれをレビューし、規約、決定事項、プロジェクトの事実など、永続的なものを記録します。キャプチャは完了したすべてのターンで実行され、セッションを中断することはありません。」つまり、書き込みはターンの完了後に自動的かつ事後的に行われます。ターンの途中で書き込まれることはなく、確認を求められることもありません。
ストレージ(Storage)。「メモはMarkdownファイルで、1つのテーマにつき1つのトピックが作成されます。各プロジェクトには独自のワークスペーススコープがあり、グローバルスコープにはどこにでも適用される設定が保持されます。」2つのスコープがあり、ディスク上のプレーンなファイルとして保存されます。/memoryというコマンドは「すべてのメモリファイルをスコープ別にグループ化し、選択したファイルのプレビューを表示する読み取り専用ブラウザを開き」ます。また、2つ目のコマンドである /dream は「新しい観察結果をそれが属するトピックにマージ」し、「バックグラウンドで定期的に自動実行」もされます。
リコール(Recall)。「関連する作業を開始する前に、Grokはその領域をカバーするトピックを読み込んで適用します。これには、そのテーマが一度も登場しないセッションも含まれます。」そして、優先順位のルールが1行で述べられています。「現在の会話における指示は、メモ内のいかなる内容よりも優先されます。」
そして、スコープに関する記述の全文は以下の通りです。「メモリは、後のセッションで重要になる可能性が最も高い詳細を保持します。チームがコードを記述およびレビューする方法、決定事項とその背後にある理由、サブシステムがどこにあるかからどのコマンドでテストスイートを実行するかといったプロジェクトに関する永続的な事実などです。タスクの状態、暫定的な結論、シークレット、およびリポジトリやそのドキュメントがすでにカバーしている内容は除外されます。」
発表内のプロダクトのスクリーンショットから、見落としがちですがもう1つ詳細があります。生成されたインデックスファイルには、「Generated by Grok. Do not edit this file directly.(Grokによって生成されました。このファイルを直接編集しないでください。)」という行が含まれています。
利用可能性については、濁すことなく明記されています。「メモリ機能は現在、Grok Buildで利用可能です。新しいセッションに適用されます。/newを実行するか、新しいgrokを開始すると、最初のターンが完了した後にメモの作成が始まります。」
これによって変わること、変わらないこと
これにより、1つのプロジェクト内での継続性のコストが変わります。もしチームが言語独自のテストコマンドではなく、ラッパーを介してテストスイートを実行している場合、それこそがこの機能が保持するために構築された「永続的なプロジェクトの事実」であり、発表内の具体例もまさにそれです。毎セッションそれを繰り返すのは純粋なオーバーヘッドでしたが、これからはその必要がなくなります。
進行中の作業に何が起こるかは変わりません。「タスクの状態」は除外リストの最初の項目です。マイグレーションの途中でターミナルを閉じると、メモにはチームがマイグレーションをどのように記述するかが保持されますが、7つのステップのうちステップ4にいて、まだ2つのファイルを変換する必要があるといった情報は保持されません。これは意図的な設計上の選択であり、擁護できるものです(中途半端な状態は、プロジェクト内の他の何よりも早く陳腐化するためです)。しかし、これは「エージェントが私たちの進捗状況を覚えている」というイメージとは正反対のものです。
まだ結論に至っていない事柄に何が起こるかも変わりません。「暫定的な結論」が2番目の項目です。火曜日に「エッジでキャッシュすべきか、サービスでキャッシュすべきか」と自問自答し、「おそらくサービスだろう、様子を見よう」で終わった議論。それこそが来週最も必要となる推論であり、かつ「まだ永続的ではない」として最もフィルタリングされやすい推論なのです。
リポジトリを複製することもありません。「リポジトリやそのドキュメントがすでにカバーしている内容は除外される」というのは賢明なルールですが、問題を静かに別の場所へと移し替えています。つまり、ドキュメントが触れているすべての事柄について、メモリの完全性はドキュメントの完全性に依存するということです。READMEが間違っていれば、メモがそれを訂正することはありません。
そして、シークレットを保持することもありません。これは当然のことであり、議論の余地はありません。
これらはどれも欠陥ではありません。xAIは謝罪すべき制限事項を説明しているのではなく、リリースページで事前に「書き込みポリシー」を説明しているのです。これは、ほとんどのメモリ機能が教えてくれる以上の情報です。有益な対応は、この機能に対して懐疑的になることではなく、どの4つのカテゴリが別の場所に居場所を必要としているかに気づき、3週間後にそのギャップに気づくのではなく、意図的にその居場所を選択することです。
人々が誤解しがちなこと
「エージェントが私の作業を中断したところから再開してくれる。」 エージェントが引き継ぐのは、あなたの規約と決定事項です。中断した場所は「タスクの状態」であり、タスクの状態は名指しで除外されています。
「もう何も書き留めなくていい。」 1つのリポジトリ内の規約やプロジェクトの事実については、おおむねその通りです。しかし、除外リストにあるすべての項目や、別のツールや別のマシンから読み取れるようにする必要があるものについては、そうではありません。メモはプロジェクトごと、インストールごとに作成されます。
「私が言ったことはすべて記憶される。」 キャプチャは「完了したすべてのターンで実行」されますが、記録されるのは「永続的なもの」です。「永続的」かどうかは、モデルがあなたのターンに対して行う判断です。発表では、特定の文言が必ず保存されるとは約束されておらず、インデックスファイル自体のヘッダーにも、それは執筆されたものではなく生成されたものであると書かれています。
「メモの内容はプロンプトの指示に勝つ。」 勝つことはありません。そして、これが正しい設計です。「現在の会話における指示は、メモ内のいかなる内容よりも優先されます。」メモが間違っている場合、今入力した内容がそのセッションにおいてメモを上書きします。そして、ファイルを修正するまで、そのメモは明日になっても間違ったままです。
「Skills(スキル)と同じである。」 仕組みもトリガーも異なります。私たちは、GrokのSkillsが再利用可能なAIメモリにとって意味すること でその境界線を引き、その区別の一般的なバージョンは エージェントのスキルがメモリではない理由 にあります。スキルはあなたが呼び出す機能であり、これらのメモはあなたについて書き留められた観察結果です。
解決策:除外された4つのカテゴリの居場所を作る
除外リストは仕様です。仕様として扱いましょう。
ステップ 1:暫定的な結論は自分で書き留める
失ったときに最もコストがかかるカテゴリは、その時点では最も重要でなさそうに見えるものです。つまり、到達したものの、まだコミット(確定)していない結論です。「おそらくこれをシャードすることはないだろう。」「リトライロジックは問題ない。タイムアウトが問題だ。」これらはコミットメッセージに残ることはなく、ドキュメントにするには暫定的すぎ、設計上キャプチャから除外されます。
これらを日付と理由とともに、ステートメントとして書き留めてください。それぞれ1行で十分です。結論よりも理由の方が重要です。なぜなら、その理由こそが、来月になってもその結論がまだ有効かどうかを教えてくれるからです。
ステップ 2:タスクの状態を示す引き継ぎ用の1行を残す
タスクの途中でセッションを閉じる前に、タスク状態の除外によって他の誰も書かないであろう「引き継ぎの1行」を書いてください。何をしていたか、何が完了したか、次に何をすべきか。これには15秒しかかかりませんが、そうしなければ差分(diff)から状況を再構築するために費やすはずだった10分間を節約できます。
これはこの機能に対する批判ではありません。数ヶ月間持続するストアにおいて、タスクの状態を除外することは正しい判断です。ただ、引き継ぎを書くのはあなたの役目であり、見失ってしまうような一時ファイルに書くよりも、永続的な場所に書く方がはるかに優れているというだけのことです。
ステップ 3:ツールを離れても残すべき事実を決める
メモは、1台のマシン、1つの製品内の、プロジェクトごとおよびグローバルにスコープされたMarkdownファイルです。すべての作業がそこで行われている間は、それで問題ありません。その環境を超えて残す必要がある事実とは、来期に別のマシンの別のアシスタントに対して再説明しなければならないような事実です。アーキテクチャの決定、所有権、不自然な設計を説明する制約などです。
これはセッションの継続性とは異なる要件であり、自分の事実のどれがどちらに該当するのかを明確にすることには価値があります。私たちは、エージェントに実際にどれだけのメモリを与えるべきか でサイズに関する問題を詳しく検討しました。
MemoryLakeでの設定方法
これら3つのステップはすべて同じ対象を示しています。それは、会話の書き起こしから推測されたものではなく、あなたが意図的に保持することを選択した事実です。MemoryLakeは、これらの事実をあなた自身が書き込むストアであり、どのツールがその事実を生成したかに関係なく、接続した任意のアシスタントから読み取ることができます。エントリーはあなた自身の言葉で、あなた自身が書き込みます。xAIのシステムや他のベンダーのストアから読み取られたり、書き込まれたり、削除されたりすることは一切ありません。Grok Buildのメモは、完全にGrok Build自身の管理下に置かれたままです。
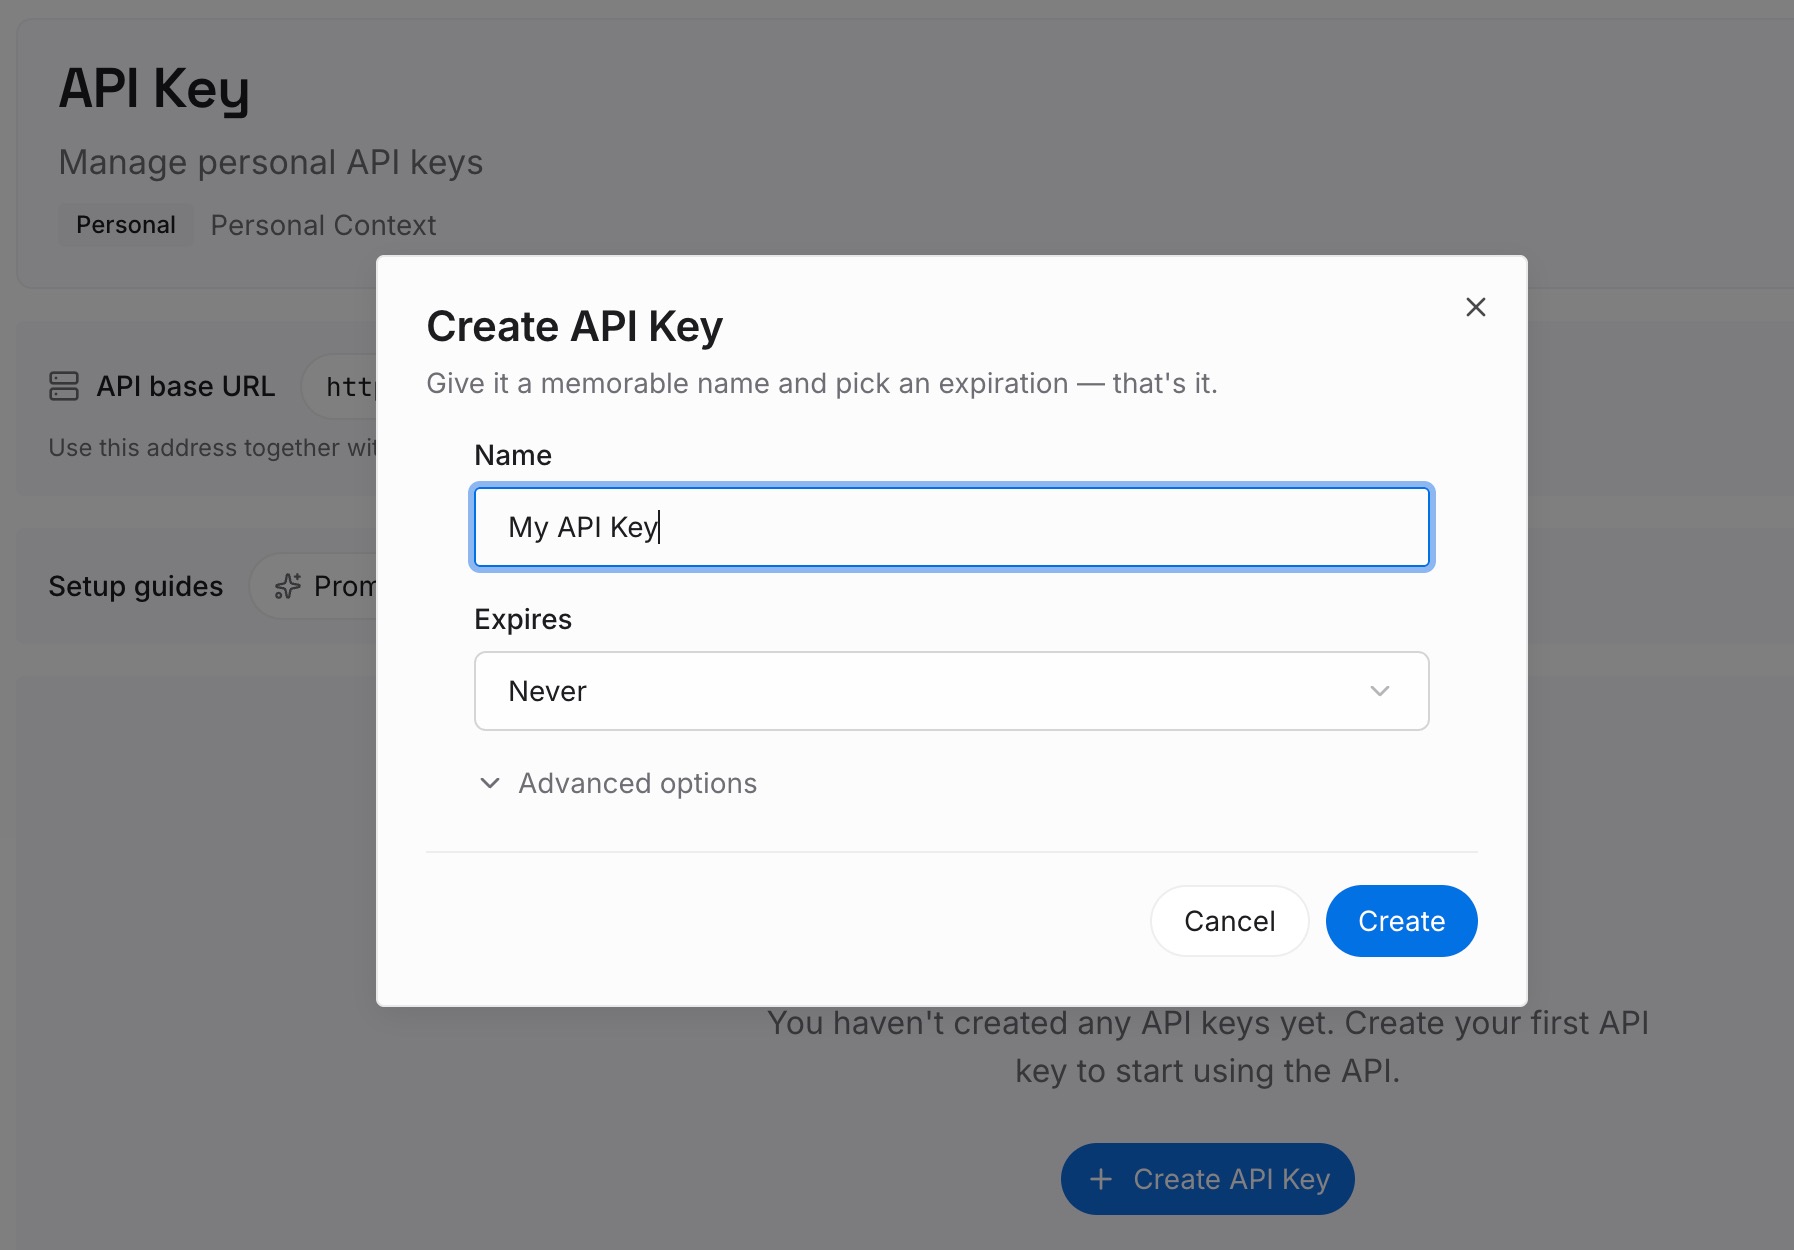
ステップ 1:APIキーを作成する
ダッシュボードからキーを生成します。これにより、コーディングエージェント、チャットアシスタント、そして来期に使うかもしれないあらゆるツールが、同じ事実のセットにアクセスできるようになります。
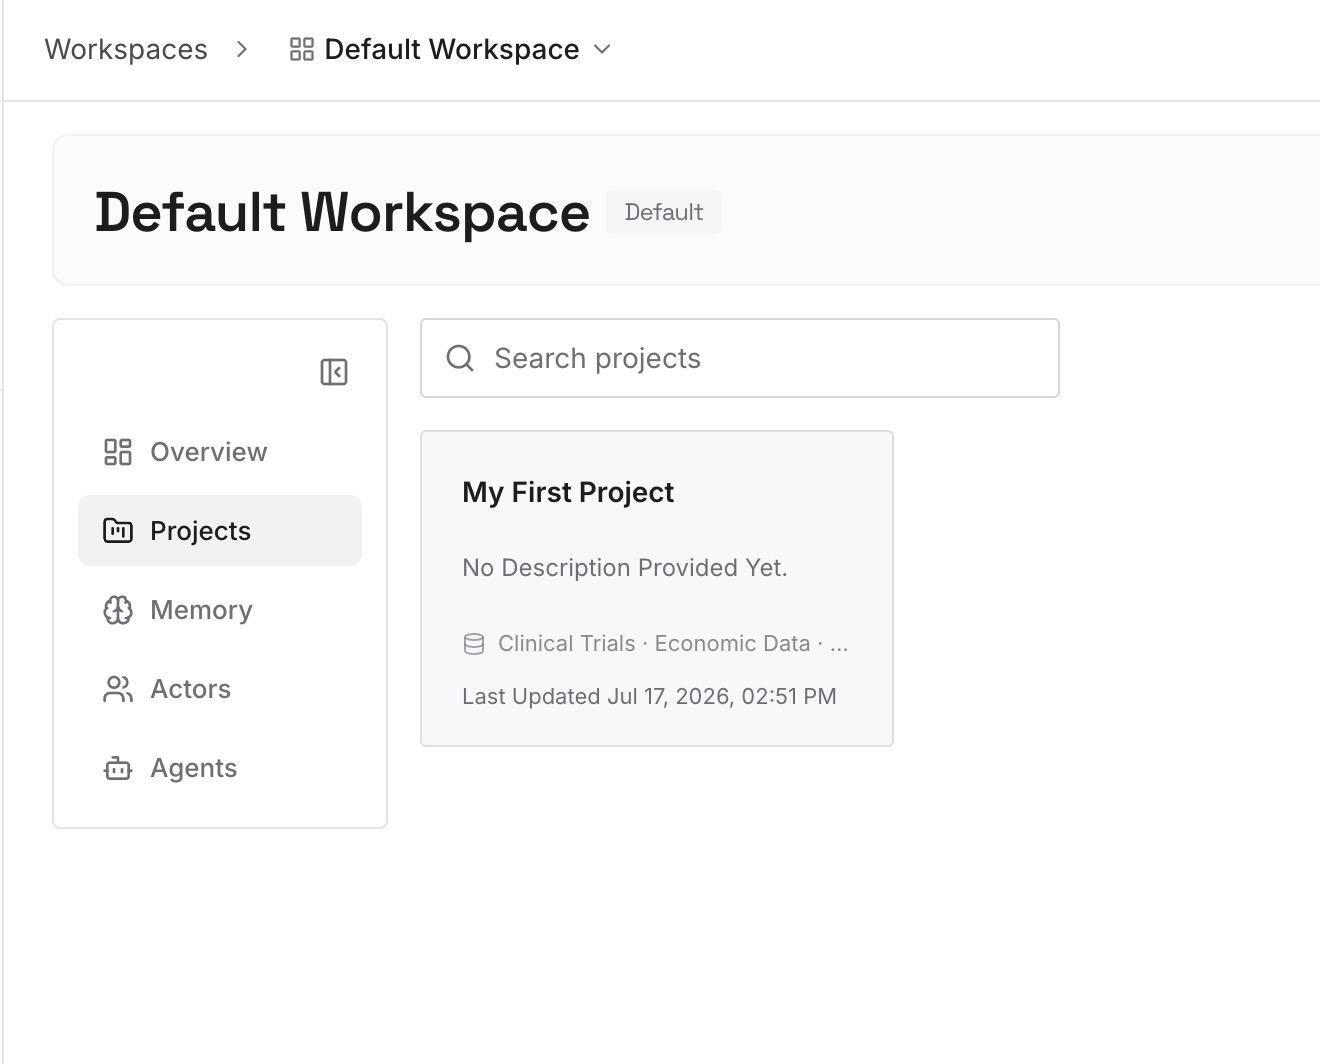
ステップ 2:最初のメモリをアップロードする
除外された4つのカテゴリから始めましょう。暫定的な結論、引き継ぎの1行、および理由を再導出したくない決定事項などです。通常、1つのプロジェクトにつき12個ほどの短いエントリーでカバーできます。それぞれをストーリーとしてではなく、日付付きのステートメントとして記述してください。
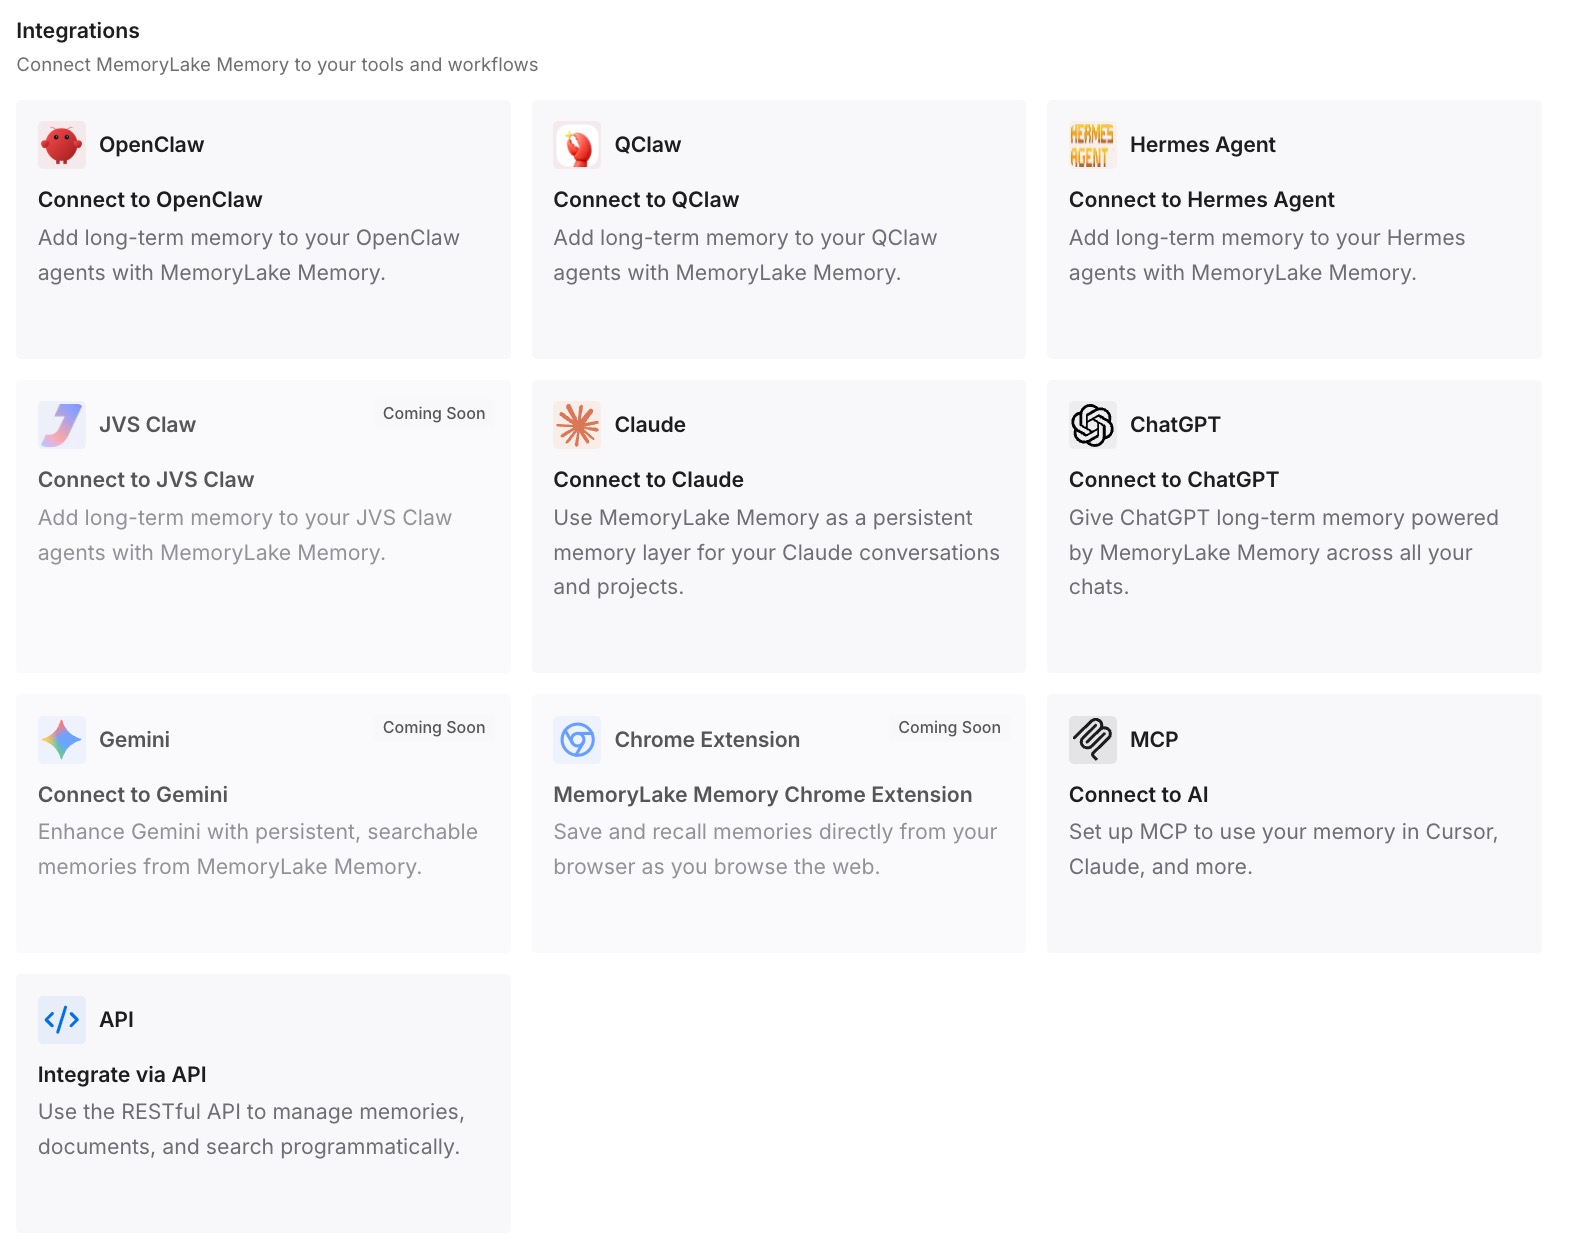
ステップ 3:AIとエージェントを接続する
ツールをこのレイヤーに向けることで、セッションの開始時に事実を再構築するのではなく、ロードさせることができます。そして、それを証明する方法でテストしてください。別のツールで新しいセッションを開き、その事実の1つを尋ねてみてください。もし回答が得られれば、その事実はもはや1つの製品の書き込みポリシーに依存しなくなったことになります。
実務における変化
最初の変化は、発表内容が単なる期待ではなく、検証可能なものになることです。「覚えている」という主張は検証できません。しかし、「規約、決定事項、プロジェクトの事実から、タスクの状態、暫定的な結論、シークレット、ドキュメントがすでにカバーしている内容を除いたもの」という主張であれば、自分の1週間の作業と照らし合わせて、どこにギャップがあるかを確認できます。
2つ目は、ドキュメントが静かに、新しい形で重要な役割を担うようになることです。メモは「リポジトリやそのドキュメントがすでにカバーしている内容」をスキップするため、古くなったドキュメントは、メモリが意図的に優先したドキュメントになってしまいます。READMEのレビューは、単なる身だしなみ(衛生管理)ではなく、メモリのメンテナンス作業になります。
3つ目は、Grok Buildを一度も開かないとしても、「トピックごとのファイル」という設計は模倣する価値があるということです。1つのテーマにつき1つのトピックを作成し、定期的にマージし、その結果を読み取り専用ブラウザで確認できるようにすることは、肥大化し続ける単一のファイルよりも優れた形状であり、手動で管理するストアにも同じ形状が適用できます。蓄積され続けるログの失敗パターンについては、検索可能なセッションログが、メモリを求める人々を失望させ続ける理由 で説明しています。
4つ目は、Grokのチャット側にメモリを追加することは、依然として別の仕組みを持つ別の作業であるということです。私たちはその選択肢を Grokに永続的なメモリを追加する実用的な方法 で取り上げました。Grok BuildのメモはGrok Buildにスコープされています。
自動書き込みメモリを扱うためのベストプラクティス
信頼する前にメモを読む。 そのために /memory が存在します。ファイルを読み取り専用ブラウザで確認することが、ひっそりと間違っている1つのメモを見つける最も早い方法です。
会話の中ではなく、ファイルでメモを修正する。 会話での指示は現在のセッションで優先されますが、ディスク上の内容は何も変更されません。規約が変更された場合は、トピックファイルを編集してください。
永続性フィルターに独自の判断基準があることを想定する。 キャプチャは「永続的なもの」を記録します。あなたが永続的だと思っても、モデルがそう判断しなかったものは、エラーを出すことなく単に表示されません。
シークレットを絶対に近づけない。また、除外設定をセキュリティ管理策として依存しない。 除外は書き込みポリシーであり、セキュリティ境界ではありません。
決定事項ごとに、ツールの外部に1つの書面による回答を保持する。 もしある事実を2つ目のアシスタントに再説明しなければならないのであれば、それは1つの製品のメモだけに留めておくべきではありません。
リポジトリのドキュメントを四半期ごとに読み直す。 メモリは設計上ドキュメントを優先するため、ドキュメントの陳腐化はメモリの陳腐化を意味します。
結論
Grok Buildのメモリ機能は、異例なほど誠実に説明された、真に有用な機能です。完了したすべてのターンの後にキャプチャし、Markdownのトピックファイルをプロジェクトスコープとグローバルスコープに保存し、関連する作業の前にそれらを読み込み、現在の会話がメモの内容を上書きできるようにします。
心に留めておくべき部分は、それがどこで停止するかを教えてくれる一文です。「タスクの状態、暫定的な結論、シークレット、およびリポジトリやそのドキュメントがすでにカバーしている内容は除外されます。」
xAIはメモリ問題を解決したと発表しているわけではなく、ここにある内容もそれを暗示していません。彼らは書き込みポリシーをリリースし、それを公開したのです。公開された書き込みポリシーに対して取るべき合理的な対応は、それを読み、その大部分に同意し、除外されたカテゴリをどこに置くかを決定することです。なぜなら、それらこそが最初に必要となるものであり、定義上、誰もあなたの代わりにそれらを書き留めてはくれないからです。