
実際に移行されるもの
Perplexity自身の定義がその範囲を示しています。「メモリ(パーソナル検索と呼ばれることもあります)は、Perplexityが会話間で詳細を記憶できるようにする機能であり、やり取りをよりパーソナライズされ、効率的なものにします。」
そして、参照する対象を2つの異なる要素に分割しています。1つ目は「メモリ(Memories)」であり、「将来的にPerplexityがより適切な回答を提供できるように、ユーザーが共有する好み、関心、情報」です。2つ目は「検索履歴(Search history)」であり、「一部のシナリオでは、最も関連性の高い回答を提供するために、過去の質問や回答などを参照することが役立ちます」とされています。
この分割は単なる見かけ上のものではなく、その結果ははっきりと述べられています。
「両方を究極的にコントロールできるように、権限は分離されています。メモリをオフにしてもメモリは消去されず、履歴内のスレッドを削除しても同様です。」
2つのトグル、2つのストレージがあり、どちらのスイッチを切り替えても中身は空になりません。メモリをオフにしてリセットされたと思い込み、再度オンにしたときにパーソナライズが復活して不思議に思ったことがあるなら、それはバグではなく、ドキュメントに明記されている通りの挙動です。
メモリがどのように構築されるかは、何を保持すべきかを判断する上でさらに重要です。Perplexityは、使用に伴って蓄積されるものとして説明しています。「Perplexityで質問をしたり、好みを指定したりすると、この情報を使用して重要なメモリを保存します。」そして、機密情報に関するセクションには、重要な補足があります。「メモリは、ユーザーが尋ねた質問や提供した情報の頻度を優先するモデルに基づいて生成されます。」
「頻度」です。「重要度」ではありません。3月に11回質問したことはしっかりと反映されますが、全体を規定する一度だけ述べた制約は、まったく記憶されていない可能性があります。これは、この移行を計画する上で最も役立つ事実であり、移行とは実質的に「監査(オーディット)」であることを示しています。
それでは、具体的な仕組みを一つずつ見ていきましょう。
メモリのリストは、自分で確認できるため移行可能です。 Perplexityのドキュメントによると、アカウントの「設定(Settings)」の「パーソナライズ(Personalize)」セクションにある「メモリの管理(Manage Memories)」から、保存されたメモリを表示および削除できます。ヘルプ記事には表示と削除について記載されていますが、ダウンロード可能なファイルについては記載されていません。そのため、エクスポートするのではなく、リストを読んで重要な内容を書き留める計画を立ててください。
検索履歴は、スレッドが存在する範囲でのみ移行されます。 ここに罠があります。Perplexityのドキュメントでは、一部のスレッドは一時的なものであり、期限切れになるとされています。「ログアウト状態のスレッドは、アカウントにサインインせずに作成されたスレッドです。これらの匿名スレッドは14日後に期限切れになり、復元できません。」また、「シークレット(Incognito)スレッドは、24時間後に期限切れになるプライベートな会話です。」Cometを使用している場合、その範囲はさらに広がります。「クエリに開いているタブ、閲覧履歴、またはエージェントのアクションのトリガーが含まれる場合、一時的なスレッドは常に期限切れになります。」
シークレットモードでの内容は一切保存されていません。 Perplexityは明確に述べています。「シークレットモードを使用している間、メモリと過去の検索は常にオフになり、シークレットモードで尋ねられた質問が保持されたり、メモリで使用されたりすることは一切ありません。」優れたプライバシー設計ですが、その方法で行った調査は、自分で保存したものの中にしか存在しないことを意味します。
引用のトレースは移行できません。 Perplexityはプロセスを示します。回答を得ると、参照されたメモリや過去の検索がソース(情報源)に表示されます。その出所はPerplexityの回答インターフェースの特性です。持ち運べるのは、文中にソース名を明記して書き留めた「結論」だけです。
次に、移行先についてです。ChatGPTのドキュメントに記載されているパーソナライズ機能は、Custom Instructions(カスタム指示)、メモリの要約、および従来の保存されたメモリシステムです。OpenAIは役割を次のように分割しています。「明示的な情報や指示については、Custom Instructionsに追加できます。会話を通じて共有された情報については、ChatGPTが関連する詳細を記憶できます。」従来のリストについては、タイミングが明示されています。「削除しない限り、保存されたメモリは将来の回答で常に考慮されます。」また、表示される要約は一部に過ぎないと警告しています。「メモリの要約は最も重要な詳細を捉えるはずですが、チャットに基づいてChatGPTが記憶しているすべてが含まれるわけではありません。」
つまり、双方に「可視化されたレイヤー」と「推測されたレイヤー」が存在します。可視化されている部分はきれいにマッピングできますが、推測された部分はどちらの方向にも一切移行されません。だからこそ、ここで「書き留めること」がすべての作業になるのです。
メモリ領域ではなくSpaces(スペース)を移動する場合は、形状の異なる別の資産となります。これについては、PerplexityのSpacesをChatGPTに移行する方法で解説しています。また、移行のきっかけがツールの切り替えではなく、制限に達したことである場合は、その制限自体についてPerplexityのメモリ制限に対する最適な解決策で解説しています。
手動での移行手順
ステップ 1:いずれの設定を変更する前にも、両方のストレージを確認する
「設定(Settings)」を開き、「パーソナライズ(Personalize)」に進み、「メモリの管理(Manage Memories)」を開きます。リスト全体に目を通してください。斜め読みは避けてください。これがインベントリ(目録)を確認できる唯一の機会です。Perplexityが「頻度によって構築された」と述べている通り、プロフィールを読むというよりは、検索ログを読むような感覚で確認してください。
確認しながら、すべてのエントリを以下の3つのバケツに分類します。
真実であり、重要(土台となるもの)。 あなたの専門分野、制約、実際に従っているルールなど。これらは移行対象です。
真実だが、些細なこと。 料理の好み、単発の比較、友人のために調べたことなど。これらは放置します。これらを新しいツールにコピーしてしまうと、初日から新しいメモリ領域が散らかってしまいます。
誤り、または期限切れ。 頻度重視のストレージには、これらが蓄積されがちです。離脱したプロジェクト、使わなくなったツール、2つ前の職種での好みなど。これらは、あなたが信頼していた回答にいつの間にか影響を与えていた可能性が最も高いため、注意深く確認してください。
次に、多くの人が見落としがちな2回目の確認を行います。ライブラリを調べて、重要だったスレッドから結論を回収(ハーベスト)します。Perplexityのスレッドには推論のプロセスが残されていますが、その一部には意図しない有効期限があります。削除を行う前にこれを実行してください。ライブラリからすべてのスレッドを削除する操作は、元に戻せないアクションとしてドキュメントに記載されています。
その際、2つ目の権限も確認してください。メモリの参照と検索履歴の参照は個別に切り替えることができ、一方をオフにしても他方は消去されません。
ステップ 2:ChatGPTが提供する2つのインターフェースで再構築し、検証する
常に適用される指示や、あなたに関する不変の事実は Custom Instructions(カスタム指示)に入力します。OpenAIはここを「明示的な情報や指示」のための場所と説明しています。簡潔にまとめてください。これはすべての回答に影響します。
状況に応じた事柄は、使用しながら入力していきます。これはOpenAIが説明するもう一方の仕組み(会話で共有され、記憶される詳細)です。つまり、再構築は「一度の貼り付け」では終わりません。1週間ほど通常通り使用する中で、重要なことを意図的に一度伝えるプロセスになります。
その後、検証を行います。リストを盲信するのではなく、OpenAIが推奨する方法を使用してください。ガイダンスは直接的です。「ChatGPTが何かを覚えているか知りたい場合は、チャットで直接聞いてみてください。」表示される要約はインベントリではありません。OpenAI自身も次のように述べています。「必ずしもそうとは限りません。ChatGPT's memoryは、過去のチャットからのコンテキストを継続的に更新・統合したものであり、要約に個別の項目として表示できる内容よりも広い場合があります。」このギャップが日常的に何を意味するかについては、ChatGPTのメモリ要約から除外されるもので解説しています。
スケジュールに関する注意点として、一時的なチャット(Temporary Chats)で再構築を行っても、何も保存されません。OpenAIのドキュメントによると、一時的なチャットは既存のメモリを使用せず、新しいメモリを作成することもありません。
より良い方法:頻度モデルに書き換えられない場所に、厳選したリストを保管する
あなたは今、価値があり、かつ少し骨の折れる作業を終えました。機械が生成した自分自身のプロフィールを読み、どの部分が真実かを判断したのです。その「判断」こそが資産です。しかし、それを現在使用しているストレージの中に放置しておくと、その資産は消えてしまいます。なぜなら、どちらのストレージも常に自動更新されるように設計されているからです。
ですから、厳選したバージョンを自分自身の場所に保管してください。生のリストではなく、あなたが修正したバージョンです。
それこそが MemoryLake の目的です。あなた自身の言葉で、それぞれが重要な理由を添えてエントリを書き込みます。接続されたすべてのAIアシスタントが同じデータセットを読み込みます。ベンダーのストレージから勝手に抽出されることはありません。そこにあるのは、あなたが自ら入れたものだけです。
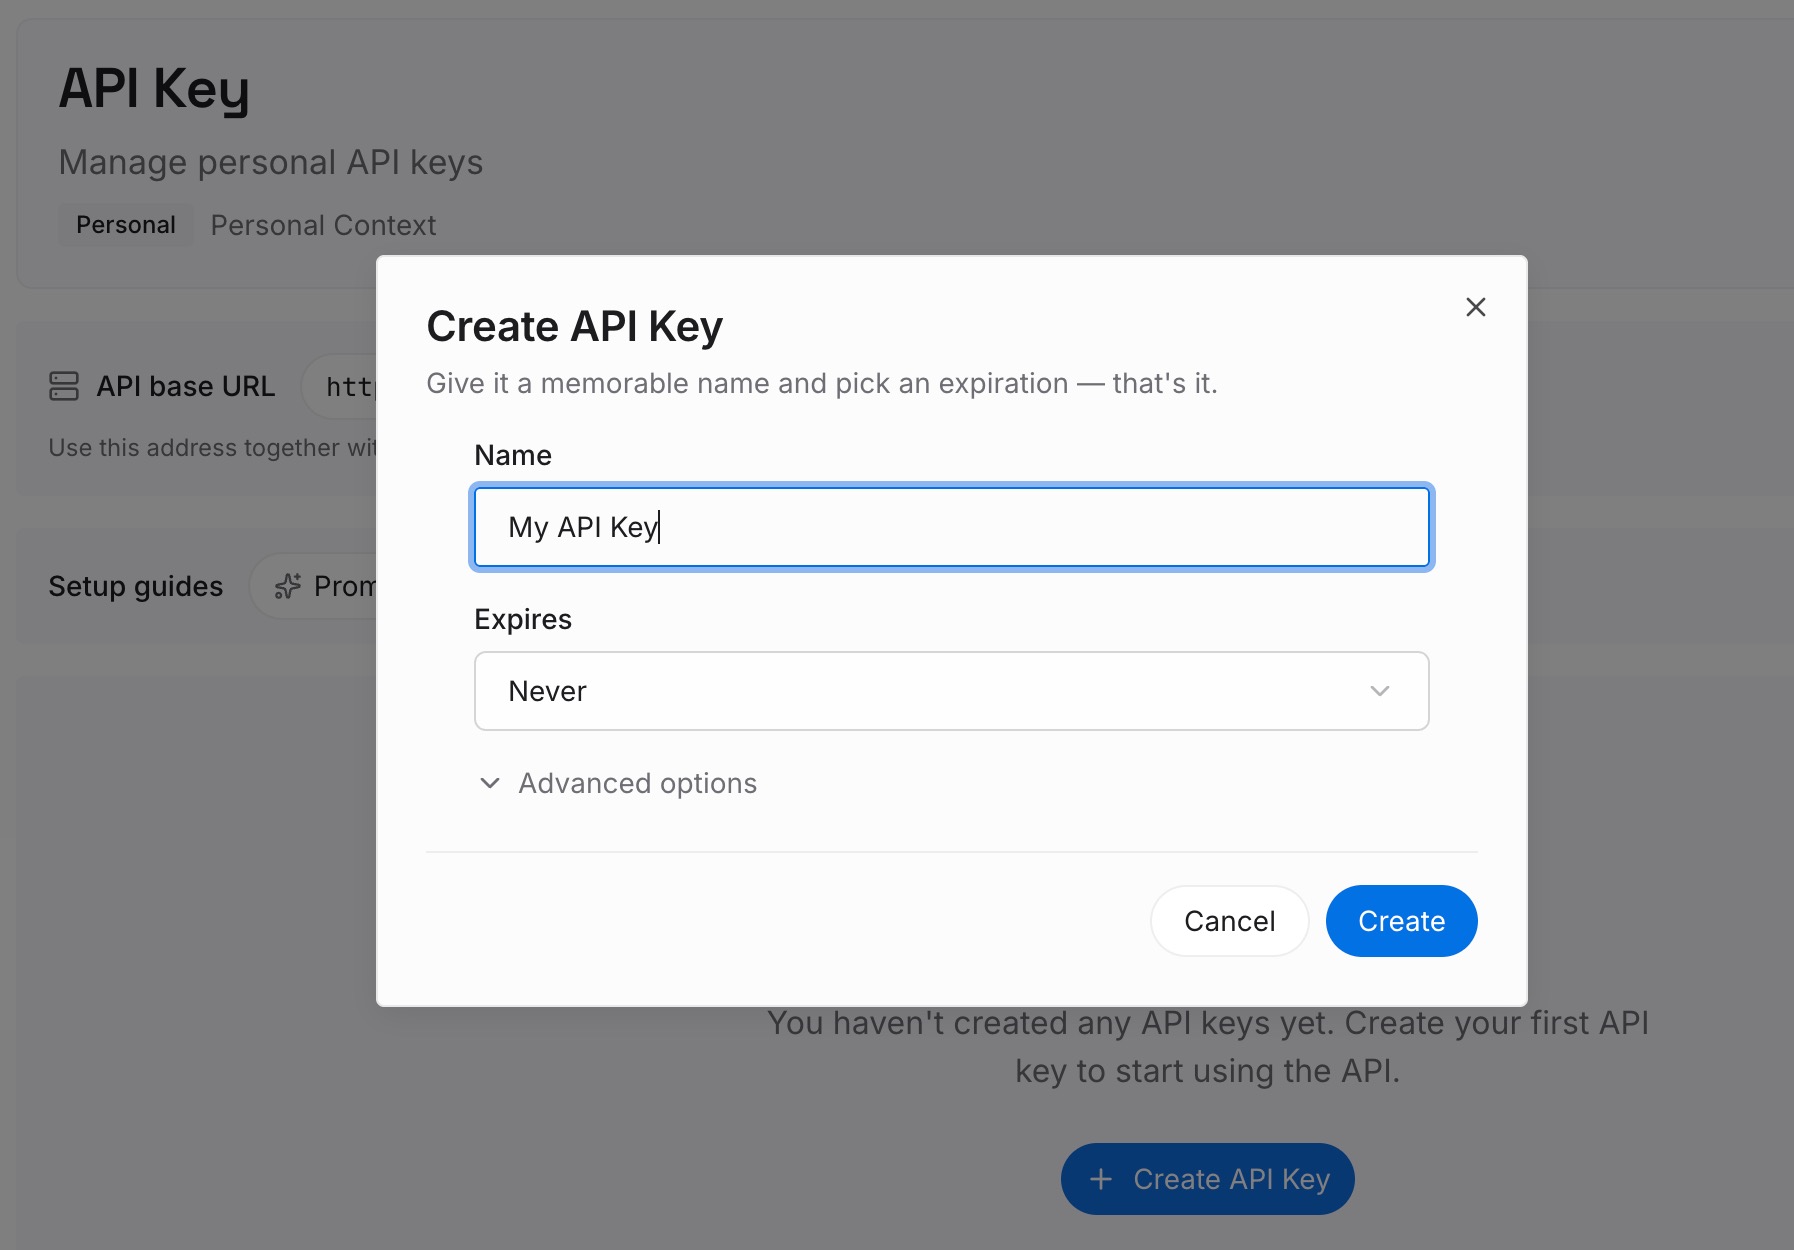
ステップ 1:APIキーを作成する
サインインし、ワークスペースの設定を開き、APIキーを生成します。これはアシスタントが同じレイヤーを読み取るために使用する認証情報です。一度作成すれば、調査に使用する各ツールからアクセスできるようにしておくだけです。
ステップ 2:最初のメモリをアップロードする
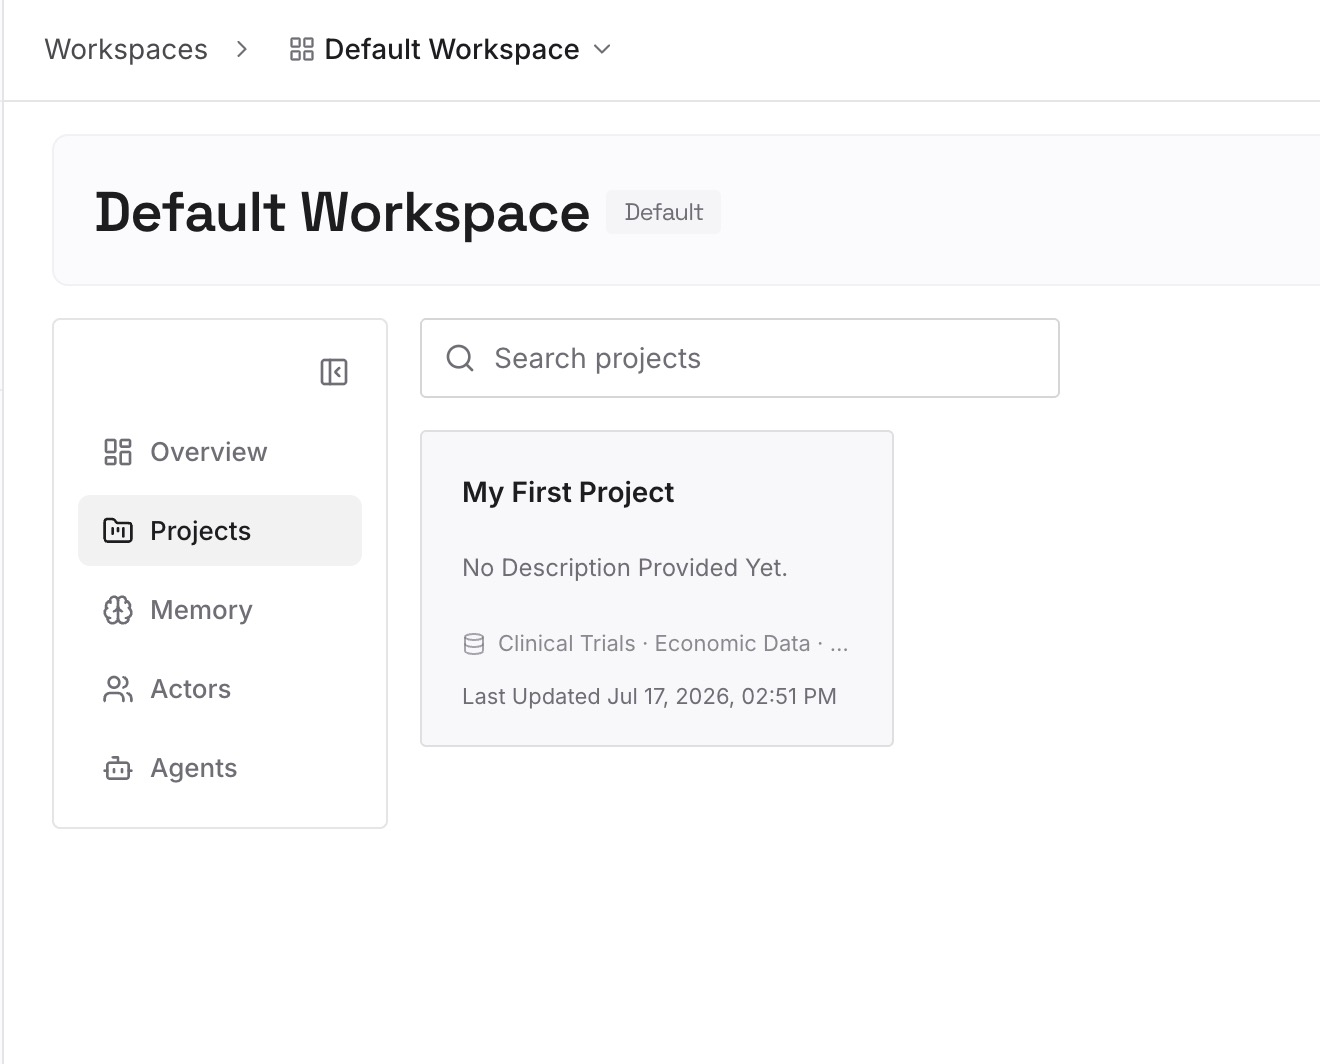
監査で分類した「重要(土台となるもの)」の山から始めます。テーマごとに1つのエントリを作成し、それぞれに理由を添付します。再発見するのにコストがかかる制約を追加してください。例えば、2つの情報源が対立したときにどちらを信頼するか、すでに解決済みの質問は何か、過去6ヶ月間の読書から実際に得られた結論は何か、などです。
ステップ 3:AIとエージェントを接続する
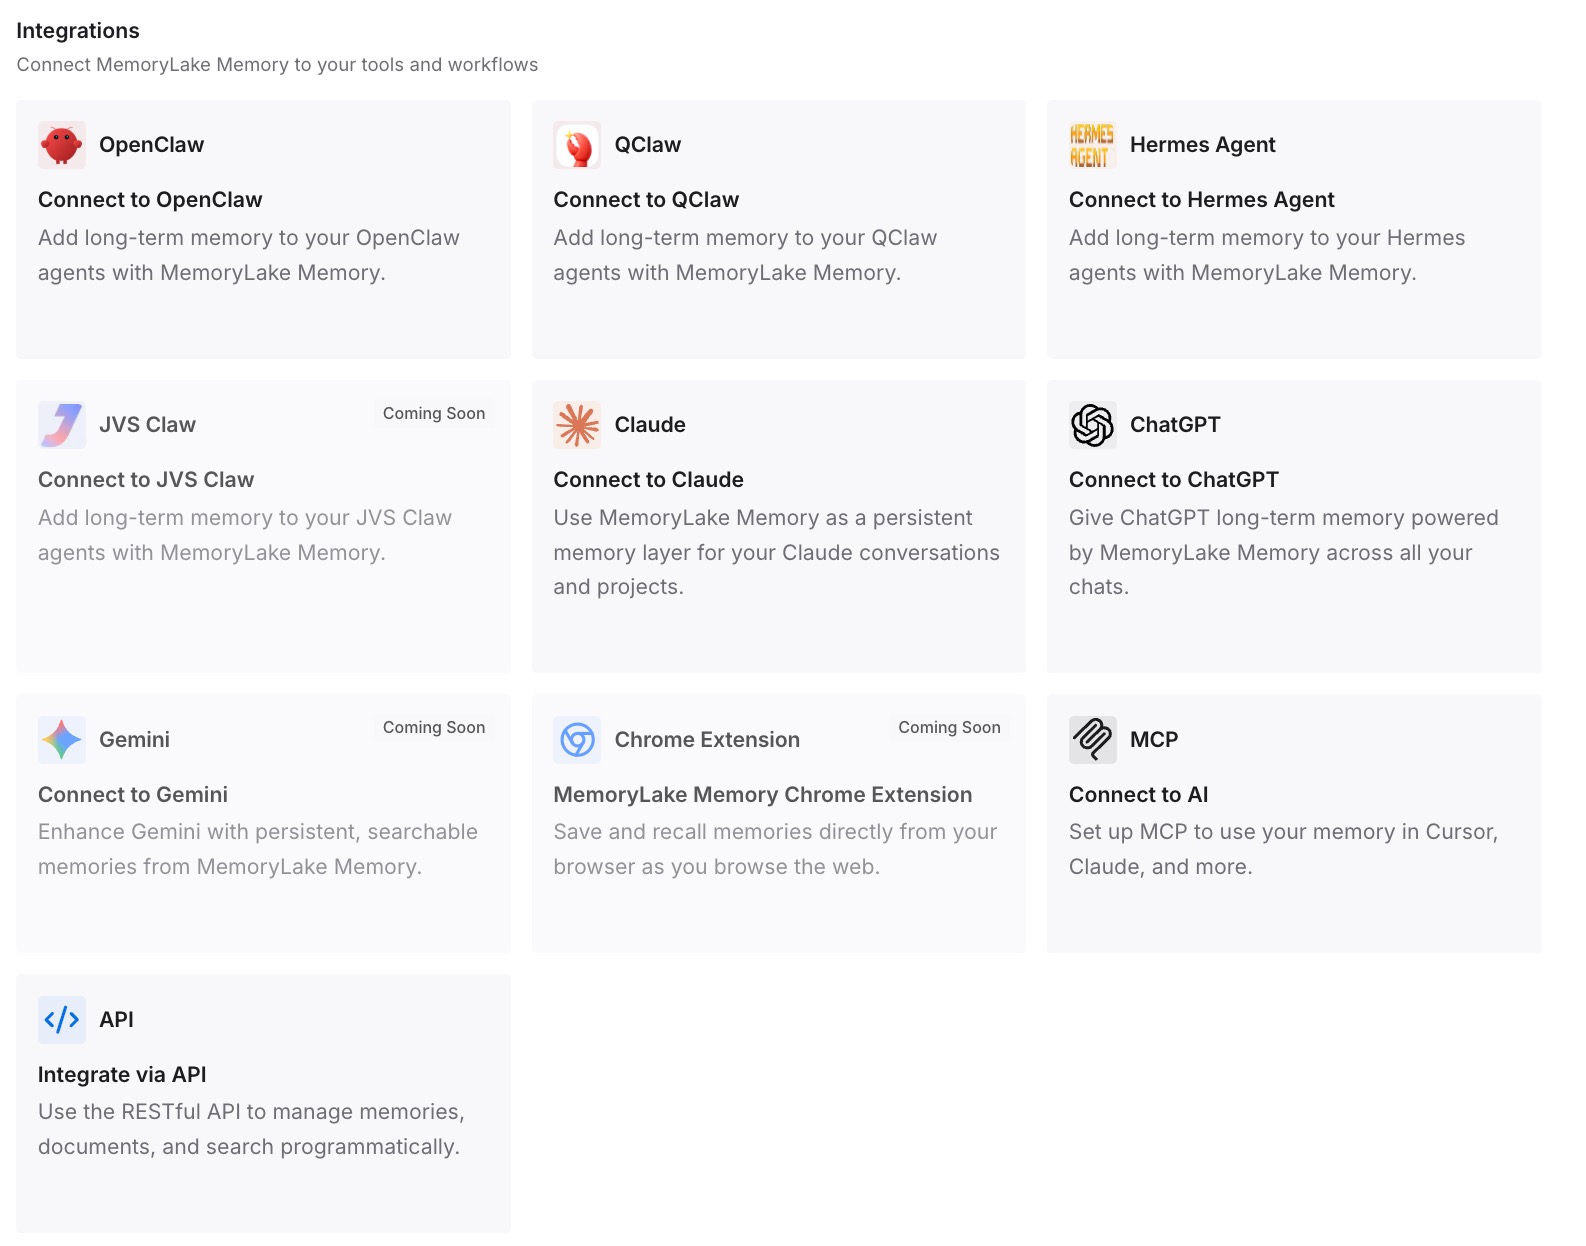
ChatGPTや、その他に使用しているツールを接続します。同じ厳選されたデータセットがそれぞれに届くため、新しいスレッドを開いた時点で、あなたが「最も頻繁に質問したこと」ではなく、「決定したこと」をすでに把握した状態からスタートできます。
実務における変化
第一の違いは、「頻度」によってあなたが定義されなくなることです。意図的に書いた記録は「あなたが意図したこと」を示しますが、反復から推測された記録は「あなたが質問したこと」を示します。これらは全く異なるものであり、ツール間で引き継ぐ価値があるのは前者だけです。
第二に、期限切れのスレッドが結論を道連れにすることがなくなります。一時的なスレッド、ログアウト状態のスレッド、シークレットモードはすべて合理的な機能ですが、意思決定を保管する場所ではありません。決定事項が別の場所に保管されていれば、スレッドの期限切れは「損失」ではなく、単なる「整理整頓」になります。
第三に、ツールの切り替えが一大イベントではなくなります。ChatGPTのメモリをPerplexityに移行する方法に記載されている逆方向の移行を行ったことがある人なら、毎回同じ作業が発生することを知っているはずです。厳選されたバージョンが双方の外部にあれば、この作業は一度だけで済みます。
第四に、調査自体の定着性が高まります。Perplexityが調査の文脈を忘れてしまうときにおける不満は、事実を忘れること自体よりも、次の質問をする前に「プロジェクトが何であるか」を再定義しなければならないことにあります。
メモリ領域を移行するためのベストプラクティス
コピーする前に監査する。 頻度重視のリストはログであり、プロフィールではありません。何を質問したかの証拠として読み、何が真実であるかは別途判断してください。
好みの隣に理由を書く。 「一次ソースを好む」は単なる設定です。「業界紙が2025年の規則変更を誤って伝え続けたため、一次ソースを好む」であれば、人間やアシスタントがそれに基づいて行動し、後から検証することができます。
削除する前にスレッドから回収する。 ライブラリからすべてのスレッドを削除する操作は元に戻せないとドキュメントに記載されており、一部のスレッドは削除しなくても自動的に期限切れになります。
片方だけでなく、両方の権限を確認する。 メモリの参照と検索履歴の参照は別々のトグルであり、Perplexityはメモリをオフにしてもメモリは消去されないと述べています。
機密情報は意図的に除外する。 Perplexityは、健康や財務に関する詳細などがメモリに保持される可能性を減らすための措置を講じており、メモリバンクを確認して消去できると述べています。これを保証ではなく最低限の対策と捉え、本当に機密性の高い情報は意図的にアシスタントのメモリに入れないようにしてください。
移行先のリストは不完全であることを想定する。 OpenAIは、要約にはすべてが含まれるわけではないと述べており、代わりにチャットで尋ねるよう案内しています。実務上の影響については、ChatGPTのメモリ制限で詳しく説明しています。
結論
Perplexityはこの機能を誠実に構築しました。ストレージを消去することなく参照を制御できるように権限を分離し、メモリは頻度を重視したモデルによって生成されることを開示し、どのスレッドがいつ期限切れになるかを公開しています。これほど多くの情報を自発的に提供するベンダーはほとんどありません。
それでも移行が困難なのは、移動する対象が「ドキュメント」ではないからです。それは、あなたがどれだけ頻繁に質問したかに基づいて構築された、機械によるあなたの印象(インプレッション)であり、静かに期限切れになるスレッドとともに、2つのスイッチを持つ2つのストレージに収められています。
ですから、監査を行い、修正されたバージョンを保持し、どちらのベンダーのモデルにも書き換えられない場所に保管してください。リストは次に使用するツールで再び生成されます。しかし、そのどの部分が真実であったかという「判断」は、あなたが書き留めておかない限り、どこにも残らないのです。