
実際に移行できるもの
Spaceは4つの要素で構成されており、移行先での扱いはそれぞれ大きく異なります。
スレッドは、1つずつドキュメントとして移行します。 スレッドを開き、共有またはその他のオプションメニューを使用して、PDF、Markdown、またはDOCXにエクスポートします。必要なのはMarkdownです。エクスポートには、プロンプト、回答、フォーマット、および後でリサーチを再利用するために最も重要なソースリスト付きの引用ブロックが含まれます。Space全体を一度にエクスポートする公式な方法はありません。Spaceを一括エクスポートしてNotionに送るブラウザ拡張機能も存在し、実際に動作しますが、Perplexityアカウントへのアクセス権限を許可する必要があるため、安易に行うのではなく慎重に判断すべきです。
アップロードされたファイルは移行されません(すでに手元にあるはずです)。 Spaceに添付したPDFやドキュメントは、まだローカルディスクにあるか、あるべきです。Perplexityからわざわざ取り出そうとするのではなく、それらをリポジトリに再アップロードするかコピーしてください。
カスタム指示(Custom instructions)は、ほぼそのまま移行できます。 Spaceの指示は、トーン、深さ、優先すべき事項についてのディレクティブとしてすでに書かれています。そのほとんどは、軽い編集でCLAUDE.mdにマッピングできます。引用スタイルや回答の長さに関する部分は、もはや回答を求めているのではなくコードを求めているため、通常は移行する必要はありません。
探索プロセスは移行されず、移行すべきでもありません。 40個のスレッドのうち30個は、正しい質問が何かを模索するためのものでした。それらの価値は、残りの10個を生み出すことにありました。40個すべてをエクスポートすると、Claude Codeに古い推論の山を渡すことになり、その一部は最終的な結論と矛盾し、すべてがコンテキスト(context)を圧迫することになります。移行が失敗するのは、情報を失うからではなく、持ち込みすぎるからです。
あらかじめ指摘しておくべき非対称性があります。Perplexityの記憶(memory)はスレッドを中心に整理されています。各会話は独立したコンテナであるため、Space内のコンテンツが他のスレッドに自動的に反映されることはありません。一方、Claude Codeの記憶(memory)はファイルシステムを中心に整理されており、プロジェクト内にあるものを読み込みます。単にツール間でテキストを移動するだけでなく、会話形式の知識をファイル形式の知識に変換しているのです。以下で説明するのは、すべてその変換プロセスです。
手動での移行手順
ステップ 1: 重要なスレッドのみをエクスポートする
エクスポートする前に、Space内を整理(トリアージ)します。各スレッドについて、「これは自分が支持する結論を含んでいるか、それともすでに完了した検索プロセスか?」という1つの質問を投げかけてください。前者の場合はエクスポートし、後者の場合はスキップします。
具体的には、決定事項を確立したスレッド(「ライセンスの関係でこのライブラリを使用する」など)、後で再度引用したい比較証拠を収集したスレッド、開発を制約するドメインの事実(レート制限、フォーマット、規制要件など)を含むスレッド、および、何かを間違えてその理由を突き止めたスレッドを残します。最後のカテゴリは最も価値があり、最も捨てられがちです。
残すスレッドごとに、スレッドを開き、共有またはその他のオプションメニューからMarkdownを選択します。プロンプト、回答、フォーマット、およびソースリスト付きの引用ブロックが取得できます。引用は残しておいてください。リサーチをやり直すのではなく移行する最大の理由は、ソース情報が一緒に付いてくるからです。
Spaceに数十個の残すべきスレッドがある場合、サードパーティの一括エクスポートツールの出番です。ただし、慎重に検討してください。それらのツールはアカウントへのアクセスを必要とし、ブラウザ拡張機能にPerplexityアカウント内のすべてを読み取る権限を与えることになります。個人のリサーチSpaceであれば問題ないかもしれませんが、クライアントのNDA(秘密保持契約)下にあるものの場合は、手動でスレッドをエクスポートし、余計な心配をしないようにしましょう。
一括エクスポートが存在するからといって、トリアージをスキップしないでください。トリアージの目的はエクスポートの手間を省くことではなく、持ち込んだものすべてが後でClaude Codeの注意力を奪い合うのを防ぐことにあります。
ステップ 2: エクスポートしたファイルをClaude Codeが実際に読み込める形式に変換する
生のスレッドエクスポートは、プロジェクトドキュメントとしてそのままでは役に立ちません。スレッドは対話の記録(トランスクリプト)です。不完全な質問、長い回答、それを修正するフォローアップ、および別の回答。Claude Codeはこれらをすべて読み込み、間違った部分を重視してしまう可能性があります。
そのため、凝縮(コンデンス)します。関連するスレッドのクラスターごとに、リポジトリ内(docs/research/などが適しています)に以下のような構成のMarkdownファイルを1つ作成します。
- 結論を最初に、プロジェクトに関する事実として1〜2文で記述します。
- 除外したものがあれば記述します。「Xを評価したが、Yの理由で却下した」と書いておくことで、AIエージェントが3週間後に悪気なくXを再提案するのを防げます。
- 証拠を凝縮し、エクスポートした引用ブロックのソースリンクを添えます。
- 日付と、それを取得したツールを記載します。リサーチは古くなるため、日付入りのファイルにすることで判断が可能になります。
次に、Claude Codeにそれを認識させます。プロジェクトのルートにあるCLAUDE.mdは、起動時に自動的に読み込まれるファイルです。ここにはコンテンツそのものではなく、ポインタ(参照先)を記述します。
## Research context
Decisions and their evidence live in `docs/research/`. Read
`docs/research/auth-approach.md` before touching anything under `src/auth/`.
Do not re-open decisions recorded there without flagging it.リサーチ内容をインラインでそのまま流し込むよりも、この方法が優れている理由は2つあります。第一に、CLAUDE.mdはすべてのセッションで読み込まれるため、ポインタとルールだけに留めておけばタスクあたりのコストはほぼゼロですが、4,000語のリサーチ内容をそのまま載せると、すべてのリクエストでコスト(トークン)が発生します。第二に、@pathインポートを使用すれば、常にではなく、実際に必要なときだけ特定のファイルを取り込むことができます。
個人の好みはプロジェクトファイルではなく~/.claude/CLAUDE.mdに記述し、プロジェクト用のファイルはコミットしてチーム全体で同じコンテキスト(context)を共有できるようにします。Claude Codeに最初のバージョンを起草させたい場合は、/initでリポジトリからスケルトンを作成し、/memoryでメモリファイルを直接編集できます。
そして、期待値を正しく設定してください。これにより知識が利用可能になりますが、記憶されるわけではありません。Claude Codeは依然として各セッションを新鮮な状態で開始し、長いセッションではコンテキストを圧縮するため、適切なファイルが配置されていてもセッション間でプロジェクトのコンテキストを忘れてしまいます。ファイルは最低限の土台であり、万能の解決策ではありません。
より良い方法:リサーチとコードを統合する単一のメモリレイヤー
ステップ2で実際に行ったことを見てみましょう。あるツールのフォーマットから別のツールのフォーマットへ手動でリサーチ内容を変換し、その結果を2番目のツールしか読み取れない場所に保存しました。
ここで、これからの6ヶ月間を想像してみてください。あなたは再びPerplexity(またはそれに代わるツール)でリサーチを行い、Claude CodeやCodex、あるいは新しく発表されるツールで開発を行うでしょう。その組み合わせごとに、毎回変換作業が必要になります。知識は不変ですが、それを取り巻くツールは変化します。
両方のツールからアクセスできるレイヤーに知識を保持しておけば、この変換ステップは不要になります。MemoryLakeは、ツールの下に位置するメモリ(memory)レイヤーです。リサーチノート、決定事項、ソースドキュメントを一度登録すれば、Claude CodeはMCP経由でそれらを読み込み、他のツールはAPIを介して同じストアを読み込むことができます。リサーチ内容は、移行が必要な「Perplexityの遺物」ではなく、ツールがクエリを送信して利用する対象になります。
トレードオフを公平に評価すると、docs/とCLAUDE.mdの組み合わせには確かなメリットがあります。プレーンテキストであり、バージョン管理下に置かれ、プルリクエストでレビューでき、セットアップなしで動作します。コードベースに直接属するものについては、この方法を維持してください。一方、メモリレイヤーが真価を発揮するのは、リポジトリの形に収まらない知識(プロジェクト横断的なリサーチ、クライアントのコンテキスト、3つのリポジトリにまたがる決定事項など)を扱う場合や、まだ選定していない将来のツールからその知識を読み取れるようにする場合です。
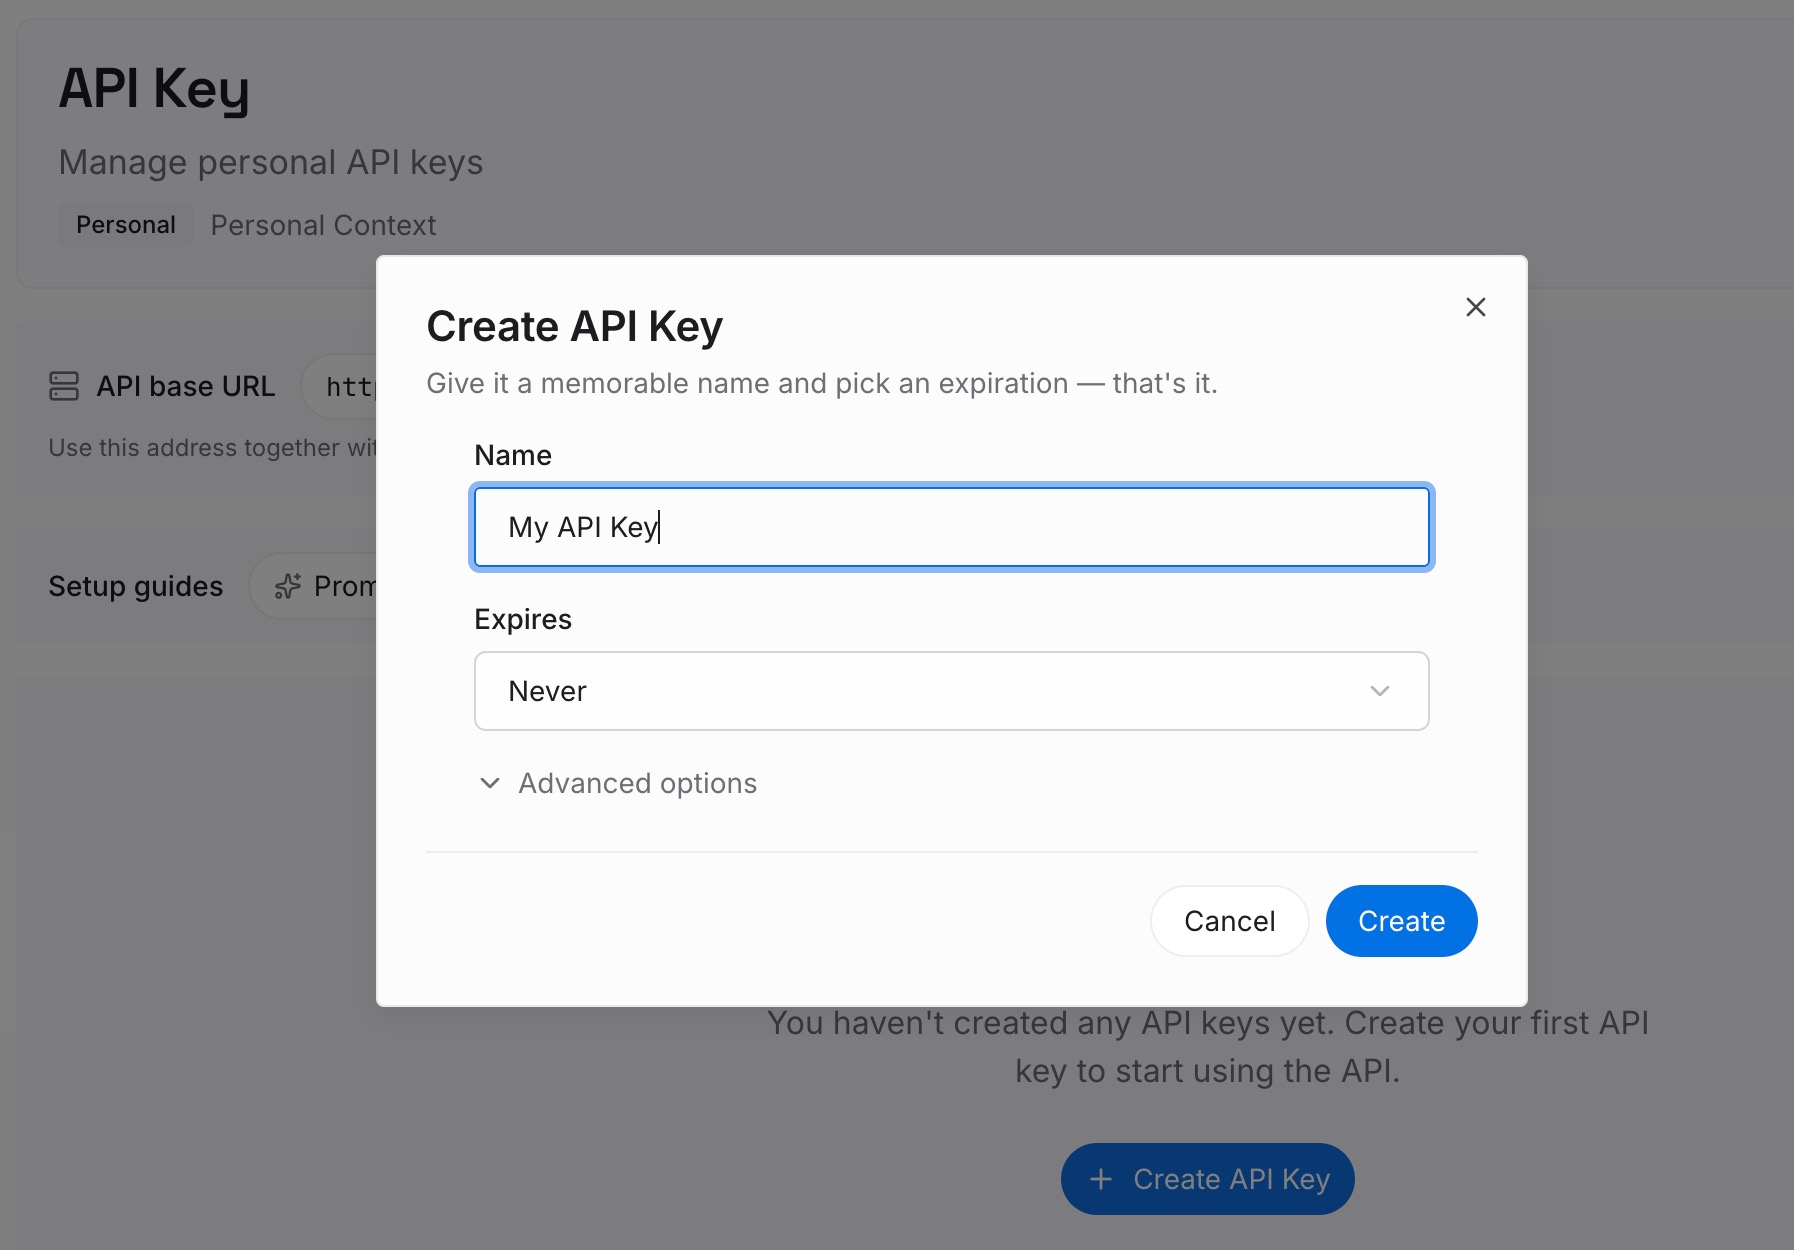
ステップ 1: APIキーを作成する
キーを生成すれば、約30秒で最初のリクエストを実行できます。キーは環境変数やシークレットマネージャーに保存し、コミットや同期の対象となる設定ファイル内にインラインで記述しないようにしてください。
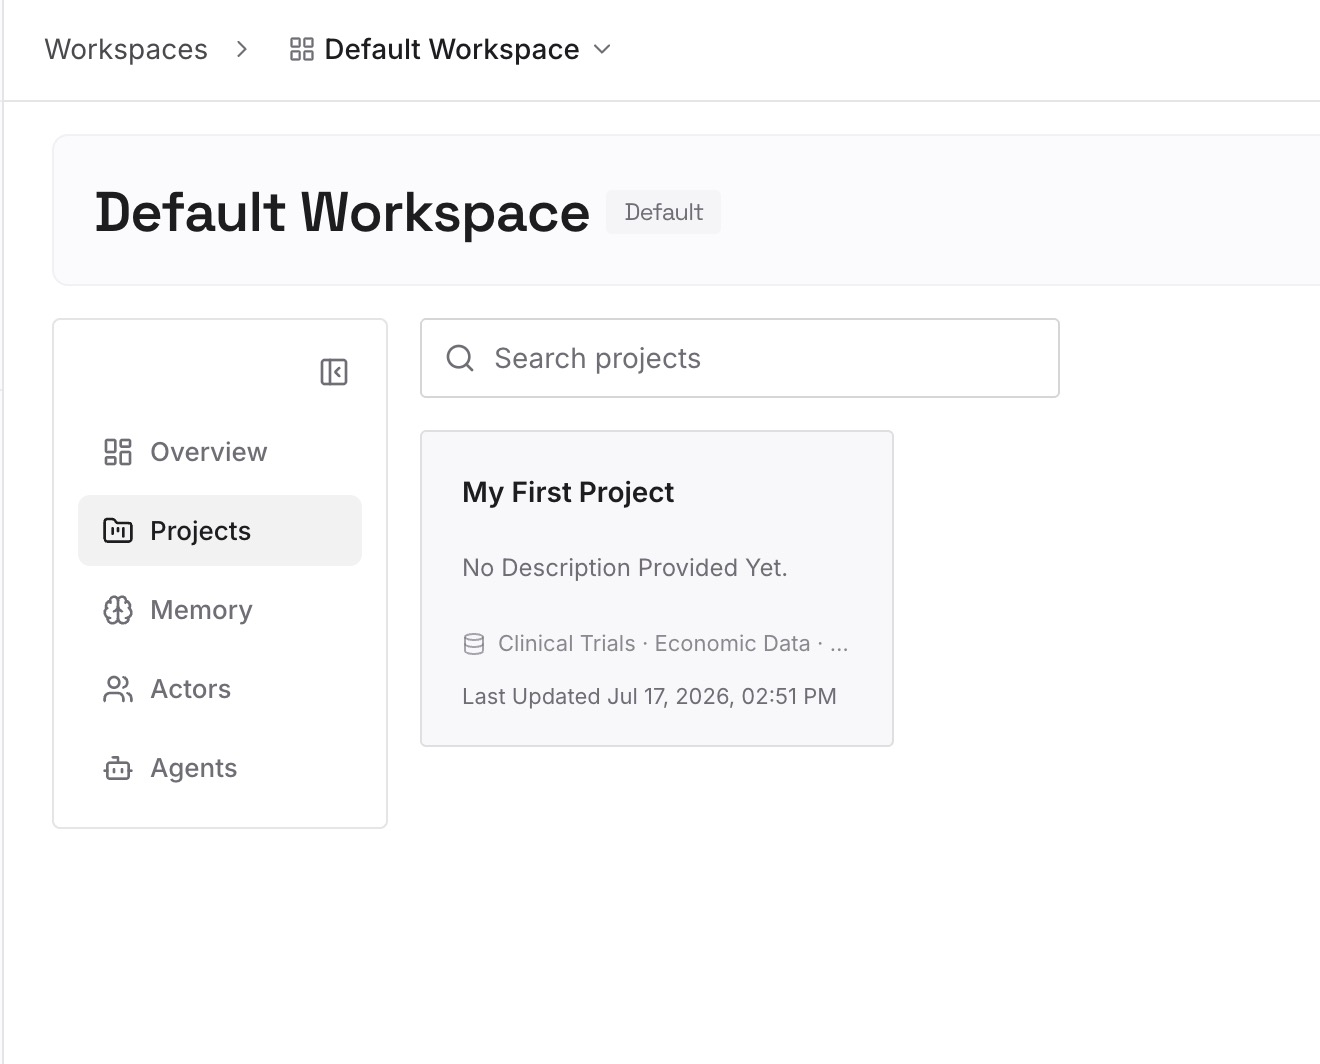
ステップ 2: 最初のメモリをアップロードする
リサーチの土台となっているドキュメント、画像、ファイルを投入します。エクスポートしたスレッド、SpaceにアップロードしていたPDF、決定事項ドキュメントなどです。要約だけでなく、可能な限りソース自体をアップロードしてください。要約にしてしまうと、重要だったはずの但し書きや前提条件が消えてしまいがちです。
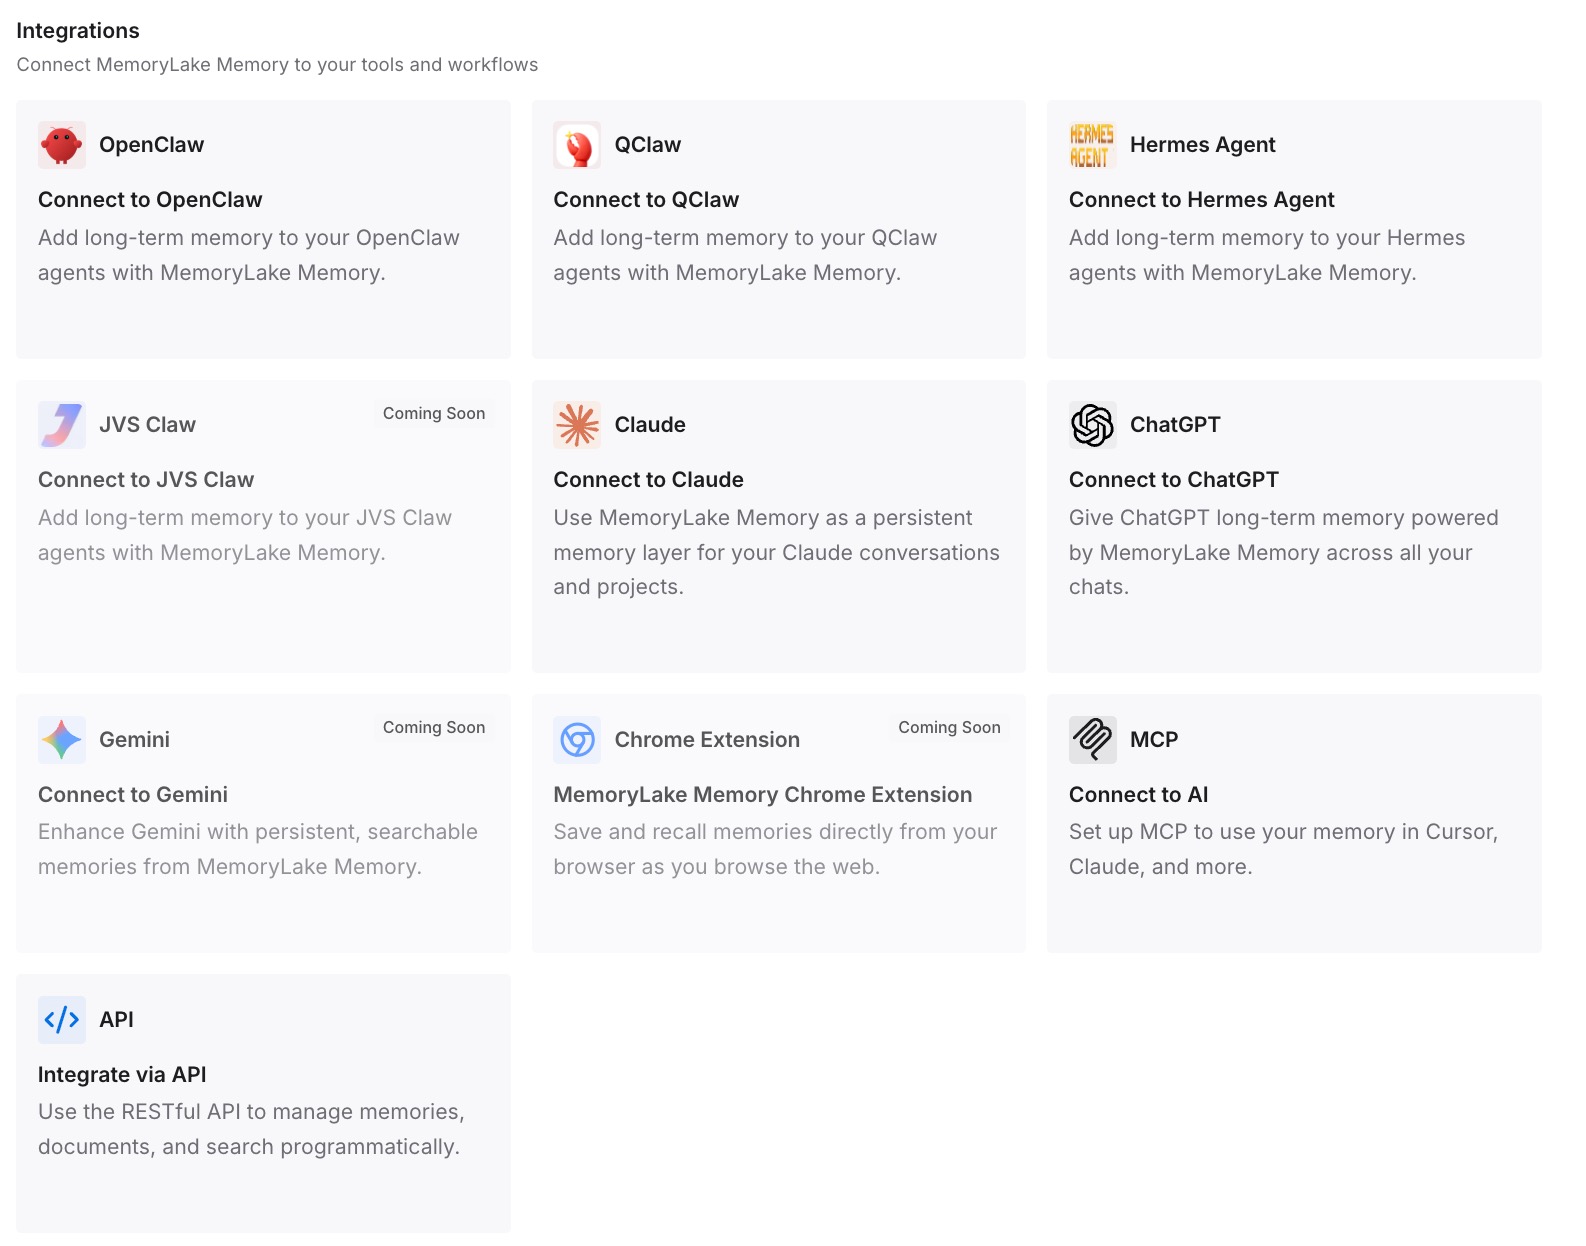
ステップ 3: AIとエージェントを接続する
Claude、Codex、OpenClaw、その他のAIエージェントに、MCPまたはAPI経由でメモリへのアクセス権を与えます。Claude CodeはMCPサーバーをサポートしているため、コードを書き換えることなく設定を追加するだけで対応できます。MCPクライアントを持たないリサーチツール(Perplexityなど)の場合は、API経由で必要な情報を取得し、プロンプトやワークフローに注入することで、双方向の連携が可能になります。
実務における変化
最初の変化は、「認証について何を決めたっけ?」という疑問に対し、コードを書いているそのツール内で、ソースが添付された回答が得られるようになることです。別の製品のスレッドへのリンクをわざわざ読みに行く必要はありません。
第二に、却下された選択肢が却下されたまま維持されることです。リサーチから開発への引き継ぎ後に最もよくある失敗は、あなたが1週間かけて除外したライブラリを、エージェントが自信満々に提案してくることです。なぜなら、除外した経緯はPerplexityのスレッドにあり、コードはここにあるからです。決定事項とその理由がストアに保存されていれば、このようなことは起こらなくなります。
第三に、多くの人が予想しない方向、つまり逆方向にも機能することです。実装の決定事項が同じレイヤーにあれば、次のリサーチフェーズは、あなたが覚えている記憶からではなく、コードベースが実際に何を行っているかという事実から開始できます。
そして実用面では、次のツールの切り替えにも耐えられます。Cursorに移行するにせよ、チャット製品に戻るにせよ、知識は一箇所にあり、ツールは単なるクライアントになります。
移行のベストプラクティス
インポートする前に凝縮する(後回しにしない)
すべてを移行してエージェントに整理させようとしがちですが、エージェントはそれをうまく処理できません。エクスポートされたデータにはどれが最終決定かを示すマークがないため、古い回答も最終的な回答と同じ重みで扱われてしまいます。40個の対話記録よりも、適切に書かれた10個の結論ドキュメントの方がはるかに優れています。また、実際に書き出すことで、自分が本当に支持できない結論に気づくことができます。
引用(citations)を残す
リサーチをやり直すよりも移行する方が優れている理由は、ソース情報が一緒に付いてくるからです。整理のためにエクスポートから引用ブロックを削除してしまうと、主張だけが残り、証拠が失われます。その結果、誰かに指摘されたときに、また検索ボックスに戻る羽目になります。Markdownエクスポートにはソースリストが含まれています。そのまま残しておきましょう。
すべてに日付を入れ、古い情報を明示する
変化の激しいAPIに関するリサーチは、ある一時点のスナップショットにすぎません。ファイルに日付を入れ、何かが変更されたことを知ったときは、新しいドキュメントを横に追加するのではなく、既存のファイルを編集してください。日付のない矛盾する2つのドキュメントは、日付が明記された1つのドキュメントよりもはるかに厄介です。
指示(instructions)と知識(knowledge)を分ける
CLAUDE.mdは、毎セッション読み込まれるルールとポインタのためのものであり、短く保つべきです。リサーチ内容は知識であり、長く、たまにしか関連せず、常に読み込むにはコストがかかります。これらを混ぜてしまうと、リクエストごとにコストがかかる肥大化したファイルになり、それでもすべてを収めることはできなくなります。
結論
Perplexityは、PDF、Markdown、またはDOCX形式で一度に1つのスレッドしかエクスポートできず、公式なSpaceの一括エクスポートはありません。また、Claude Codeにはインポーターがありません。そのため、確実なアプローチは手動で簡潔に行うことです。Spaceを整理して検索プロセスではなく結論を残し、それらを引用付きのMarkdownとしてエクスポートし、各クラスターを決定事項から始まる日付入りのドキュメントに凝縮し、インラインで貼り付けるのではなくCLAUDE.mdからそのフォルダを参照させます。
慎重に判断すべきなのは、その知識をその後にどこに置くかです。リポジトリ内に置けば、そのツールにおけるそのプロジェクトに役立ちます。両方のツールが読み取れるメモリ(memory)レイヤーに置けば、次のプロジェクトや次のツールでも役立ちます。これは思った以上に重要なことです。なぜなら、リサーチには1週間かかったかもしれませんが、ツールの選択はリサーチ内容が古くなる前に変わる可能性があるからです。