
OpenAIが実際に公開した内容
まずはHabitatとは何か、そして誰がそこからデータを読み取るのかから始めましょう。OpenAIはこれを「OpenAI製品が必要な情報に迅速かつ確実にアクセスできるように構築したオンラインストレージプラットフォーム」と説明し、それが処理するリクエストの種類を挙げることから始めています。「ログイン、Codexの設定確認、ChatGPTでの新しい会話の開始など、すべてのOpenAI製品はデータへの高速で信頼性の高いアクセスに依存しています。これらのアクションのそれぞれにおいて、製品が応答を返す前に、多くの個別のデータルックアップが必要になる場合があります。」
その規模は率直に示されています。Habitatは「現在、毎秒7,000万回以上のリクエストを処理しており、ほぼ40の地理的地域にわたって、毎週10億人以上の人々が使用する製品を支えています」そして「今日では、500ペタバイト以上のデータを提供する複雑な分散システムとなっています。」
そして、ここで重要となる設計上の決定が登場します。OpenAIはこれを制限ではなく、決定として位置づけています。
「クライアントが大規模なテーブルスキャンや多数のテーブルにわたる結合を引き起こす可能性のある任意のSQLクエリを構築できるようにするのではなく、HabitatはシンプルなNoSQL APIを公開しています。強力なAPIの欠如は、Habitatの設計における明示的なトレードオフです。」
その理由は予測可能性にあります。「私たちは、シンプルで予測可能、かつ一定の作業量で済むリクエスト向けに最適化することを目指しています。私たちの経験では、このようなシステムはスケールさせるのが大幅に容易であり、誤りや誤用が発生しにくいです。予測不可能なファンアウトを伴うリクエストは、運用上危険です。それらは分離やロードバランシングを複雑にし、サービスとクライアントの両方にとってスケールが困難なレイテンシの急増(レイテンシクリフ)を引き起こします。」
データモデルはそれに従っています。「Habitatは、TAOにインスパイアされた、クライアント定義のオブジェクトおよびエッジタイプを中心にモデル化されたNoSQL APIを公開しています。クライアントはオブジェクトとエッジ、およびそれらがどのように関連しているかを事前定義しますが、各タイプのコンテンツは定義しません。」OpenAIがここでインスピレーションの源を挙げていることは注目に値します。これは十分に実績のあるパターンであり、手抜きのために発明されたものではありません。
And then the sentence the coverage skipped:
「私たちは、各オブジェクトとそれに対応するエッジがストレージレベルのパーティションにコロケーション(同地配置)されるようにこのグラフをパーティション分割していますが、オブジェクトと、そのエッジが指し示すリモートオブジェクトをコロケーションさせるためのデータベースレベルの協調的な取り組みは行っていません。その結果、モデルは水平方向のスケーラビリティのために容易にパーティション分割されますが、オブジェクト間の特定のホップが、異なる地域に保存されている2つのまったく異なるAzure Cosmos DBアカウントからの取得を必要とする可能性があるため、グラフのトラバーサルは非効率になります。」
これを2回読んでみてください。オブジェクトとその直接のエッジは一緒に配置されます。しかし、それらのエッジが指し示すものは、世界の反対側に配置されている可能性があります。OpenAIはこの境界を明示的に付け加えています。「結果として生じる関係はグラフに似ていますが、Habitat自体は、特定のオブジェクトの直接のエッジをクエリすること以外、典型的なグラフ走査(トラバーサル)クエリをサポートしていません。」
これより複雑なものはすべて、ライブパスから完全に除外されます。「より複雑なクエリのニーズを持つクライアントのために、私たちはRocksetを介して公開されるHabitatのオフラインセカンダリビューを提供しています。」変更は変更データキャプチャ(CDC)によってストリーミングされ、各チームが独自のインスタンスを実行します。OpenAIはその理由を明確にしています。「この設計により、オンラインストレージを読み取り負荷の高い分析および検索ワークロードから隔離しています。」
これが変えること、変えないこと
今日のChatGPTの動作については何も変わりません。これはインフラストラクチャレイヤーに関するエンジニアリングの投稿であり、製品の発表ではないため、OpenAIもそれ以外の主張はしていません。
また、特定の機能のデータがどこにあるかを教えてくれるわけでもありません。この投稿では、HabitatのクライアントとしてChatGPT、API、Codex、および内部サービスを挙げており、リクエストの例として「ChatGPTで新しい会話を開始する」を挙げています。製品機能のスキーマは公開されておらず、この記事でそれを捏造するつもりもありません。
これが変えるのは、私たちができる推測の質です。この投稿の前は、「なぜ私のアシスタントは個々の事実は覚えているのに、それらを決して結びつけられないのか」というのは単なる推測に過ぎませんでした。今や、それらを結びつけることがストレージレイヤーにおいて高コストな操作であるという、文書化されたアーキテクチャ上の理由が存在します。これは、それを構築した人々によって述べられています。直接のエッジを持つ単一オブジェクトのルックアップは安価で一定の作業量で済むケースであり、オブジェクト間のホップは地域をまたぐ可能性のあるケースなのです。
これは「AIのメモリが悪い」という主張とは異なり、より有用なものです。ロングコンテキストがメモリではない理由で説明されているギャップは、通常、モデルの問題として捉えられます。しかし、ここには、ベンダーが自社システムについて公開した、ストレージ層という1つ下のレイヤーにおける同じ構図があります。
もう1つ、覚えておく価値のある一文があります。なぜなら、設計哲学全体を簡潔に説明しているからです。「平均的なユーザーリクエストが数百回のデータベース呼び出しを引き起こす場合、ユーザーが体感するのは最も遅いデータベース呼び出しである。」
人々が誤解しがちなこと
OpenAIがストレージで手抜きをしたという誤解。 投稿では、理由を挙げて詳細にその逆を主張しています。APIを制限することこそが、この規模のシステムを予測可能にするものです。OpenAIは制限のないクエリを「運用上危険」と呼び、コストの不均衡を直接説明しています。「実行するのが高コストで困難なSQLクエリを、安価かつ容易に作成できてしまう。」10億人のためのデータベースをダウンさせるようなクエリを製品チームに書かせないプラットフォームこそが、その役割を果たしているプラットフォームです。
これがOpenAIに固有のものであるという誤解。 そうではありません。OpenAIはインスピレーションとしてTAOを挙げていますが、これは異なる規模の別の会社から公開された設計であり、それが内包するトレードオフ(オブジェクトをそのエッジとコロケーションさせ、リモートホップが高コストであることを受け入れる)は、グラフ型のストアを水平方向にパーティション分割するための標準的な方法です。非常に大規模なオンラインデータストアを運用している人なら誰でも、同じ計算に直面します。
オフラインコピーが解決してくれるという誤解。 Habitatの脱出ハッチは本物ですが、OpenAIはそれにコストがかかることを率率直に認めています。「このRocksetのプロビジョニングは、クライアントに余分な摩擦をもたらします」そして、各チームは「独自のRocksetインスタンスのスケーリングに責任を負います。」これは、所有者と予算が存在する内部のエンジニアリングオプションです。ユーザー向けの機能ではなく、投稿のどこにもそうであるとは示唆されていません。
解決策はより長いコンテキストウィンドウであるという誤解。 トラバーサルコストとコンテキスト長は別の問題です。ウィンドウが大きくなると、1回のリクエストでモデルに表示できる量が変わりますが、ストレージレイヤーがどのルックアップを安価として扱うかは変わりません。この混乱の検索(リトリーバル)版については、RAGがメモリではない理由で説明されています。ドキュメントを見つけることと、結論を保持することは同じではありません。
解決策:接続を専門とする場所に接続を保存する
単一オブジェクトのルックアップがどこでも安価なケースであるならば、永続的な対策は、オンデマンドで接続が導き出されることを期待するのをやめ、接続自体を独自のオブジェクトとして書き留め始めることです。
ステップ 1:事実とそれらの間の関係を分離する
アシスタントが知っていることに実際に依存している内容を確認し、2つの山に分類します。
最初の山は「事実」です。「私たちは1日単位で請求します。」「ステージングデータベースはフランクフルトにあります。」「Priyaが決済連携を担当しています。」これらはそれぞれ独立しており、どのシステムにとっても取得コストが低いものです。
2番目の山は「関係性」であり、ここに価値が隠されています。「財務システムが端数を拒否するため、私たちは1日単位で請求します。」「2025年の契約におけるデータローカリティ条項のため、ステージングはフランクフルトにあります。」「組織再編以来、Priyaが決済を担当しているため、古いランブックには別の人の名前が記載されています。」
2番目の山は、その時点ではどちらの半分も明白に感じられるため、誰も書き留めない山です。また、再構築に最もコストがかかる山であり、一定作業量の単一ルックアップに最適化されたストアが、あなたのために再構成するのが最も苦手とする山でもあります。
ステップ 2:関係性を2つのエントリと期待ではなく、1つの文章として書く
1つの文章として書かれた関係性は、単一のオブジェクトです。2つのエントリ間で暗黙のままにされた関係性はトラバーサル(走査)であり、トラバーサルが高コストな経路である理由についてのベンダーの説明を読んだばかりです。
したがって、「2025年の居住性条項のため、フランクフルト」を1つのレコードとして書き、何かが結合してくれることを期待して場所のレコードと契約のレコードを別々に書くのはやめましょう。これは小さな規律ですが、大きな見返りがあります。これは優れたコミットメッセージを作成するのと同じ直感です。差分(diff)が事実であり、メッセージが関係性です。
2つのレコードが本当に矛盾している場合は、矛盾が発見されるのを待つのではなく、レコード自体にその旨を記載してください。誰もそれをしない場合の失敗モードについては、メモリ競合の検出で説明されています。
ステップ 3:すべてのアシスタントがアクセスできる1つのアドレスをそのレイヤーに与える
ある製品のメモリに書き込んだ関係性は、次の製品からは見えません。ツールを移行したり、3つのツールを同時に使用したりする際に、関係性を最初から書き直す必要がないよう、このレイヤーを特定のベンダーのストアの外に維持してください。この問題の実践的な解決策は、ChatGPT、Claude、Geminiにまたがる1つのメモリで詳しく説明されています。
MemoryLakeでの設定方法
MemoryLakeは、2番目の山のために構築されています。決定事項とその背後にある理由を、あなた自身の言葉で直接書き込み、接続されたすべてのアシスタントが同じセットを読み取ります。ベンダーのストアから引き出されるものは何もありません。このレイヤーは、あなたが入力したものを保持します。
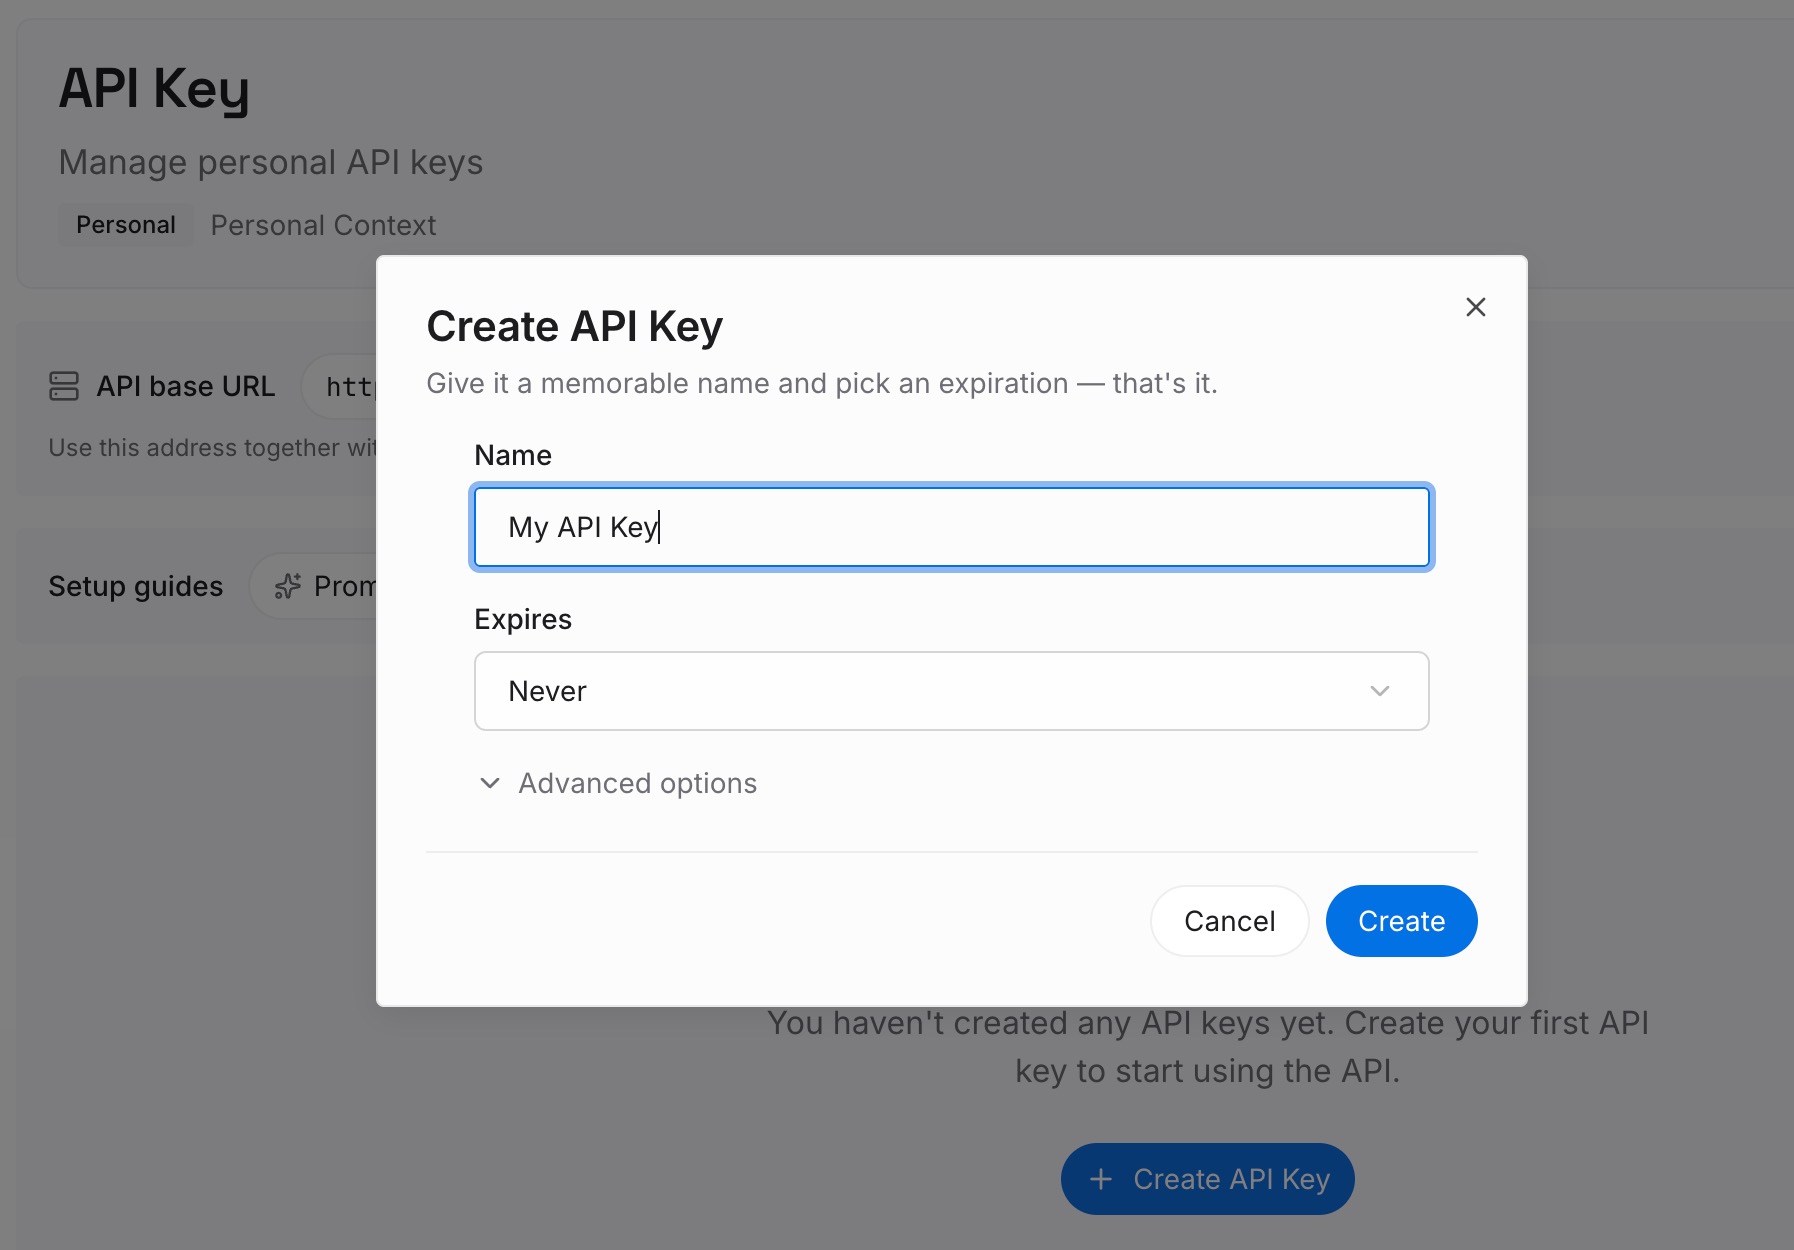
ステップ 1:APIキーを作成する
サインインし、ワークスペースの設定を開き、APIキーを生成します。これはアシスタントが同じレイヤーを読み取るために使用する資格情報であるため、一度作成したら、作業するすべてのツールからアクセスできるようにしておきます。
ステップ 2:最初のメモリをアップロードする
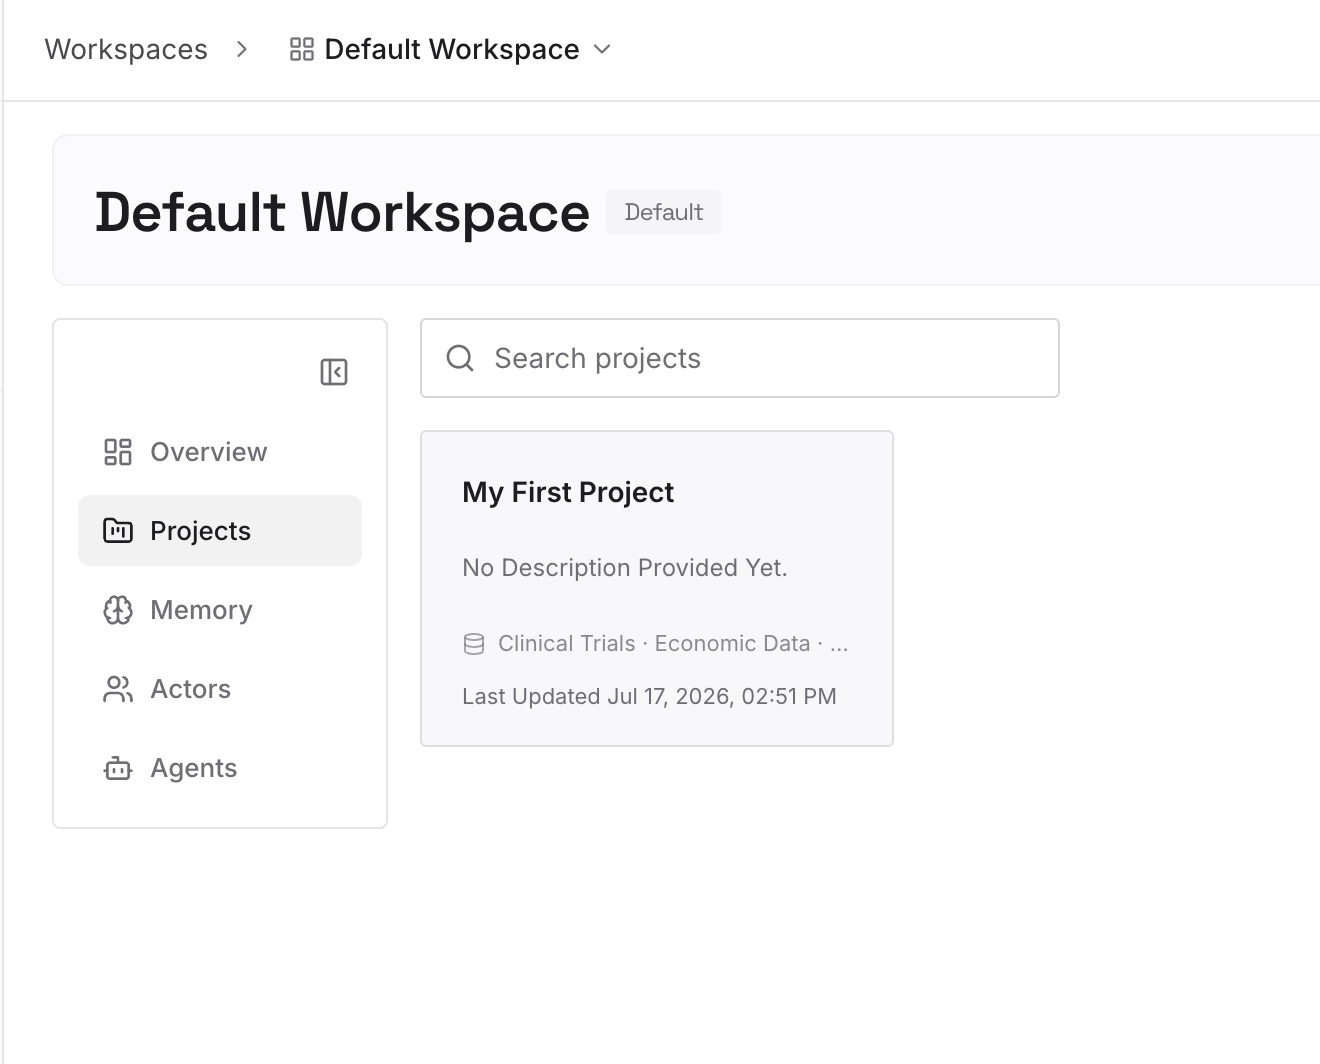
事実ではなく、関係性から始めましょう。今四半期に2回説明した5つの事柄を取り上げ、ルールと理由の両方を含む1つの文章としてそれぞれ書き留めます。再発見するのにコストがかかり、記録するのにコストがかからない制約を追加します。
ステップ 3:AIとエージェントを接続する
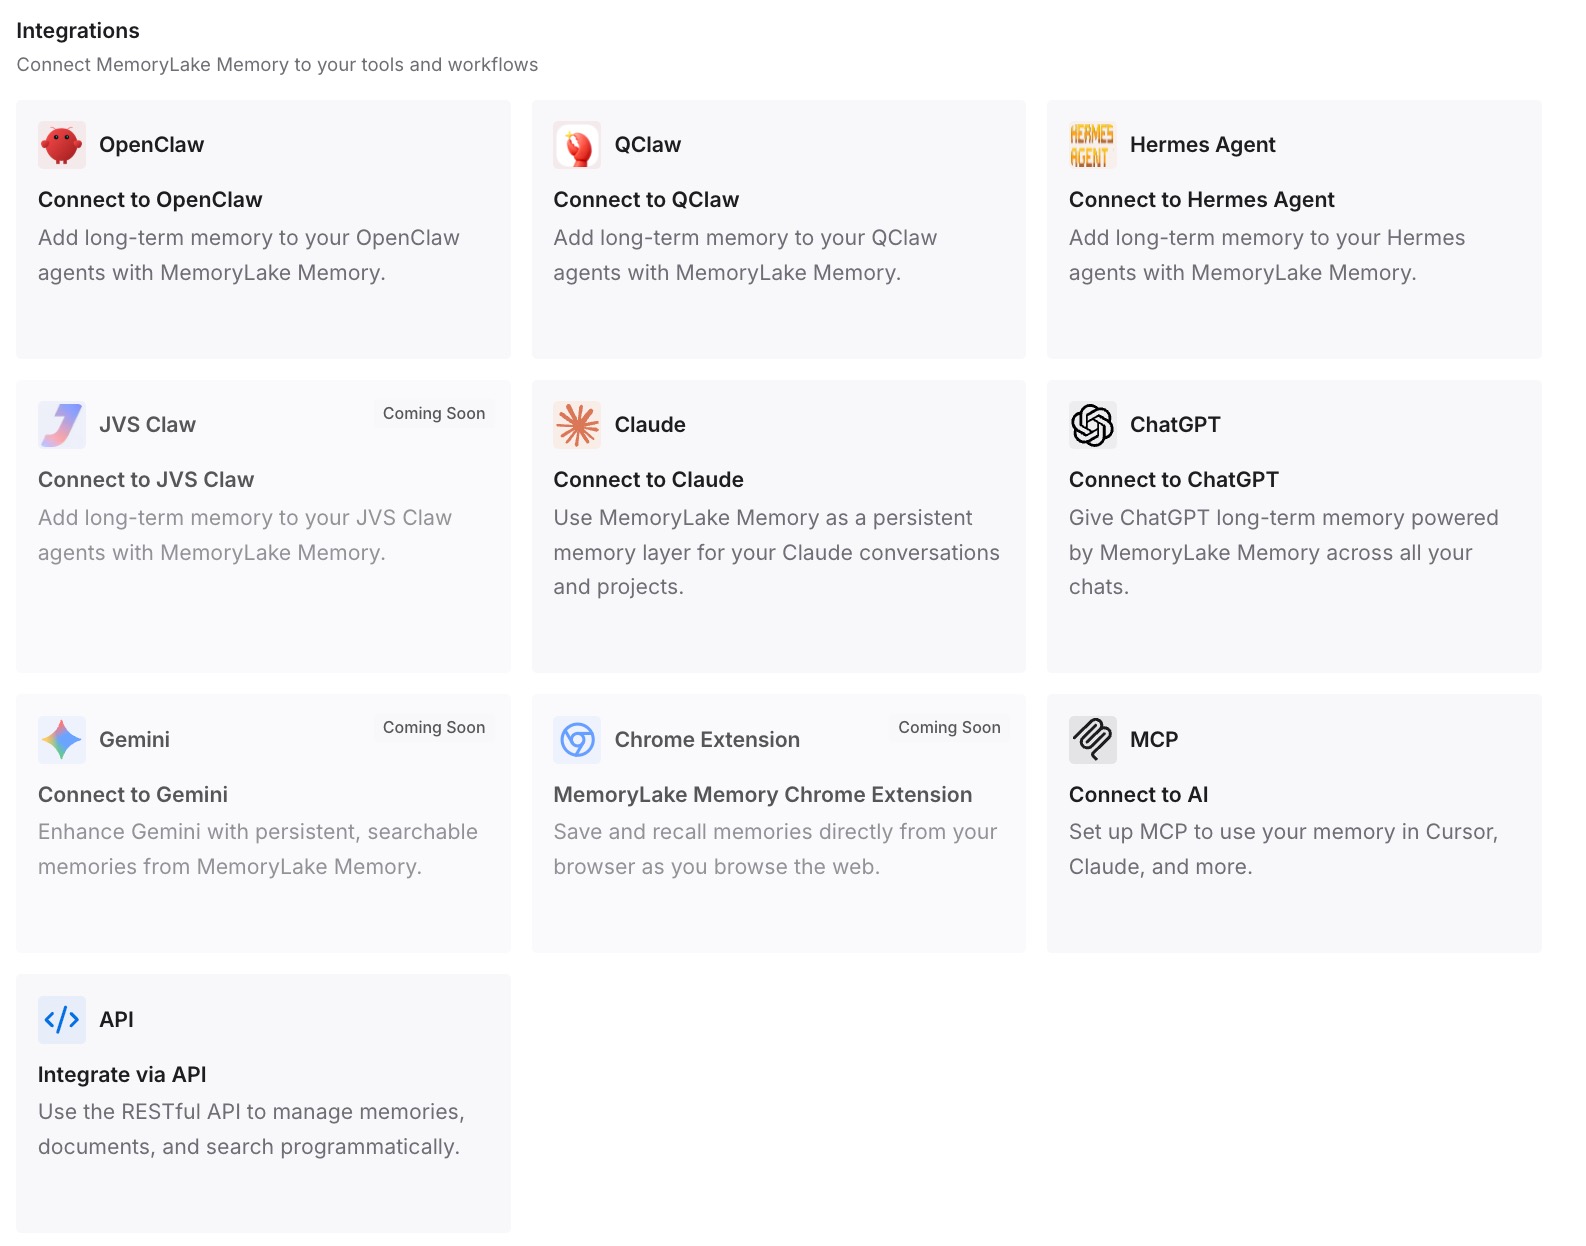
ChatGPTや、その他に使用しているツールを接続します。同じ推論がそれぞれに届くため、新しい会話はゼロからではなく、すでに結論づけた内容から始まります。
実務においてこれが変えること
最初の違いは、間違ったことにイライラしなくなることです。あなたが住んでいる都市は覚えているのに、なぜそこに引っ越したのかを覚えていないアシスタントは、不注意なのではありません。単一のオブジェクトとその直接のエッジを取得するのが非常に得意なレイヤーによって処理されているだけです。それを知ることで、漠然とした不満が具体的な習慣へと変わります。
2つ目は、メモがより短く、より便利になることです。独自の理由を伴うレコードは、意味をなすために2つ目のレコードを必要としないため、単独で読み取られても機能します。これはまさに、これらのシステムが最適化されているアクセスパターンです。
3つ目は、状況が変化したときに現れます。理由が書き留められていれば、それらがまだ有効かどうかを戻って確認できます。これは、事実のリストを読み直してどれが古くなっているかを考えるのとはまったく異なる作業です。そのレビューの習慣については、AIが覚えている内容の監査で説明されています。
4つ目は、セッション間の連続性です。ChatGPTがセッション間でコンテキストを失うときで説明されている落胆するような感覚は、ほとんどの場合、どこにも記録されなかった関係性を、毎回あなたが手動で再導出するコストによるものです。
ルックアップ型メモリを操作するためのベストプラクティス
決定ごとに1つのレコードを書き、その中に理由を含める。 一緒にしないと意味が通じない2つのレコードは、失敗を待つだけのトラバーサルです。
構造化よりも具体性を優先する。 簡潔に表現された文章は、維持管理できない巧妙なスキーマに勝ります。取得を行うシステムは、保存されたものを返すのは得意ですが、あなたが何を繋ごうとしたかを推測するのは得意ではありません。
何が真実であるかだけでなく、何が変わったかを記録する。 「3月に共有アカウントから移行した」という情報は、「独自のアカウントを持っている」という情報よりも有用です。なぜなら、読者に対してどの古い資料を信用すべきでないかを教えてくれるからです。
四半期に一度、最も古いエントリを読み直す。 事実は静かに腐敗します。理由は騒がしく腐敗するため、誤りを見つけやすいです。
レイヤーを特定の製品の外に維持する。 ベンダーは再設計を行います。OpenAIは、ライブラリからサービス、そして書き換えへと移行したサービスを説明する投稿を公開したばかりで、ストレージ層に関する第2部を約束しています。あなたの推論がそれを気にする必要はありません。
エンジニアリングの投稿を製品仕様書として扱わない。 この投稿はプラットフォームとそのトレードオフを説明しています。個々の機能のデータモデルを文書化しているわけではなく、そこから読み取ろうとするのは推測に過ぎません。
結論
Habitatに関する投稿は優れたエンジニアリングの文章であり、心に留めておくべき価値があるのは書き換えの部分ではありません。ベンダーが、求められてもいないのに、自社のオンラインストレージがシンプルで予測可能、かつ一定作業量のルックアップのために意図的に設計されていること、オブジェクト間の関係性が異なる地域に配置される可能性があること、および実際のトラバーサルを必要とするものはすべて、独自の所有者を持つオフラインコピーに送られることを明言している点です。
これを額面通りに受け取れば、私たちにとっての結論は平凡であり、同時に解放的なものです。あなたが言った2つのことの間の接続が、オンデマンドで再発見されるのを待つのはやめましょう。その接続を、独自の平易な文章として一度書き留め、使用するすべてのツールが読み取れる場所に保存してください。これにより、高コストな操作が安価な操作に変わります。これは、OpenAIのプラットフォームチームが1つ上のレイヤーで使用したのと同じトリックです。