
なぜ挿入順序は優先度のランキングではないのか
以下はドキュメントからの引用(原文ママ)です:
"数値。複数のエントリーが同時に有効化された場合の優先度を定義します。順序(Order)の数値が大きいエントリーほど、コンテキストの末尾近くに挿入され、出力に対してより大きな影響を与えます。例えば、順序が100のエントリーは、順序が250のエントリーよりも前にコンテキスト内に表示されます。"
数値が大きいほど、後ろに配置され、影響力が強くなります。250のエントリーは100のエントリーの後に配置され、モデルがこれから文章を生成しようとする位置(コンテキストの末尾)により近くなります。もし世界の根観となるルールに「1」を設定し、使い捨ての酒場に「400」を設定した場合、モデルの注意のすぐ隣に居座るのはその酒場の方になってしまいます。
これが1つ目の役割です。2つ目の役割は、ドキュメントのまったく別のセクション(「有効化設定(Activation Settings)」)に記載されており、長期のセッションで牙を剥くことになります:
"予算(トークン制限)が使い果たされた場合、プロンプト内にキーが存在していても、それ以上のエントリーは有効化されません。"
"常時有効(Constant)のエントリーが最初に挿入されます。その後に、順序(Order)の数値が大きいエントリーから順に挿入されます。"
つまり、同じ数値が「誰が生き残るか」も決定しているのです。World Infoの予算が尽きると、有効化は停止します。キーワードが一致し、エントリーが対象となっていても、何も挿入されません。最初に挿入されるのは常時有効(Constant)のエントリーであり、その後に数値の大きいものから順に挿入されていきます。あなたが「1」に設定したエントリーは、スペースの確保においても、モデルの注意を引く上でも、最後尾に並んでいることになります。
同じセクションにあるもう1つの記述は、再帰的なロア(Recursive Lore)の考え方を変えるものです:"キーが直接言及されたことで挿入されたエントリーは、他のエントリーのコンテンツ内で言及されたエントリーよりも優先度が高くなります。" 再帰によって引き出されたエントリーは、実際の会話によってトリガーされたエントリーの後ろに並ぶことになります。
そして、多くの「静かな失敗(サイレントエラー)」の原因となっている詳細があります。エントリーのタイトル(Entry Title)は、ドキュメントにおいて「エントリーを識別するための便宜上のテキストフィールドであり、AIやトリガーロジックには利用されません」と説明されています。プロのTipsではさらに広く、「有効化キーワード、タイトル、およびコンテンツ(Content)フィールド以外の情報はコンテキストに挿入されないため、各World Infoエントリーは包括的で自己完結した説明を持つ必要があります」と述べられています。もしタイトルに重要な意味を持たせているなら、それはAIに一切読まれていません。
これは、why agents ignore your instruction files(エージェントが指示ファイルを無視する理由)で説明されている問題と本質的に同じです。ファイルは存在し、内容も正しいのに、モデルに届いていないのです。
人々が代わりに試みがちなこと
すべてを「1」にリネームする。 すべてが「最も重要」になってしまうと、同順位の判定はランダムになり、予算制限によってどこかでリストが打ち切られることに変わりはありません。これでは優先順位をつけたことにはならず、優先順位をつける能力を自ら放棄したことになります。
すべてのエントリーを常時有効(Constant)にする。 青い丸の戦略(常時有効)は、エントリーが「キーワードを必要とせず、コンテンツに関係なくトリガーされる」ことを意味します。これは機能しますが、条件付きエントリーが検討される前に予算をすべて使い果たしてしまいます。常時有効のエントリーは最初に挿入されるとドキュメントに明記されているからです。3つか4つなら計画的と言えますが、20個もあれば予算に余裕は一切なくなります。
エントリーを短く書いて、それで終わりにする。 これは有用ですが、対処する変数を間違えています。長さは「いくつのエントリーが収まるか」に影響しますが、順序は「どれがスペースを獲得し、どこに配置されるか」に影響します。「すべてを短くする」アプローチの限界は、how much memory you should give an AI agent(AIエージェントにどれだけのメモリを与えるべきか)で説明されているものと同様です。
問題が起きなくなるまで予算(トークン制限)を引き上げる。 これはロアの問題をコンテキストの問題に変換しているだけです。World Infoの許容量を増やすということは、チャット履歴に割くスペースが減ることを意味します。これは why long context isn't memory(長いコンテキストがメモリではない理由)で説明されているトレードオフそのものです。プロンプトの空きスペースを増やすことはメモリを増やすことではなく、同じ棚の割り当てを変えているに過ぎません。
問題を回避するために、エントリーをベクトルマッチングに切り替える。 SillyTavernはそのコストについて率直に述べています:"検索の品質は埋め込みモデルの出力に完全に依存するため、どのエントリーが挿入されるかを正確に予測することは不可能です。確実で予測可能な結果を望む場合は、キーワードマッチングを使用してください。" また、ベクトルマッチングはキーワードチェックを置き換えるだけであり、予算、確率、フィルター、包含グループ(Inclusion Groups)は依然として適用されます。明文化できたはずの決定を類似性検索で代用するという、このトレードオフのより広い側面については、why RAG isn't memory(なぜRAGがメモリではないのか)で解説しています。
解決策:読ませたい「遅さ」で番号を決め、予算が実際にどこまで届くかを確認する
ステップ 1:近接度に基づいて、バンド(帯域)ごとに番号を再設定する
「優先度」を考えるのをやめ、「モデルが次に生成する文章にどれだけ近い位置に配置すべきか」を考え始めましょう。
番号の間に広いギャップを持たせた3〜4つのバンド(帯域)を作ります。そうすれば、後から全体をリネームすることなく新しいエントリーを挿入できます。低い数値は、早い段階で確立しておくべき背景(世界の物理法則、時代、大まかな設定など)に割り当てます。中間の数値は、場所や勢力に関する常識的な事実に割り当てます。高い数値は、モデルが文章を書く直前に最後に読ませたいもの(進行中のプロットの制約、キャラクターが絶対にしないことに関する厳格なルール、現在のシーンの状況など)に割り当てます。
正確な数値よりも、広いギャップを空けることの方が重要です。100刻みのバンドにしておけば、全体をリネームすることなく、既存の2つのエントリーの間に新しいエントリーを滑り込ませる余裕が生まれます。
次に、「ロア挿入戦略(Lore Insertion Strategy)」を確認してください。これが、数値が何と比較されるかを左右するからです。デフォルトは「Sorted Evenly(均等ソート)」で、SillyTavernはこれを「ソースを無視して、すべてのエントリーを1つの大きなファイルの一部であるかのように、挿入順序に従ってソートする」と説明しています。代替案である「Character Lore First(キャラクターロア優先)」や「Global Lore First(グローバルロア優先)」は、各グループ内で順序を適用する前に、オリジン(出自)ごとにグループ化します。もしキャラクターのロアブックとグローバルのロアブックで異なる番号のルールを使用している場合、Sorted Evenlyは作者が意図しない形でそれらを交互に配置してしまいます。
また、チャットに紐づくロアやペルソナに紐づくロアは、この比較よりも完全に前に、ドキュメントに記載された順序(チャットロア、ペルソナロア、そして選択した戦略によるキャラクターまたはグローバルロア)で挿入されることにも注意してください。
ステップ 2:位置(Position)と順序(Order)は異なるコントロールであるため、切り離して考える
「挿入順序(Insertion Order)」は、有効化されたエントリー間のシーケンス(順序)を決定します。「挿入位置(Insertion Position)」は、プロンプトのどの領域にエントリーが配置されるかを決定し、SillyTavernはそれぞれの影響について注記しています。
「Before Char Defs(キャラクター定義の前)」は「会話に中程度の影響を与える」とドキュメントに記載されています。「After Char Defs(キャラクター定義の後)」は「より大きな影響」を持ちます。例示メッセージ(Example Message)の位置は、対話例ブロックとして解析され、例示メッセージのルールに従うため、コンテキストが満たされるにつれて押し出される可能性があります。Author's Note(著者注)の位置には、ドキュメントが感嘆符付きで警告している罠があります:"Author's Noteが無効(挿入頻度 = 0)になっている場合、A/N位置にあるWorld Infoエントリーは無視されます!" エントリーが完璧に書かれ、正しくキーが設定され、順序が高くても、まったく別の機能がオフになっているために静かに破棄されてしまうことがあるのです。
ここで最も鋭いツールとなるのが「深度(Depth)」位置です。これはチャット内の特定の深度(深度0がプロンプトの最下部)に、システム、ユーザー、またはアシスタントの役割を選択してエントリーを挿入するものです。これにより、エントリーを常時有効にすることなく、生成の直前に厳格な制約を課すことができます。
完全にコントロールしたい場合、「Outlet」位置を使用すると自動挿入が完全に無効になり、自分で配置した名前付きトークンの下にコンテンツが保存されます。ドキュメントには実際の注意点が挙げられています:アウトレット名はケースセンシティブ(大文字小文字を区別)であり、マクロを呼び出す際に名前の前後のスペースは無視されるため、スペースでパディングされた名前は一致しません。また、ネストはサポートされておらず、キャラクターカードのフィールドは早期に解析されるためアウトレットを展開できません。
ステップ 3:パネルを読むのではなく、何がドロップ(除外)されたかを見て検証する
「正しいエントリー」と「挿入されたエントリー」は別物であり、設定パネルは前者しか表示しません。
複数のエントリーが同時にトリガーされるはずのシーンを実行し、実際に何が届いたかを確認します。順序の高いエントリーが表示され、低いエントリーが表示されない場合、予算の天井に達したことがわかり、順序設定が機能していることが確認できます。条件付きのエントリーがまったく届かない場合は、まず常時有効(Constant)のエントリーの数を数えてください。
包含グループ(Inclusion Groups)のテストは意図的に行ってください。その挙動は人々を驚かせることがあります:"同じグループラベルを持つ複数のエントリーが有効化された場合、プロンプトに挿入されるのは1つだけです。" これはグループの重み(Group Weight)によって選択されますが、「Prioritize Inclusion(包含優先)」を有効にしている場合は「最も高い『順序(Order)』値を持つものが選択されます。」これは、順序の数値に与えられる3つ目の役割であり、オプトイン(選択制)です。
また、順序を疑う前に、時間制限効果のある設定を確認してください。「Sticky(固定)」は、一定のメッセージ数の間エントリーをアクティブに保ち、その間は確率チェックを無視します。「Cooldown(クールダウン)」は、一定のメッセージ数の間再有効化をブロックします。「Delay(遅延)」は、チャットが十分に長くなるまで有効化を防ぎます。そして「Scan Depth(スキャン深度)」を確認してください。これが0の場合、"再帰されたエントリーとAuthor's Noteのみが評価される" ため、キーワードがスキャンされない限り、どれだけ正しい番号を設定してもエントリーが機能することはありません。
これは、auditing what your AI remembers(AIが覚えていることを監査する)で説明されている規律と同じです。設定を読むのではなく、出力を観察することによって検証してください。
MemoryLakeでの設定方法
この作業から2つのことが得られますが、ロアブックに属するのはそのうちの1つだけです。エントリー自体はSillyTavernの仕事であり、うまく機能します。しかし、「なぜこのルールがあのルールより優先されるのか」「どの制約を絶対に落としてはならないのか」「エントリーが静かに停止したときに何を学んだか」といった「推論(Reasoning)」は、数値フィールドの中に保存する場所がありません。
MemoryLakeは、特定のフロントエンドの外部で、この2つ目のレイヤーを保持します。あなた自身の言葉で書き留めておくことで、ツールを変更したり、ロアブックを再構築したり、世界設定を他の人に渡したりしても、いつでも読み返すことができます。
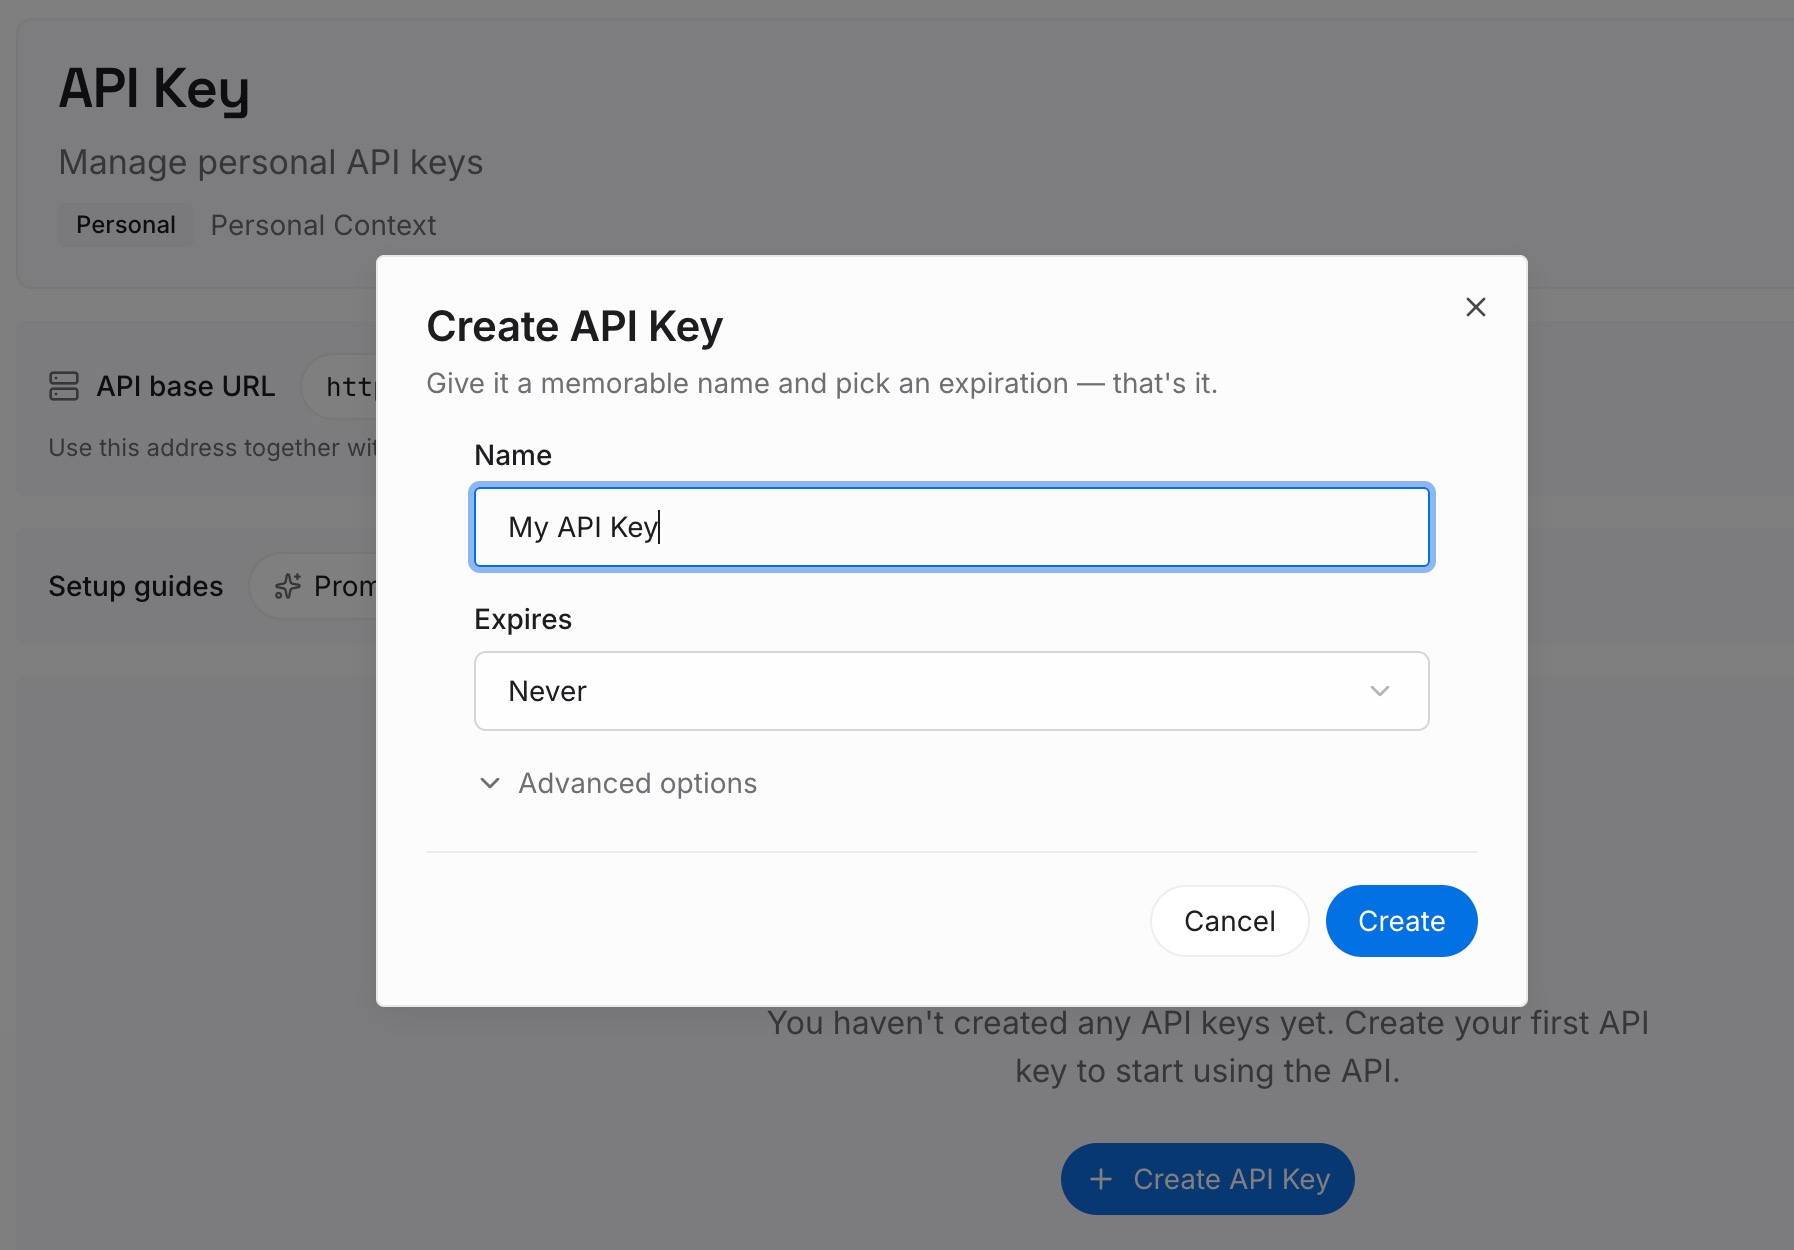
ステップ 1:APIキーを作成する
サインインし、ワークスペースの設定を開いて、APIキーを生成します。これはアシスタントが同じレイヤーを読み取るために使用する資格情報です。一度作成すれば、執筆を行う各マシンからアクセスできるようにしておきます。
ステップ 2:最初のメモリをアップロードする
エントリーの本文やタイトルから推論を切り離します。なぜ各バンドが存在するのか、どのエントリーが重要なのか、どれを降格させたのかとその理由、苦労して発見した条件などを整理します。ロアブックはロアを保持し、このレイヤーはそれに関する「決定事項」を保持します。
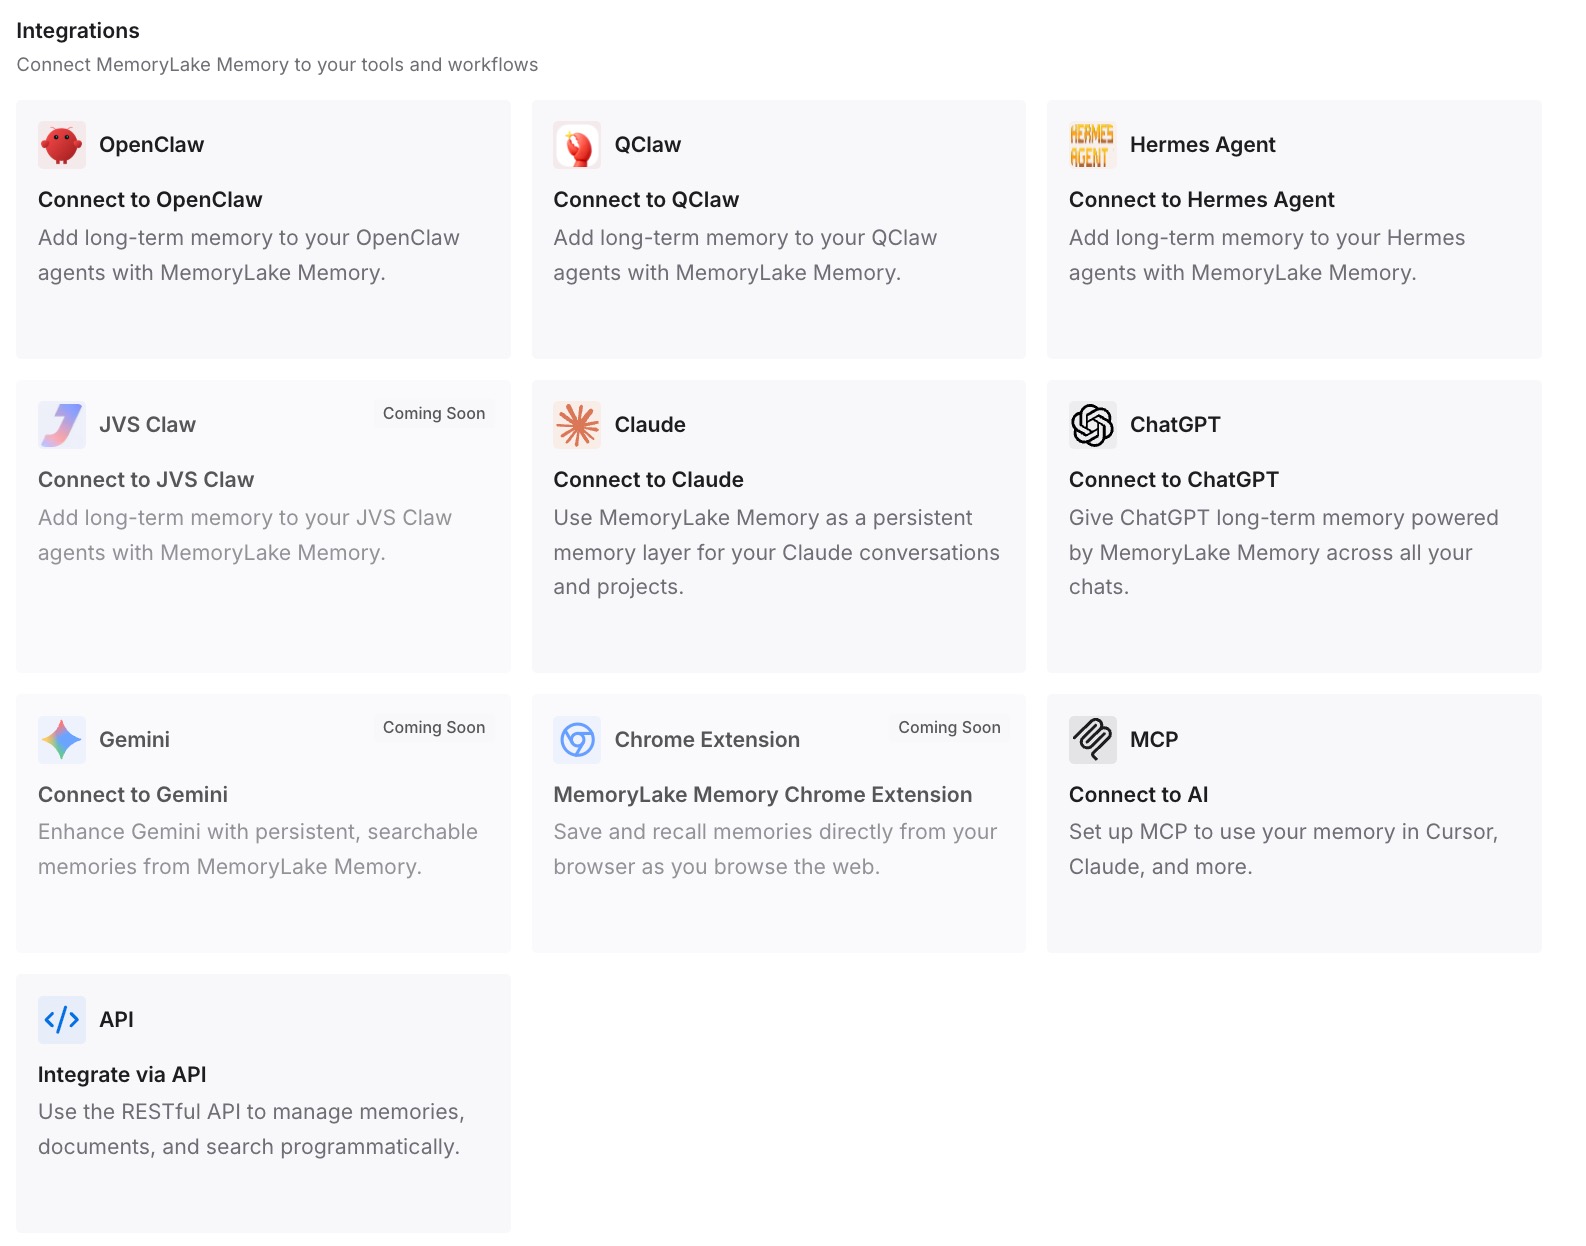
ステップ 3:AIとエージェントを接続する
あなたが執筆に使用するあらゆるツールと接続します。同じ決定事項がそれぞれのツールに届きます。ロアブックは次のツールにそのまま移行できないことがありますが、その背後にある「考え方」は移行されるべきだからです。
実践において何が変わるか
最初の違いは、長いシーンで現れます。価値の高いエントリーに高い数値を割り当てておけば、予算が尽きたときにランダムではなく最も重要度の低い端からトリミングされるようになり、実際に届いたエントリーは最も影響力のある場所に配置されます。
2つ目は、「静かな失敗」が診断可能になることです。エントリーが正しいにもかかわらず表示されない理由として、ドキュメントには少なくとも4つの原因(予算超過、Author's Noteの無効化、包含グループの抽選漏れ、スキャン深度の不足)が挙げられています。このリストを知っておくことで、謎がチェックリストへと変わります。
3つ目は、タイトルに騙されなくなることです。タイトルは自分自身のためだけのものであると受け入れれば、すべてのエントリーに自己完結した本文を持たせるようになります。これは、ドキュメントが「各エントリーは包括的で自己完結した説明を持つべきである」と求めていることとも一致します。
4つ目は、ポータビリティ(移植性)です。言葉による条件として表現された世界設定は、プラットフォームの移行を乗り越えられますが、挿入順序の数値として表現された世界設定は移行できません。これこそが、migrating Character AI Lorebooks to ChatGPT(Character AIのロアブックをChatGPTに移行する)で説明されているような、移行を苦痛にするギャップです。OpenAIのドキュメントに記載されているパーソナライズ機能には、それらを受け取るための順序制御が記述されていません。
World Infoの順序設定におけるベストプラクティス
優先度ではなく、位置で番号を決める。 数値が大きいほど後ろに配置され、後ろに配置されるほど影響力が強くなります。必要なら付箋に書いて貼っておきましょう。
ギャップを空ける。 100刻みのバンドにしておけば、世界設定全体をリネームすることなく新しいエントリーを挿入できます。
常時有効(Constant)のエントリーは計画的に予算を配分する。 これらは最初に挿入され、最初に予算を消費します。青い丸のリストは、暗記できるほど短く保ちましょう。
厳格な制約は最上部ではなく、深度(Depth)に配置する。 深度位置を使用すれば、コンテンツを常時有効にすることなく、生成位置の近くに配置できます。
Author's Noteの位置を使用する前に、Author's Noteの設定を確認する。 Author's Noteが無効になっている場合、Author's Noteの位置に割り当てられたエントリーは無視されます。
すべてのエントリーに自己完結した本文を持たせる。 タイトルやキーワードはコンテキストに挿入されないため、タイトルがないと意味が通じないエントリーは、AIにとっては意味をなさないエントリーになります。
予算や戦略を変更した後は必ず再テストする。 ロア挿入戦略を変更すると数値の比較対象が変わり、予算を変更するとカットオフされる位置が変わります。どちらも警告なしに(静かに)発生します。
結論
SillyTavernは、直感に反する部分も含めて、真に強力なプロンプト管理システムを提供し、それを適切にドキュメント化しています。「挿入順序(Insertion Order)」は優先順位ではなく位置であり、数値が大きいほど後ろに配置され、より重要な意味を持ちます。同じ数値が、予算が尽きたときに誰が生き残るかを決定し、包含グループの勝者を決定するためにも使用できます。
広いバンドで近接度に基づいて番号を再設定し、最後に配置すべきものには位置や深度を使用し、設定パネルを読むのではなく実際に何が届いたかを観察して検証してください。そして、エントリーの本文から推論を切り離しましょう。数値フィールドは、あなたの世界がなぜそのように機能するのかを記録するには不向きな場所であり、次に使用するツールには独自のコントロールや予算があり、このロアブックを読み取る方法がまったくない可能性があるからです。