
なぜ wiki.json によって DeepWiki が縮小してしまうのか
まずはこのファイルが何を行うかから始めましょう。「Wiki生成中にリポジトリのルートディレクトリに .devin/wiki.json ファイルが見つかった場合、提供された repo_notes と pages を使用してWiki生成をコントロールします。両方のフィールドが必須であり、pages には少なくとも1つのページをリストする必要があります。」
これら2つのフィールドは異なる役割を担っています。Cognition はこれを1行でまとめています。「Notesは各ページがどのように書かれるかをガイドし、pages はどのページが作成されるかを決定します。」Notesはコンテキストであり、Pagesはアウトラインです。
そして、このアウトラインは文字通りに解釈されます。設定リファレンスによると、pagesは「明示的な指示として扱われます。JSONで定義したページのみが生成され、それ以上でもそれ以下でもありません。」トラブルシューティングのセクションでは、この点がさらに2回強調されています。これは、多くの人が陥りやすい罠であることを示しています。「Wikiはリストしたページのみを生成するため、ページのないフォルダは表示されません。」そして「注意:DeepWiki はこの配列に含まれるページのみを生成するため、足りないページだけでなく、すべてのページが存在することを確認してください。」
したがって、「Wikiが testing/ フォルダをスキップしたから、それに言及した設定を追加しよう」という最も自然な行動をとると、自動的に計画されたWikiが、書き下したページのみで構成されるWikiに置き換わってしまいます。
考慮すべき厳しい制限もあります。「最大30ページ(エンタープライズは80ページ)」、「リポジトリとページのノートを合わせて最大100個のノート」、「1ノートあたり最大10,000文字」。ページのタイトルは「一意かつ空でない」必要があります。また、ページのないファイルが自動プランに静かにフォールバックすることもありません。pages を省略した(または空のままにした)wiki.json は「拒否されます」。
Wikiに反映される内容を決定する詳細がさらに2つあります。ブランチについて:「Devin は各リポジトリのデフォルトブランチをインデックスします」。Cognition のヒントは「チームが活発に開発しているブランチをインデックスする」ことです。エフォート(労力)について:Wiki生成は3つのエフォートレベルのいずれかで実行されますが、「エンタープライズ組織は常に低エフォートで実行され、この設定は変更できません。」
そして、それを読む対象(オーディエンス)がいます。DeepWiki は人間が閲覧するだけのものではありません。「Ask Devin は、Wikiの情報を使用してコードベース内の関連するコンテキストをよりよく理解し、見つけ出します。」また、DeepWiki MCP サーバーを介して、外部エージェントは read_wiki_structure、read_wiki_contents、ask_question という名前のツールを使用してそれを読み取ります。生成されないページは、これらのエージェントの誰も読み取ることができないページになります。
人々が代わりに試みがちなこと
足りないページだけを記述した wiki.json を追加する。 これは前述の罠です。欲しかったページは手に入りますが、リストに記載しなかった他のすべてのページを失うことになります。
repo_notes を使用してカバレッジを要求する。 Notesはページの書かれ方を決定するものであり、どのページが存在するかを決定するものではありません。「scriptsフォルダをドキュメント化する」というノートを追加しても、pages にそのページがなければ何も起こりません。
自動生成された Wiki をそのままにして、エージェントが残りのコードを検索することに期待する。 エージェントはコードを検索できますが、フォルダの生成されたドキュメントは、名前でファイルを見つけることとは異なります。エージェントが実際に読み込む情報は、ほとんどのチームが想定しているよりも狭い範囲です。このパターンについては、コーディングエージェントが実際に読み取っているもので解説しています。
MCP サーバーを DeepWiki に向け、プライベートリポジトリもカバーされていると仮定する。 パブリック MCP サーバーは「パブリックリポジトリへのアクセスを提供する、無料の、リモートの、認証不要のサービス」と説明されています。プライベートコードの場合、Cognition は Devin API キーを使用した Devin MCP サーバーを指し示しています。
あるクライアントの MCP 設定を別のクライアントにコピーする。 Cognition はこれを明示的に指摘しています。「Devin Desktop は serverUrl を使用しますが、他のほとんどのクライアントは標準の url フィールドを使用します。間違ったフィールド名を使用すると、MCP サーバーは静かに無視されます。」
解決策:現在の Wiki を記録し、完全なページリストでコントロールする
目標は、関心のあるフォルダをカバーし、自動プランがすでに生成した有用な内容をすべて維持し、それに依存するすべてのエージェントに届く Wiki を作成することです。
ステップ 1:設定を追加する前に、現在の Wiki 構造を記録する
何かを触る前に、現在の自動生成された Wiki に何が含まれているかを書き留めておきます。Devin または deepwiki.com で Wiki を開き、ページツリー(すべてのトップレベルページとすべての子ページ)をコピーします。
MCP クライアントを使用している場合は、リポジトリに対して read_wiki_structure を呼び出すようエージェントに依頼できます。Cognition はこれを「GitHub リポジトリのドキュメントトピックのリストを取得する」方法と説明しています。後で比較できるように、結果をファイルに保存しておきます。
次に、各ページに「維持(keep)」、「統合(merge)」、「削除(drop)」の3つのラベルのいずれかを付けます。人間やエージェントが使用するページは維持します。隣接するコードをカバーしている薄いページは統合します。誰も説明を必要としない、生成されたコードやベンダーコードをドキュメント化しているページは削除します。
最後に、足りないものをリストアップします。自動プランがスキップしたフォルダ、作成されなかった横断的なトピック(サービス間の通信方法、デプロイの仕組みなど)、および生成されたサマリーが浅すぎて役に立たない領域などです。
ステップ 2:必要なすべてのページを記述した wiki.json を作成し、優先事項を repo_notes に記述する
不足している部分だけでなく、作成したリスト全体からファイルを構築します。
すべての「維持」ページと不足しているページを pages に追加し、それぞれに一意の title と具体的な purpose を設定します。Cognition のガイダンスでは、「焦点を当てる特定のディレクトリ、ファイル、または概念に言及する」こと、および「システムが意図を理解するのに十分な詳細を提供する」ことが推奨されています。parent を使用して、「高レベルの概要ページから」階層を再構築します。
コミットする前に数を数えてください。リストがページ制限を超える場合は、エージェントや新しいチームメンバーが最もよく開くページを優先し、関連するページを統合して制限内に収めます。
強調や関係性の表現には repo_notes を使用します。Cognition は、「コードベースのどの部分が最も重要であるか」を示し、「システムの異なる部分間の関係を説明する」ノートを推奨しています。追加する内容がない場合でも、repo_notes キーは残しておいてください。リファレンスには「空の配列([])を使用する」と記載されています。特定の1ページにのみ適用されるガイダンスについては、page_notes を使用します。
その後、ドキュメント化された手順に従います。「ファイルをコミットし、Wiki を再生成します。」
ステップ 3:再生成、比較、そしてエージェントに届いているかの確認
再生成された Wiki を、ステップ1で保存したツリーと比較します。すべての「維持」ページが依然として存在し、統合されたページが首尾一貫して読め、不足していたフォルダにページが作成されていることを確認します。何かが消えてしまった場合、それは pages から漏れています。
ブランチを確認します。Wiki がデフォルトブランチを説明している一方で、チームが別のブランチで作業している場合は、Cognition のヒントに従って、そのブランチをインデックス作成に追加します。
次に、エージェントを確認します。チームが使用している各 MCP クライアントで、サーバーのエントリがそのクライアントが期待するフィールド(Devin Desktop の場合は serverUrl、その他ほとんどの場合は url)を使用していること、および推奨されるエンドポイントを指していることを確認します。Cognition は「SSE が非推奨になりつつあるため、/mcp エンドポイントが推奨されます」と述べています。各クライアントに、新しいページのいずれかに答えがある質問を投げかけてみてください。クライアントが Wiki から回答を返せば、コントロールがエージェントに届いている証拠です。
コードベースの形状が変わったら、ファイルを見直してください。新しいサービスや廃止されたモジュールがある場合は、ページリストを編集する必要があります。なぜなら、Wiki はファイルに書かれていることだけを生成し、それ以上でもそれ以下でもないからです。
Setting this up in MemoryLake
コントロールされた DeepWiki は、コードが何であり、どのように組み合わされているかを説明します。これはリポジトリから生成されるため、履歴ではなく構造を記述します。たとえば、なぜモジュールが分割されたのか、どのアプローチが試みられ、断念されたのか、API についてチームが合意した内容は何か、などです。そうしたコンテキストは、人々の頭の中や散らばったスレッドの中に存在しています。MemoryLake は、Wiki と並行してそれらを保管しておく場所であり、エージェントが地図と、その背景にある理由の両方を取得できるようにします。
エントリーはあなた自身の言葉で、あなた自身が記述します。あなたの DeepWiki、wiki.json、リポジトリ、またはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。
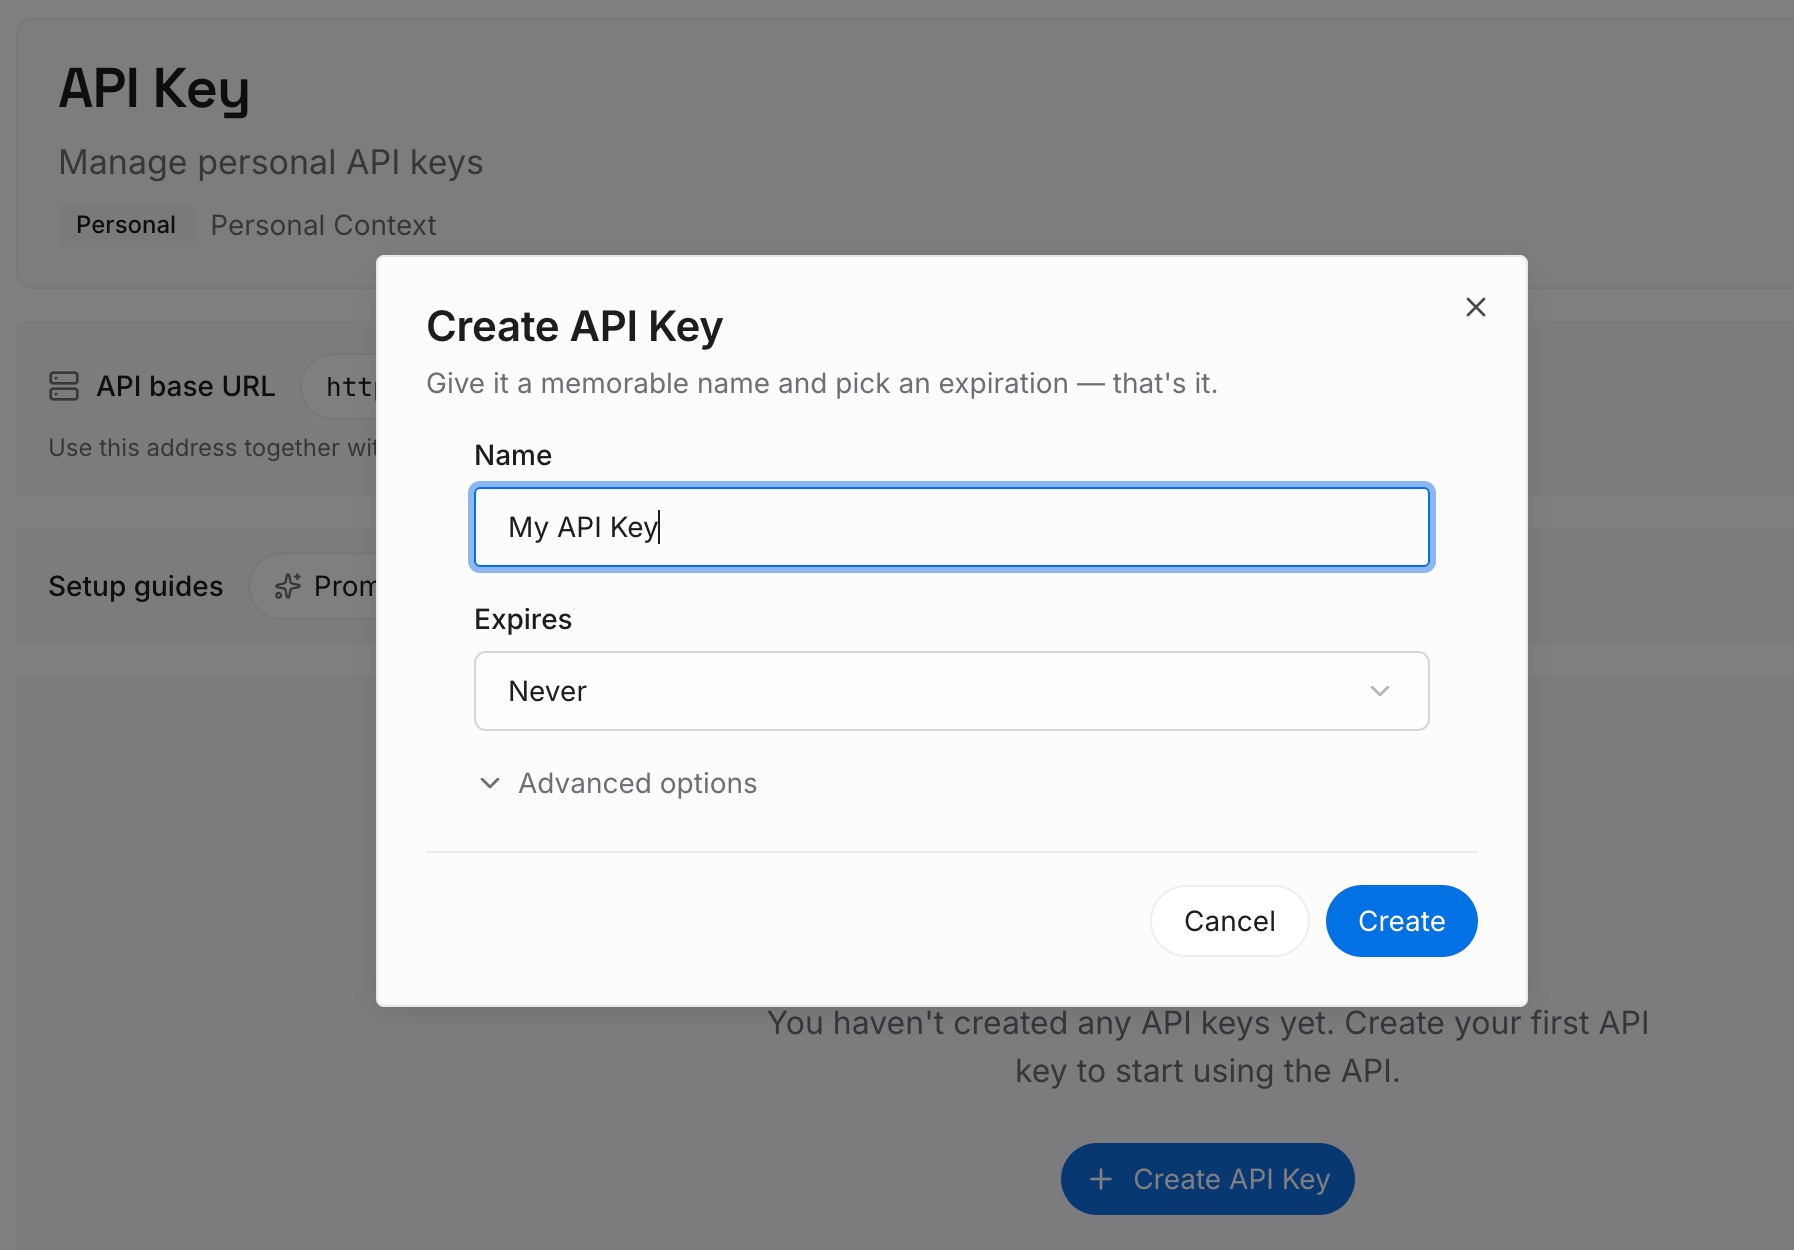
ステップ 1:API キーを作成する
サインインし、ダッシュボードからキーを生成します。このキーにより、コーディングエージェントがどのクライアントで実行されていても、あなたが作成したエントリーを読み取ることができるようになります。
ステップ 2:最初のメモリをアップロードする
ステップ1で明らかになったものの、生成されたページには収まらない内容から始めましょう。構造の背後にある決定事項、既知の落とし穴、コードからは明らかではない規約などです。1つのエントリーにつき1つの決定事項を、その理由とともに記述します。
ステップ 3:AI とエージェントを接続する
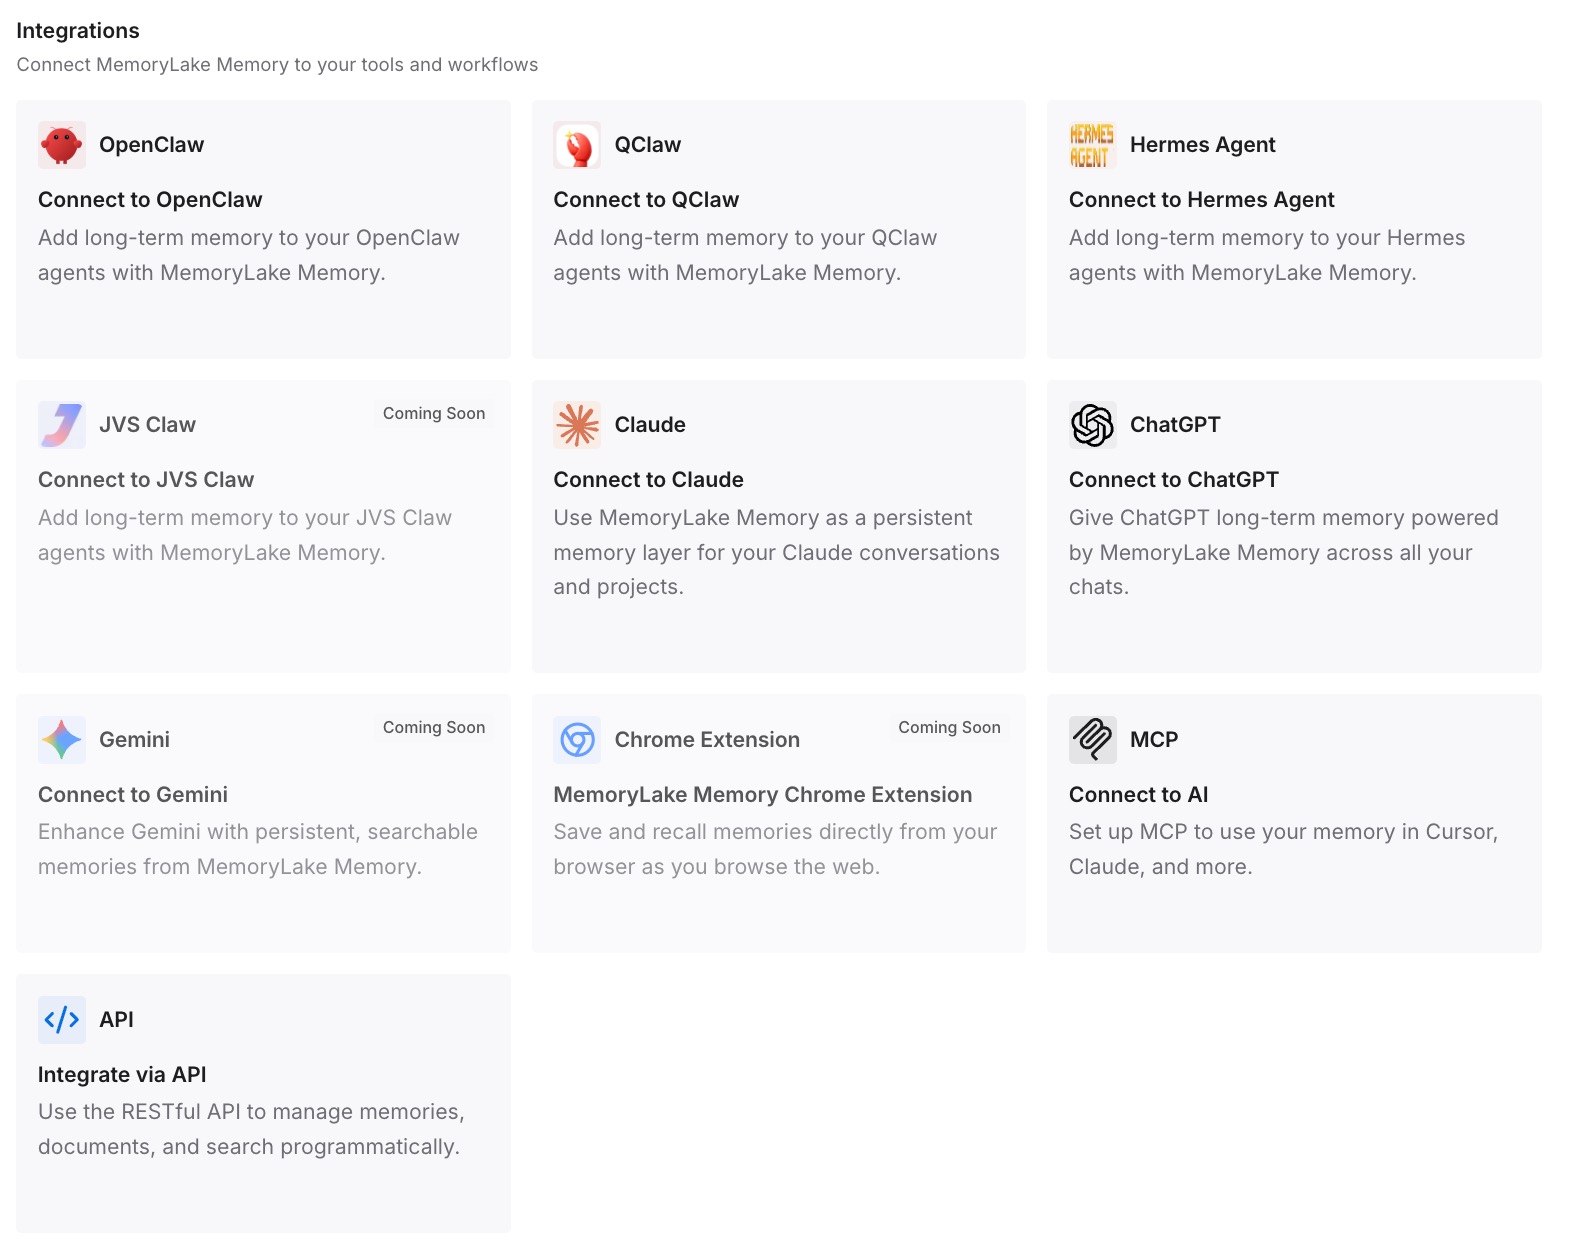
チームが使用しているコーディングエージェントを接続します。これにより、MCP を介して DeepWiki を読み取るエージェントを含め、すべてのセッションで決定事項が Wiki の隣に配置されるようになります。
実務における変化
第一の違いは、コントロールに伴うリスクがなくなることです。既存のツリーを記録し、そこからページリストを作成してしまえば、wiki.json を追加することは、Wiki を置き換えるのではなく、カバレッジを拡大することを意味するようになります。
第二に、リポジトリノートが本来の役割を果たすようになります。カバレッジが pages に定義されていれば、ノートは Cognition が設計した本来の目的、すなわち優先順位や関係性の説明に専念できます。これにより、新しいページを要求するのではなく、すべてのページの品質が向上します。
第三に、エージェントが不完全な地図に基づいて作業することがなくなります。同じ Wiki が Ask Devin とすべての MCP クライアントに提供されるため、完全なページリストを用意することで、すべての場所で同時に回答の質が向上します。これは、エージェントが全体像を再構築するためにセッションごとにコードベースを再読するのを防ぐために重要です。
第四に、生成されたドキュメントとチームの知識が混同されなくなります。コードから再生成された Wiki は「これは何か」に答えます。決定事項は「なぜこのようになっているのか」に答えます。生成されたページに対する検索(Retrieval)は有用ですが、なぜRAGはメモリではないのかで説明されているように、チームが決定したことを記憶することとは異なる役割を持っています。
DeepWiki をコントロールするためのベストプラクティス
設定を追加する前に、現在のページツリーを保存する。 これが、wiki.json によって何が削除されたかを知る唯一の方法です。
足りないページだけでなく、必要なすべてのページをリストアップする。 Wiki は pages 配列に記述された内容のみを正確に生成します。
強調には repo_notes を、カバレッジには pages を使用する。 Notesはページの書かれ方をガイドし、Pagesはどのページが存在するかを決定します。
制限内に収める。 ページ数制限を超える場合は、ページを統合します。
チームが開発しているブランチをインデックスする。 Devin は、他のブランチを追加しない限り、デフォルトブランチをインデックスします。
MCP フィールドをクライアントに合わせる。 フィールド名が間違っていると、サーバーは静かに無視されます。
理由は Wiki の外の永続的な場所に保管する。 Devin 独自の Knowledge エントリには独自の検索ルールがあり、Devin がタスクのコンテキストを忘れてしまう問題は、ドキュメントのカバレッジとは別の問題です。手順については、メモリをスキルに移行するのも一つの方法です。
結論
.devin/wiki.json は、DeepWiki の自動プランが大規模なリポジトリの重要な部分を見落としている場合に適したツールです。また、これは非常に厳密です。Cognition が述べているように、「JSON で定義したページのみが生成され、それ以上でもそれ以下でもありません。」
コントロールを行う前に、現在の Wiki を記録してください。その記録と不足している部分からページリストを構築し、強調にはリポジトリノートを使用し、制限内に収めて再生成します。その後、ブランチが正しいこと、およびすべての MCP クライアントが期待するフィールドで設定されていることを確認し、Wiki を読み取るエージェントが意図したバージョンを取得できるようにします。
コードの背後にある理由は、独自のレイヤーに保管してください。生成された Wiki は構造を記述するものであり、その背後にある決定はチームから生まれるものだからです。セッション間で MCP 接続が何を引き継ぎ、何を引き継がないのかというより広い問題については、MCP における欠落したメモリレイヤーを参照してください。