
Always-on Agentとは何か
Anthropicの最初の指摘は、この名称は「体験」を表すものであり、決して止まることのない「プロセス」を指すのではないということです。ブログの言葉を借りれば、「実際には、エージェントはその時間のほとんどを眠って過ごし、定期的に起きて仕事をする」のです。
仕事の各区切りは「Run(実行)」と呼ばれます。投稿では、Runを「エージェントがイベントを受け取り、タスクを完了し、何が起こったかについての情報を保存する」プロセスとして説明しています。Runは「Session(セッション)」の内部で動作し、セッションはメッセージとツール呼び出しのトランスクリプト(記録)として定義されます。Runが終わると、エージェントは再び眠りにつきます。
Anthropicによれば、Always-on Agentの内部では他のエージェントと同じコア・ループが使われています。異なるのはそのループを取り巻くアーキテクチャです。何がエージェントを起動させるのか、RunからRunへ何を引き継ぐのか、そしてその成果がどのようにユーザーに届くのか、という点です。
この投稿では、関心が再燃した理由として2つのモデルの進化を挙げています。それは、いつチェックインすべきかという判断力の向上と、長いタスクにおけるコストの低下です。
5つのプリミティブ
Anthropicはこれらを一行で列挙しています。「Always-on Agentを取り巻くアーキテクチャには、5つのコア・プリミティブがあります。イベントインボックス、タイマー、Memory、パーミッション、そしてアウトボックスです。」
イベントインボックス(Event inbox)。 ほとんどのエージェントは、ユーザーがメッセージを送ったときにのみ実行されます。Always-on Agentは、Webhook、スケジュールされたタスク、バックグラウンドジョブによってトリガーされます。各ソースがエージェントを直接呼び出すのではなく、すべてのソースがインボックスにイベントを書き込み、ワーカーがそこからイベントを拾い上げます。Anthropicは「インボックスを信頼できる唯一の情報源(Source of Truth)にすべきである」と推奨しています。これにより、実行中にワーカーが停止しても、新しいワーカーが同じイベントを再試行できます。また、2つのRunが互いに上書きし合わないよう、1つのインボックスに対して一度にアクティブなワーカーは1つにすることを推奨しています。
タイマー(Timers)。 これらがエージェントをプロアクティブにします。Anthropicは2つの種類を分けています。「フォローアップは、返信を確認するなど、エージェントが自分自身に設定する期限です。」スケジュールは、日刊ニュースレターのような既知のケイデンス(周期)で行われる繰り返しタスクです。スケジューラーが期限の来たタイマーをチェックし、インボックスにイベントを追加します。
Memory(記憶)。 詳細は後述します。
パーミッション(Permissions)。 Runはユーザーのアクセス権限を保持し、無人で作動するため、各ツール呼び出しにおいて、エージェントは続行するか、ブロックするか、あるいは承認を待つかを決定しなければなりません。
アウトボックス(Outbox)。 Always-on Agentは仕事の大部分をバックグラウンドで行い、ユーザーはすべてのステップではなく結果を受け取ります。Runは、メッセージを送信するか、何も送信する必要がないと判断するか、あるいは許可や入力を求めることで終了します。
これらのピースがサイクルを形成します。イベントがRunを開始し、エージェントはMemoryを読み込み、パーミッションの範囲内で仕事を行い、Memoryを更新して結果を届けます。投稿はこう締めくくっています。「各Runは短時間ですが、サイクルは無期限に続き、それがエージェントを常にオンであるかのように感じさせるのです。」
なぜMemoryが連続性を感じさせるプリミティブなのか
5つのうち、バラバラのRunの連続を一人のアシスタントのように感じさせるのがMemoryです。Anthropicは直接的にこう述べています。「Always-on Agentは多くの断続的なRunをまたいで動作し、連続性を維持するためにMemoryに依存しています。」
投稿では2つの構造的な推奨事項を挙げています。
Memoryには専用のストアを用意する。 インボックスやタイマーと同様に、Memoryは個別に保存されるべきです。Anthropicは、Claude Codeの自動MemoryやMessages APIのMemoryツールを含む自社製品において、Memoryはファイルのディレクトリであると述べています。Always-on Agentの場合、それらのディレクトリはデータベースやオブジェクトストレージなどの永続的なストレージにマッピングされるべきです。「これにより、Memoryはワーカーよりも長生きします。」
Claude Code版のこれを利用したことがあるなら、私たちのガイド Claude Codeの自動Memoryとは何か で、Memoryファイルがどのようにロードされ、インデックス化されるかを解説しています。
Memoryには他で見つけられないものだけを保持する。 これが他のすべてを形作るルールです。「経験則として、Memoryにはエージェントが再度検索できないものだけを保持すべきです。」投稿は続けます。「イシュートラッカーなど、すでに他のシステムに存在するものであれば、代わりにポインタ(参照)を保存すべきです。」
Anthropicが推奨する4種類のMemory
投稿ではMemoryを4つのタイプに分類しています。それぞれが、エージェントが毎回のRunで再確認しなければならない異なる疑問に答えるものです。
ユーザーの指示 (User instructions)
「エージェントの動作に関するユーザーからの指示は、専用のファイルに保存し、すべてのRunの開始時にロードする必要があります。」
その理由は、人間が常に監視しているわけではないからです。「ユーザーが常にエージェントを操縦するためにそばにいるとは限らないため、指示はRunをまたいで引き継がれなければなりません。」先週、エージェントに「正午より前にクライアントにメールを送らないように」と伝えたなら、その指示は先週のセッションではなく、次のRunがロードするファイルに含まれている必要があります。
ユーザーノート (User notes)
「エージェントは、ユーザーの役割、好み、あるいは与えられた訂正など、ユーザーについて学んだことを保存すべきです。」
Anthropicは、最初は1つのファイルから始め、ノートが増えるにつれて複数の小さなファイルに移行することを提案しています。その場合、各Runの開始時にはインデックスのみがロードされ、エージェントは必要なときに個別のファイルをコンテキストに引き込みます。
過去のメッセージ (Past messages)
「エージェントは、同じことを繰り返さないように、すでにユーザーに伝えた内容を把握しておくべきです。」
これは各Runの開始時にロードされる別のファイルにするか、ワーカーがユーザーとの直近数件のメッセージをロードするようにします。
タスクの進捗 (Task progress)
「進行中の各タスクについて、エージェントは何が完了し、何が残っているかを網羅した進捗ファイルを保持すべきです。」
新しいRunはそのファイルを読み、前のRunが停止したところから再開できます。ユーザーノートと同様に、開始時にはインデックスのみをロードし、必要に応じて個別の進捗ファイルを引き込むことが推奨されています。
Dreaming(ドリーミング)
Run中に保存されるもの以外に、投稿では「Dreaming」と呼ばれるオプションの追加ステップについて説明しています。これは過去のセッションを見直してMemoryを整理するプロセスです。Anthropicの言葉を借りれば、「Dreamingは古いエントリを置き換え、多くのRunをまたがないと見えてこないパターンを見つけ出すことができます。」詳細はAnthropicのエージェントMemoryに関する以前の記事を参照するように述べており、これについては私たちのガイド Claudeが何を覚えるかをどう決めるか で解説しています。
Memoryに含めるべきでないもの
「Memoryにはエージェントが再度検索できないものだけを保持すべき」というルールは、両刃の剣です。何を保持すべきかを教えると同時に、何を省くべきかも教えてくれます。
他のシステムに存在するあらゆるもの。 チケットの詳細、ドキュメントの内容、カレンダーのエントリ、コードにはすでに居場所があります。これらをMemoryにコピーすると、古くなる可能性のある第2のバージョンが作成されてしまいます。チケットIDやドキュメントリンクなどのポインタで十分です。
完全なトランスクリプト。 セッションにはすでにメッセージとツール呼び出しが記録されています。Memoryはエージェントがそこから学んだことのためのものであり、コピーを二重に持つためのものではありません。
エージェントがどのみちロードするコンテキスト。 Anthropicは、作業の前にエージェントがシステムプロンプト、ツール定義、Memoryファイルをロードし、このオーバーヘッドがすべてのRunに含まれることを指摘しています。投稿では、コストを抑えるためにMemoryをスリムに保ち、プロンプトキャッシュを使用することを推奨しています。Memoryのすべての行は、毎回のRunで支払うコストになります。
なぜセッションだけでは不十分なのか
セッションが単独で連続性を処理してくれると考えがちです。Anthropicは、セッションが運ぶものと運ばないものの間に明確な線を引いています。
「新しいセッションは、このコンテキストのオーバーヘッドと、Runをトリガーしたイベントのみで開始されます。」対照的に、既存のセッションは、以前のRunからのメッセージとツール呼び出しを呼び戻します。ユーザーからの返信など、以前の作業を継続するイベントは既存のセッションを再開しますが、それ以外はすべて新しいセッションを開始します。
したがって、エージェントが先週の会話を見るかどうかは、新しいイベントがどのセッションに着地するかによります。日次タスクを実行するタイマーは、新しく開始されるかもしれません。どちらの場合でもロードされるのはMemoryだけです。
長いセッションには特有の問題があります。セッションが長くなりすぎると、古いメッセージを要約(Compaction)するか、新しいセッションを開始することになると投稿は述べています。そして重要な一文が続きます。「どちらのアプローチも詳細を失うため、永続化が必要なものは途中でMemoryに保存されるべきです。」
これが、これらのエージェントを構築または使用するすべての人にとってのコアな設計原則です。要約はセッションを継続させるための手段であり、記憶するための手段ではありません。来月になっても重要な決定事項であれば、要約によってサマリーに残ることを期待するのではなく、要約される前にMemoryに保存されるべきです。
パーミッション:リスクの所在
MemoryはAlways-on Agentを便利にします。パーミッションは、それがどれほどのダメージを与えうるかを決定します。Anthropicは率直です。「パーミッションは、Always-on Agentが最も大きなリスクを抱える場所です。」
投稿では3つのコンポーネントを説明しています。
- 認証情報ストア(Credential store)。 推奨されるパターンは、エージェントの環境外にあるプロキシが送信リクエストに認証情報を追加することです。これにより、エージェントは本物の認証情報を持たずにリクエストを送信します。
- オートモード(Auto mode)。 AnthropicはClaude Codeのオートモードを例に挙げています。これは分類器を使用してリスクの高いアクションをレビューし、危険と判断されたものをブロックします。最も重要な決定には、依然としてユーザーのレビューが必要です。
- 遅延ツール呼び出し(Deferred tool calls)。 エージェントが承認を必要とする場合、Runは終了し、セッションは呼び出しの途中で保存されます。リクエストはユーザーに送られ、その回答がイベントとして戻ってくると、新しいRunが開始され、保存されたセッションが再開されます。
Memoryにとって、この遅延パターンは重要です。返信によって作業が停止した場所から再開するためには、保存されたセッションとMemoryファイルが永続的である必要があります。
アウトボックスとエージェントが話すべき量
Always-on Agentはいつ話すべきかを自分で決めます。Anthropicは、ほとんどのAlways-on Agentはメッセージを直接届ける送信ツールだけで事足り、正式なアウトボックスが必要になるのは、メッセージのペースを調整したり、エラーから回復したりしたい場合のみであると述べています。
量については、現実的なガイダンスがあります。メッセージを送りすぎるエージェントはノイズになり、少なすぎるエージェントは見落としを発生させます。投稿の推奨事項はこうです。「実際には、エージェントは最初は静かに始め、時間の経過とともにユーザーの注意をより多く獲得していくのが良いでしょう。」
「過去のメッセージ」というMemoryタイプがこれをサポートします。
人々が最初に間違えること
エージェントが常に動いていると思い込む。 ほとんどの時間は眠っており、イベントやタイマーで起きます。
記憶をセッションに頼る。 新しいセッションは、コンテキストのオーバーヘッドとトリガーイベントのみで始まります。
要約(Compaction)をMemoryとして扱う。 Anthropicは、要約も新しいセッションも詳細を失うと述べています。
すべてを保存する。 Memoryには、エージェントが再度検索できないものだけを保持すべきです。
指示を会話の中に留める。 ユーザーの指示は専用のファイルに属し、すべてのRunの開始時にロードされるべきです。
解決策:Always-on Agentに信頼できるMemoryを与える
ステップ1:4つの種類を分ける
ユーザーの指示、ユーザーノート、過去のメッセージ、タスクの進捗を別々のファイルまたはレコードに保持し、それぞれを個別にロードまたは更新できるようにします。
ステップ2:コピーではなくポインタを保存する
他のシステムに存在するものは、それがどこにあるかを記録します。他には存在しない事実だけを保持します。
ステップ3:セッションが終わる前に保存する
決定事項や進捗は、要約や新しいセッションによって失われる前、つまりRunの最中にMemoryに書き込みます。
ステップ4:共有パーツを一箇所にまとめる
エージェントやツールをまたいで適用される指示や好みは、それぞれに対して書き直すべきではありません。自分で管理するストアに保管してください。
MemoryLakeでのセットアップ
Anthropicの投稿では、自分で構築するエージェントのためのMemoryについて説明されています。また、ChatGPT、Claude Code、Codexなど、すでに使用しているアシスタント全体で同じもの、つまりすべてのツールが開始時に参照すべき指示、好み、プロジェクトの決定事項を、単一のセッション以外の場所に保持したい場合もあるでしょう。
MemoryLake は、そのような作業コンテキスト(指示、好み、決定事項など)のためのMemoryレイヤーであり、自分で管理する一箇所に保管され、接続したアシスタントから利用可能です。
エントリは自分の言葉で自分で書きます。エージェントのMemoryディレクトリ、セッションやトランスクリプト、Claude Codeの自動Memory、Messages APIのMemoryツール、あるいはベンダーのストアから読み取られたり、そこに書き込まれたり、削除されたりすることはありません。Always-on Agent、セッション、要約は、Anthropicが説明した通りに機能します。
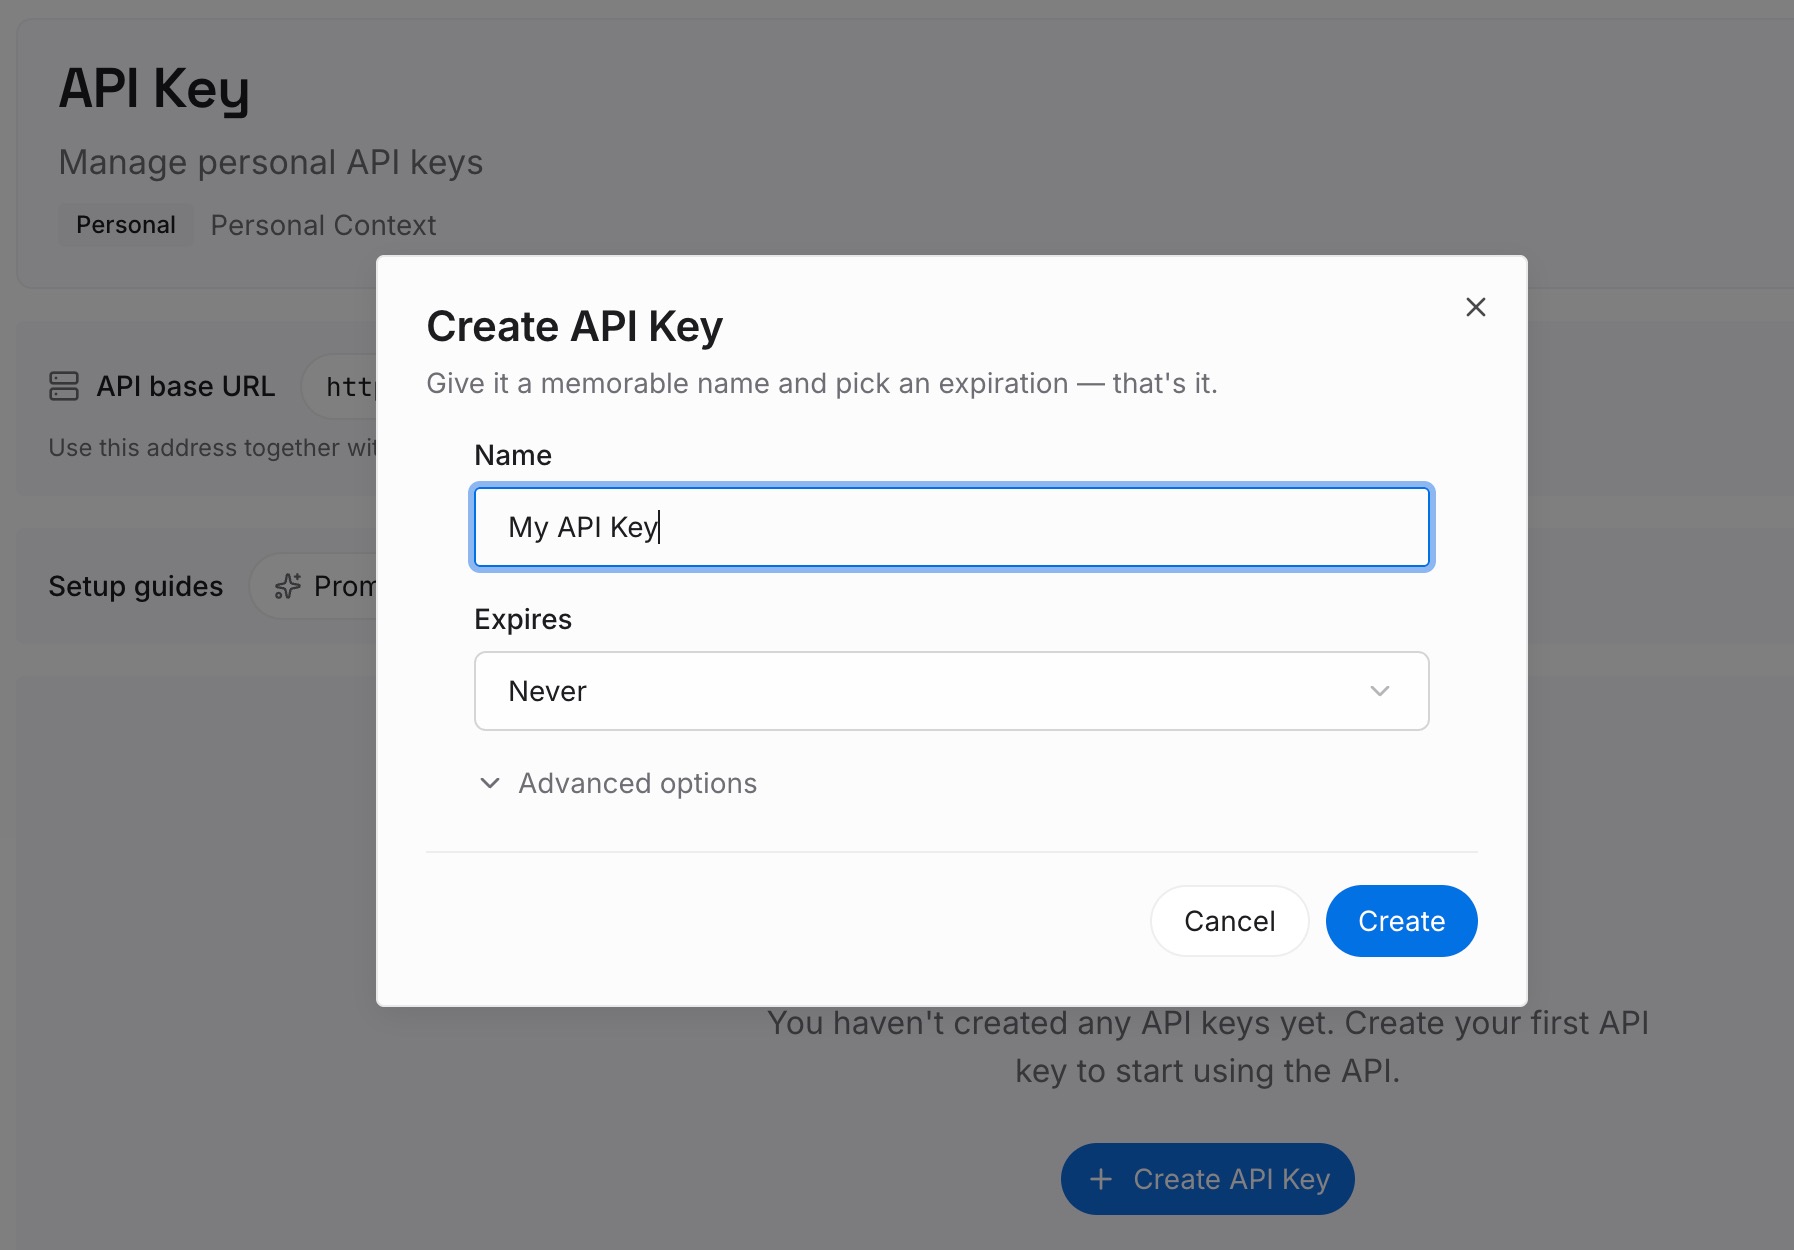
ステップ1:APIキーを作成する
サインインしてダッシュボードからキーを生成します。エージェントの作業ファイルの外にある、他の認証情報と一緒に保管してください。
ステップ2:最初のMemoryをアップロードする
解決策のステップ1にある、ツール間で適用される4つの種類から始めましょう。恒久的な指示、アシスタントがあなたについて知っておくべきこと、進行中のプロジェクトが依存する決定事項などです。1つのエントリにつき1つの指示または決定事項にします。
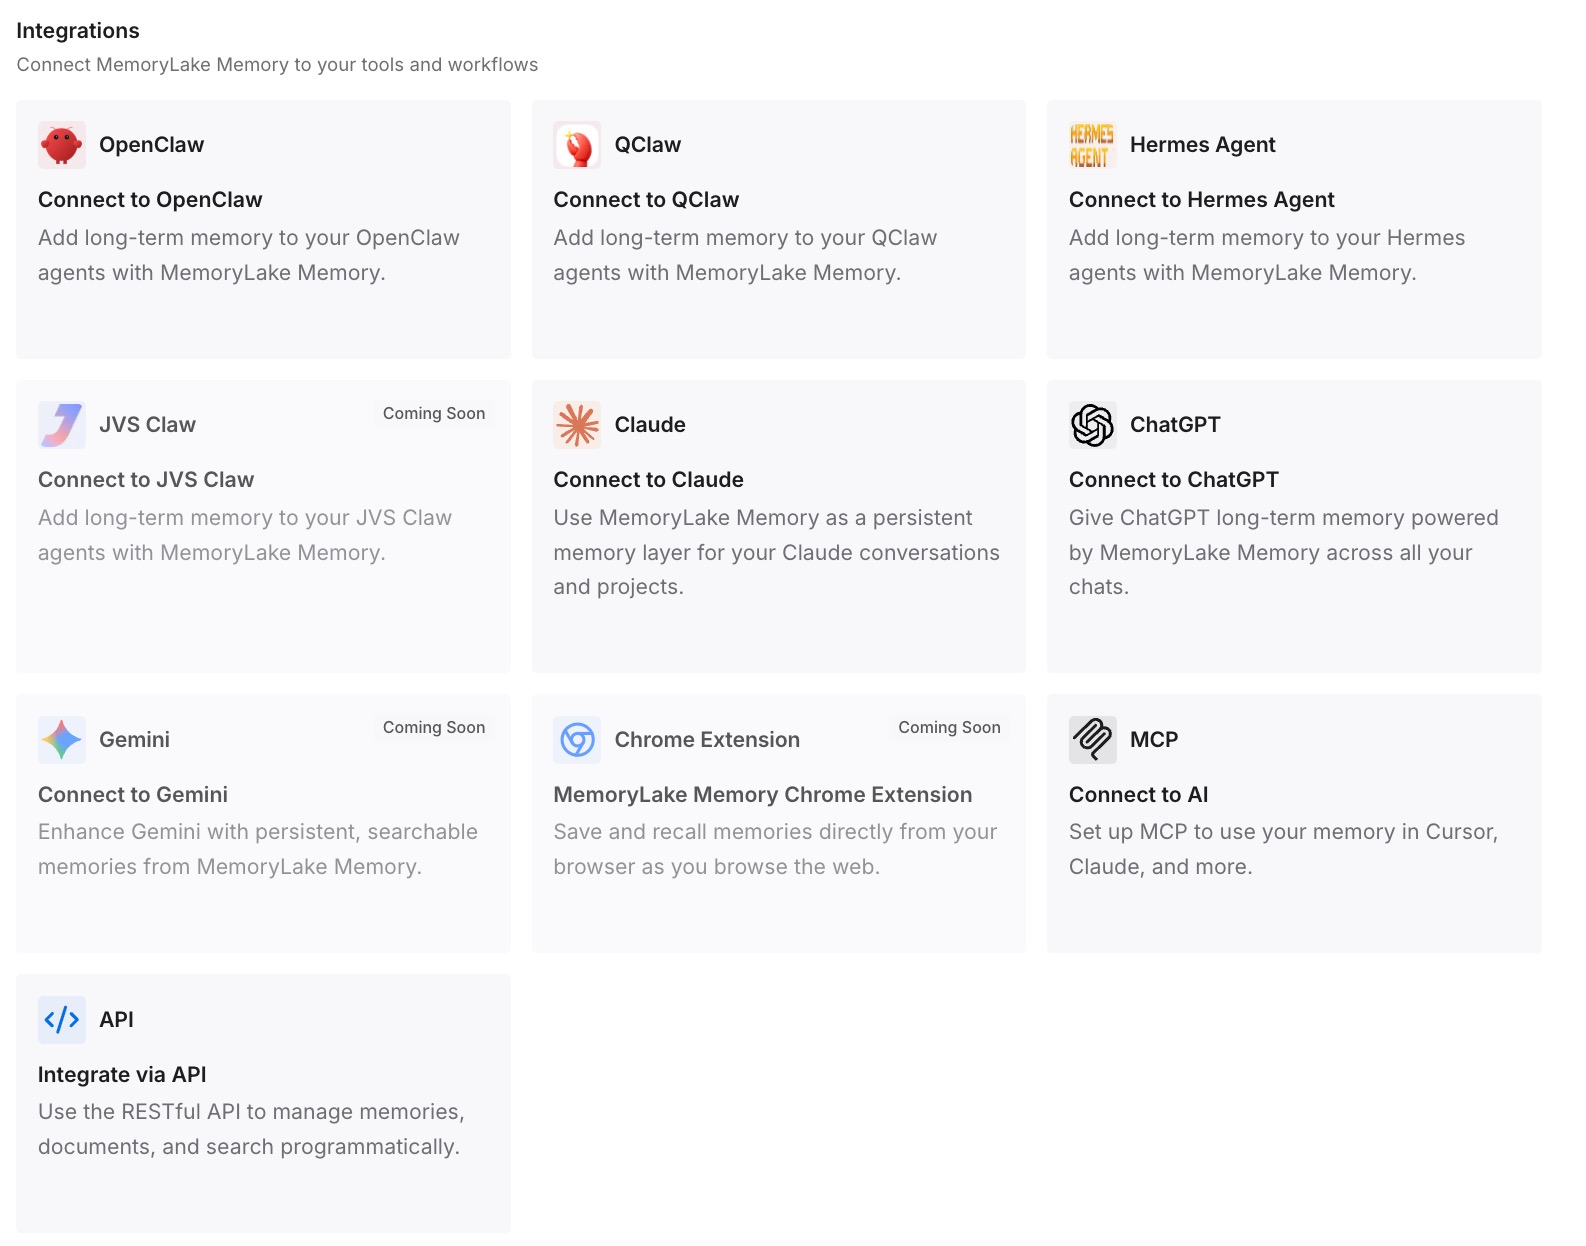
ステップ3:AIとエージェントを接続する
ChatGPT、Claude Code、Codex、または使用している他のアシスタントを接続します。それぞれが同じエントリを利用できるため、新しいセッションはあなたが書き留めたコンテキストから始まります。
実務で何が変わるか
第一の違いは、新しいセッションが「白紙」ではなくなることです。依存している指示や決定事項は、トランスクリプトに残されるのではなく、書き留められています。
第二に、繰り返しが減ります。各アシスタントに好みを説明し直す必要はなく、セッションが要約された後に説明し直す必要もありません。
第三に、Memoryと記録の境界線が明確になります。ツールは独自のデータを保持し、共有コンテキストはあなたが修正可能な一箇所に置かれます。
Always-on Agentのベストプラクティス
スリープを前提に設計する。 各Runは、Memoryとトリガーイベントが提供するものだけで始まると想定してください。
毎回のRunで指示をロードする。 あなたが見ていないときでも適用されるよう、専用のファイルに保持してください。
Memoryをスリムに保つ。 すべての行が毎回のRunでロードされるため、他にあるものはポインタを保存してください。
話した内容を追跡する。 過去のメッセージの記録により、プロアクティブなエージェントが同じことを繰り返すのを防ぎます。
進捗を随時書き込む。 進捗ファイルにより、次のRunが最初からやり直すのではなく、継続できるようになります。
決定事項を要約(Compaction)に任せない。 セッションが要約される前に、永続化が必要なものはすべて保存してください。
静かに始める。 時間をかけて、エージェントがユーザーの注意をより多く獲得できるようにします。
結論
Always-on Agentは常に動いているわけではありません。Anthropicの説明によれば、彼らは眠り、イベントやタイマーで起き、短いRunを行い、何が起こったかを保存します。それを支えるのが、イベントインボックス、タイマー、Memory、パーミッション、アウトボックスという5つのプリミティブです。
Memoryこそが、Runを連続したものに感じさせる要素です。Anthropicは、ユーザーの指示、ユーザーノート、過去のメッセージ、タスクの進捗という4つの種類を推奨しています。これらは永続的に保存され、エージェントが再度検索できないものだけを保持するようにスリムに保たれるべきです。新しいセッションはわずかなコンテキストで始まり、要約は詳細を失うため、永続化が必要なものはすべてRunの最中にMemoryに書き込まれるべきです。