
用語の由来
YCの2026年夏季Requests for Startupsには、「Company Brain」というタイトルの項目が含まれています。それは、何がAIの進歩を妨げているのかという主張から始まります。「企業のAI自動化における最大の障害は、もはやモデルではありません。モデルは非常に短期間で非常に優れたものになりました。現在の障害はドメイン知識です。」
この項目では、問題を日常的な言葉で説明しています。「どの企業にも、重要なノウハウがあらゆる場所に散らばっています。あるものは人々の頭の中にあり、あるものは古いメールアカウント、Slackのスレッド、サポートチケット、データベースの中に埋もれています。」そして、なぜそれが人間には機能し、エージェントには機能しないのかを説明しています。「会社が機能しているのは、人間がその知識がどこにあり、どのように適用すべきかを漠然と覚えているからです。」
その結論はこうです。「しかし、AIエージェントはそのようには動作できません。すべての企業をAI自動化で運営したいのであれば、新しいプリミティブ、すなわち『Company Brain』が必要です。」
Company Brainとは何か
YCの項目では、これを「これらすべての断片化されたソースから知識を引き出し、構造化し、最新の状態に保ち、AI用の実行可能なスキルファイルに変換するシステム」と定義しています。
この一文には4つの動詞があり、それぞれが独立したタスクです。
- 知識を引き出す(Pull knowledge out): メール、チャット、チケット、ドキュメント、データベースから知識を見つけ出す。
- 構造化する(Structure it): 散らばった記述を整理されたものに変える。
- 最新の状態に保つ(Keep it current): 会社の変化に合わせて更新する。
- AIで利用可能にする(Make it usable by AI): 項目にある言葉を借りれば、「実行可能なスキルファイル」にする。
最後のステップの目的は、検索ではなく「実行」です。「そうすれば、AIシステムはそのスキルファイルを使用して、実際に安全かつ一貫して業務を遂行できるようになります。」
既存ツールとの違い
この項目では、既存のツールとの違いを明確に述べています。「これは全社的な検索システムや、ドキュメントに対するチャットボットではありません。返金がどのように処理されるか、価格の例外がどのように決定されるか、エンジニアがインシデントにどのように対応するかといった、会社がどのように機能しているかを示す『生きた地図』なのです。」
検索はドキュメントを見つけます。Company Brainは、誰も書き留めていない部分を含め、「物事がどのように行われるか」を捉えることを目的としています。
Company Brainが記憶すべきこと
YCの項目にある3つの例は、ドキュメントでは見つけにくい3種類の知識を指し示しています。
物事がどのように行われるか(How things get done)
返金がどのように処理されるかは「手順」です。その一部はポリシーページにあります。しかし、その多くは「どのケースを誰に回すか」「最初に何をチェックするか」「何が例外として認められるか」といった実務の中にあります。
意思決定がどのようになされるか(How decisions get made)
価格の例外がどのように決定されるかは「判断」です。それは前例、誰に権限があるか、そして古いスレッドにしか存在しないかもしれない理由に依存します。Company Brainは、決定事項とその理由を捉えなければなりません。そうでなければ、エージェントはそれを次のケースに適用できません。
人々がどのように対応するか(How people respond)
エンジニアがインシデントにどのように対応するかは「プレッシャー下での実務」です。ランブックは役立ちますが、実際の対応は、どのシステムが故障しやすいか、誰を呼び出すべきかを知っていることにも依存します。
出典(Where it came from)
これら3つの根底にあるのが「プロバナンス(由来)」です。出典のない事実は信頼しにくく、修正も困難です。この分野のオープンソースプロジェクトは、これを明示しています。YCの項目がモデルとして挙げているオープンソースのブレインプロジェクトであるGBrainは、「出典を伴う明示的な事実」を保存し、「修正と撤回」をサポートし、「エージェント間で同じmemoryを利用可能にする」と述べています。
誰が最新の状態に保つのか
「最新の状態に保つこと」は、定義の中で最も短い部分ですが、実現するのが最も難しい部分です。価格、オーナー、ポリシー、システムなど、企業は絶えず変化します。3月時点で正確だったCompany Brainは、10月にはエージェントを誤らせる可能性があります。
鮮度を維持するには、次の3つが必要です。
- 修正(Corrections): 事実が間違っている場合、それを修正する方法が必要であり、修正された内容が古いバージョンよりも優先されなければなりません。
- 撤回(Withdrawal): 事実が適用されなくなった場合、単に新しい事実を上書きするのではなく、それを引退させる方法が必要です。
- 日付(Dates): 事実がいつ記録されたかを知ることで、エージェントも人間も、それをどの程度信頼すべきかを判断できます。
誰かがこれに責任を持つ必要があります。抽出によって知識を見つけることはできますが、どのバージョンが最新かを判断するのは「判断」であり、それはプロセスを運営する人々に属します。エージェントのmemoryは、保持する量を減らすことでより正確になったという私たちの考察では、追加することと同じくらい剪定(プルーニング)が重要である理由を説明しています。
AI memoryの役割
チームがmemory機能を持つアシスタントを使用している場合、それぞれの種類が何を保持しているかを理解することが役立ちます。なぜなら、それら単体ではCompany Brainにはならないからです。
各アシスタント内のパーソナルmemory
ChatGPTやClaudeは、それを使用している個人に関する事項を記憶します。そのmemoryはアカウント単位です。ClaudeのTeamプランについて、Anthropicは「個々のTeamプランメンバーは、自分のmemory設定を直接管理する」と述べています。ある人のアシスタントが学習した内容は、同僚のアシスタントで自動的に利用できるわけではありません。
コーディングエージェントもmemoryを保持します。Claude Codeの自動memoryはマシンローカルです。Anthropicは、そのファイルは「マシンやクラウド環境間で共有されない」と述べています。Codexはローカルのmemoryをホームディレクトリに保存します。OpenAIのアドバイスは直接的です。「memoryは、常に適用されなければならないルールの唯一のソースとしてではなく、役立つ想起レイヤーとして扱ってください。」
リポジトリ内の指示ファイル
エンジニアリングの知識については、チームはすでに共有レイヤーを持っています。AGENTS.mdやCLAUDE.mdなど、リポジトリにチェックインされたファイルです。OpenAIのガイダンスでは、「チームに必要なガイダンスはAGENTS.mdやチェックインされたドキュメントに保持する」よう推奨しています。これらのファイルは共有され、バージョン管理され、レビュー可能です。これは、一つのリポジトリにおいてCompany Brainが必要とする要素の大部分を満たしています。リポジトリの枠外にある意思決定については、ChatGPTがアーキテクチャの決定を忘れる理由についてのガイドで、何が失われがちかを解説しています。
人とエージェントを横断する共有レイヤー
欠けているピースは、人、ツール、プロジェクトを横断して存在するレイヤーです。GBrainのREADMEには、有用な境界線が引かれています。「永続的な設定や事実はエージェント間で共有でき、一時的なタスクやハーネスの設定状態はローカルに留まる。」Company Brainとは、この「永続的で共有される部分」のことです。マルチエージェントシステム向けの共有memoryソリューションのリストでは、そのレイヤーへのアプローチを比較しています。
Company Brainの信頼性を支えるもの
エージェントがCompany Brainに基づいて行動する場合、その間違いはエージェントの間違いになります。それが許容可能かどうかは、次の4つの特性で決まります。
- プロバナンス(Provenance): すべての事実が、その由来まで遡れること。
- スコープ(Scope): 人やエージェントが、閲覧を許可されたものだけを見ること。例えばGBrainのREADMEには、「認証されたリモートクライアントは、ソースと操作の許可、および可視性フィルターによって制限される」とあります。
- 鮮度(Currency): 事実に日付が付与されており、古い事実は修正または撤回されていること。
- レビュー可能性(Reviewability): 人間が保存内容を読み、変更できること。
- これらは、あらゆる共有memoryを役立たせるための特性と同じです。コンテキストエンジニアリングに関するガイドでは、エージェントが受け取るコンテキスト(上下文)が、モデルそのものと同じくらい重要である理由を説明しています。
人々が最初に試してしまうこと
すべてをインデックス化して「ブレイン」と呼ぶ。 それは単なる全社検索です。YCの項目では、これを明確に否定しています。
各個人のアシスタントのmemoryに頼る。 パーソナルmemoryはアカウントやマシン単位です。それは共有された知識にはなりません。
抽出を仕事のすべてだと考える。 知識を引き出すのは最初のステップに過ぎません。最新の状態に保つことが継続的な仕事です。
プロバナンスをスキップする。 出典のない事実は信頼しにくく、修正はさらに困難です。
会社全体から始める。 一度にすべてを対象に構築されたブレインは、具体性を保つのが困難です。一つのプロセスをうまくやり遂げることで、何が機能するかが分かります。
解決策:最新状態を維持できる一つのプロセスからCompany Brainを始める
ステップ1:一つのプロセスを選び、それが実際にどう機能しているかを書き出す
エージェントや新人が間違え続けているプロセスを一つ選んでください(返金、特定の例外処理、インシデント対応など)。人々の頭の中にある部分も含め、それが実際にどのように機能しているかを書き出します。そのプロセスを運営している人々に聞いてください。
ステップ2:決定事項を理由と日付とともに記録する
そのプロセスにおける判断について、それぞれの決定、なぜその決定がなされたか、誰が、いつ行ったかを記録します。これらはエージェントが推論できない事実です。Claudeに永続的なドメイン知識を与えるためのガイドでは、アシスタントのためにこの種の知識をどのように構造化するかを解説しています。
ステップ3:オーナーとレビューのサイクルを割り当てる
そのプロセスを最新の状態に保つ責任者を一人決めます。変化した事実は修正し、適用されなくなった事実は撤回し、すべての更新に日付を入れます。もし知識がグループチャットから始まるのであれば、ChatGPTのグループチャットを共有プロジェクトに移行するガイドが、知識の「家」を作る一つの方法を示しています。
MemoryLakeでのセットアップ
YCが提唱する意味でのCompany Brainは巨大なシステムです。チームが今日から始められる部分はもっと小さく、特定のアカウントやツールに縛られない、出典と日付を備えた「人々やエージェントが必要とし続ける事実と決定事項」の共有・維持リストです。
MemoryLakeは、そのリストを一箇所で維持し、ChatGPT、Claude Code、Codexなどの接続されたアシスタントから利用できるようにするためのmemoryレイヤーです。
エントリはあなた自身の言葉で作成します。メール、チャットツール、チケット、アシスタントのmemory、あるいはベンダーのストレージから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。MemoryLakeは、あなたが記録することを選択した内容のみを保持します。システムから知識を勝手に抽出することはありません。
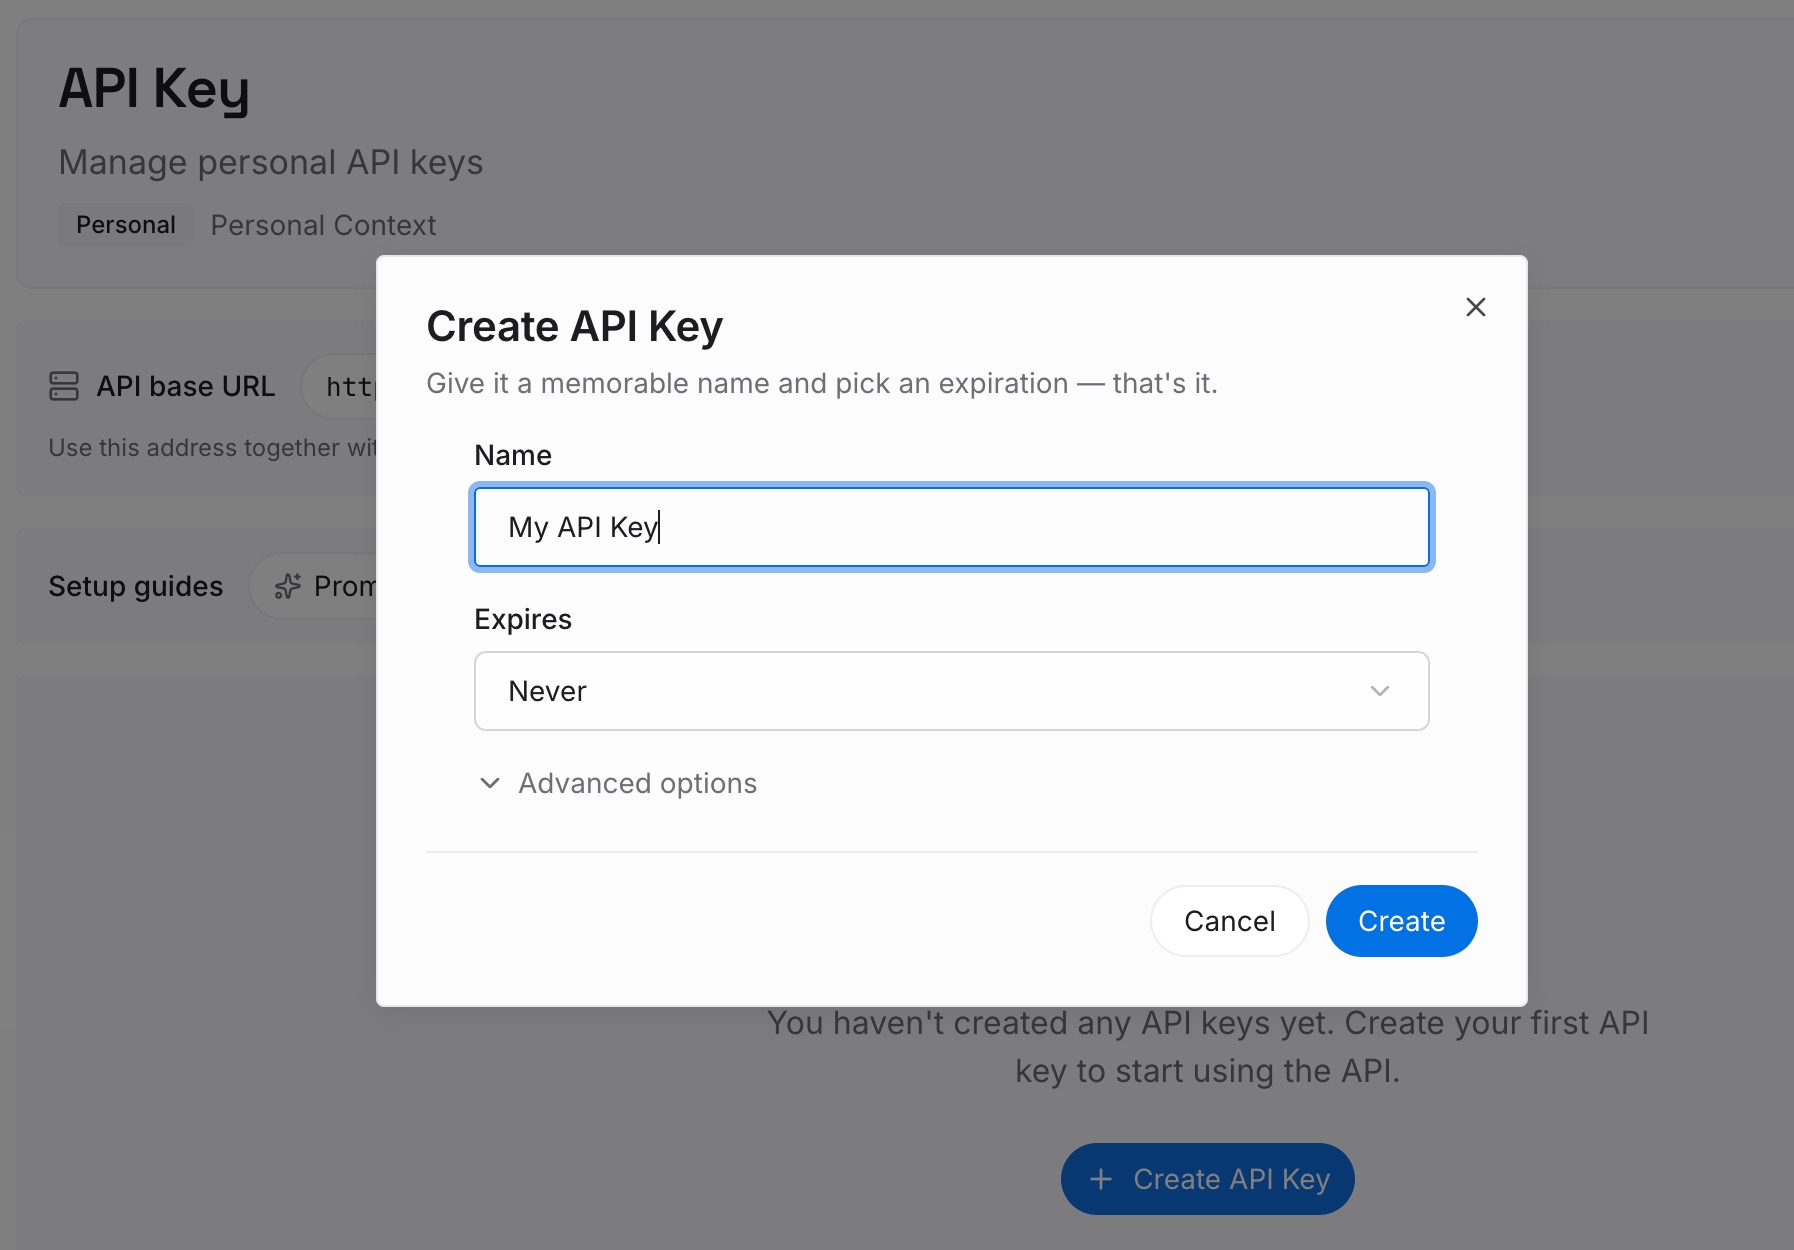
ステップ1:APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーはMemoryLakeのワークスペースに属し、他のアカウントとは独立しています。
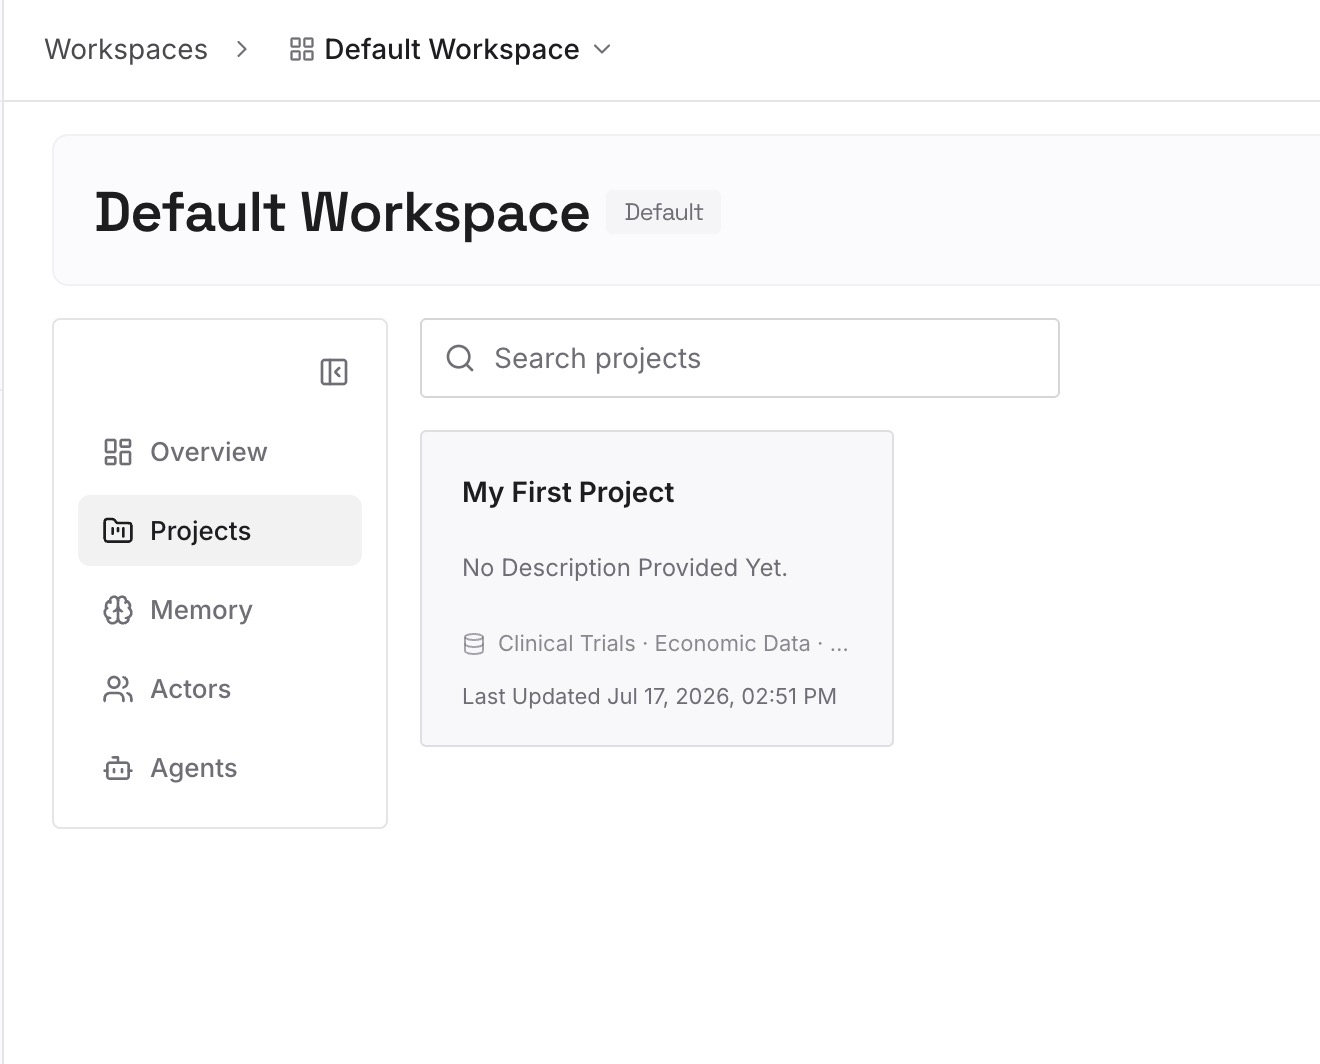
ステップ2:最初のmemoryをアップロードする
「解決策」のステップ1のプロセスと、ステップ2の決定事項から始めます。1エントリにつき1ポイント、出典と日付を添え、組織のポリシーで許可されている内容のみを保存します。
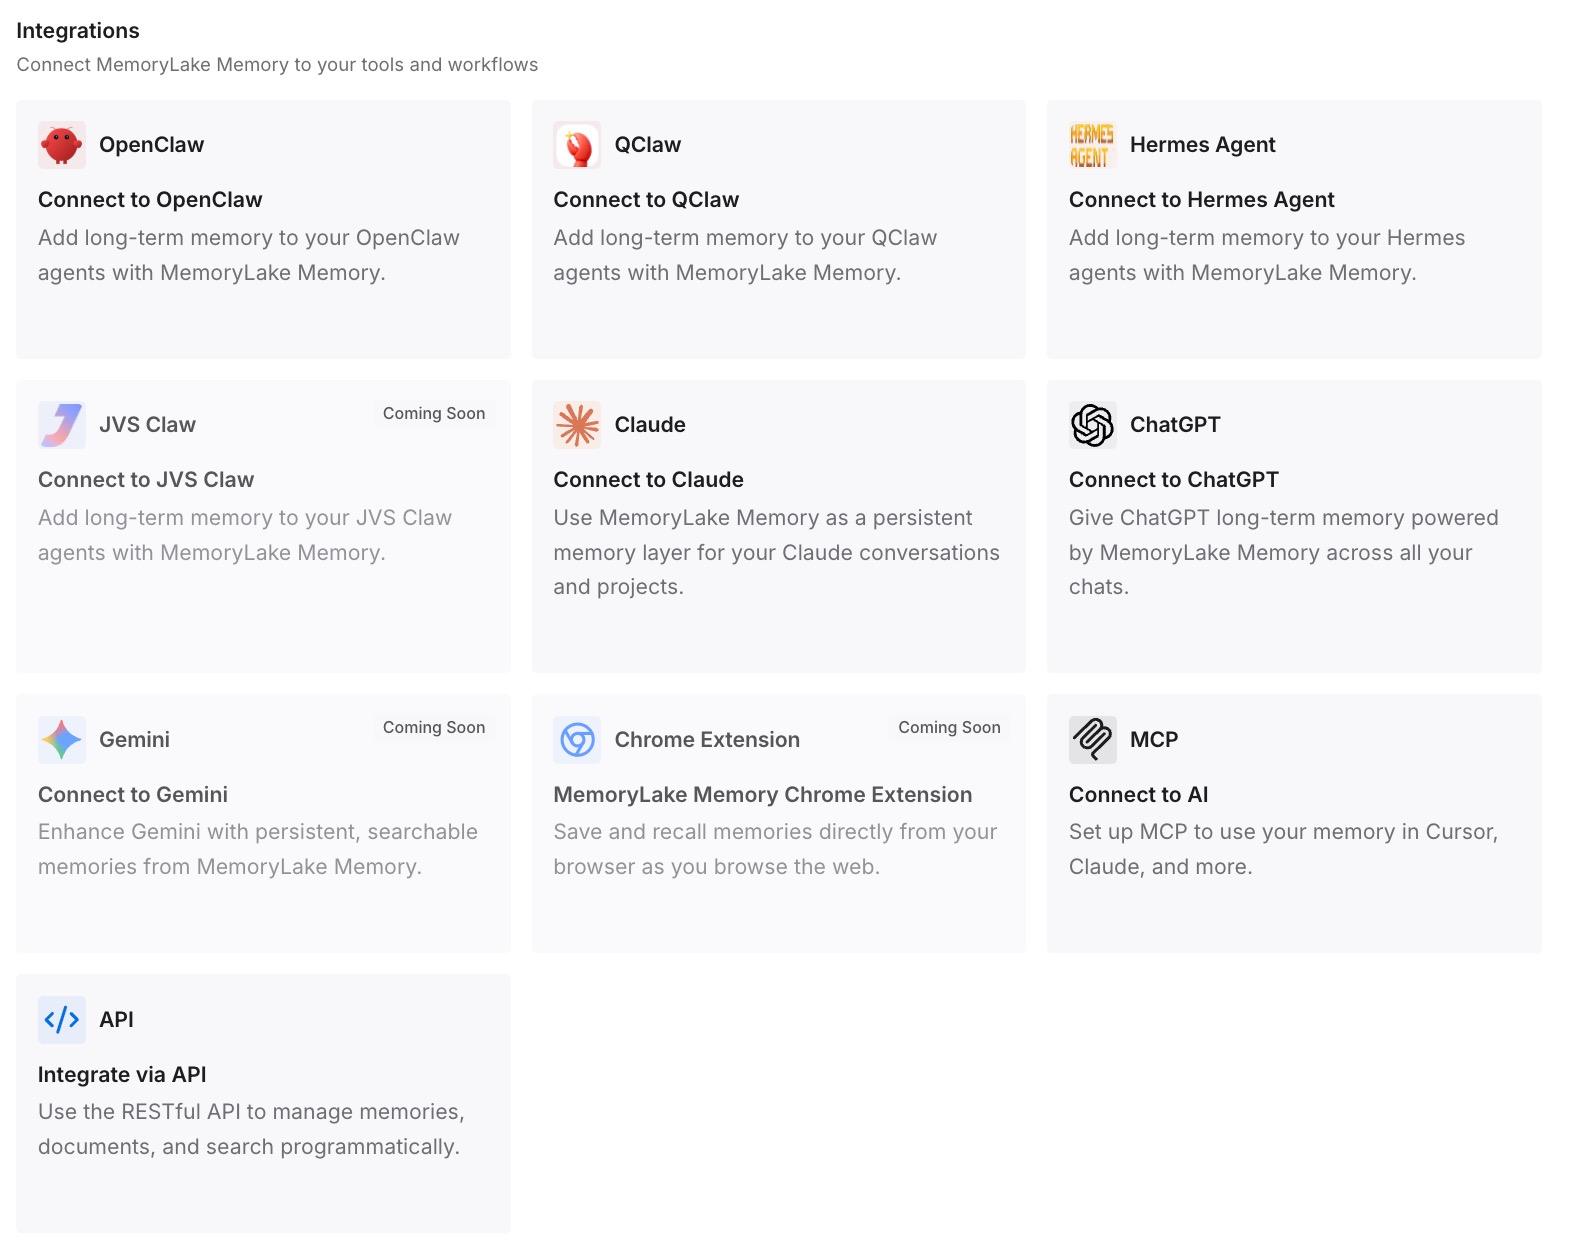
ステップ3:AIとエージェントを接続する
チームが使用しているアシスタントを接続します。維持管理された同じ事実が各アシスタントで利用可能になり、ステップ3で決めたオーナーが一箇所でそれらを最新の状態に保ちます。
実務で何が変わるのか
第一の違いは、用語の明確化です。Company Brainは検索ではなく、ドキュメントに対するチャットボットでもありません。それは、会社がどのように機能するかについての「維持された知識」です。
第二に、現実的な出発点が得られます。決定事項、出典、日付とともに書き出された一つのプロセスは、すべてを捉えようとする曖昧な計画に勝ります。
第三に、鮮度の維持にオーナーが決まります。定義の中で最も困難な「最新の状態に保つこと」が、誰の仕事でもない状態から、誰かの仕事になります。
Company Brain構築のベストプラクティス
一つのプロセスから始める。 拡大する前に、それが機能することを証明する。
ドキュメントだけでなく決定事項を捉える。 理由こそが、エージェントが推論できない部分である。
すべての事実にソース(出典)を付ける。 プロバナンスがあるからこそ、修正が可能になる。
すべてのエントリに日付を入れる。 鮮度は、いつその事項が真実であったかを知ることに依存する。
古くなったものは撤回する。 新しい事実を上に重ねるだけではいけない。
スコープを尊重する。 すべての事実が、すべての人間やエージェントの目に触れるべきではない。
リポジトリのルールはリポジトリに置く。 共有指示ファイルは、コードに関してはすでに機能している。
結論
Company Brainとは、会社が実際にどのように機能しているかを捉え、その知識を最新の状態に保ち、AIが利用できるようにするシステムです。YCの2026年夏季Requests for Startupsはこの用語を広め、全社検索やドキュメント用チャットボットとは異なるものとして定義し、手順、意思決定、対応を保持すべき内容として挙げました。
今日のアシスタントのmemoryは、この一部をカバーしています。アカウントごとのパーソナルmemory、マシンごとのローカルmemory、リポジトリごとの指示ファイルです。欠けているレイヤーは、共有され、維持され、出典が明らかなものです。一つのプロセスから始め、その決定事項を理由と日付とともに記録し、誰かにそれを最新の状態に保つ役割を与えてください。