
簡潔な回答
コンテキストエンジニアリングとは、言語モデルの作業の各ステップにおいて、モデルにどのような情報(指示、ツール、例、取得されたドキュメント、会話履歴、記憶など)を届けるかを決定し、必要なものだけを過不足なく提供する実践のことです。プロンプトエンジニアリングはその一部にすぎません。作業が複数のセッションにまたがる場合、コンテキストの供給元となるのが「記憶(memory)」です。
この用語の起源
Anthropicのエンジニアリングチームは、2025年9月の投稿で最も明確な定義の1つを示しました。「Anthropicでは、コンテキストエンジニアリングをプロンプトエンジニアリングの自然な進化と捉えています。」彼らによると、プロンプトエンジニアリングとは指示を記述し整理することです。一方、コンテキストエンジニアリングは「LLMの推論中に、プロンプトの外部から入り込む可能性のある他のすべての情報を含め、最適なトークン(情報)のセットを厳選し維持するための一連の戦略を指します。」
このシフトが起きたのは、エージェントがループ内で動作するためです。同投稿では、「ループで実行されるエージェントは、次の推論ターンに関連する可能性のあるデータをますます多く生成するため、この情報を循環的に洗練させる必要があります」と説明されています。これにより、作業は継続的なものになります。「コンテキストエンジニアリングとは、絶えず進化する可能性のある情報の宇宙から、限られたコンテキストウィンドウに何を入れるかを厳選する技術であり科学です。」
したがって、両者の違いは範囲とタイミングにあります。プロンプトエンジニアリングは会話の前に一度だけ行うものです。コンテキストエンジニアリングは、エージェントが次に何を見るべきかを決定するたびに発生します。
エージェントのコンテキストに含まれるもの
Anthropicは、エージェントが扱う要素として「システム指示、ツール、Model Context Protocol (MCP)、外部データ、メッセージ履歴など」を挙げています。実際には、ほとんどのエージェントは5種類のコンテキストを利用します。
指示(Instructions)。 システムプロンプトに加え、コーディングエージェントがセッション開始時に読み込む CLAUDE.md や AGENTS.md などのファイル。
ツール(Tools)。 エージェントができることの定義であり、これ自体もスペースを消費します。Anthropicは、「私たちが目にする最も一般的な失敗パターンの1つは、機能が多すぎる肥大化したツールセットや、どのツールを使用すべきかについて曖昧な決定ポイントを招くツールセットです」と警告しています。
例(Examples)。 例外的なケースを網羅したリストではなく、標準的な例の小さなセット。
取得された情報(Retrieved information)。 必要に応じて引き込まれるドキュメント、検索結果、データ。
履歴と記憶(History and memory)。 このセッションで以前に何が起こったか、そして過去のセッションで何が学ばれたか。
優れたコンテキストエンジニアリングとは、主にこれらの一貫したバランスを保つことです。Anthropicの指導原則は、「優れたコンテキストエンジニアリングとは、望ましい結果の可能性を最大化する、シグナルの高いトークンの最小限のセットを見つけることである」というものです。
コンテキストを増やすだけでは解決しない理由
コンテキストウィンドウが大きくなれば、これらすべてが不要になると考えがちです。しかしAnthropicは、彼らが「コンテキストの劣化(context rot)」と呼ぶ現象を指摘して、これに反論しています。「コンテキストウィンドウ内のトークン数が増えるにつれて、そのコンテキストから情報を正確に思い出すモデルの能力は低下します。」彼らの結論は、「したがって、コンテキストは限界収益が逓減する有限の資源として扱われなければならない」というものです。
Claudeデベロッパープラットフォームのコンテキスト編集に関するドキュメントでも、製品の観点から同じ点が指摘されています。「コンテキストは収益が逓減する有限の資源であり、無関係なコンテンツはモデルの集中力を低下させます。」さらに、Anthropicのエンジニアリング投稿では、「近い将来、あらゆるサイズのコンテキストウィンドウが、コンテキスト汚染や情報の関連性の懸念にさらされる可能性が高い」と付け加えられています。
Alibabaも企業側の視点から同じ結論に達しました。雲栖大会の基調講演では、企業のデータをエージェントにただ流し込むだけでは機能しないという議論がなされました。ウィンドウを過負荷にすると、エージェントがタスクに必要なスペースが無駄になるため、データはまずレイヤーに圧縮される必要があります。
これが、短いプロンプトだけではコストや品質の問題が解決しない理由でもあります。この点については、短いプロンプトだけでは不十分な理由で詳しく説明しています。問題は、送信する量がどれだけ少ないかではなく、送信するものが適切であるかどうかです。
1つのコンテキストウィンドウを超える作業のための3つの技術
長期にわたるタスクに対して、Anthropicは「圧縮(compaction)、構造化されたメモ作成(structured note-taking)、マルチエージェントアーキテクチャ」という3つのアプローチを説明しています。
圧縮(Compaction)。 「圧縮とは、コンテキストウィンドウの制限に近づいた会話を取り込み、その内容を要約し、その要約を使用して新しいコンテキストウィンドウを再開始する実践です。」これにより作業を継続できますが、既知のリスクがあります。「過度に積極的な圧縮は、後になって初めてその重要性が明らかになるような、微妙だが重要なコンテキストの喪失を招く可能性があります。」
構造化されたメモ作成(Structured note-taking)。 「構造化されたメモ作成、またはエージェント記憶(agentic memory)とは、エージェントがコンテキストウィンドウの外部にある記憶に永続化されるメモを定期的に書き込む技術です。これらのメモは、後でコンテキストウィンドウに引き戻されます。」ToDoリストや NOTES.md ファイルはそのシンプルなバージョンです。
サブエージェント(Sub-agents)。 「特化したサブエージェントは、クリーンなコンテキストウィンドウで焦点を絞ったタスクを処理し」、リードエージェントには凝縮された結果のみを返します。
これら3つすべてに共通する検索(retrieval)パターンもあります。エージェントは、最初からすべてを読み込むのではなく、「軽量な識別子(ファイルパス、保存されたクエリ、ウェブリンクなど)を維持し、ツールを使用して実行時にデータをコンテキストに動的にロードするためにこれらの参照を使用します。」Claude Codeは、Anthropic自身のハイブリッドな例です。「CLAUDE.md ファイルは最初にそのままコンテキストに投入されますが、globやgrepのようなプリミティブにより、環境をナビゲートしてジャストインタイムでファイルを取得できます。」
検索は記憶と同じではありませんが、この2つはしばしば混同されます。AIの記憶とRAGの比較では、その違いを詳しく説明しています。
なぜ「コンテキストこそがすべて」が企業の議論になったのか
2026年9月、コンテキストエンジニアリングはエンジニアリングブログから企業戦略へと移行しました。Alibaba Cloudは、同社のエージェント型クラウドを「モデル、ハーネス、コンテキストという3つのコアシナリオを中心に構築されている」と説明し、AIエージェントに「リアルタイムのコンテキストと長期記憶を提供する」Agent Contextサービスを開始しました。Qianwen Officeは、Enterprise Contextと呼ばれるコンパニオン製品を立ち上げました。これは、対象範囲が会社全体である場合のAIエージェント用コンテキストレイヤーの姿です。
Qianwen Officeの基調講演では、企業版の課題を「ビジネスを知らないエージェント」「個人に留まる有用なノウハウ」「データセキュリティへの懸念」の3つに分類しました。提案された解決策は、圧縮を中心に据えて、企業データを接続し、理解し、再利用可能にすることでした。
最も興味深い発言は、その後のインタビューから得られました。Qianwen OfficeのバイスプレジデントであるShu Junliang氏は、コンテキストは「最終的に使用するエージェントから切り離されている(decoupled)」とし、企業のコンテキストは「その企業に属していなければならない」と述べました。さらに、このインフラは「データベースのようにまだ標準化されていない」と付け加えました。
これは、すべてのコンテキストエンジニアが最終的に直面する原則の企業形態です。コンテキストはステップごとに組み立てられますが、それが組み立てられる元となる知識には所有者が存在し、その所有者がエージェントであることはほとんどありません。
記憶が適合する場所 — そしてなぜそれがエージェントよりも長生きしなければならないのか
コンテキストエンジニアリングは、ウィンドウに何を入れるかを決定します。作業が複数のセッションにまたがる場合、その情報の多くは記憶から提供されます。一部の著者は、この後半部分を「メモリエンジニアリング(memory engineering)」と呼んでいます。コンテキストエンジニアリングは推論時に機能し、記憶は時間を超えて機能します。
落とし穴は、今日のほとんどの記憶メカニズムが1つのツールまたは1つの場所に紐づいていることです。
Claude Codeの自動記憶(auto memory)は、明確な境界を持つ合理的な設計の良い例です。「自動記憶はマシンローカル」であり、「ファイルはマシン間やクラウド環境間で共有されません。」開発者向けのAnthropicの記憶ツールは、ユーザーに主導権を与えることでさらに一歩進んでいます。「記憶ツールはクライアント側で動作します。Claudeがファイル操作を要求し、アプリケーションがそれを実行します。独自のインフラを通じて、データがどこにどのように保存されるかを制御できます。」同じページで、その境界は「記憶は完全にアプリケーション内に存在します」と明確に述べられています。Anthropicのマネージドストアがこれにどのようにアプローチしているかは、Claudeエージェントのメモリ(記憶)ストアの解説で説明されています。
コンシューマー向けツールも独自の境界線を引いています。たとえばChatGPTでは、共有プロジェクトは「プロジェクト外の個々のメンバーのコンテキスト、カスタム指示、または記憶にアクセスできません。」
これらはどれも欠陥ではありません。それぞれの境界は、プライバシー、範囲、予測可能性など、何かを保護しています。しかし、これらが合わさることで、エージェントが必要とする知識は、使用するツールの数だけ散らばることになります。3つのエージェントを実行しているチームには、それぞれの製品のルールによって形成された3つの部分的な記憶が存在することになります。
これこそが、Alibabaのインタビューが指摘したギャップです。コンテキストがエージェントから切り離されるべきであるなら、それが利用する記憶も同様に切り離されるべきです。どのような種類の記憶が重要であるかは、AI記憶の6つのタイプで説明されている独自のテーマですが、ここでの実用的なポイントは、それらがどこに存在するべきかということです。
独自のAIエージェントにコンテキストエンジニアリングを適用する方法
始めるのにフレームワークは必要ありません。3つのステップで価値の大部分をカバーできます。
ステップ 1: 常設コンテキストと作業コンテキストを分離する
すべてのセッションが何から始まるべきかをリストアップします。誰のための作業か、規約、決定事項、どのモデルも推測できない定義などです。これが「常設コンテキスト(standing context)」です。次に、タスクの進行に伴って引き込まれるもの(ファイル、検索結果、最近の履歴など)をリストアップします。これが「作業コンテキスト(working context)」です。
常設コンテキストは指示と記憶に属します。作業コンテキストはジャストインタイムで取得されるべきです。この2つを混同することが、エージェントが重要な事実を見落としたり、無関係な事実に溺れたりする最も一般的な原因です。
ステップ 2: 常設コンテキストをレイヤーに圧縮する
まず短いインデックスを作成し、次にプロジェクト、決定、またはプロセスごとに1つのコンパクトなエントリを作成し、最後にソースドキュメントを配置します。新しい決定が古い決定を視覚的に置き換えるように、エントリに日付を付けます。例は網羅的ではなく、標準的なものにとどめます。
すべてを保存したいという衝動を抑えてください。より多くの記憶がエージェントに役立つかどうかは、AIエージェントにどれだけの記憶を与えるべきかで検証されている現在進行形の疑問です。
ステップ 3: すべてのエージェントがアクセスできる場所に常設コンテキストを保存する
これは、ほとんどのセットアップでスキップされるステップです。常設コンテキストが1つのツールの記憶に存在する場合、他のすべてのエージェントはそれなしで開始することになります。単一の製品の外側にあるレイヤーに保存し、2つの異なるエージェントに自分の作業について同じ質問をしてテストしてください。一方しか答えを知らない場合、コンテキストはそのツールの中に閉じ込められています。
MemoryLakeでのセットアップ
ステップ3では、エージェントではなくあなたに属する記憶レイヤーについて説明しています。MemoryLakeはそのタスクのために構築されています。単一のツールの外側に位置するAIエージェント用の長期記憶であり、一度設計した常設コンテキストを、使用するすべてのアシスタントで利用できるようにします。
エントリはあなた自身の言葉で記述します。Claude Codeの記憶ディレクトリ、エージェント独自のストア、またはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。
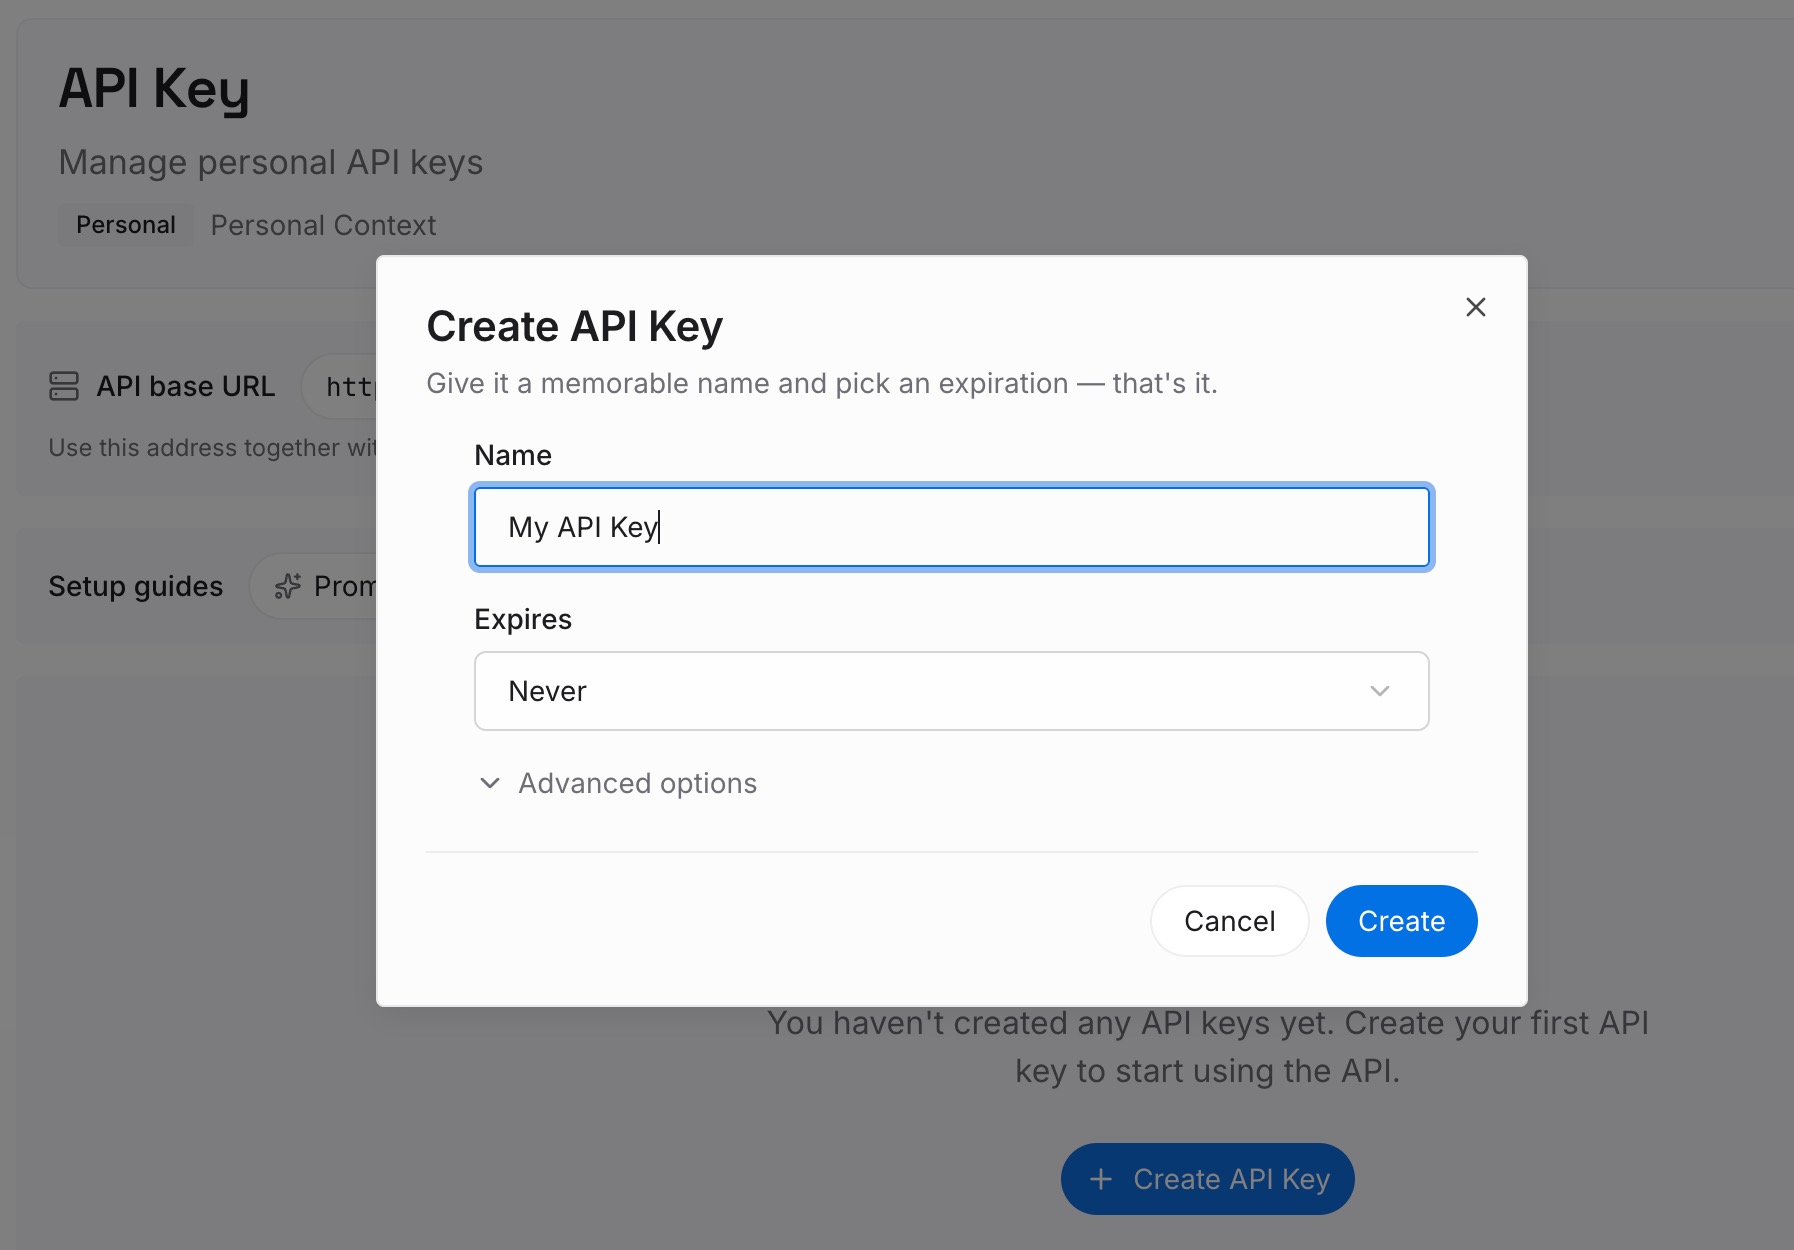
ステップ 1: APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーは、単一のエージェントやモデルから独立した、記憶レイヤー内のワークスペースに属します。
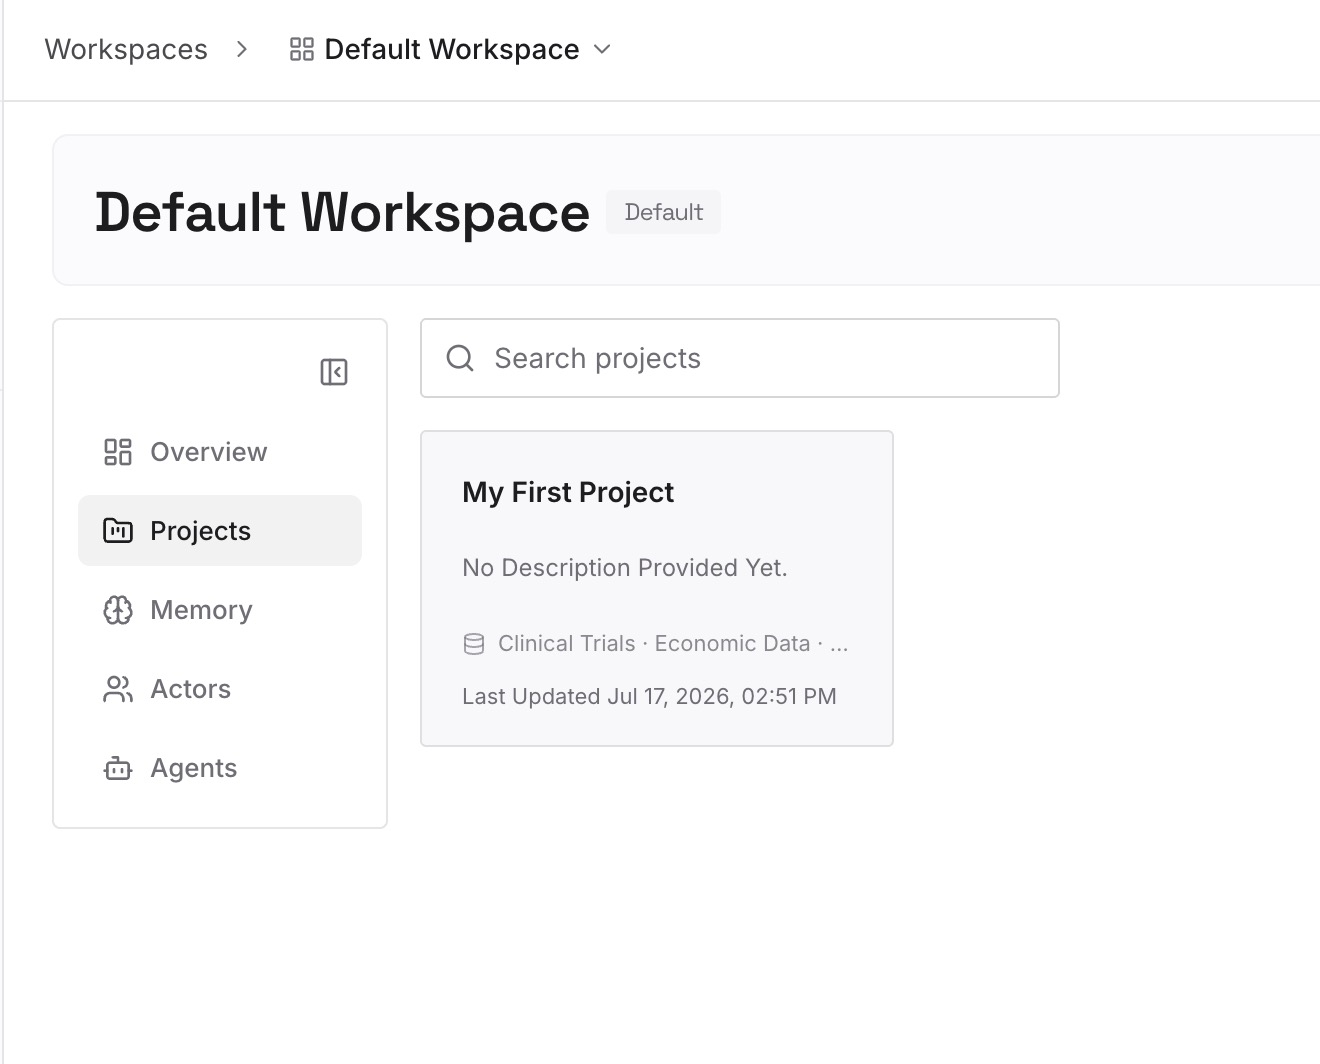
ステップ 2: 最初の記憶をアップロードする
ステップ1の常設コンテキストとステップ2のレイヤー化されたエントリ(定義、決定事項、規約など)から始めます。1つのエントリにつき1つの事実を、日付付きで登録します。
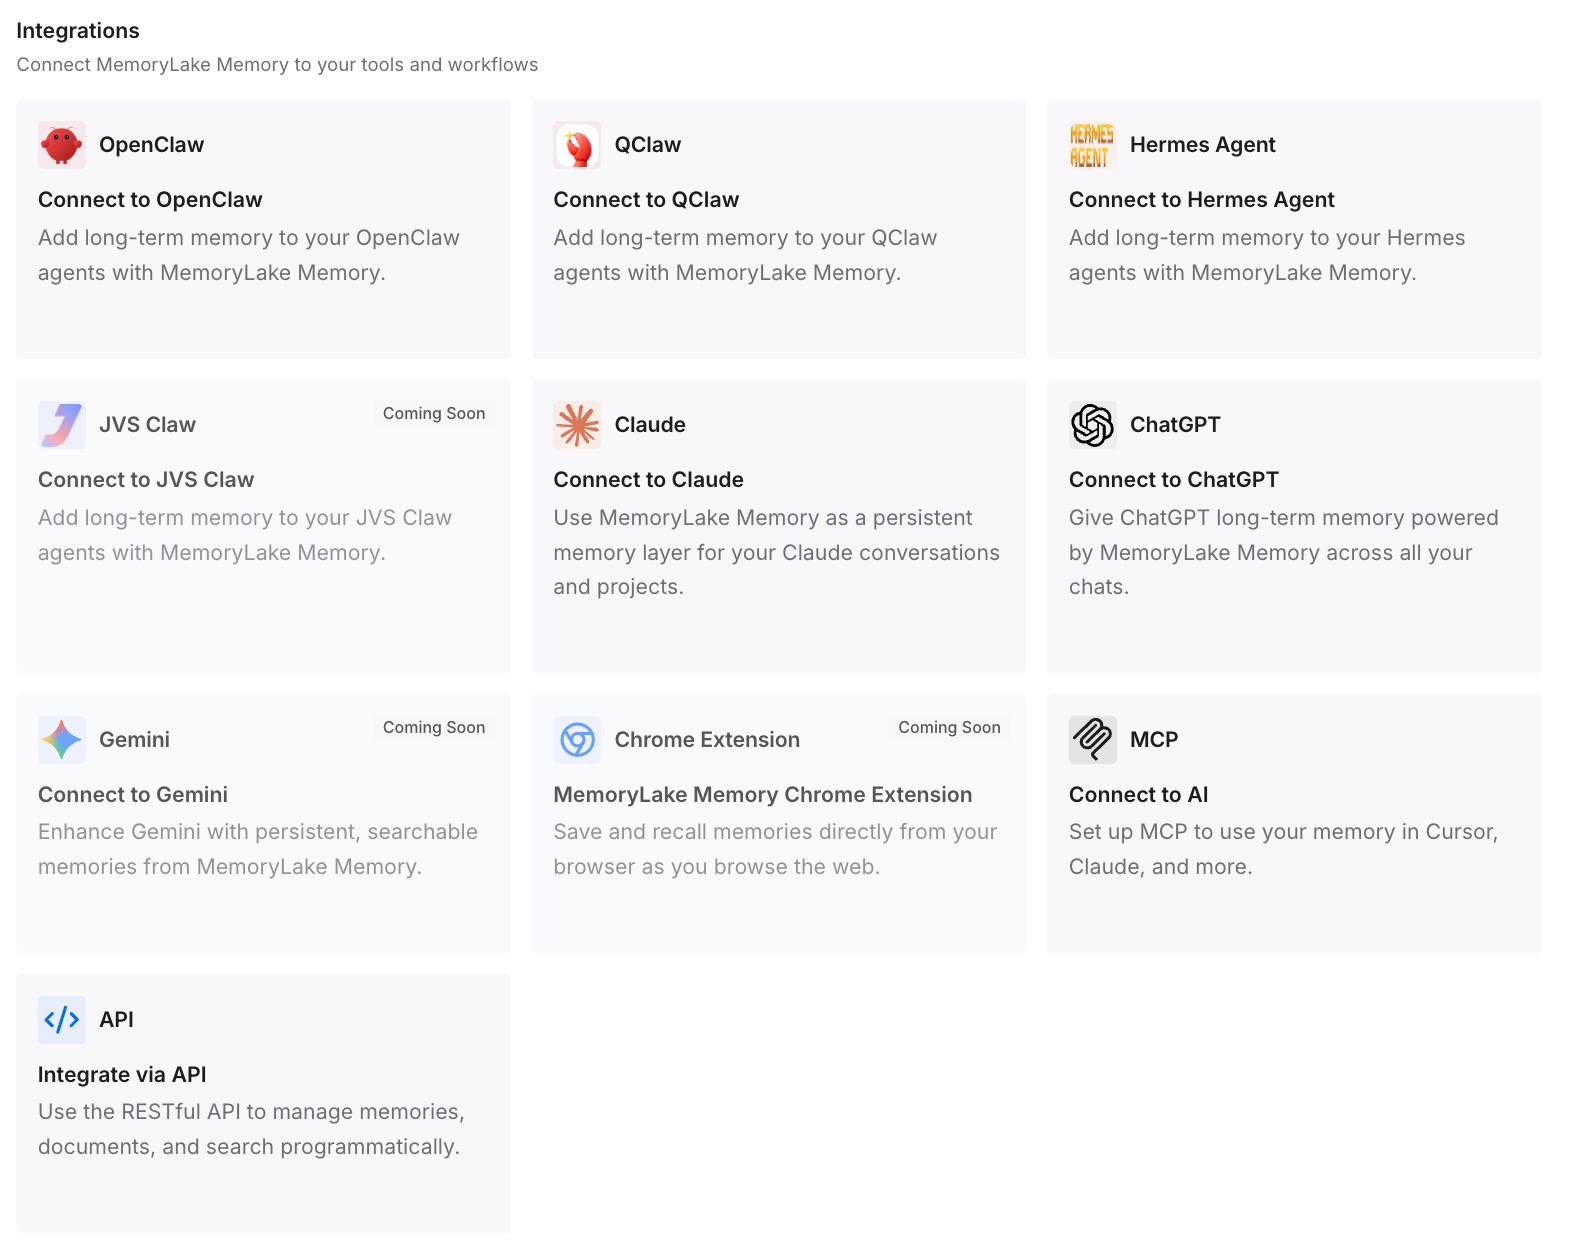
ステップ 3: AIとエージェントを接続する
使用しているアシスタントやエージェントを接続します。これにより、それぞれが同じ常設コンテキストを利用できるようになり、設計通りに「切り離しテスト」をクリアできます。
コンテキストエンジニアリングのベストプラクティス
コンテキストを予算として扱う。 すべてのトークンがモデルの注意を引くために競合します。その場所に値するものだけを含めてください。
ツールは少なく、明確に区別する。 重複するツールは、エージェントに曖昧な選択を強いることになります。
作業コンテキストはジャストインタイムで取得する。 タスクが必要とするときにファイルやデータをロードし、最初からすべてを読み込まないようにします。
慎重に圧縮する。 要約は作業を継続させますが、後で重要になる詳細が抜け落ちる可能性があります。
ウィンドウの外部にメモを書き出す。 構造化されたメモにより、エージェントは中断した場所から再開できます。
常設コンテキストを単一のツールから独立させる。 1つの製品の内部に存在する記憶は、その製品にしか役立ちません。エージェントが言ったことと行ったことの区別については、AIエージェントのエピソード記憶で説明されており、何を保存するかを決定する際に念頭に置く価値があります。
結論
コンテキストエンジニアリングは、プロンプトエンジニアリングの自然な後継者です。それは、巨大でありながらも有限であるウィンドウの中で、エージェントが各ステップで何を見るかを決定する継続的な作業です。Anthropicの原則はそれを要約しています。「望ましい結果の可能性を最大化する、シグナルの高いトークンの最小限のセットを見つけること」です。
その技術はよく理解されています。圧縮、構造化されたメモ、サブエージェント、そしてジャストインタイムの取得です。まだ定まっていないのは、これらすべての背後にある知識がどこに存在するべきかということです。Alibabaの「Context is All You Need」というフレーズには、コンテキストインフラがまだ標準化されていないという事実の告白が伴っています。
標準化されるまでの実用的なルールはシンプルです。ステップごとにコンテキストを設計しつつ、それが利用する常設の知識は、自分が所有し、使用するすべてのエージェントからアクセスできる1つの場所に保管することです。このレイヤーのより広範な紹介については、AIの記憶とは何かをご覧ください。