
Anthropic 所说的智能体记忆是什么
该文章对智能体记忆的定义较为狭窄。它是“Claude 从经验中获得的知识——包括与用户的交互和分配给它的任务——并且它在会话之间保留这些知识,保存为以后可以读取的上下文 (context)”。
它还列出了排除在外的内容:模型权重的更改、单个对话中的上下文学习 (in-context learning),以及压缩 (compaction)——它将其描述为替换旧轮次以使 Claude 能够继续工作的摘要。
证据来自几项评估:Continual Learning Bench、Claude 玩《宝可梦 红》、内部文档语料库以及围绕并购构建的法律基准测试。
记忆是对你所需内容的预测
文章中的第一个观点是,写笔记是一场赌注。用 Anthropic 的话来说,“记忆偶尔是一种预测。”它继续道:“通过写下一条规则,智能体预测它所描述的模式将再次具有相关性。”
在 Continual Learning Bench 任务中,Claude 回答数据库问题,被告知正确答案,并可以在下一个问题之前编写记忆。每个问题都在全新的会话中开始,只有一个例外:记忆目录是延续的。
较旧的模型留下了零散的、未经测试的猜测文件。文章称“Claude Opus 5 是第一个闭环的模型”,其条目包含一条规则、它是如何知道该规则为真的,以及关于陷阱的警告。
规则、其证据以及它所规避的陷阱是你以后可以检查的格式。
Claude 选择保留什么
宝可梦的对比是文中通过最清晰的例子。在游戏进行到大约 10,000 步时,一个较旧的模型在 225 个文件夹中编写了 413 个记忆文件,并获得了一枚徽章。而一个较新的模型在两个文件夹中编写了九个文件,外加一个名为 global.md 的顶层文件,并获得了四枚徽章。
区别在于每个模型认为什么值得保存。旧模型记录了每一次战斗、道具和角色,文章解释了为什么这会产生负面影响:“Sonnet 3.7 的详细记录在不断过时。”
新模型保存了游戏没有显示的内容。文章这样区分:“关于策略、计划和经过测试的规则的记忆文件只有在 Claude 总结出它们时才存在,除非 Claude 将它们写下来,否则它们会消失。”像玩家的金钱或地图位置之类的信息每一轮都可以从屏幕上读取,因此存储它们是冗余的。
Claude Code 的文档为自动记忆划定了类似的界限。它将自动记忆描述为存放你的偏好、修正以及“Claude 无法从代码中推导出的项目上下文”的地方。存在于代码、README 或构建文件中的事实可以在需要时直接读取。复制这些事实的笔记可能会与源内容发生偏差。
告诉 Claude 记忆的用途,而不是如何使用它
文章关于引导的建议很简短:“我们发现,告诉 Claude 记忆的用途是有帮助的,但不要告诉它如何使用记忆。”
Anthropic 测试了关于写什么的特定规则。当规则告诉模型仅记录失败时,更强大的模型失去了记忆带给它们的大部分收益。结论是:“对于更强大的模型,赋予它们判断显著性 (salience) 的自由比预先设定固定规则更有效,而且这些规则最终可能会削弱性能。”
旧模型则不同:提示一个模型先读取其记忆并测试其理论可以提高其分数。对于前沿模型,Anthropic 将其默认设置为简单的引导,即在有人要求或某些内容显然值得记住时创建笔记。
这一发现是关于智能体将什么写入记忆的规则。它并没有评估你为编码工作提供给 Claude 的项目指令。如果你在 CLAUDE.md 中添加了一行告诉 Claude 只保存某些类型的笔记,这项研究是测试该行是否有帮助的一个理由,而不是证明它在你的设置中有害。
为什么错误的记忆笔记会在以后被信任
请仔细阅读这一发现。文章直接指出了风险:“由于 Claude 根据它在会话中判断为显著的内容写入记忆,因此从一开始就错误或随着环境变化而漂移的笔记可能会在以后的会话中被 Claude 读取并信任。”
在宝可梦的运行中,Claude 记错了地标所在的侧山,将该山标记为已完成,并多次从单向壁架上走下,回到了它来时的路线上。
Anthropic 测试的修复方法是 Dreaming:一个根据原始会话记录检查笔记的过程。Claude 将错误的笔记与记录进行对比,发现了错误,并重写了笔记。有了修正后的笔记,它回到了洞穴并到达了下一个城市。文章解释了为什么这行得通:“记录为 Claude 验证其记忆提供了事实依据 (ground truth)。”
这对 Claude Code 的自动记忆意味着什么
Claude Code 的自动记忆是你机器上的普通文件。文档说明你可以运行 /memory 来浏览它们,并且“一切都是普通的 markdown,你可以阅读、编辑或删除”。
文档中有一个细节直接与研究相关。Claude Code 会在 cleanupPeriodDays 保留期后删除旧的会话记录,但“从该保留清理中排除记忆目录中的记忆文件”。记忆文件会一直保留,直到你或 Claude 编辑或删除它们。
将这两个事实放在一起看。笔记的寿命可能比产生它的会话记录更长。如果笔记是错误的,那么可以证明它错误的记录可能已经消失了。Anthropic 的 Dreaming 过程依赖于该记录。对于本地自动记忆,检查的责任落在了你身上,需要对照代码和项目的当前状态。我们的指南 为什么 Claude Code 会忘记你的修正 涵盖了相反的失败情况,即修正根本没有进入笔记。
为什么每个会话仅加载部分记忆
文章描述了一个层级结构。笔记可以被提升到顶层,智能体的框架会在每个会话开始时将其加载到上下文 (context) 中,这样 Claude 就不需要搜索它们。文章随后对该层级设置了限制:“注入的记忆会消耗宝贵的 token,并且错误的笔记可能会被带入每个会话。”
它补充说,加载笔记并不保证 Claude 会根据它采取行动,并引用了 Claude Code 自己的文档,即较长的指令文件会降低遵循度。其结论是:“因此,记忆层级的顶层必须保持相对较小”。
文章随后以 Claude Code 的自动记忆为例说明了相同的设计。文档详细说明了数字:“MEMORY.md 的前 200 行,或前 25KB(以先到者为准),会在每次对话开始时加载。”它继续道:“超过该阈值的内容不会在会话开始时加载。”
其余内容存放在主题文件中,Claude 根据需要读取。MEMORY.md 充当指向它们的索引。
Claude Code 在 Claude 写入时也会强制执行此限制。如果 MEMORY.md 接近限制,Claude Code 会提醒 Claude 缩短它。如果超过限制,写入仍然成功,但 Claude Code 会返回一个错误,告诉 Claude 重写索引,“因为超过限制的所有内容在下次加载时都会被丢弃”。
因此,对于任何笔记,实际问题在于它所处的位置。MEMORY.md 前 200 行中的内容在会话开始时就在那里。更靠后的内容,或主题文件中的细节,只有在 Claude 主动寻找时才会出现。我们的 Claude Code 自动记忆 指南解释了这些文件的存放位置以及如何关闭该功能。
这同样适用于你编写的指令文件:文档建议每个 CLAUDE.md 文件保持在 200 行以下,因为“较长的文件会消耗更多上下文并降低遵循度”。子目录文件有它们自己的截止限制,这在我们的 子目录 CLAUDE.md 限制 指南中有涵盖。
当多个编写者共享一个页面时
后期的一个实验很容易被忽略,但它与任何在智能体或人之间共享记忆的人都相关。Claude 根据一组合同构建了一个维基 (wiki)。多个智能体同时向一个共享的合同条款表写入内容。当 Anthropic 对根据该维基构建的简报进行评分时,57 个评分事实中有 41 个得以保留。文章发现了原因:共享表对条款的总结很差且缺失了一些条款,“因为智能体相互覆盖了对方的工作”。
改进后的指令为每份合同分配了由单个智能体编写的独立页面,“该页面逐字引用条款,而不是将它们总结到共享表中”。通过这一改变,所有 57 个事实都进入了简报。
每个页面一个编写者可以避免覆盖,引用来源可以保留摘要可能会丢掉的细节。
Claude Code 的文档指出,“同一个 git 仓库中的所有工作树和子目录共享一个自动记忆目录”。如果你在一个仓库的多个工作树中运行并行会话,它们会共享该目录。记忆文档没有描述如何处理对同一文件的同时写入,因此在并行工作一天后检查 MEMORY.md 是值得的。Anthropic 的 Managed Agents 指南在编写者之间采取了类似的划分,这在我们的文章 Claude Managed Agents 中的两个记忆存储 中有涵盖。
维基何时有帮助,何时没有
文章并没有将维基作为通用答案。在需要多个文档事实的问题上,Claude 使用维基的表现优于仅使用搜索。在大多数标准可以从单个文档中满足的法律任务中,维基没有显示出明显的收益。在另一项任务中,维基变得比构建它的文档还要大。文章对该案例的结论是:“Claude 制作了一个极其详细的维基,实际上没有抽象出任何东西。”文章还列出了开放性问题,包括在检查每条笔记都需要计算成本时,如何保持记忆的准确性。
人们首先尝试的做法
保存所有内容,以防万一。 庞大且过时的记忆会浪费搜索时间并产生误导。
编写关于保存什么的严格规则。 对于更强大的模型,Anthropic 发现固定规则可能会削弱性能。
因为笔记在记忆中就信任它。 笔记可能从一开始就是错的,Claude 可能会在以后的会话中读取并信任它。
让 MEMORY.md 增长。 超过前 200 行或 25KB 的任何内容都不会在会话开始时加载。
解决方案:保持加载层小且可检查
第 1 步:阅读自动记忆保存的内容
运行 /memory,打开自动记忆文件夹,阅读 MEMORY.md 和主题文件。对照代码或项目的当前状态检查每个条目,并修正或删除不再真实的内容。不要指望能找到原始会话,因为记录会按计划清理。
第 2 步:保持 MEMORY.md 为限制内的索引
在 MEMORY.md 中保持每个条目一行,并将细节移至主题文件。将 Claude 在每个会话开始时需要的条目放在顶部附近。删除任何复制 Claude 可以从代码中读取的内容。
第 3 步:每个页面一个编写者,并引用决策
如果多个会话或团队成员向相同的笔记添加内容,请为每个主题提供自己的页面。当事实来自文档、工单或决策记录时,请复制确切的措辞而不是摘要。
在 MemoryLake 中设置
Anthropic 的文章是关于智能体根据当时看起来重要的内容为自己编写的记忆。还有另一种具有不同属性的记忆:你自己确认的决策和惯例。你在编写条目时就知道它是正确的,并且你可能希望在多个工具和多台机器上使用它。Claude Code 的文档称自动记忆是机器本地的。
MemoryLake 是一个记忆层,用于将这些确认的条目保存在你维护的一个地方,供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你自己用自己的语言编写条目。不会从你的 MEMORY.md、你的自动记忆主题文件、你的 CLAUDE.md 文件、你的 Claude 聊天或任何供应商的存储中读取、写入或删除任何内容。Claude Code 的自动记忆将继续按照 Anthropic 描述的方式工作。
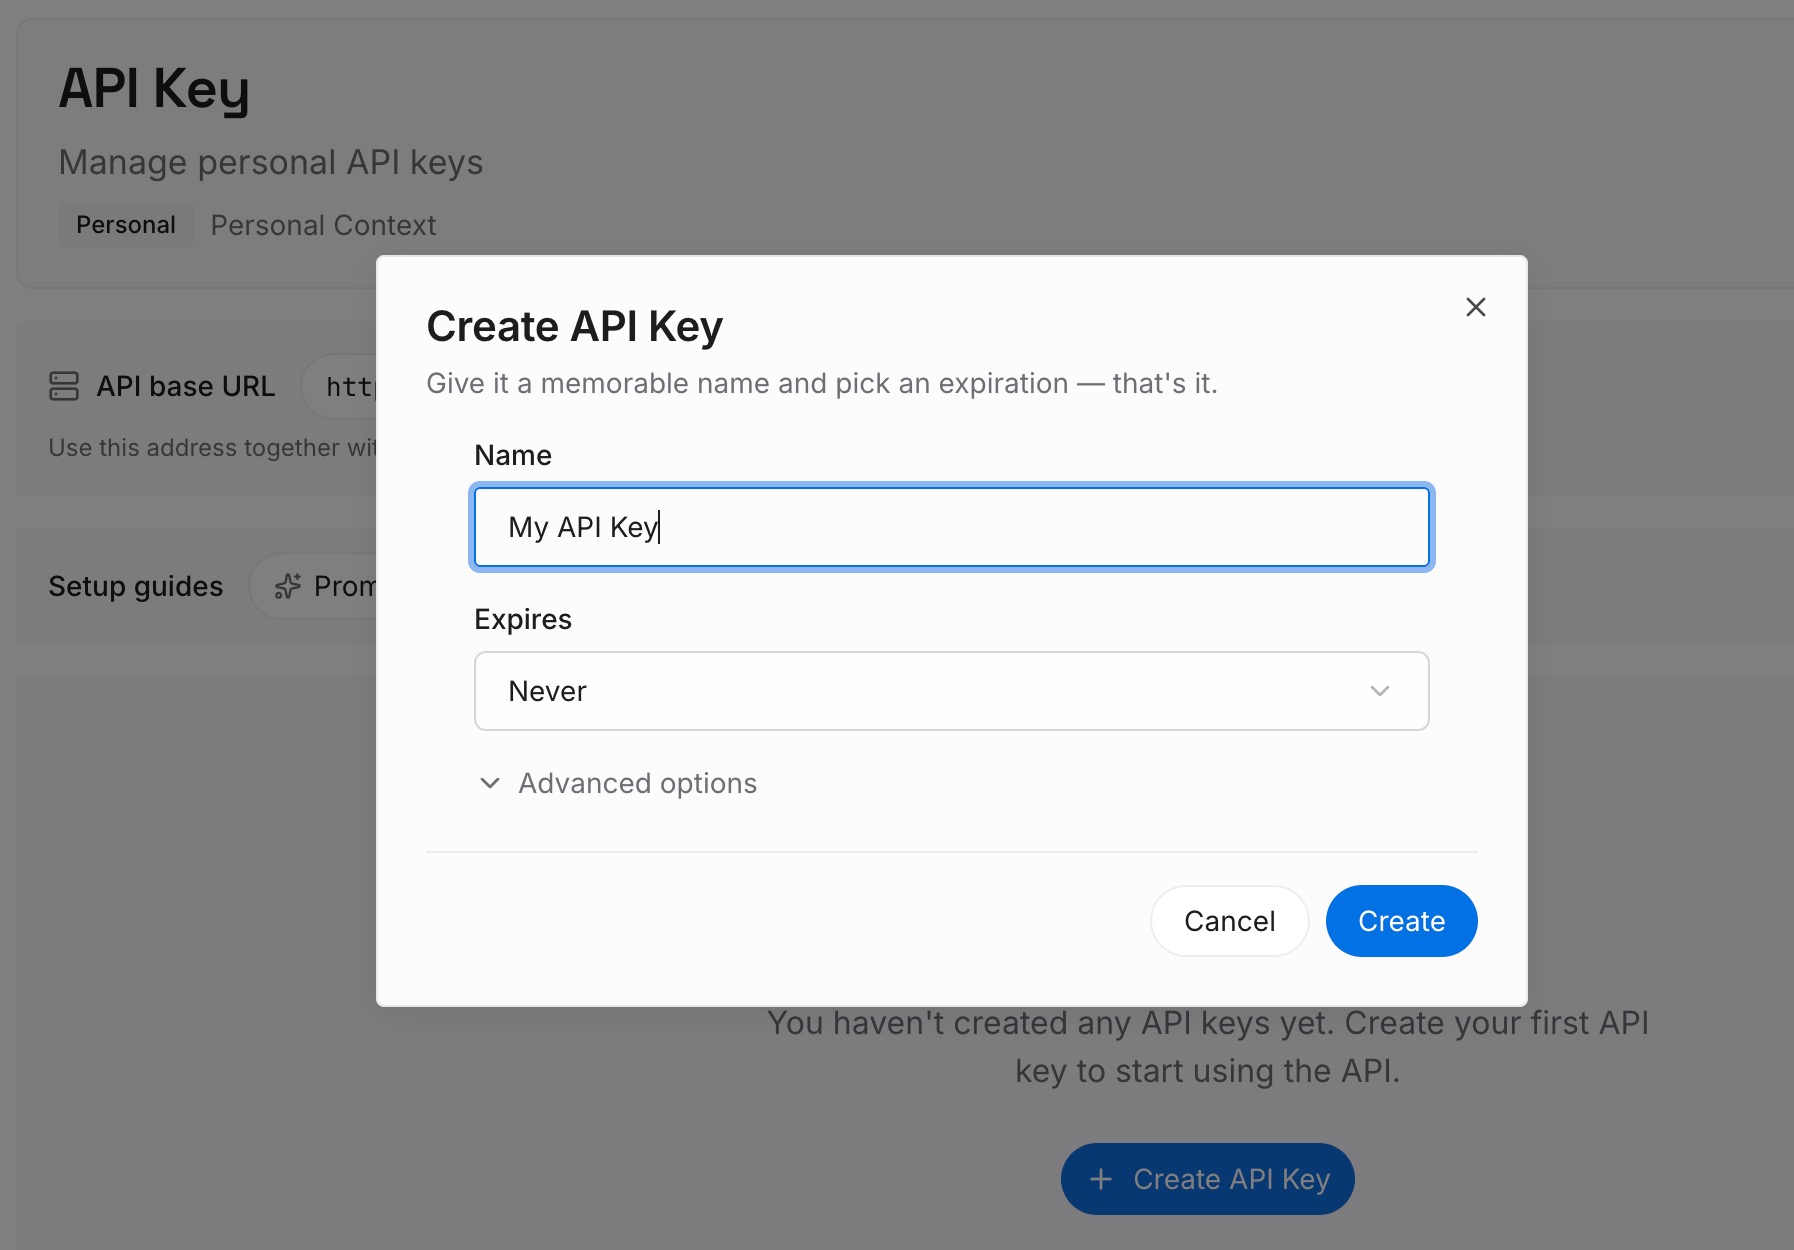
第 1 步:创建 API 密钥
登录并从控制面板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的 Anthropic 账户分开。
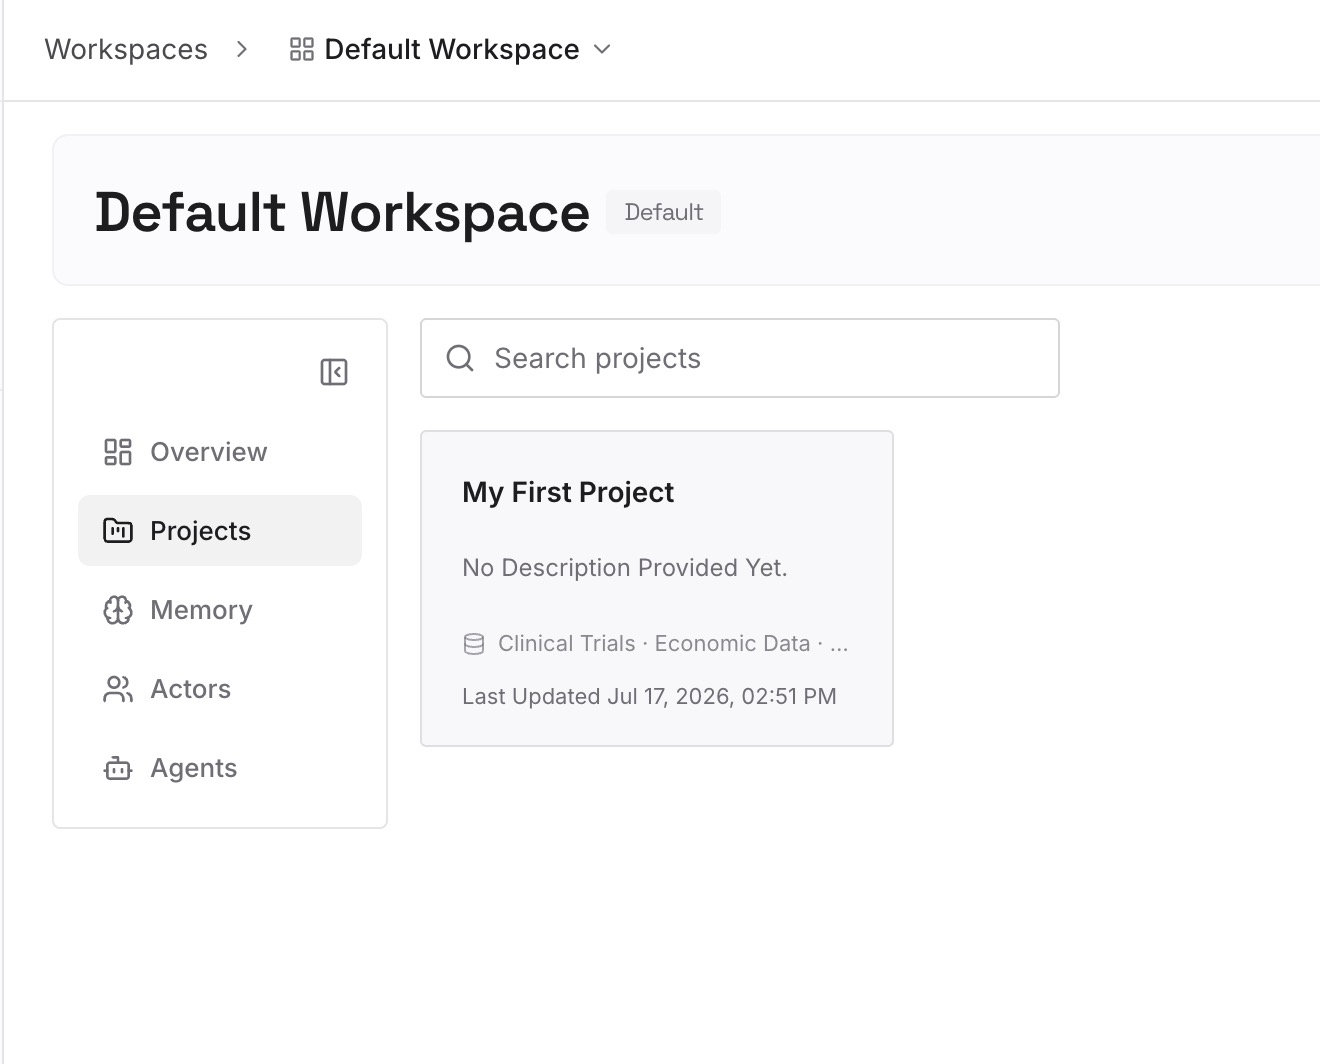
第 2 步:上传你的第一批记忆
从你在上述第 1 步中检查并确认仍然正确的条目开始。每个条目一个决策,逐字引用来源并注明你确认的日期。
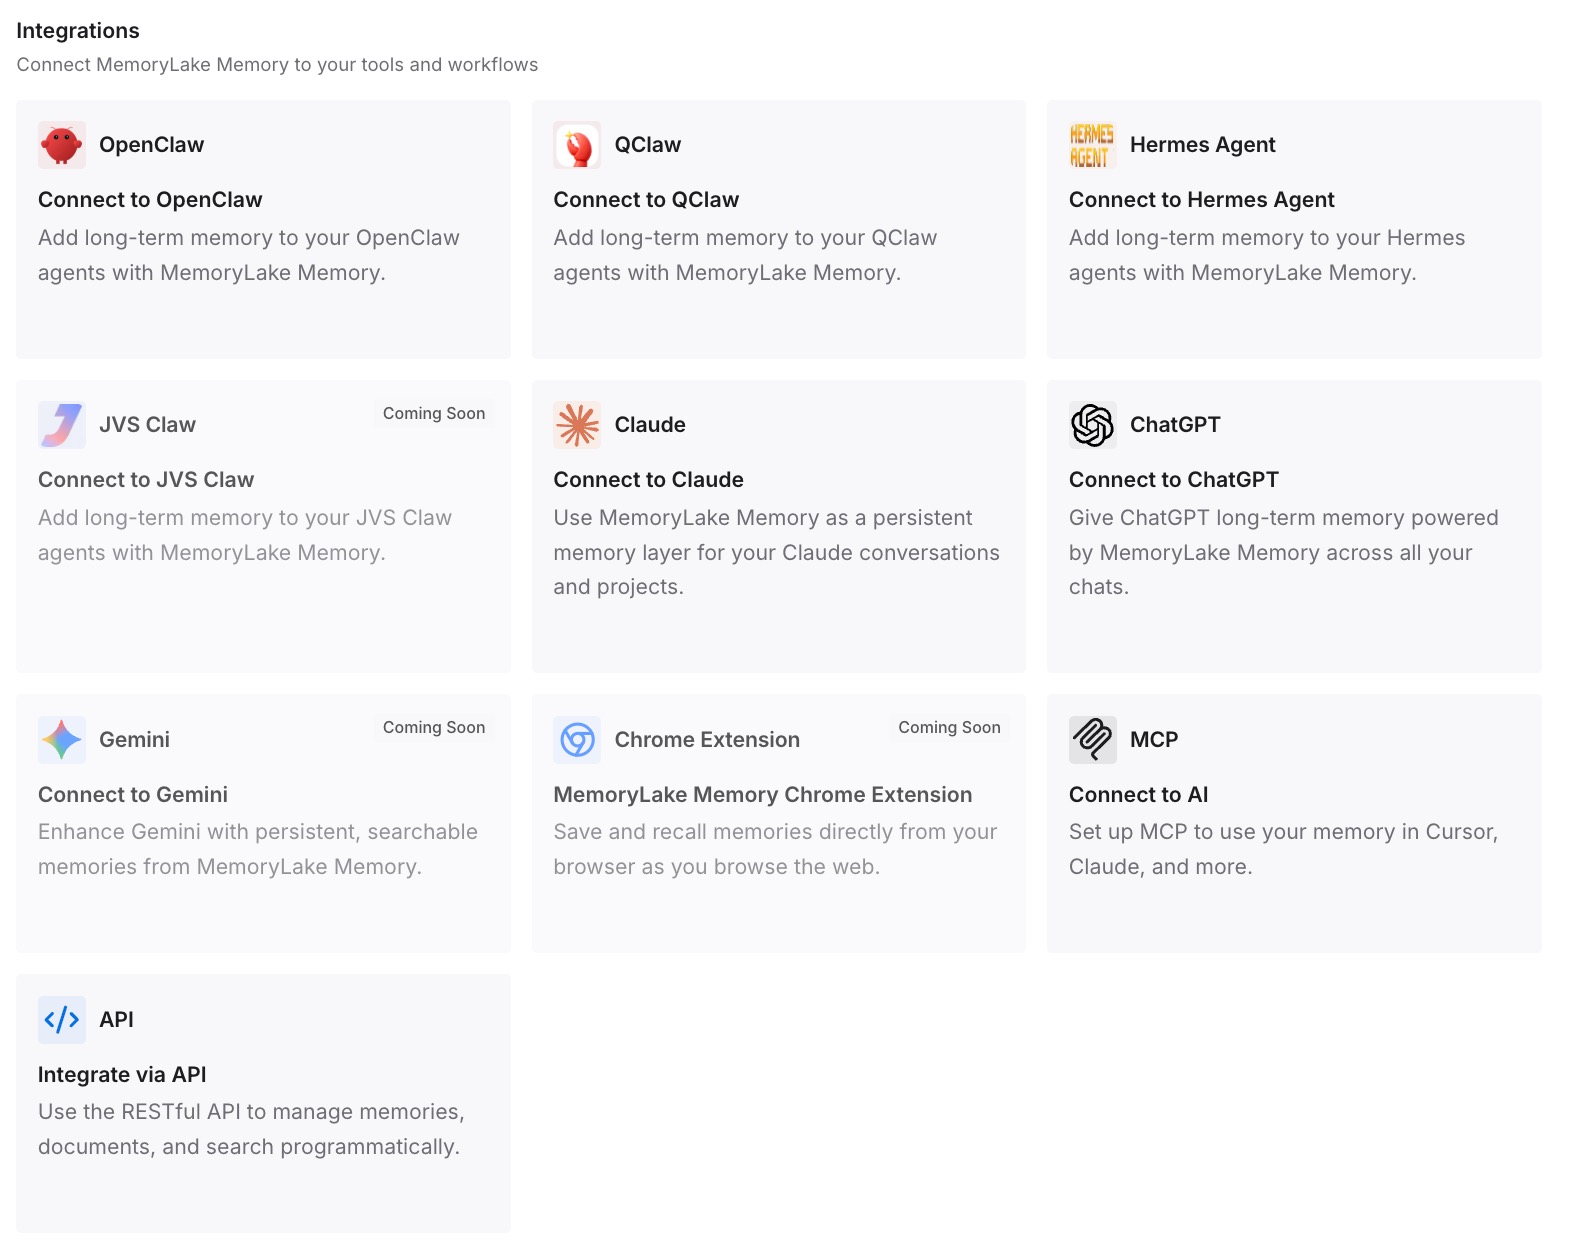
第 3 步:连接你的 AI 和智能体
连接 Claude Code 和你使用的任何其他助手。相同的确认条目在每台机器和每个工具中都可用。
这在实践中改变了什么
第一个区别是更短的索引。MEMORY.md 可以保存指针和每个会话需要的少数内容,而确认的决策存放在你可以查阅的地方。
第二个是更清晰的事实来源。当自动记忆笔记和确认的条目不一致时,你知道哪一个是你在检查后编写的。
第三个是重要内容只有一个编写者:你确认的决策只有一个作者。
Claude 记忆文件的最佳实践
保存 Claude 无法在别处读取的内容。 策略、决策和经过测试的规则属于记忆。代码中的事实则不然。
编写规则及其证据。 规则、你如何知道它是真的以及它规避的陷阱在以后很容易检查。
对照源内容检查笔记。 错误的笔记可能会在以后的会话中被信任。
保持顶层较小。 只有 MEMORY.md 的前 200 行或 25KB 会在会话开始时加载。
倾向于每个页面一个编写者。 具有多个编写者的共享页面可能会丢失事实。
引用而非总结重要术语。 确切的措辞可以保持细节完整。
结论
Anthropic 的文章通过其自身的评估解释了 Claude 如何决定记住什么。笔记是预测。当被告知记忆的用途而不是被给予固定规则时,更强大的模型表现更好。从一开始就错误的笔记可能会在以后的会话中被读取并信任,这就是为什么 Anthropic 测试了针对原始记录的 Dreaming。每个会话加载的层级被刻意保持得很小,在 Claude Code 中这意味着 MEMORY.md 的前 200 行或 25KB。
对于你自己的设置,这归结为三个习惯:对照源内容检查自动记忆保存的内容,保持 MEMORY.md 为一个简短的索引并将重要条目放在顶部,以及为重要事实提供单一编写者和确切措辞。