
启动 Claude 的位置决定了加载内容
第一个决定最简单,影响也最大。文档指出:“启动 claude 的位置决定了 Claude 在无需额外权限授予的情况下可以读取和编辑哪些文件,哪些 CLAUDE.md 文件在启动时加载到上下文中,以及应用哪些项目设置。”
它对比了两种选择:
- 从仓库根目录启动。 Claude 可以访问每个文件。启动时,它仅加载根目录的 CLAUDE.md,子目录文件按需加载。
- 从子目录启动。 Claude 可以访问该子树,直到你授予更多权限。启动时,它会加载该目录的 CLAUDE.md 以及所有祖先目录的 CLAUDE.md。
文档建议,当任务跨越多个包时从根目录启动,而当工作范围仅限于一个包时从子目录启动。
有一个细节很容易被忽略:“.claude/settings.json 中的项目设置不会像 CLAUDE.md 文件那样从父目录继承。”指令会从父目录级联,但设置不会。
按目录分层 CLAUDE.md 文件
文档描述了为什么单个根文件会失效:它“往往要么膨胀到涵盖每个子系统的约定,在与当前任务无关的指令上浪费上下文,要么变得过于通用而毫无用处。”
其建议分为两个层级:
- 根目录 CLAUDE.md:用于适用于所有地方的指令,如编码标准和提交约定。
- 每个包或子系统一个 CLAUDE.md:用于该领域特定技术栈的约定。
文档中的示例展示了效果。当你从 API 包启动 Claude 时,它会加载该包的 CLAUDE.md 和根目录的 CLAUDE.md,“上下文中不会出现来自 packages/web/ 的指令。”
要检查实际加载了哪些文件,请运行 /context all 并查看 Memory files 下的列表。
文档还提供了三种保持这些文件更新的方法:
- 在拉取请求中审查 CLAUDE.md 的编辑,就像对待任何其他文档一样。
- 在重大模型发布后重新审视。 针对旧模型限制而制定的指令,在新模型能够处理该情况后可能会变成负担。
- 添加一个建议更新的 Stop 钩子。 Stop 钩子会接收会话记录的路径,因此脚本可以在记忆犹新时提出 CLAUDE.md 的修改建议。
按需加载的子目录文件有其自身的尺寸行为,这与根文件不同。我们在关于 Claude Code 中子目录 CLAUDE.md 限制 的指南中介绍过这一点。
按目录的 CLAUDE.md 或路径范围规则
Claude Code 有第二种将指令定位到树中特定部分的方法:在 .claude/rules/ 下使用带有 paths: 通配符的规则文件。文档对比了这两者。
按目录的 CLAUDE.md 与其代码一起位于目录内。当你从该目录启动时,它会在启动时加载,或者按需加载。它适合由目录所有者维护自己约定的团队。
路径范围规则 位于仓库根目录的中央 .claude/ 文件夹中。当 Claude 处理匹配其通配符的文件时,它会加载。它适合希望将所有约定放在一个地方的团队,或者适用于许多分散路径的规则。
我们在关于 什么是 Claude Code 规则 的指南中介绍了规则文件的工作原理。
排除其他包的指令
当你从根目录启动时,每个子目录的 CLAUDE.md 可以在 Claude 接触到那里的文件时按需加载。claudeMdExcludes 设置可以通过路径或通配符跳过特定文件,“以便它们永远不会加载”。
文档建议将其用于你从不工作的目录,例如其他团队的包、遗留代码或第三方库子树。一些细节决定了它是否按你预期的方式工作:
- 它是静态的。 “排除列表是静态的,不是针对每个任务的开关。”如果每天要专注于不同的包,请从该包启动 Claude,而不是编辑排除项。
- 模式匹配绝对路径。 使用
**/开头的相对风格模式来匹配树中的任何位置。 - 它也涵盖规则。 排除一个包的文件夹会跳过其下的每个 CLAUDE.md 和规则文件,而根目录 CLAUDE.md 和你工作的包则正常加载。
- 范围合并。 你可以在用户、项目、本地或托管范围进行设置,数组会跨范围合并,因此团队默认值和个人添加项会结合在一起。
- 托管文件仍然加载。 如果你的组织部署了托管的 CLAUDE.md,匹配它的模式不会跳过它。
对于仅适用于你的排除项,文档建议使用 .claude/settings.local.json。如果你手动创建该文件,请自行将其添加到 gitignore 中。
阻止 Claude 读取不需要的代码
指令只是填充上下文的一部分。文档指出:“文件读取是另一个随着代码库增长而增加的成本。”
Gitignored 路径。 Claude 的内容搜索默认遵循 .gitignore,因此像 node_modules/、dist/ 和 build/ 这样的路径不会出现在搜索结果中。
已提交的生成代码或第三方代码。 对于已提交的路径,在 permissions.deny 中添加 Read 拒绝规则。将它们放在 .claude/settings.json 中供仓库中的每个人使用,放在 .claude/settings.local.json 中供你自己使用,或者放在托管设置中以在所有地方强制执行。
文档明确指出了限制:“拒绝规则不涵盖自行打开文件的子进程。”
语言服务器查询。 代码智能插件将 Claude 连接到语言服务器,因此它可以跳转到定义并查找引用,“而不是扫描树”。文档称这与排除项和拒绝规则配合良好:后者排除无关内容,而代码智能则防止 Claude 通读剩余内容。
仅检出所需内容,并谨慎添加目录
对于工作树(worktrees),worktree.sparsePaths 设置使用 git sparse-checkout 仅写入列出的目录加上根级文件。如果你希望在工作树内使用根目录的设置和规则,请将 .claude 包含在列表中。
当你从一个包启动并需要访问同级包时,你授予访问权限的方式会改变加载的内容。文档中的表格显示:
additionalDirectories设置:永远不会加载 CLAUDE.md、规则或 skills。--add-dir标志或/add-dir命令:加载 skills,并且仅在设置了CLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MD环境变量时才加载 CLAUDE.md 和规则。
因此,添加同级包会给 Claude 文件访问权限,但不一定包含该包的约定。如果同级包的规则对任务很重要,请配合环境变量使用 --add-dir。
按目录添加 skills
Skills 适用于仅在相关时才加载的参考资料。文档指出,任何子目录都可以在其自身的 .claude/skills/ 下定义 skills,并随该区域的代码一起提交。其示例:API 包中的 API 测试 skill 和 Web 包中的组件模式 skill。当 Claude 处理某个包中的文件时,它会加载该包的 skill。
使用大量 skills 时有一个陷阱。Claude 通过读取每个发现的 skill 的名称和描述来选择 skill,并且“只有选定 skill 的完整内容会加载到上下文中”。当数量很多时,文档称某些 skill 可能会完全丢失其描述。其建议是:“保持描述简短,并以请求可能包含的词汇开头”。
哪些 skills 在范围内取决于你启动的位置:
- 从子目录启动:该目录的 skills、直到根目录的每个父目录的 skills,以及用户和企业级 skills。
- 从根目录启动:根目录 skills 加上 Claude 接触到的每个子目录的 skills,“这可能会累积到数百个”。
对于许多目录共享的 skills,例如 PR 约定或部署检查清单,文档建议放在根目录的 .claude/skills/。
当分层不再能扩展时
文档坦言,按目录的文件并不能解决所有问题:“约定会漂移,文件会过时,而且没人负责根目录。”
其建议是将约定和参考内容从始终加载的 CLAUDE.md 移至按需加载的机制中:
- Skills:用于在相关时加载的参考资料。
- Plugins:由平台团队拥有并通过托管设置供所有人安装的 skills、钩子和命令的版本化捆绑包。Plugin skills 使用命名空间,因此不会与按目录的 skills 冲突。
- MCP 服务器:如果你的组织已经在仓库上运行代码搜索或检索索引。
- 一旦约定存在于插件中,处于不熟悉代码区域的同事可能不知道该应用哪一个。文档建议使用 SessionStart 钩子,将启动目录映射到正确的插件并打印建议,因为 Claude Code 会在第一个提示符之前将钩子的输出添加到 Claude 的上下文中。
跨包的更改
对于涉及多个包的更改(例如共享类型及其每个调用点),文档给出了两种技术。在一个会话中将整个更改交给 Claude,这样每次编辑背后的决策就能保持一致。并且先制定计划:在计划模式下,Claude 将计划写入文件,“Claude Code 在每次压缩后重新注入计划文件,因此计划在对话历史可能丢失的情况下仍能保留”。
人们首先尝试的做法
将所有内容放入根目录 CLAUDE.md。 这会在无关指令上浪费上下文。
按任务编辑 claudeMdExcludes。 它是静态的。应该改为从特定包启动。
期望拒绝规则阻止所有读取。 自行打开文件的子进程不受涵盖。
使用 additionalDirectories 添加同级包并期望加载其 CLAUDE.md。 该设置永远不会加载 CLAUDE.md 或 skills。
编写冗长的 skill 描述。 当 skills 很多时,描述可能会被截断。
解决方案:为你所在的代码加载正确的指令
第 1 步:选择启动位置
对于专注的工作从包目录启动,对于跨包任务从根目录启动。
第 2 步:按目录拆分 CLAUDE.md
在根目录保留全仓库规则,在每个包中保留特定技术栈的约定,然后使用 /context all 进行检查。
第 3 步:排除和拒绝你永远不需要的内容
使用 claudeMdExcludes 排除其他团队的指令,并使用 Read 拒绝规则处理生成代码或第三方代码。
第 4 步:记录每个约定存在的原因
指令文件说明该做什么。背后的决策以及哪些约定正在被废弃,需要它们自己的归宿。
在 MemoryLake 中设置
在大型代码库中,约定分散在许多文件和所有者中。它们背后的决策,例如为什么 API 使用查询构建器,或者为什么某个遗留服务被冻结,是新同事和新会话不断询问的内容。
MemoryLake 是此类项目上下文(如架构决策、包所有权和约定背后的原因)的记忆层,统一保存在你维护的一个地方,并可供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你用自己的语言亲自编写条目。不会从你的 CLAUDE.md 文件、规则或 skills、设置文件、会话或任何供应商的存储中读取、写入或删除任何内容。CLAUDE.md 的加载、排除和 skills 仍按 Anthropic 描述的方式工作。
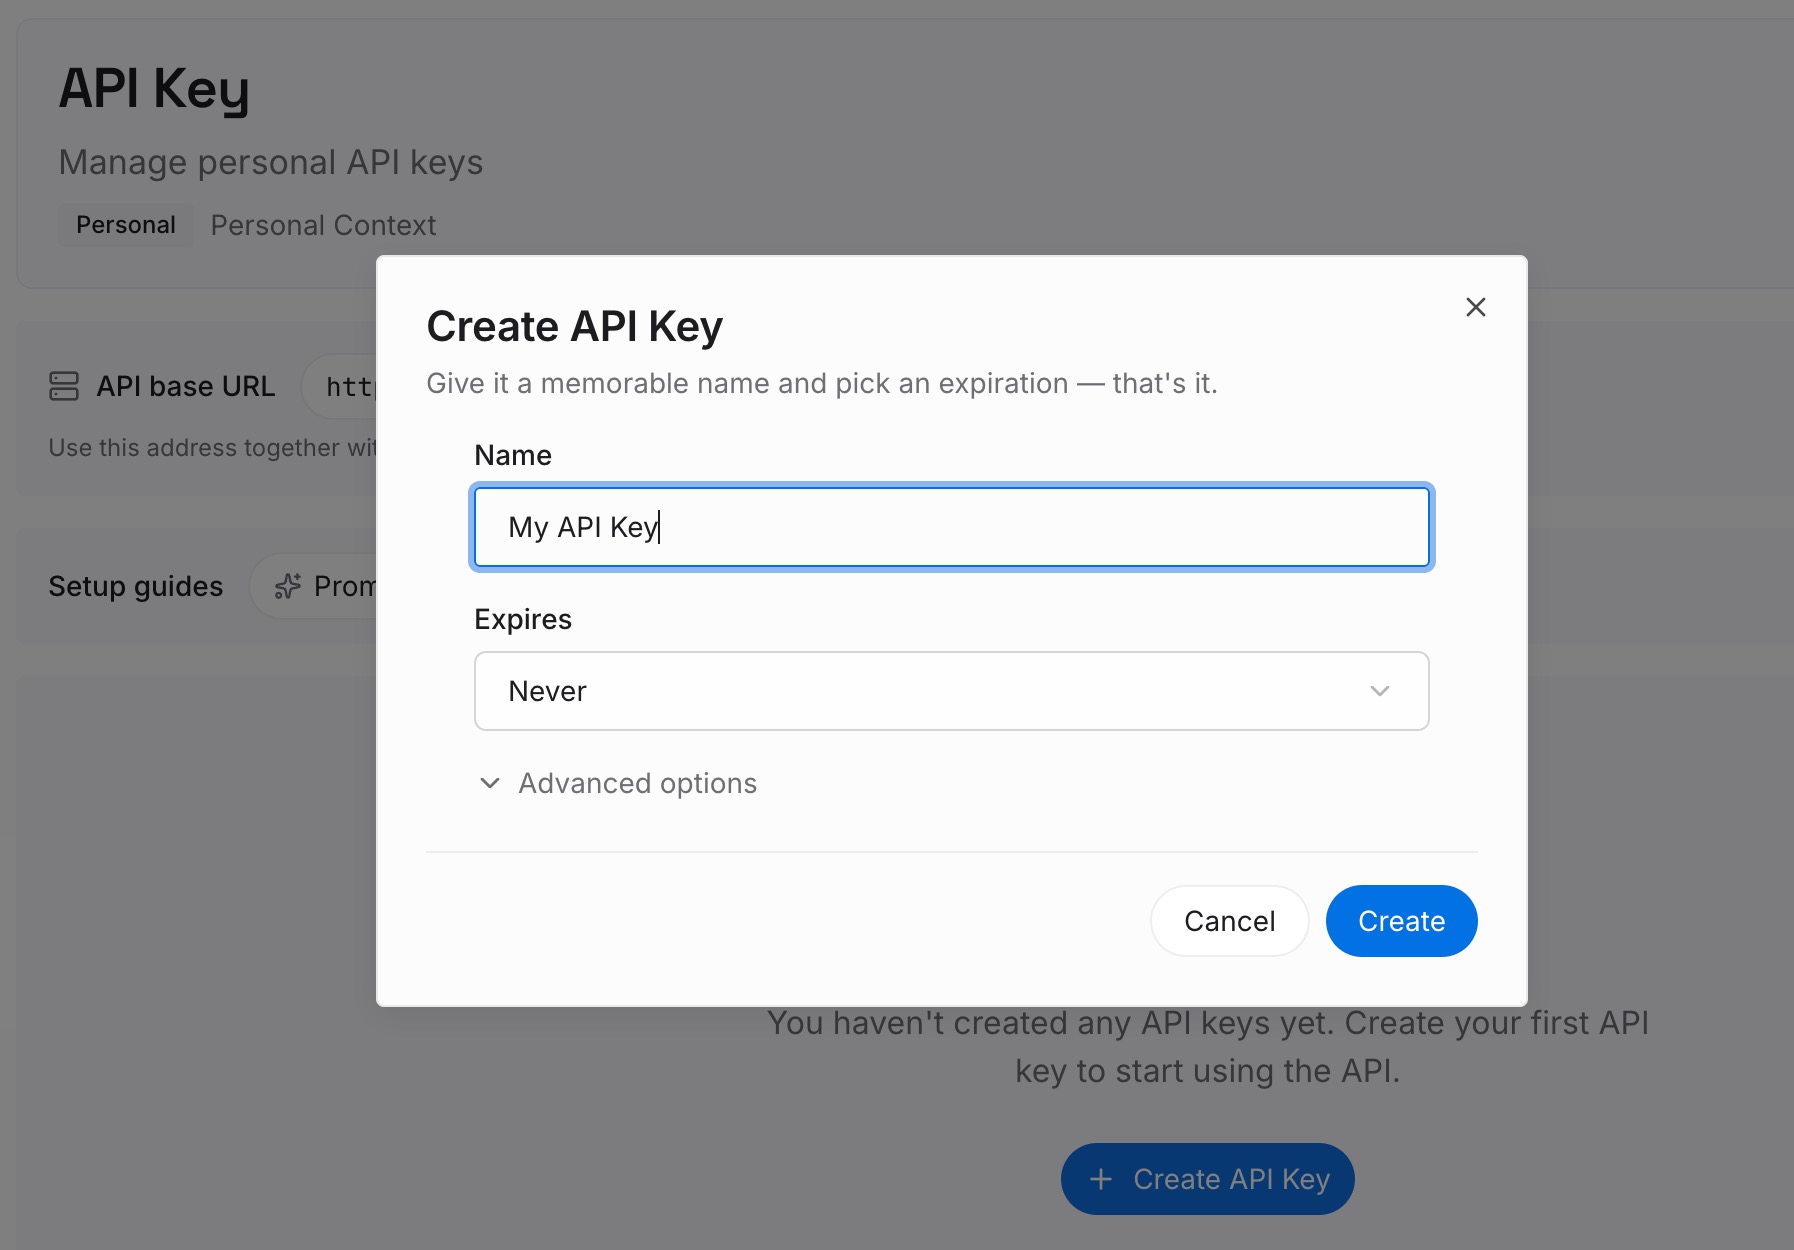
第 1 步:创建 API 密钥
登录并从控制面板生成密钥。像对待任何其他凭据一样,将其存储在仓库之外。
第 2 步:上传你的第一批记忆
从你在解决方案第 4 步中编写的内容开始:约定背后的决策,按包分组。每个条目一个决策,并注明其所有者。
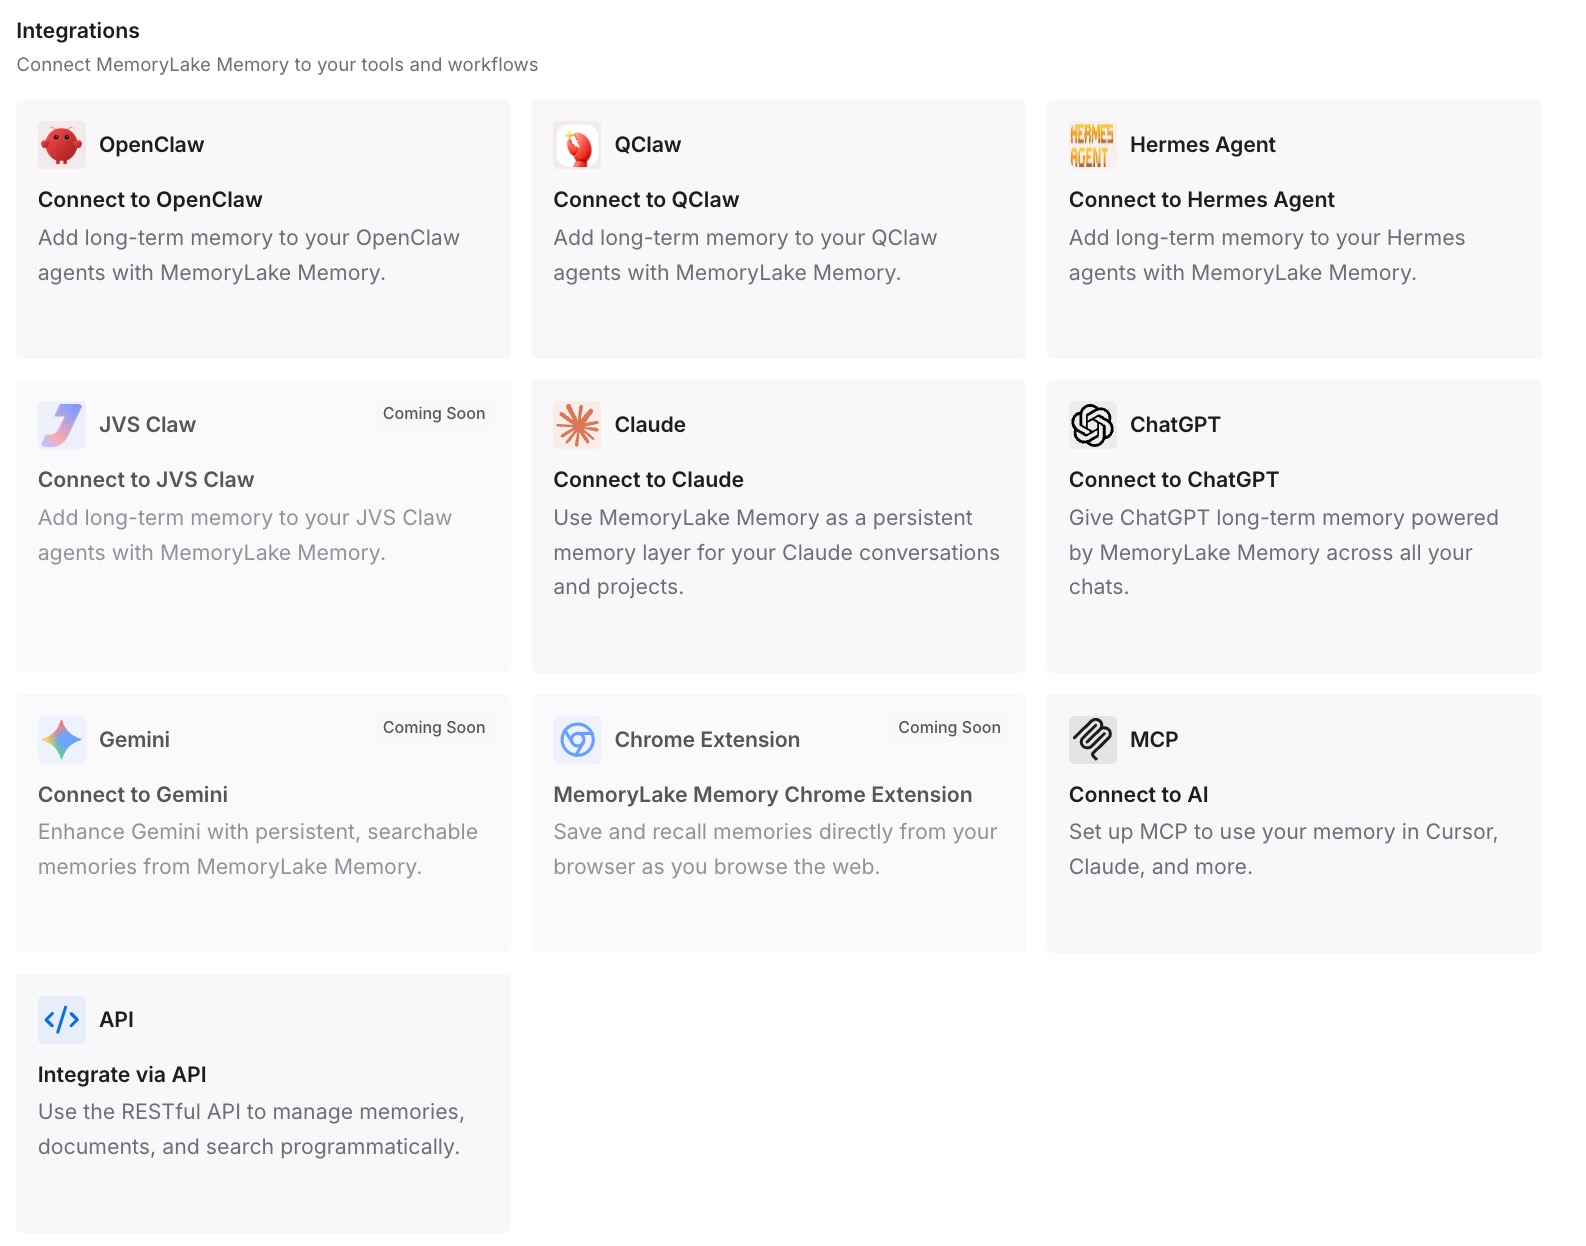
第 3 步:连接你的 AI 和代理
连接 Claude Code、Codex 和你使用的其他助手。无论会话从哪个包开始,每个助手都可以利用相同的决策。
这在实践中改变了什么
第一个区别是指令文件变小了。CLAUDE.md 可以专注于“该做什么”,而推理过程则保存在别处。
第二个区别是更容易上手。新同事可以阅读为什么某个包以这种方式工作。
第三个区别是跨工具的一致性。在同一个仓库中工作的 Codex 可以使用相同的决策。
大型代码库中 Claude Code 的最佳实践
在工作所在处启动。 这决定了加载哪些 CLAUDE.md 文件。
按目录分层指令。 根目录用于全局,包目录用于其自身的技术栈。
检查加载内容。 使用 /context all。
排除你从不碰的内容。 claudeMdExcludes 是静态的,因此设置一次即可。
拒绝读取生成代码。 并记住子进程不受涵盖。
保持 skill 描述简短。 以请求可能包含的词汇开头。
将不断增长的约定移至 skills 或插件。 按需加载它们。
结论
Claude Code 根据你启动它的位置加载 CLAUDE.md 文件:从根目录启动仅加载根文件,或者从子目录启动加载该包的文件及其所有祖先文件,其他文件按需加载。Anthropic 的大型代码库指南建议按目录分层指令,使用 claudeMdExcludes 排除你从不工作的文件,阻止读取生成代码,并将 skills 的范围限制在它们服务的包中。
当按目录的文件不再能扩展时,指南建议将约定移入按需加载的 skills、插件或 MCP 服务器中。将这些约定背后的决策保存在你维护的地方,这样它们就不会随文件一起漂移。