
使用浏览器的两种方式
OpenAI 的文档描述了 ChatGPT 桌面应用(Codex 和 ChatGPT Work 均在此运行)中的两个选项。
内置浏览器。 它包含在桌面应用中并自动安装。文档称它“让您和 ChatGPT 在对话中拥有网站和本地 Web 应用的共享视图”。您可以预览页面、在页面上发表评论,或让 ChatGPT 与网站交互。
浏览器扩展程序。 您将其安装在 Chrome、Edge、Brave、Opera 或 Vivaldi 中。随后 ChatGPT 即可在您的常规浏览器中运行,使用您现有的标签页和登录信息。
扩展程序文档总结了 ChatGPT 何时使用哪种工具:它“还可以根据任务需求在工具之间切换,当有专用集成可用时使用插件,当需要已登录的浏览器 context 时使用您的浏览器,而在处理 localhost 时使用内置浏览器”。
可用性说明:内置浏览器文档指出“浏览器在 Codex CLI 或 Codex IDE 扩展中不可用。请打开 ChatGPT 桌面应用以使用内置浏览器”。
内置浏览器可以看到什么
内置浏览器从零开始。文档指出它使用独立的配置文件,“不会自动共享您现有的标签页或浏览器会话”。
这就是为什么开头示例中的仪表板显示登录界面的原因。您的 Chrome 会话并不在那里。文档说明了应对方法:“当任务需要账号时,您可以直接登录。”在“设置 > 浏览器”中,您可以管理浏览器数据以及设备上可用的任何配置文件导入功能。
这种隔离同样适用于历史记录。“内置浏览器保持自己的配置文件和浏览历史记录。结果不会自动包含来自您常规 Chrome 配置文件或其他浏览器的页面。”当您在其地址栏输入时,建议来自内置浏览器自身的历史记录。
这种隔离具有优势。您为一个任务访问的网站不会与您的个人浏览混合,且 ChatGPT 无法在您未登录的账号上执行操作。
扩展程序可以看到什么
扩展程序的工作方式则相反。它在您的常规浏览器配置文件中运行,因此 ChatGPT 可以在您已登录的地方工作。
这带来了内置浏览器所不具备的 context:
- 您的已登录会话。 内部工具、电子邮件以及您每天使用的服务。
- 您打开的标签页。 您可以在桌面应用中提及一个打开的标签页,将该页面作为 context 提供给 ChatGPT。
- 选中的文本。 在支持侧边对话的浏览器中,您可以高亮一段文字并将其带入对话。
侧边对话在 Chrome、Edge、Brave 和 Vivaldi 中可用,但在 Opera 中不可用。文档解释了它如何连接到您的其他对话:“面板会保留在您打开它的标签页中。您在侧边对话中开始的对话可以在 ChatGPT 应用中查看,您也可以在侧边对话中打开最近的 ChatGPT 对话,以便在任何地方继续工作。”
要开始浏览器任务,您可以启动一个 ChatGPT Work 或 Codex 对话,并通过 @ 提及来选择浏览器。文档补充了一个如果您使用多个配置文件时很重要的细节:“请确保您使用的是安装了扩展程序的浏览器配置文件。”
网站权限的工作原理
两种选项在 ChatGPT 对网站执行操作前都会询问,但控制项位于不同位置。
在扩展程序中, 文档指出:“默认情况下,ChatGPT 在与每个新网站交互前都会询问。”您可以选择允许一次、允许此网站、允许所有网站或拒绝。已允许和已屏蔽的域名在“设置 > 计算机使用”下管理,通过选择浏览器旁的“管理”进行操作,支持的浏览器共享这些网站权限。
文档将一个选项标记为高风险。如果您允许所有网站,ChatGPT 在使用网站前将不再询问,因此文档建议仅在您信任 ChatGPT 可以使用浏览器中打开的任何网站时才选择此项。
在内置浏览器中, 浏览、下载和上传的默认权限位于“设置 > 浏览器 > 代理权限”下,并可针对特定网站设置例外。ChatGPT 在执行敏感操作(如提交信息、进行购买、更改权限或删除数据)前也会要求确认。文档补充道:“ChatGPT 无法在内置浏览器中自动执行文件上传。”
在两种情况下,许可并不等同于信任。内置浏览器文档警告:“网站权限允许 ChatGPT 与该网站交互;它并不代表该网站的内容值得信赖,也不代表批准每一项操作。”
为什么浏览器历史记录每次都需要您的许可
浏览历史记录的处理比网站更加谨慎。
在内置浏览器中,文档指出:“在可用时,ChatGPT 可以请求搜索您的浏览历史记录,以查找与当前任务相关的页面。”它会要求您审查该请求,因为“浏览历史记录可能包含内部 URL、搜索词和其他敏感信息,因此仅在任务需要该 context 时才允许”。
在扩展程序中,规则更加严格。文档解释了历史记录访问的含义:“如果您允许 ChatGPT 访问浏览器历史记录,相关的历史记录条目可以成为 ChatGPT 用于任务的 context 的一部分。”
它还解释了为什么请求会重复:“ChatGPT 将历史记录访问范围限定在当前请求中,且历史记录没有‘始终允许’选项。”
因此,开头示例中的第二次请求并非故障。每个想要获取您历史记录的任务都会重新询问,批准一个任务并不代表批准下一个。网站可以被永久允许,但历史记录不行。
OpenAI 存储了哪些浏览内容
扩展程序文档直接回答了这个问题:“OpenAI 不会通过扩展程序存储您浏览器操作的独立完整记录。OpenAI 仅在浏览器活动成为 ChatGPT context 的一部分时才会存储,例如 ChatGPT 从页面读取的文本、截图、工具调用、摘要、消息或对话中包含的其他内容。”
它补充说,您的 ChatGPT 数据控制适用于 context 中处理的内容,并建议不要通过浏览器任务发送机密或高度敏感的数据,除非这些数据是必需的且您在场审查每个 prompt。
因此,对于扩展程序,浏览器任务中保留的内容就是进入对话的内容。ChatGPT 读取的页面成为该对话的一部分,没有关于您浏览器操作的独立完整记录。
对于内置浏览器,其自身历史记录保留在该浏览器中。当您的组织允许时,您可以在“设置 > 浏览器”中搜索、重新打开页面或删除条目,“清除浏览数据”允许您选择时间范围和要删除的数据类型。
Memory 如何应用于浏览器任务
扩展程序文档中有一个关于 memory 的简短章节:“计算机使用遵循您的 Memories 设置。如果 Memories 开启,ChatGPT 在您的浏览器中工作时可以使用相关的已保存 memories。如果 Memories 关闭,浏览器控制则不使用 memories。”
因此,您的 memory 设置会延续到浏览器工作中。如果 ChatGPT 通过 memory 知道您正在处理哪个项目或您喜欢的报告格式,它可以在您的浏览器中工作时利用这些信息。
浏览器任务从 ChatGPT Work 或 Codex 对话开始。我们在 ChatGPT Work 模式 指南中介绍了 Work 与 Chat 及 Codex 共享的内容,包括 memory、项目和历史记录。
针对不同任务该使用哪种方式
文档的指导指向了一个简单的划分:
- 本地开发页面: 使用内置浏览器。它是处理 localhost 的官方选择,并支持对页面元素发表评论和开发者模式。
- 无需登录的公共页面: 内置浏览器可以将任务与您的个人浏览分开。
- 已登录的工具: 使用扩展程序,它使用您现有的会话。
- 您正在阅读的页面: 使用扩展程序的侧边对话或标签页提及。
- Codex Cloud 任务: 当云任务拥有浏览器访问权限时,使用云任务内部的浏览器来检查您的 Web 应用、复现 bug 或验证修复。
如果扩展程序无法连接
文档的故障排除步骤首先从黑名单开始,然后涵盖常见原因:
- 更新 ChatGPT 桌面应用,并更新或删除多余的副本。
- 重启浏览器并检查侧边对话是否加载。
- 确认浏览器在“设置 > 计算机使用”下显示“管理”。
- 使用安装了扩展程序的浏览器配置文件。
- 开始一个新的 ChatGPT Work 或 Codex 对话。文档称这“可以清除特定于对话的连接状态”。
- 重启桌面应用,并在需要时重新安装扩展程序。
人们首先会尝试的操作
期望内置浏览器已登录。 它使用独立的配置文件。请在那里登录,或使用扩展程序。
在不同的浏览器配置文件中使用扩展程序。 它仅在安装了它的配置文件中工作。
在 Codex CLI 中寻找内置浏览器。 它位于 ChatGPT 桌面应用中。
期望历史记录访问权限被记住。 历史记录没有“始终允许”选项。
允许所有网站以停止询问。 文档将此标记为高风险选择。
解决方案:根据任务所需的可见范围选择浏览器
第 1 步:确定任务是否需要您的登录信息
对于已登录的工具使用扩展程序,其他所有任务使用内置浏览器。
第 2 步:审慎设置网站权限
逐个允许网站,并为 ChatGPT 不应使用的域名保留黑名单。
第 3 步:仅在需要时批准历史记录
审查每个历史记录请求,因为历史记录条目可能会成为任务 context 的一部分。
第 4 步:写下任务应该了解的信息
记录下您原本会让 ChatGPT 在历史记录中寻找的细节,例如哪个仪表板重要以及使用哪个账号。
在 MemoryLake 中进行设置
浏览器历史记录是您所看内容的粗略记录。任务实际需要的 context(例如哪个内部仪表板是事实来源、报告属于哪个账号,或者哪个页面替换了旧页面)最好作为您编写的简短笔记保存,而不是每次都在历史记录中搜索。
MemoryLake 是此类工作 context 的记忆层,例如资源位置、您信任的来源以及背后的决策,保存在一个由您维护的地方,并可供您连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
您可以用自己的语言亲自编写条目。不会从您的浏览器配置文件、浏览历史记录、登录信息、ChatGPT memories、Codex 对话或任何供应商的存储中读取、写入或删除任何内容。内置浏览器和扩展程序仍按 OpenAI 描述的方式工作。
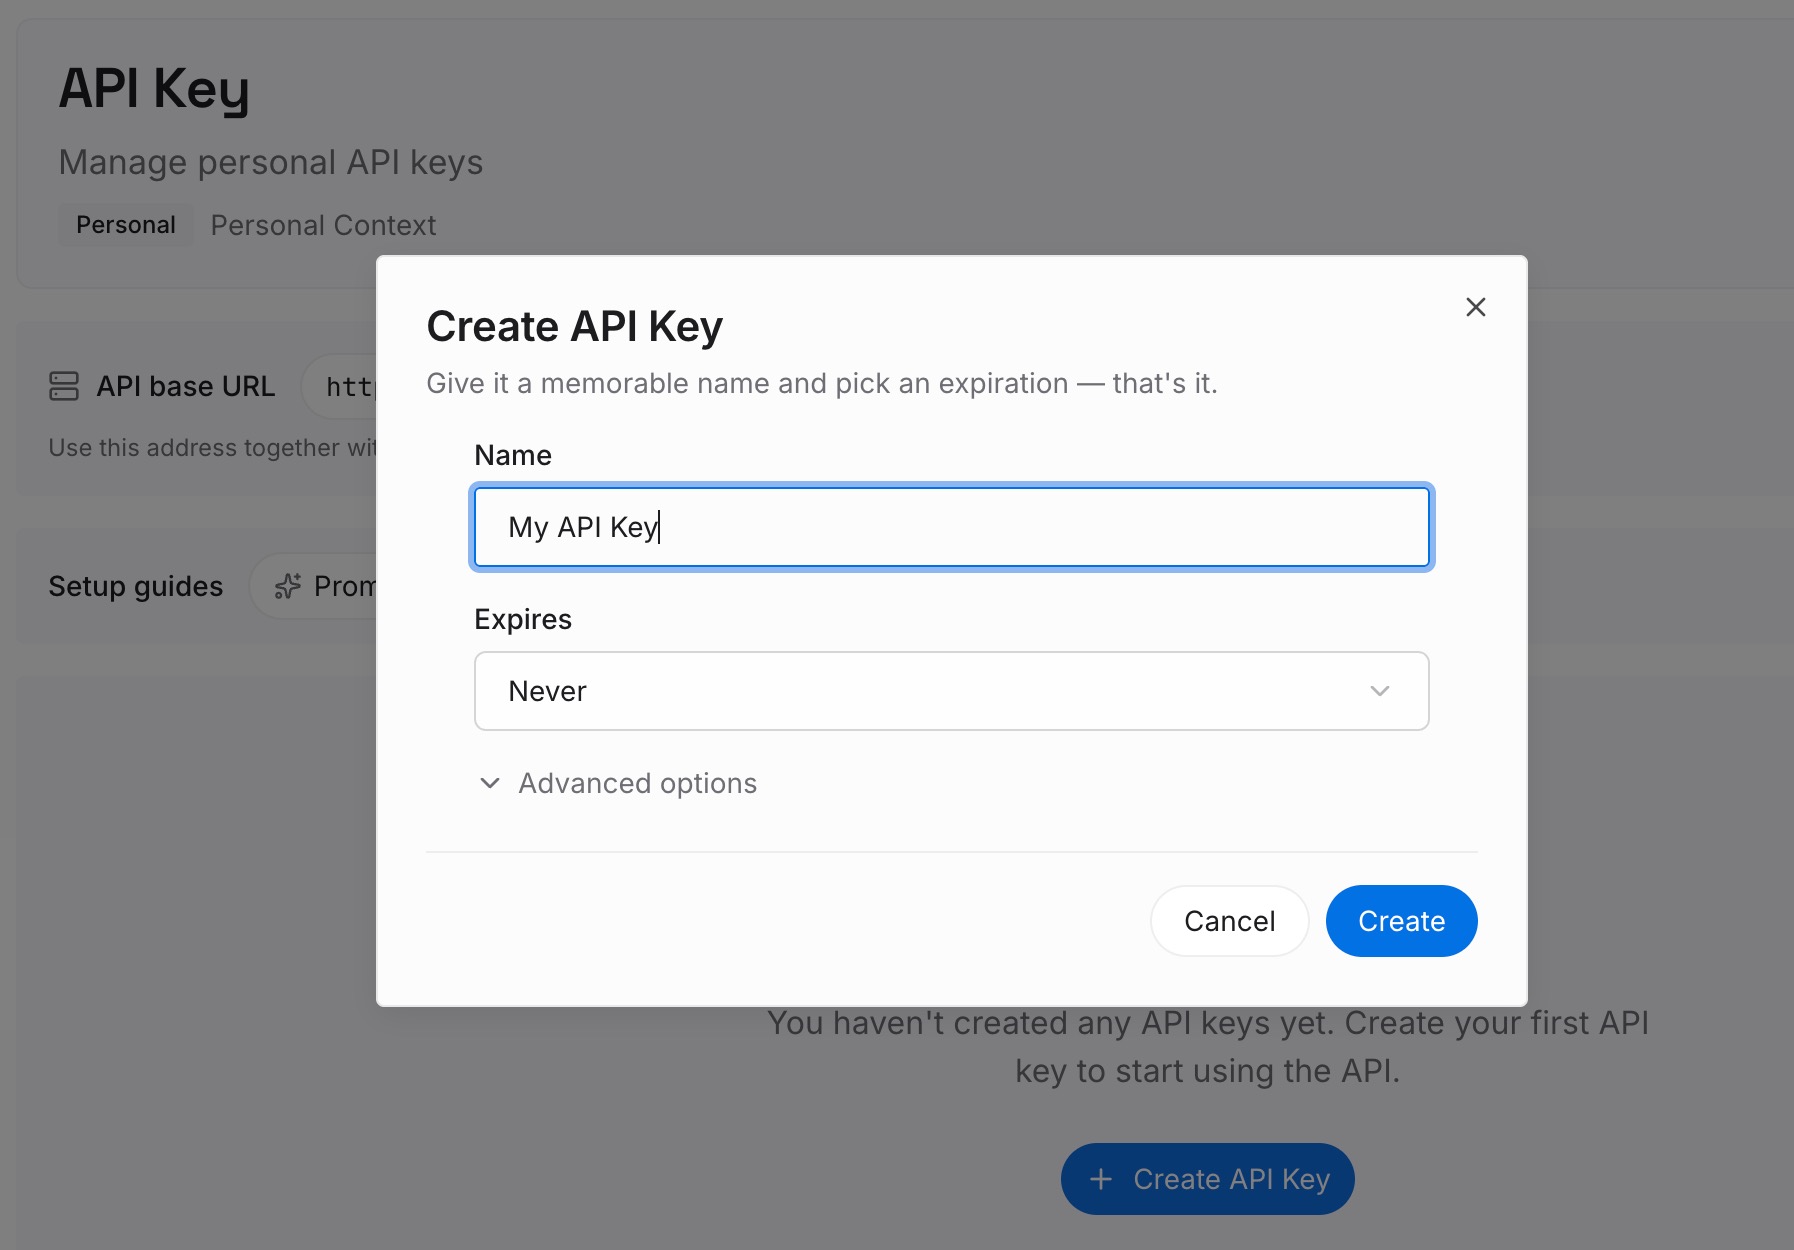
第 1 步:创建 API 密钥
登录并从仪表板生成密钥。像对待其他凭据一样将其存储在私密处。
第 2 步:上传您的第一条 memories
从您在解决方案第 4 步中写下的内容开始:哪些页面和账号对您的工作很重要。每个条目一个来源。
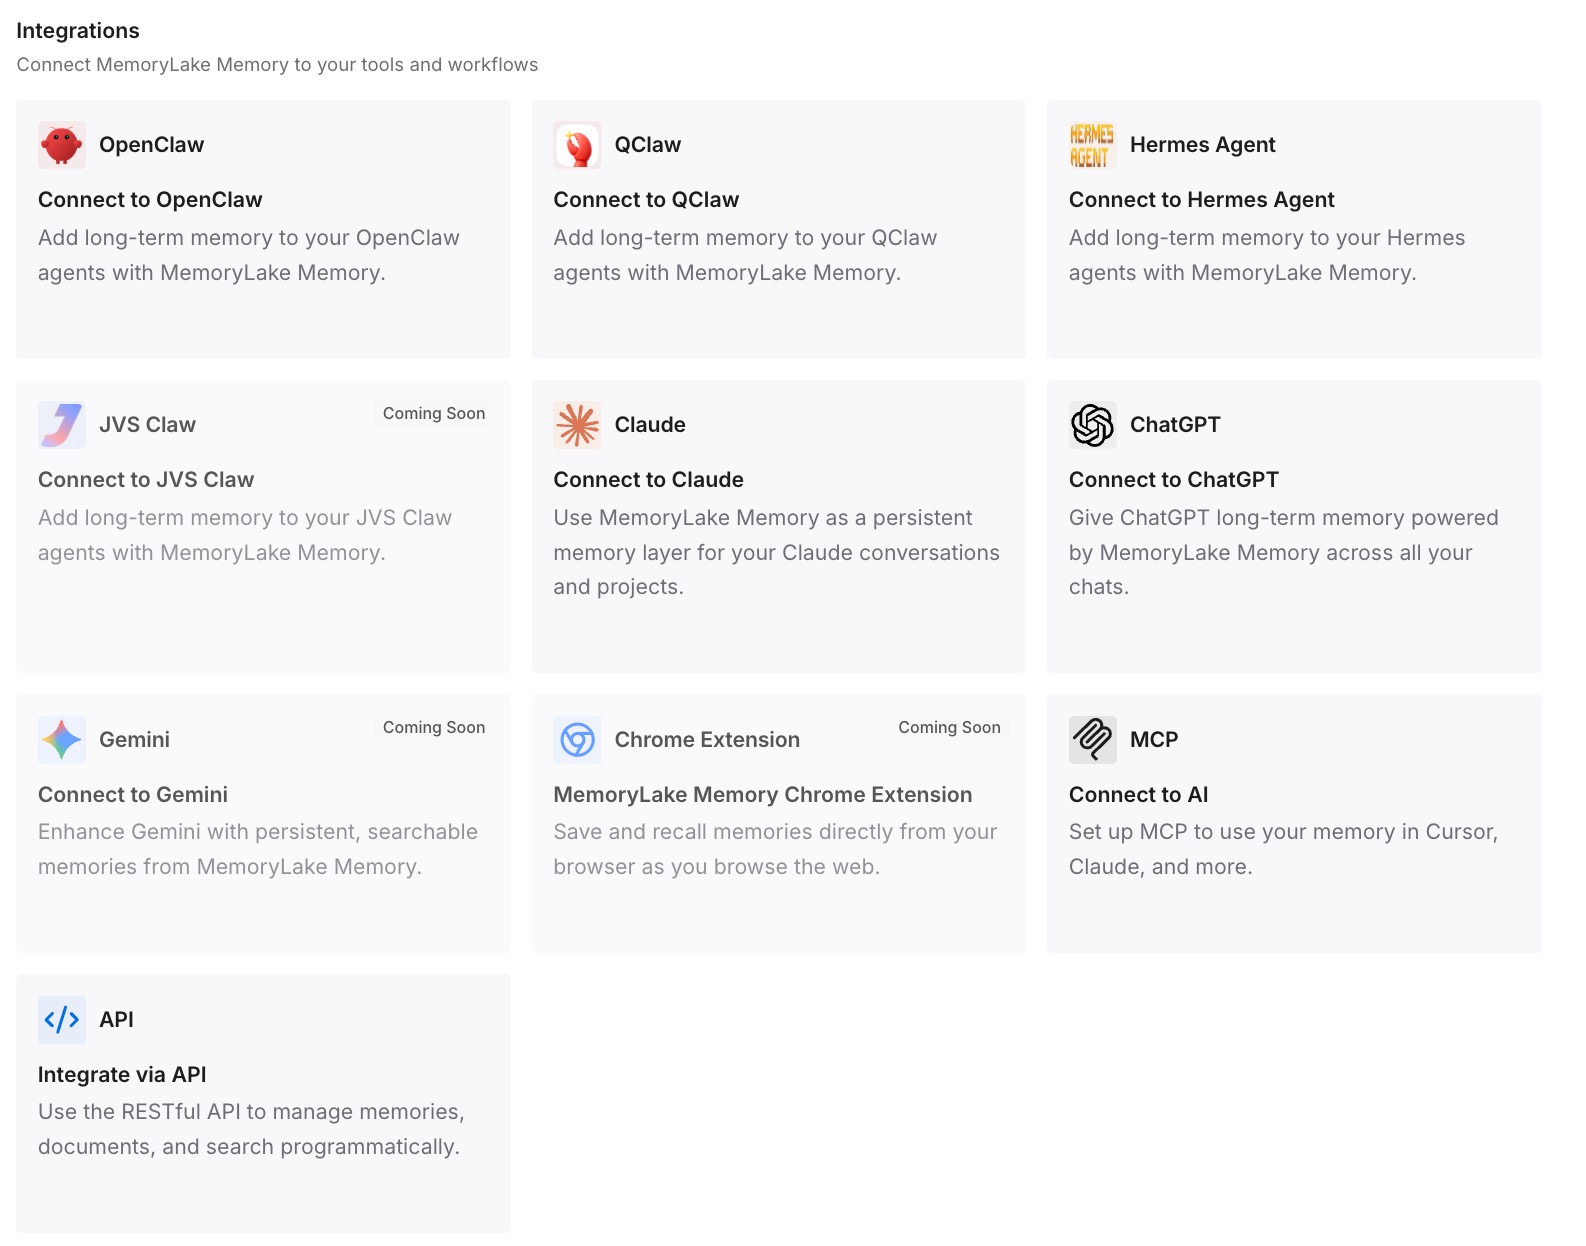
第 3 步:连接您的 AI 和 agents
连接 Codex、ChatGPT 以及您使用的其他助手。每个助手都可以调用关于资源位置的相同笔记。
这在实践中改变了什么
第一个区别是历史记录请求减少了。任务已经知道哪个页面重要。
第二个区别是结果更加一致。每次都会引用相同的来源。
第三个区别是工具之间的一致性。在 ChatGPT 和 Codex 之外也可以使用相同的笔记。
Codex 和 ChatGPT Work 浏览器任务的最佳实践
对 localhost 使用内置浏览器。 它是处理本地页面的官方选择。
对已登录工具使用扩展程序。 它在您的常规配置文件中运行。
保持狭窄的网站权限。 按网站允许,而不是允许所有网站。
将历史记录视为敏感信息。 仅在任务需要时批准。
不要在浏览器任务中涉及机密。 OpenAI 建议除非必需且受监督,否则不要发送机密信息。
检查配置文件。 扩展程序仅在安装它的地方工作。
完成后清除内置浏览器数据。 使用“设置 > 浏览器”中的“清除浏览数据”。
结论
Codex 和 ChatGPT Work 可以通过两种方式使用浏览器。ChatGPT 桌面应用中的内置浏览器使用自己的配置文件和历史记录,不共享您的标签页或会话,是处理本地页面的官方选择。浏览器扩展程序则在您的常规 Chrome、Edge、Brave、Opera 或 Vivaldi 配置文件中运行,您已在其中登录。
网站权限可以一次性、按网站或为所有网站授予,但浏览器历史记录访问权限仅限于每个请求,且没有“始终允许”选项。OpenAI 仅在浏览器活动成为对话 context 的一部分时才会存储,且计算机使用遵循您的 Memories 设置。根据任务需要查看的内容选择浏览器,并将您原本需要搜索的细节保存在自己的笔记中。