
Codex 0.165.0 发生了哪些变化
发布说明在“新功能”下列出了两项记忆相关条目:
- Memory v2 是新配置文件的默认版本。
- Codex 可以将外部智能体的记忆导入 v2。
背后的拉取请求(Pull Request)比发布说明透露了更多信息。第一个标题为“将新记忆配置文件默认设置为 v2”的请求给出了理由:“没有 v1 记忆工作区的配置文件在开始使用 v2 之前,没有需要保留或合并的旧上下文。”
第二个请求解释了之前存在的问题:“外部智能体记忆导入以前仅写入 v1 工作区并仅排队 v1 合并,导致 v2 流水线缺少导入的资源。”
因此,在此版本之前,运行 v2 流水线的机器即使从其他智能体导入记忆,导入的内容也无法到达 v2。0.165.0 版本弥补了这一差距,同时让 v2 成为没有旧记忆需要继承的机器的起点。
哪些保持不变
在深入研究版本之前,先区分一下更新未改变的内容是有帮助的。
记忆默认仍处于关闭状态。 Codex 文档指出:“本地 Codex 记忆默认关闭。”您可以在 ChatGPT 桌面应用的“设置 > 个性化”中通过“启用 Codex 记忆”来开启,或者通过 config.toml 中的功能标志开启。版本更改仅在开启记忆后才有意义。
记忆仍然是本地的。 文档称“本地 Codex 客户端使用独立的本地记忆存储和控制”,而 ChatGPT 网页版则使用 ChatGPT 记忆。发布说明并未描述两者之间有任何关联。
文件仍然是生成的中间状态。 OpenAI 的指导意见没有改变:“将这些文件视为生成的中间状态。您可以在排除故障或共享 Codex 主目录之前检查它们,但不要依赖手动编辑它们作为主要的控制手段。”
逐会话控制的工作方式保持不变。 /memories 控制当前对话是否可以使用现有记忆以及是否可以为未来的记忆做出贡献,并且“对话级别的选择不会改变您的全局记忆设置”。
您的机器使用哪个记忆版本
Codex 随附的配置架构现在用一句话描述了版本设置:“选择记忆流水线。启用记忆时,新配置文件默认使用 v2,除非明确禁用了双写(dual-write);现有的 v1 配置文件默认使用 v1。”
拉取请求给出了 Codex 执行的确切测试逻辑:“当启用记忆且 memories 目录不存在时,选择 v2。”它还列出了保持不变的情况:“保留显式的 memories.version 设置、memories.dual_write = false 的退出选项,以及现有工作区或文件系统检查错误时的 v1 默认值。”
通俗地说,当记忆开启时,Codex 会查看您的 Codex 主目录:
- 尚无
memories目录。 Codex 将该配置文件视为新配置文件并使用 v2。 - 已存在
memories目录。 Codex 让您留在 v1,以便继续使用已建立的记忆。 - 您自行设置了版本。 Codex 会尊重您的设置。
- Codex 无法检查文件系统。 它会回退到 v1。
决定因素是目录,而不是您安装 Codex 的日期。如果一个安装了数月的实例因为从未启用记忆而没有 memories 目录,那么根据拉取请求的规则,当您开启记忆时,它将进入 v2。
双写(dual-write)意味着什么
架构将第二个设置 memories.dual_write 描述为:“在选择 v1 时同时生成两个版本;切换后 v2 独立运行。”
这描述了一个过渡期。处于 v1 的机器可以同时构建 v2 记忆,这样在迁移到 v2 时就已经有内容可用了。将 memories.dual_write 设置为 false 是默认设置所尊重的选择之一,在这种情况下,新配置文件默认不会迁移到 v2。
memories.version 和 memories.dual_write 目前都尚未出现在 Codex 配置参考文档中。两者都源自架构和拉取请求,因此请将其视为可能仍会发生变化的当前行为。
每个版本的文件存放在哪里
文档记录的位置是 v1 存储库:“主要的记忆文件位于 ~/.codex/memories/ 下,包括摘要、持久条目、近期输入以及来自先前对话的辅助证据。”
v2 工作区是一个独立的目录。导入拉取请求通过名称引用它:“始终将选定的资源导入 memories_v2。”如果您使用 CODEX_HOME 移动了 Codex 主目录,则这两个目录都将位于该位置,而不是 ~/.codex。
一个微小的变化影响了重置操作。拉取请求称,它使“重置不存在的记忆工作区成为空操作,这样就不会创建一个未使用的 v1 目录”。在全新机器上重置记忆不再会留下一个空的 memories 文件夹,从而避免让 Codex 误以为该配置文件处于 v1。
导入的 Claude Code 记忆存放在哪里
Codex 的导入流程将另一个智能体的设置和近期工作带入 ChatGPT 桌面应用或 Codex CLI。导入文档列出了可以迁移的内容。指令文件变为 AGENTS.md,设置变为 config.toml,而记忆这一行显示:来自 Claude Code 的项目记忆,目标位置为 Memories。
导入拉取请求描述了这些记忆现在会发生什么:
“始终将选定的资源导入 memories_v2。当选择 v1 或存在旧版工作区时,同时也更新 memories。”
因此:
- 在 v2 配置文件上,导入的记忆进入
memories_v2。 - 在 v1 配置文件上,它们会进入两者。Codex 将它们写入您当前使用的流水线的
memories,同时也写入memories_v2以备后用。
导入后,Codex 会为它更改的每个工作区排队执行一次合并任务。拉取请求称它将“为每个更新的命名空间分别排队合并”,并使合并导入记忆的指令适应“活动流水线的输出格式”。导入的记忆是原始材料,Codex 会将其折叠进自己的记忆格式中,而不是原样复制文件。
同一版本中的第三个拉取请求阻止了导入和合并任务同时更改同一个工作区。如果目标位置正在使用中,Codex 将“如果目标位置被锁定,则返回可重试的忙碌错误,并在工作区忙碌时跳过合并”。如果导入报告忙碌,请稍后再次运行。拉取请求自带的测试确认,在这种情况下不会发生文件只写了一半的情况。
导入不会触及的内容
导入文档指出:“导入不会更改或删除您现有的智能体设置。”您的 Claude Code 记忆文件将保留在原处。
CLI 导入也有一些在规划前值得了解的限制。“Codex CLI 最多导入过去 30 天内的 50 条对话。” 并且 /import “在运行任务期间、远程会话中或连接到本地应用服务器守护程序时不可用”。在桌面应用中,您可以在“设置 > 导入”中开启自动更新,以保持导入的工作与原始智能体同步,并在那里查看您的导入历史。对于更广泛的迁移,我们的从 Claude Code 迁移到 Codex 指南涵盖了指令、MCP 服务器和技能。
文档尚未说明的内容
发布说明、架构和拉取请求都描述了 v2。但 Codex 文档中的记忆页面仍然描述 ~/.codex/memories/ 下的单一存储库。
这留下了一些悬而未决的问题:
- v2 在记忆质量方面有哪些改进。 拉取请求描述了 v2 文件的去向以及 Codex 何时使用它,但未说明其记忆在内容上有何不同。
- v1 机器如何迁移到 v2。 架构提到了切换(cutover),但发布说明和文档均未描述何时或如何发生。
- 桌面应用是否显示版本。 文档中描述的“个性化”设置并未提及版本信息。
在文档更新之前,Codex 主目录中的文件夹是判断您的机器正在使用哪个版本最直接的迹象。该版本中的另一个拉取请求为应用添加了一种实验性方式,可以从“线程解析的记忆版本”读取对话的记忆摘要,且“不会回退到另一个版本”。这是一个开发者接口,但它确认了两个版本是分开保存而非合并的。
人们最常尝试的操作
误以为更新自动开启了记忆。 并没有。记忆在您启用之前仍处于关闭状态;更新只是决定了您开启记忆时会获得哪个版本。
误以为每台机器都迁移到了 v2。 只有没有现有 memories 目录的配置文件才会从 v2 开始。拥有 v1 记忆的机器默认保持在 v1。
通过编辑记忆文件来修复 Codex 的记忆。 OpenAI 要求您将其视为生成的中间状态。由于存在两个工作区,在一个文件夹中手动编辑的内容可能并不是活动流水线所读取的内容。
期望导入的记忆逐字显示。 它们会经过 Codex 自身格式的合并处理。
将 Codex 主目录复制到新电脑并期望版本一致。 您复制的文件夹决定了版本。我们的将 Codex 迁移到新电脑指南涵盖了需要携带的内容。
解决方法:检查版本、有目的地导入,并让规则脱离记忆
第 1 步:在开启记忆前后查看您的 Codex 主目录
打开您的 Codex 主目录(除非设置了 CODEX_HOME,否则为 ~/.codex),并记录存在哪些记忆文件夹。memories 文件夹意味着 v1 工作区。memories_v2 文件夹意味着存在 v2 文件,这可能是因为您处于 v2,或者是因为双写或导入创建了它们。
如果您准备在从未运行过记忆的机器上启用记忆,请预期会使用 v2。如果您想暂时保留文档记录的 v1 行为,拉取请求的规则意味着显式的 memories.version 设置会被尊重,但由于该键尚未出现在配置参考中,请在依赖它之前检查您版本的发布说明。
第 2 步:在导入前检查您要导入的内容
Claude Code 将其自身的自动记忆以纯 Markdown 格式保存在 ~/.claude/projects/<project>/memory/ 下,并带有一个 MEMORY.md 索引。在运行导入之前,打开该项目文件夹并阅读它。其中任何过时的内容都会成为 Codex 合并到自身记忆中的材料。
然后只导入您需要的内容。在 CLI 中,从本地会话运行 /import 并选择 Claude Code。在桌面应用中,打开“设置 > 导入”。如果导入提示工作区忙碌,请稍后重试。
如果您是从 ChatGPT 端迁移上下文,我们的将 ChatGPT 记忆迁移到 Codex 指南解释了为什么该路径的工作方式不同。
第 3 步:将必须执行的规则保留在 AGENTS.md 中
记忆文档对此非常直接:“将团队所需的指导保留在 AGENTS.md 或签入的文档中。将记忆视为有用的召回层,而不是必须始终执行的规则的唯一来源。”
版本更改是检查这一建议的好时机。如果某个约定仅存在于 Codex 记忆中,或仅存在于 Claude Code 的自动记忆中,请将其写入 AGENTS.md 或您的代码库文档中,这样每个会话和每个版本都能以相同的方式读取它。我们的 Codex 跳过 AGENTS.md 规则指南涵盖了 Codex 如何查找这些文件。
在 MemoryLake 中设置
Codex 现在有两个本地记忆工作区,而 Claude Code 每个项目都有自己的记忆文件夹。每个工作区都由其工具以该工具的格式在单台机器上生成。您希望每个智能体都遵循的决策需要一个不依赖于机器恰好处于哪个流水线的位置。
MemoryLake 是一个记忆层,用于将此类上下文保存在您维护的一个列表中,供 Codex 以及您连接的其他助手(如 Claude Code 和 ChatGPT)使用。
您可以用自己的语言亲自编写条目。不会从 ~/.codex/memories/、memories_v2、Claude Code 的自动记忆、您导入的设置或任何供应商的存储库中读取、写入或删除任何内容。Codex 自身的记忆将继续按照 OpenAI 描述的方式工作。
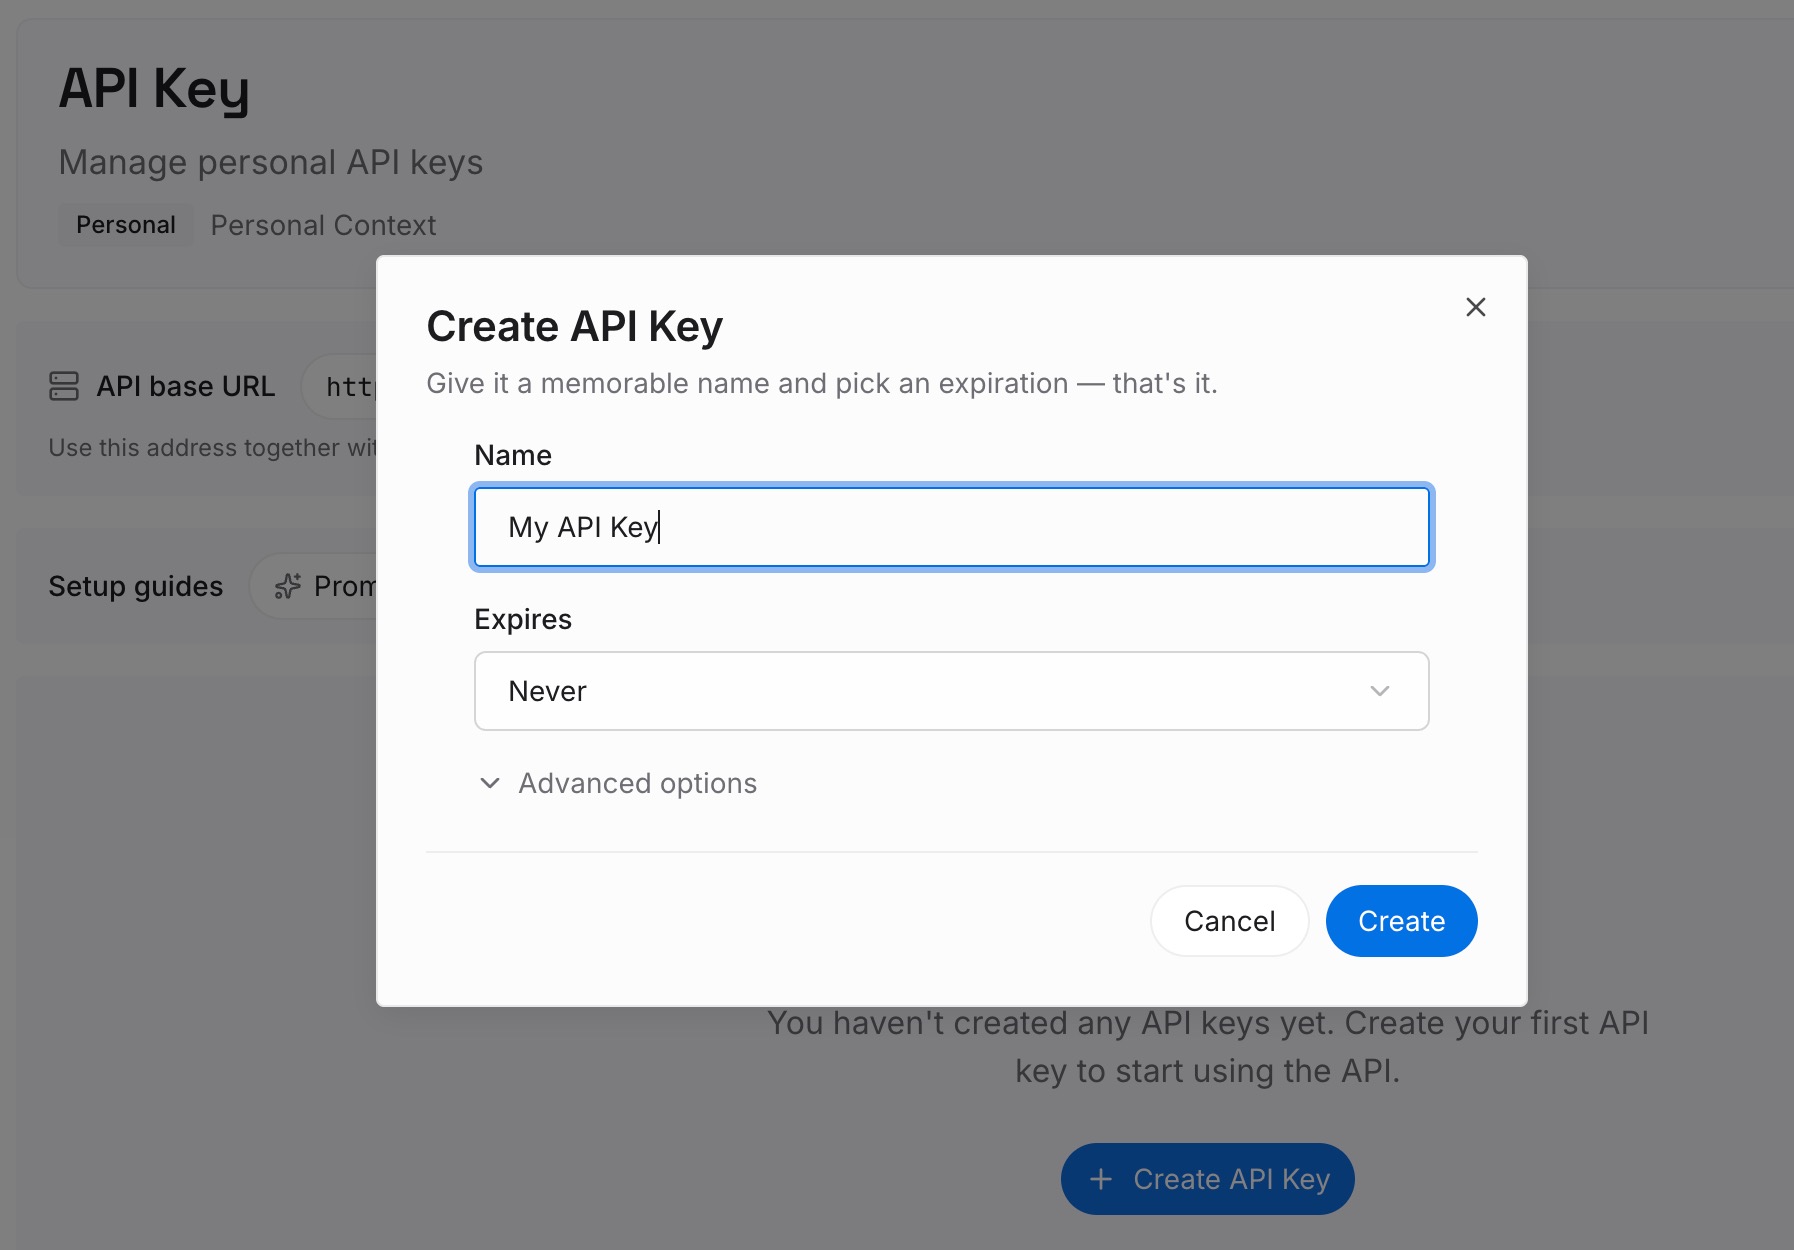
第 1 步:创建 API 密钥
登录并在控制面板中生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 ChatGPT 账号和 Codex 配置是分开的。
第 2 步:上传您的第一批记忆
从您在解决方法的第 2 步中检查的内容开始:那些值得从 Claude Code 记忆中保留的约定、决策和已知陷阱。每个条目一个要点,注明日期,并标记其适用的代码库。
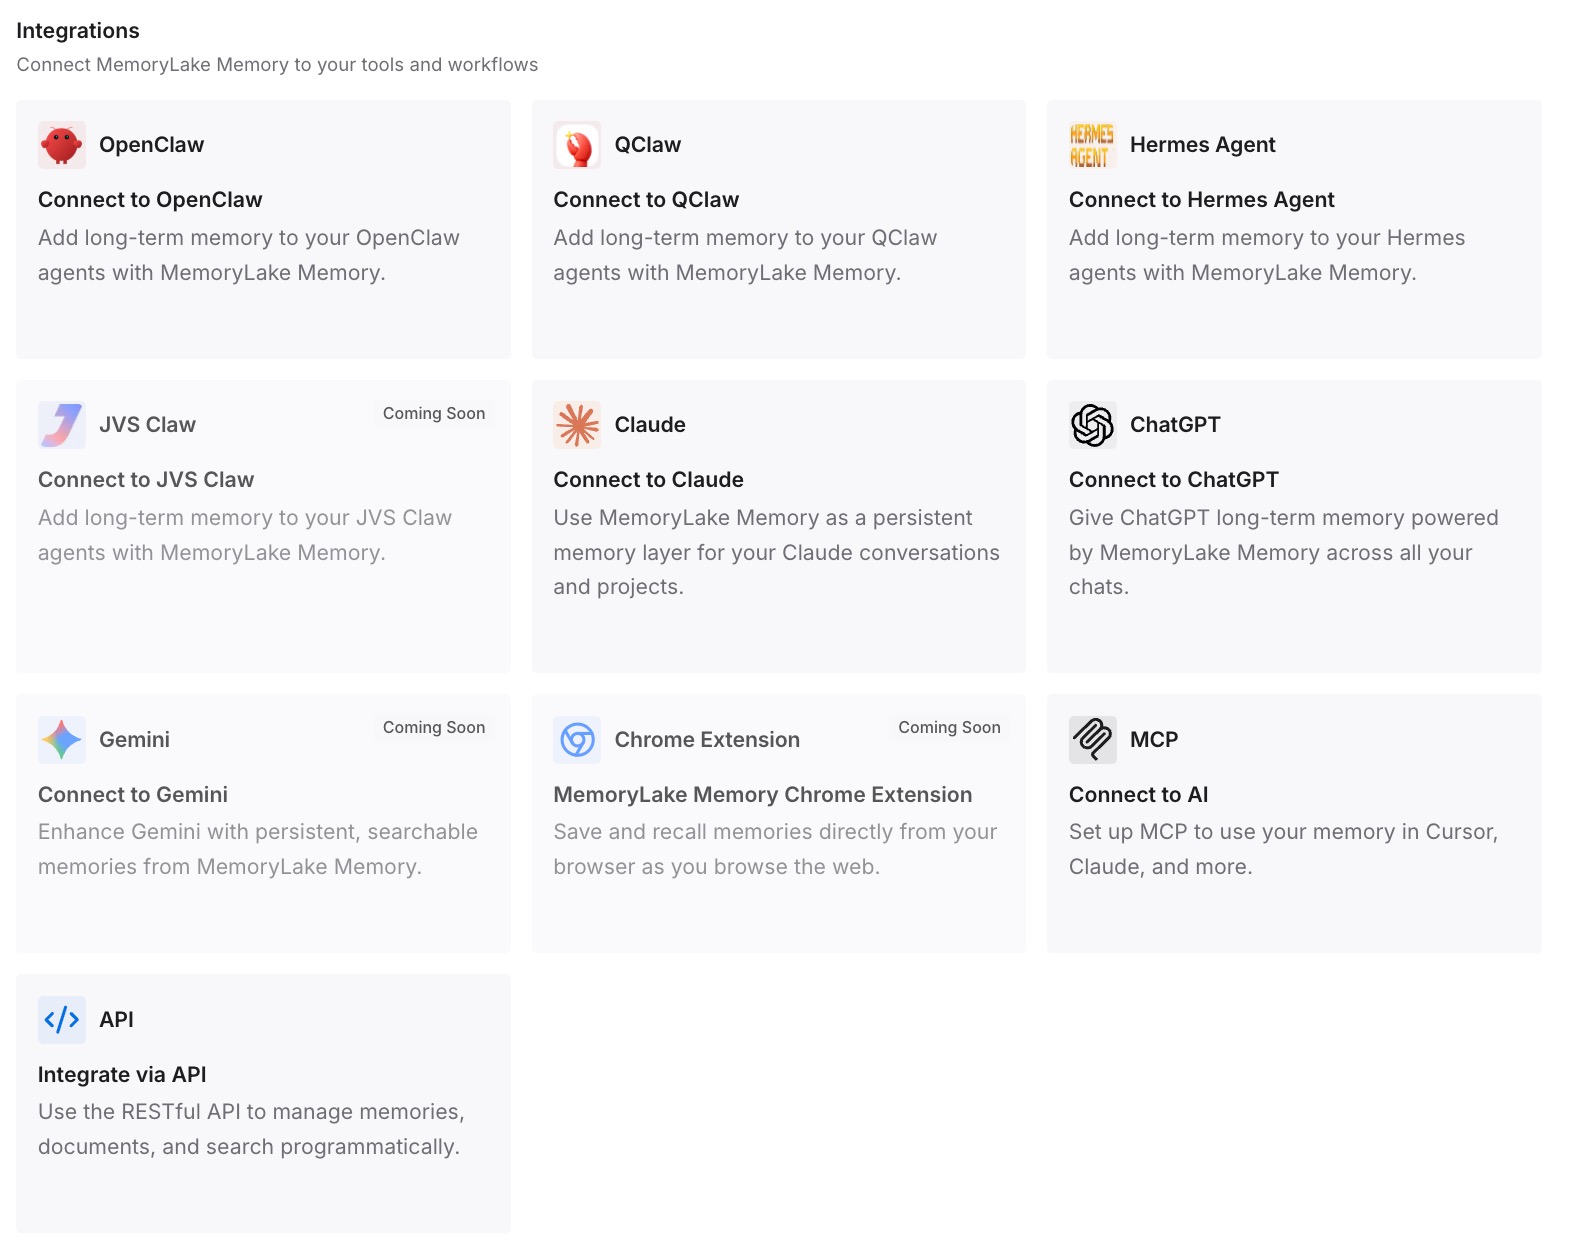
第 3 步:连接您的 AI 和智能体
连接 Codex 和您使用的其他助手。当机器更改记忆版本或您切换工具时,您依赖的上下文将保持不变。
这在实践中改变了什么
第一个区别是您知道自己正在查看哪个存储库。memories 文件夹和 memories_v2 文件夹不是一回事,更新会根据磁盘上已有的内容在两者之间做出选择。
第二个区别是导入不再神秘。在 v1 上,它们进入两个工作区;在 v2 上,它们进入一个;无论哪种方式,Codex 都会以自己的格式重写它们。
第三个区别是您依赖的规则不会随版本迁移。它们位于 AGENTS.md 和您的文档中,无论记忆流水线如何,Codex 都会读取它们。如果您正在寻找对话记录而不是记忆,我们的查找缺失的 Codex 对话历史指南涵盖了这些记录的存放位置。
0.165.0 之后 Codex 记忆的最佳实践
检查您的 Codex 主目录是否存在 memories 和 memories_v2。 文件夹会告诉您现状。
不要假设现有机器会自动使用 v2。 v1 工作区默认会让您留在 v1。
在导入前阅读 Claude Code 的记忆文件。 过时的笔记会变成过时的记忆。
重新运行报告工作区忙碌的导入。 它被设计为可重试的。
不要动生成的文件。 使用 /memories、个性化设置或重置功能代替。
将必需的规则放入 AGENTS.md。 记忆只是一个召回层。
关注发布说明。 文档尚未描述 v2,因此发布说明是变化最早出现的地方。
结论
Codex 0.165.0 将 memory v2 设置为尚未拥有 v1 记忆工作区的配置文件的默认版本,并将从 Claude Code 导入的记忆发送到 v2。已有 v1 记忆的机器默认保持在 v1,且那里的导入会同时写入两个工作区。记忆默认仍处于关闭状态,仍然是本地的,并且仍然是不应手动编辑的生成文件。
检查您的 Codex 主目录包含哪些文件夹,在导入前检查 Claude Code 的记忆,并将必须始终适用的规则保留在 AGENTS.md 中。