
什么是 Record & Replay
OpenAI 的描述是:“Record & Replay 让您可以在 Mac 上演示工作流,并将其转化为可重复使用的 Skill。当工作流具有重复性、依赖于您的偏好,或者演示比在提示词中描述更容易时,请使用它。”
文档中的示例都是日常任务:报销费用、预订停车位、创建配置正确的 Issue、发布视频或下载定期报告。
输出结果并不是一段供你回放的录像。它是一个 Skill,即一组指令,ChatGPT 或 Codex 下次会使用届时可用的任何工具来执行这些指令。Skill 文档将其描述为创建 Skill 的方式之一:“录制器捕获工作流,检查步骤,并根据演示起草一个可重复使用的 Skill。”
在何处可用
Record & Replay 有两个要求,如文档顶部所述:“Record & Replay 在 macOS 上可用。Computer Use 也必须可用且已启用。”
它可以在 ChatGPT 桌面应用中使用,无论是开启了 Work 模式的 ChatGPT 还是 Codex。OpenAI 的变更日志记录了 7 月 31 日的一次扩展:“Record & Replay 现已在欧盟、英国和瑞士可用。”
对于组织,还有一个开关。如果 Codex 是通过 requirements.toml 管理的,文档称 Computer Use 的要求也控制着 Record & Replay,将其设置为 false 会“使这两个功能都不可用”。
如何录制工作流
文档列出了以下步骤:
- 在 ChatGPT 桌面应用中,选择 ChatGPT 并开启 Work,或选择 Codex。然后打开 Plugins。
- 打开加号菜单并选择 Record a skill。
- 查看建议的提示词,添加任何有帮助的上下文,然后提交。
- 准备就绪后,批准录制请求。
- 在您的 Mac 上执行工作流。
- 从菜单栏或叠加层停止录制,或者告诉对话框您已完成。
文档在开始前的建议是:“选择一个您已经知道如何完成的工作流。当步骤稳定且成功标准明确时,Record & Replay 的效果最好。”
录制捕获的内容
文档用一句话描述了录制过程:“在录制期间,ChatGPT 或 Codex 会观察学习该工作流所需的动作和窗口内容。”
随后提到了两个细节:
- 它会一直运行直到你停止。 “录制会持续到您停止为止。”文档建议让录制专注于您希望该 Skill 教授的任务。
- 它能看到屏幕上的内容。 由于 Record & Replay 依赖于 Computer Use,因此 Computer Use 的文档也具有参考价值。它提到 Computer Use 可以查看屏幕内容并截屏,并要求您将可见的应用内容、浏览器页面、截图和打开的文件视为“ChatGPT 在任务运行时可能处理的上下文”。
在数据处理方面,Computer Use 文档称您的 ChatGPT 数据控制适用于通过 ChatGPT 处理的内容,“包括 Computer Use 拍摄的截图”。Record & Replay 页面本身并未说明录制的保存时长,因此数据控制设置是查看该信息的地方。
起草的 Skill 中包含什么
停止录制后,产品会将录制内容转化为指令。“停止录制后,ChatGPT 或 Codex 会检查捕获的工作流并起草一个 Skill。该 Skill 会解释何时使用该工作流、需要哪些输入、遵循哪些步骤以及如何验证结果。”
这赋予了 Skill 四个部分:
- 何时使用它,以便产品能识别匹配的请求。
- 需要的输入,例如文件、日期范围或 Issue 标题。
- 步骤,以指令形式编写,而非录制的点击动作。
- 如何验证结果,以便它可以检查自己的工作。
在草案编写完成后,您可以要求进行精简。
Codex 中的 Skill 是一个包含 SKILL.md 文件的文件夹,Skill 文档规定该文件必须包含名称和描述。描述对于自动使用最为重要。当请求匹配时,ChatGPT 和 Codex 可以选择一个 Skill,因此文档建议编写“范围和边界清晰的简练描述”。
回放如何工作
回放并不会重复你的点击动作。文档说明要“开启一个新的 ChatGPT 或 Codex 对话,并要求它使用生成的 Skill”。你需要提供这次不同的数值,例如要上传的文件或报告的日期范围。
“产品将该 Skill 作为任务的可重复使用上下文。”然后,它会利用当前环境中可用的工具(包括 Computer Use、浏览器操作和已安装的插件)来完成工作流。
你也可以直接调用 Skill。Skill 文档提到 ChatGPT 支持使用 @ 提及 Skill,而 Codex 支持使用 $ 提及。
Skill 在 Codex 中的存放位置
Record & Replay 页面没有说明起草的 Skill 保存在哪里。Skill 文档列出了 Codex 加载本地 Skill 的位置:
- 代码仓库:工作目录中的
.agents/skills以及向上直到仓库根目录的每个文件夹。 - 您的用户文件夹:
$HOME/.agents/skills,适用于在任何仓库中都生效的 Skill。 - 管理员位置:
/etc/codex/skills,在机器上共享。 - 系统 Skill:随 Codex 捆绑提供。
如果您手动编写或编辑 Skill,“Codex 会自动检测 Skill 的更改。如果更新未出现,请重启 Codex。”要关闭 Skill 而不删除它,文档描述了在 ~/.codex/config.toml 中的 skills.config 条目。
如果您一直在 Codex 中使用旧的自定义提示词,那么 Skill 就是此类可重复使用指令现在所属的地方。我们在将 Codex 自定义提示词转换为 Skill 的指南中介绍了如何迁移它们。
录制可能遗漏的偏好
这就是开头示例中的差距。录制显示了你做了什么,但并不总是能显示原因,或者哪些选择是刻意为之的。
文档指出了录制后需要添加的三件事:命名规范、字段默认值和决策点。在实践中,这涵盖了:
- 你默默做出的选择,比如你下意识输入的特定文件名格式。
- 你接受的默认值,即这次恰好预填了正确数值的地方。
- 你未选择的分支,例如当报告为空或文件夹已满时该怎么办。
- 录制前的提示也有帮助:“在开始录制前,说明您的目标以及在不同 Skill 使用场景下可能变化的任何特定输入。”以及“保持演示简短且完整。”
更广泛的区别在于流程与上下文之间。Skill 捕获的是如何执行任务。关于 Skill 和插件的文档将其描述为一种“减少在每个对话中粘贴相同提示词、模板、要求或流程的需求”的方法。而你选择背后的原因,以及它们随时间变化的方式,则是另一种知识。
防止秘密进入录制
文档的建议非常直接:“使用真实的输入,但避免秘密和敏感数据。”
Computer Use 指南增加了一些在录制时适用的习惯:
- 除非任务需要,否则保持敏感应用处于关闭状态。
- 避免需要秘密的任务,除非你在场并能批准每个步骤。
- 在涉及账户、安全、隐私、支付或凭据相关的设置时保持在场。
它还列出了限制:Computer Use 无法自动化终端应用或 ChatGPT 本身,也无法以管理员身份进行身份验证,或批准计算机上的安全和隐私权限提示。
何时应构建插件
Record & Replay 为您创建一个 Skill。为了在团队中共享,文档建议使用不同的包:“如果您想在团队中分发独立的稳定包、捆绑多个 Skill、包含连接器、添加 MCP 服务器或管理安装元数据,请将该工作流打包为其专属插件。”
人们最初的误区
期望回放能重复完全相同的点击。 它遵循的是 Skill,并使用当时可用的工具。
在 Windows 上录制。 Record & Replay 仅在 macOS 上可用。
录制一段混合工作的长会话。 保持演示简短且专注。
使用真实密码或私密数据。 使用真实但不含秘密的输入。
假设 Skill 知道你的规范。 录制后需添加隐藏的偏好设置。
解决方案:录制步骤,然后写下偏好
第 1 步:录制前说明你的目标
说明该工作流的用途,以及哪些输入在不同运行之间会发生变化。
第 2 步:录制一段简短、完整的演示
使用真实但不含秘密的输入,任务完成后立即停止。
第 3 步:精简起草的 Skill
添加命名规范、字段默认值和决策点,并精炼描述。
第 4 步:写下偏好背后的原因
记录规范存在的原因,或哪个选择取代了旧的选择,以便它可以应用到这个 Skill 之外。
在 MemoryLake 中设置
一个 Skill 捕获的是如何完成一项任务。而你工作背后的偏好和决策(如命名规范、文件归属以及哪种方法取代了旧方法)则适用于许多任务和工具。
MemoryLake 是此类工作上下文(如规范、偏好及其背后的决策)的记忆层,它保存在一个由你维护的地方,并可供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你用自己的语言亲自编写条目。你的录制、Skill、Codex 记忆、Computer Use 批准或任何供应商的存储库中的内容都不会被读取、写入或删除。Record & Replay 和 Skill 将按照 OpenAI 描述的方式工作。
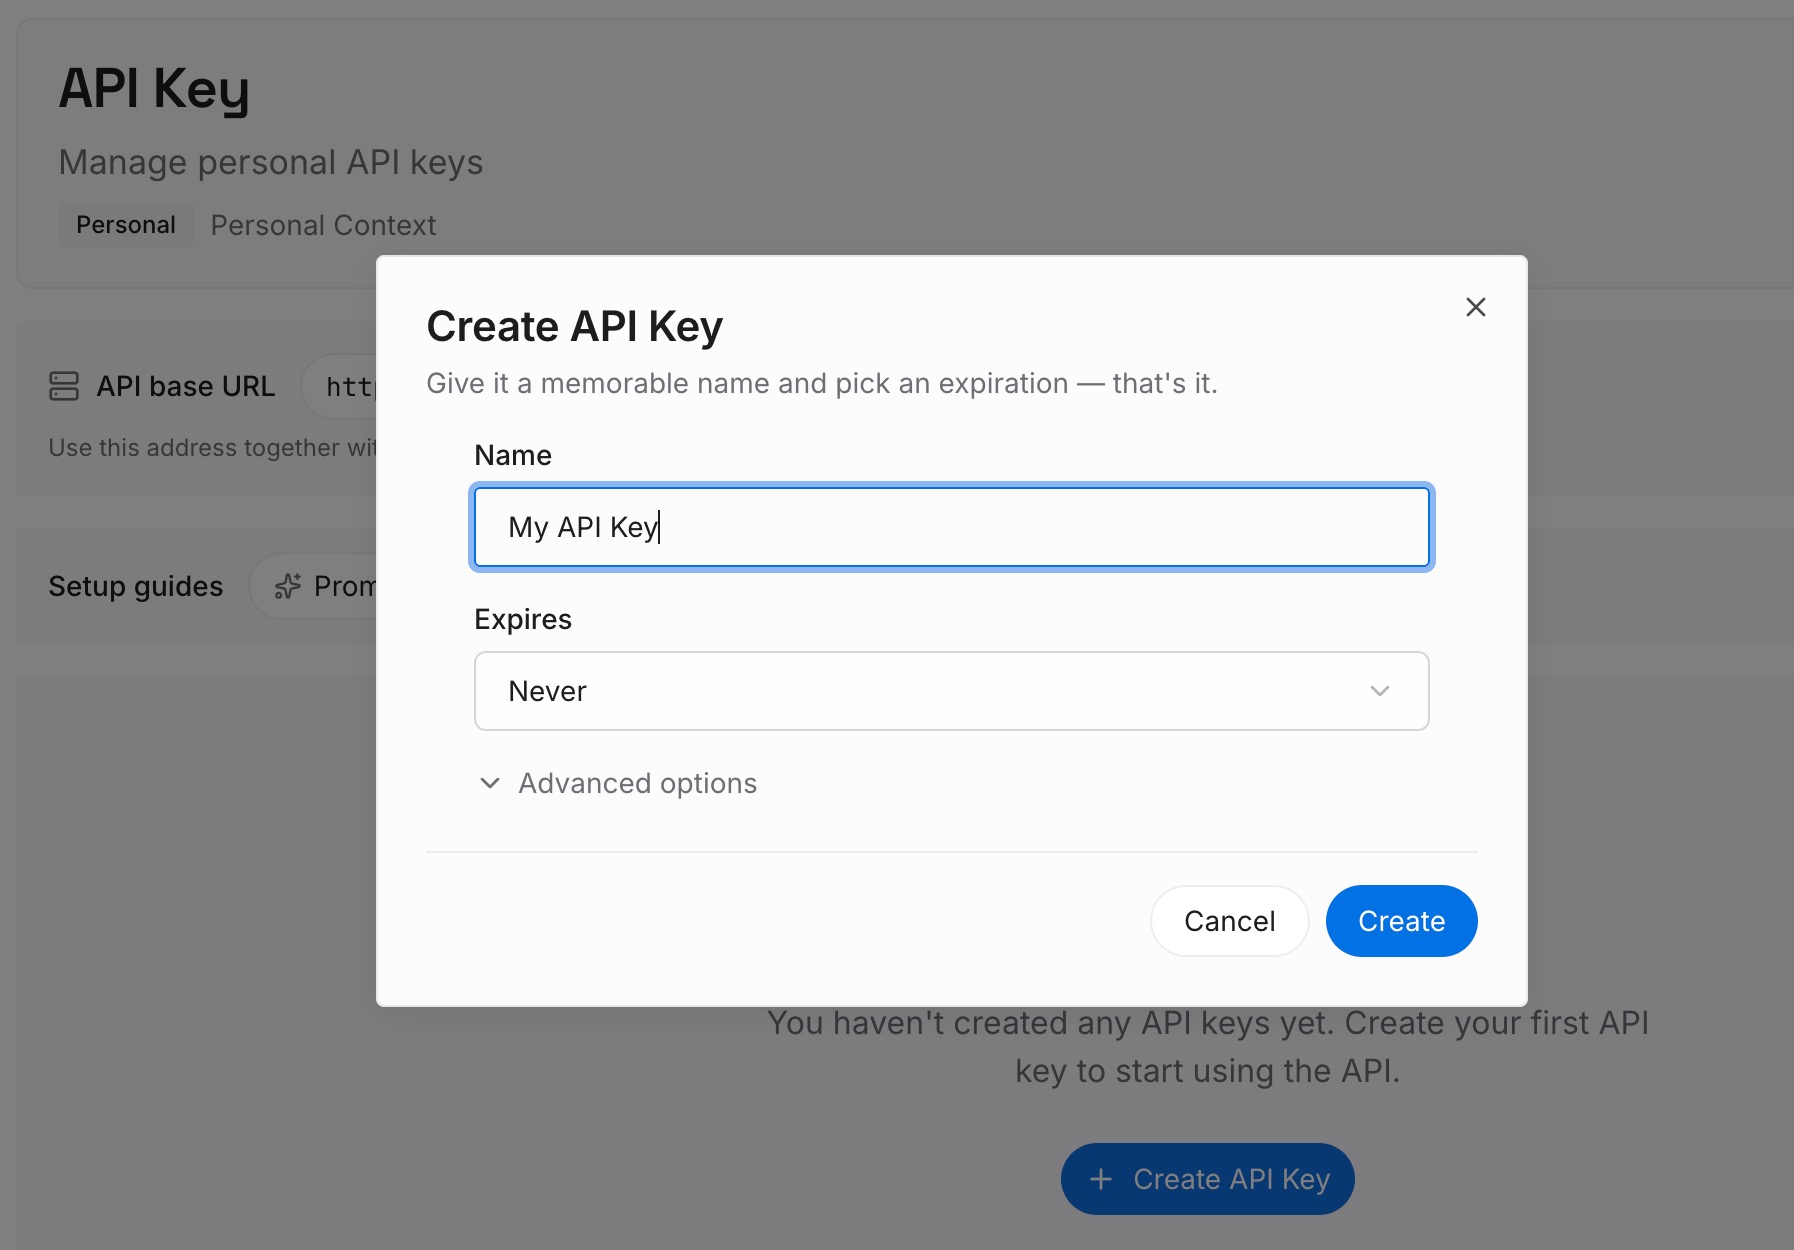
第 1 步:创建 API 密钥
登录并在仪表板生成密钥。像对待其他凭据一样将其私密存储。
第 2 步:上传你的第一批记忆
从你在解决方案第 4 步中写下的内容开始:你的规范及其背后的原因。每个条目一条规范。
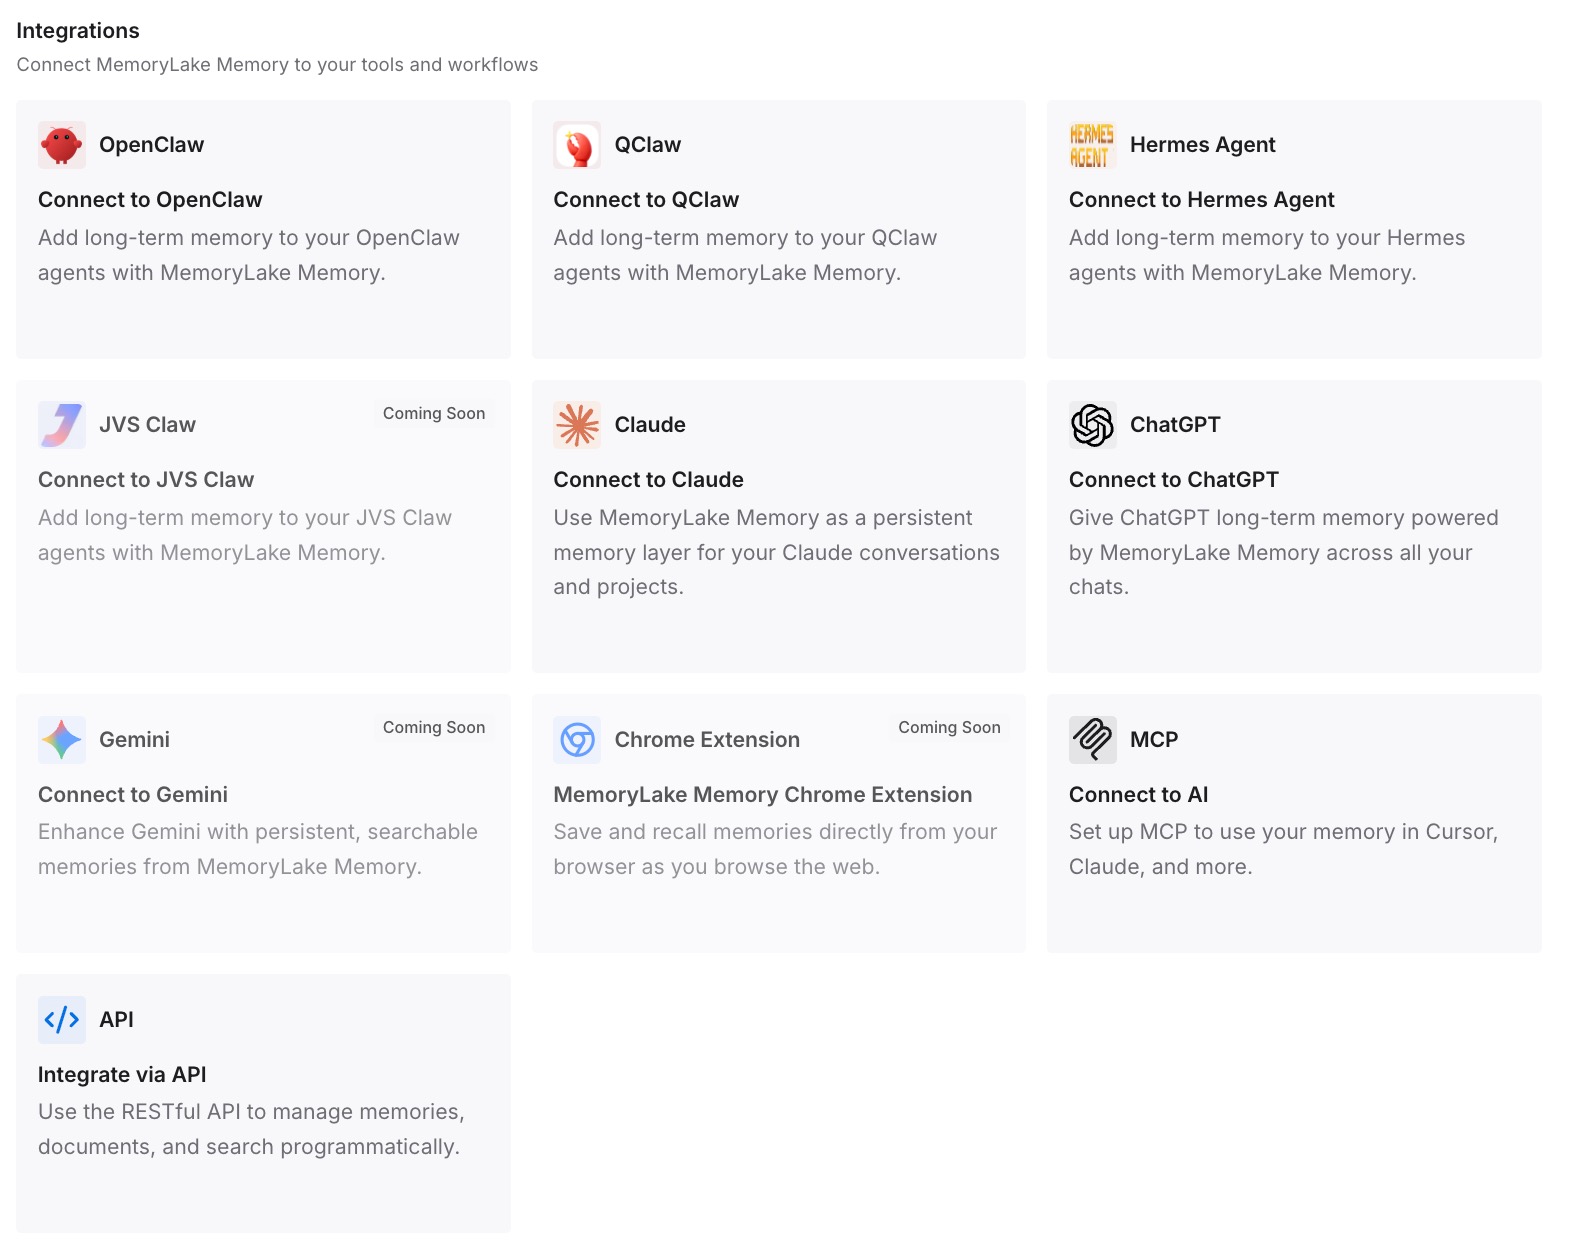
第 3 步:连接你的 AI 和 Agent
连接 Codex、ChatGPT 以及你使用的其他助手。无论哪个 Skill 或工具运行任务,每个助手都可以调用相同的规范。
这在实践中改变了什么
第一个区别是更好的回放。规范是被写下来的,而不是留给录制去推断。
第二个区别是超越单一 Skill 的复用。命名规范适用于每个工作流,而不仅仅是你录制的那个。
第三个区别是更简单的更新。当规范发生变化时,你只需修改一个条目,Skill 的指令就会随之改变。
Record & Replay 最佳实践
选择稳定的工作流。 当步骤和成功标准明确时效果最好。
先说出你的目标。 指明会变化的输入。
保持简短。 任务完成后停止录制。
避免秘密。 使用真实但安全的输入。
精简 Skill。 添加隐藏的偏好和决策点。
编写清晰的描述。 它们决定了何时使用该 Skill。
使用插件进行团队分发。 它可以捆绑 Skill 和连接器。
结论
Record & Replay 让您可以在 Mac 上向 ChatGPT 或 Codex 演示一次工作流,并将其转化为 Skill。在录制期间,它会观察学习该工作流所需的动作和窗口内容,起草的 Skill 会描述何时使用它、需要哪些输入、步骤以及如何验证结果。回放遵循 Skill 并使用当时可用的工具,而不是重复点击动作。
录制可能遗漏的是推理过程:命名规范、默认值和决策点。OpenAI 自己的建议是在录制后添加这些内容。将这些背后的广泛规范保存在一个由你维护的地方。