
消息的含义
Codex 运行在你的 ChatGPT 方案上。OpenAI 的帮助文章指出:“Codex 包含在所有 ChatGPT 方案中,包括 Free 和 Go。使用限制因方案而异。”
当你看到限制消息时,说明你已经用完了方案目前包含的配额。这并不是你项目中的错误,也不意味着你的聊天消失了。
在开始之前,有两点细节值得了解:
- Codex 和 ChatGPT Work 共享一个配额。 OpenAI 的定价页面显示:“ChatGPT 内部的 ChatGPT Work 使用情况与 Codex 使用相同的定价、额度和使用限制。” 在 Work 中的大量使用会占用你用于编程的相同限制。
- 措辞取决于你的账户。 在企业工作区中,消息可能会引导你联系工作区所有者,因为管理员在那里管理使用和支出控制。OpenAI 的管理文档指出,“耗尽的限制可能会暂停对符合条件的功能的访问。”
正在运行的轮次会发生什么
这是令人安心的部分。如果限制在 Codex 运行中途到达,该轮次可以完成。OpenAI 的措辞是“代理将能够继续完成该轮次的工作,但受公平使用限制的约束”。
OpenAI 的 FAQ 涵盖了进行中的轮次。对于之后的工作,它列出了继续进行的方法,例如额度和 API 密钥,下文将对此进行介绍。
因此,如果你在任务中途达到限制,请不要中断它。让该轮次完成,然后在计划下一步之前检查它所做的更改。
限制是如何衡量的
Codex 限制并不是固定的消息数量。OpenAI 的定价 FAQ 解释道:“你可以发送的消息数量取决于所使用的模型、任务的大小和复杂性,以及你是在本地还是在云端运行它们。”
它补充说,看起来相似的任务可能消耗不同的成本:“模型选择、上下文 (context)、推理、工具使用、检索和缓存都会影响使用情况,因此仅凭提示词长度并不是可靠的估算方式。”
定价页面按模型给出了 Plus 和 Standard Business 每五小时时段的本地消息范围。它还提到:
- “Pro 方案目前没有五小时限制。”
- “云端任务可能会比本地消息消耗更多的配额。”
- “这些估算值不是固定的消息限制”。
速度设置也很重要。定价页面显示,Fast 和 Ultrafast 模式消耗包含的限制和付费额度的速率与 Standard 模式不同。如果限制紧张,Standard 模式是以基础速率消耗限制的模式。
为什么长会话消耗更多
OpenAI FAQ 中最有用的一行是关于上下文 (context) 的。它指出:“大型项目、长时间运行的任务或需要代理持有更多上下文 (context) 的扩展会话,每条消息的消耗将显著增加。”
Codex 读取的所有内容都计入其中。OpenAI 对 token 的定义很广泛:“你的提示词、文件、聊天历史、工具结果和 ChatGPT 的响应都会消耗 token。”
这产生了一个实际后果。运行了数小时的聊天会将其历史记录带入每一条新消息中。指令文件和连接的工具在每一轮中都会增加负担。我们关于 Codex 中 context left 的含义 的指南解释了该窗口是如何填满的。
OpenAI 关于延长限制使用时间的建议也指向了同样的一点:
- 控制提示词的大小。 “对给代理的指令要精确,但要移除不必要的上下文 (context)。”
- 限制源材料。 “仅提供相关文件,并在可能的情况下缩小来源或日期范围。”
- 减小 AGENTS.md 的大小。 OpenAI 建议在你的存储库中嵌套 AGENTS.md 文件,以控制注入的上下文 (context) 量。
- 限制 MCP 服务器的数量。 “每个 MCP 服务器都会为你的消息增加更多上下文 (context),并消耗更多限制。”
在哪里查看你的使用量和重置时间
OpenAI 提供了两个查看位置:
- 使用情况仪表板 (Usage dashboard)。 “你可以在使用情况仪表板中找到当前的限制。” 定价页面反复提醒你要查看它以获取“当前的限制和重置时间”。
- 在 CLI 内部。 “如果你想在活动的 Codex CLI 会话期间查看剩余限制,可以使用
/status。”
CLI 还有一个 /usage 命令。OpenAI 的命令参考将其描述为“查看账户 token 使用情况或使用速率限制重置”的一种方式。其步骤说明你可以选择是否显示 token 活动“或兑换可用的赚取重置 (earned reset)”,并且你可以直接打开每日、每周或累计视图。
OpenAI 还建议养成一个习惯:“每隔一两周检查一次仪表板,以了解你的进度和剩余容量。”
达到限制时的选项
你可以采取的操作取决于你的方案。OpenAI 的定价 FAQ 列出了这些选项:
- Plus 和 Pro。 “达到使用限制的 ChatGPT Plus 和 Pro 用户可以购买额外额度以继续工作,而无需升级现有方案。”
- 具有灵活定价的 Business、Edu 和 Enterprise。 这些方案“可以购买额外的工作区额度以继续工作”。
- 任何方案,配合 API 密钥。 “所有用户也可以使用 API 密钥运行额外的本地聊天,使用情况按标准 API 费率收费”。
- 赚取的重置 (Earned reset)。 如果你有一个可用,
/usage允许你兑换它。 - 等待。 检查仪表板以了解你的限制何时重置。
一些个人账户会看到另一个选项。OpenAI 的 Luna Reserve 文章称,它“在常规使用耗尽后,为选定账户提供 GPT-5.6 Luna 的额外使用量”。它适用于受支持的 Codex 和 ChatGPT Work 体验中的选定 Plus 和 Pro 账户,OpenAI 表示它“不会恢复常规使用量或解锁我们最强大的模型”。我们关于 Codex 和 ChatGPT Work 中的 Luna Reserve 的指南解释了该后备方案的工作原理。
有一件事是不花钱的。OpenAI 表示,当你登录 ChatGPT 时,“自动审查安全检查是免费的,不计入你的方案使用限制。”
重新开始工作
使用限制会暂停新工作,但不会删除你的聊天。当使用量再次可用时,你可以返回同一个会话。
在 CLI 中,codex resume 可以实现这一点。OpenAI 的参考说明它可以“通过 ID 继续交互式会话或恢复最近的聊天”,并且“除非传递 --all,否则会将 --last 的范围限定在当前工作目录”。在 TUI 内部,/resume 允许你“从会话列表中恢复保存的聊天”。
恢复会带回对话,但也会带回它的大小。如果会话很长,每条新消息仍然携带那些历史记录。这时,带简短总结的新聊天可能是更好的选择。我们关于 清除 Codex 聊天与开始新聊天 的指南涵盖了这些命令之间的区别。
在你达到限制之前,或者在运行轮次结束后,让 Codex 写下目前的状况会很有帮助:已完成的工作、下一步是什么,以及你做出了哪些决定。这样的一份简短笔记可以让新聊天从要点开始,而不是从整个历史记录开始。
人们首先尝试的操作
中断正在运行的轮次。 OpenAI 表示已经在进行中的轮次可以继续。让它完成。
假设聊天已丢失。 聊天已保存。当使用量恢复时,codex resume 或 /resume 可以返回该聊天。
不经检查就等待。 使用情况仪表板和 /status 会显示你的剩余限制和重置时间。
重置后继续非常长的会话。 这会更快地消耗你的新配额,因为持有更多上下文 (context) 的扩展会话每条消息的消耗更多。
忘记 ChatGPT Work。 Work 和 Codex 共享相同的限制。
解决方案:在不重新开始的情况下从限制中恢复
第 1 步:让当前轮次完成
如果 Codex 正在任务中途,让它完成该轮次。在决定下一步之前,检查它所做的更改。
第 2 步:检查你的使用量和重置时间
打开使用情况仪表板,或在 CLI 中运行 /status。如果 /usage 提供赚取的重置,决定现在是否使用它。
第 3 步:选择如何继续
等待重置、增加额度、使用 API 密钥进行本地聊天,或者在企业方案中询问你的工作区所有者。
第 4 步:决定是恢复还是重新开始
对于短会话,恢复它。对于长会话,要求总结工作状态,并使用该总结开始新聊天。
第 5 步:修剪每轮携带的内容
保持 AGENTS.md 聚焦,在适用的地方嵌套指令,并关闭你不使用的 MCP 服务器。
在 MemoryLake 中设置
使用限制是你发现工作对单一长会话依赖程度的时刻。如果任务的决策、约定和当前状态仅存在于该聊天中,你就必须在付费恢复大上下文 (context) 或在新聊天中重新解释一切之间做出选择。
MemoryLake 是一个记忆层,用于将项目上下文 (context)(如架构决策、约定和任务进度)保存在你维护的一个地方,供你连接的助手(如 ChatGPT、Claude Code 和 Codex)使用。
你用自己的语言编写条目。不会从你的 Codex 会话、会话文件、AGENTS.md、Codex 记忆、使用配额或任何供应商的存储中读取、写入或删除任何内容。使用限制、额度和重置按照 OpenAI 描述的方式运作。
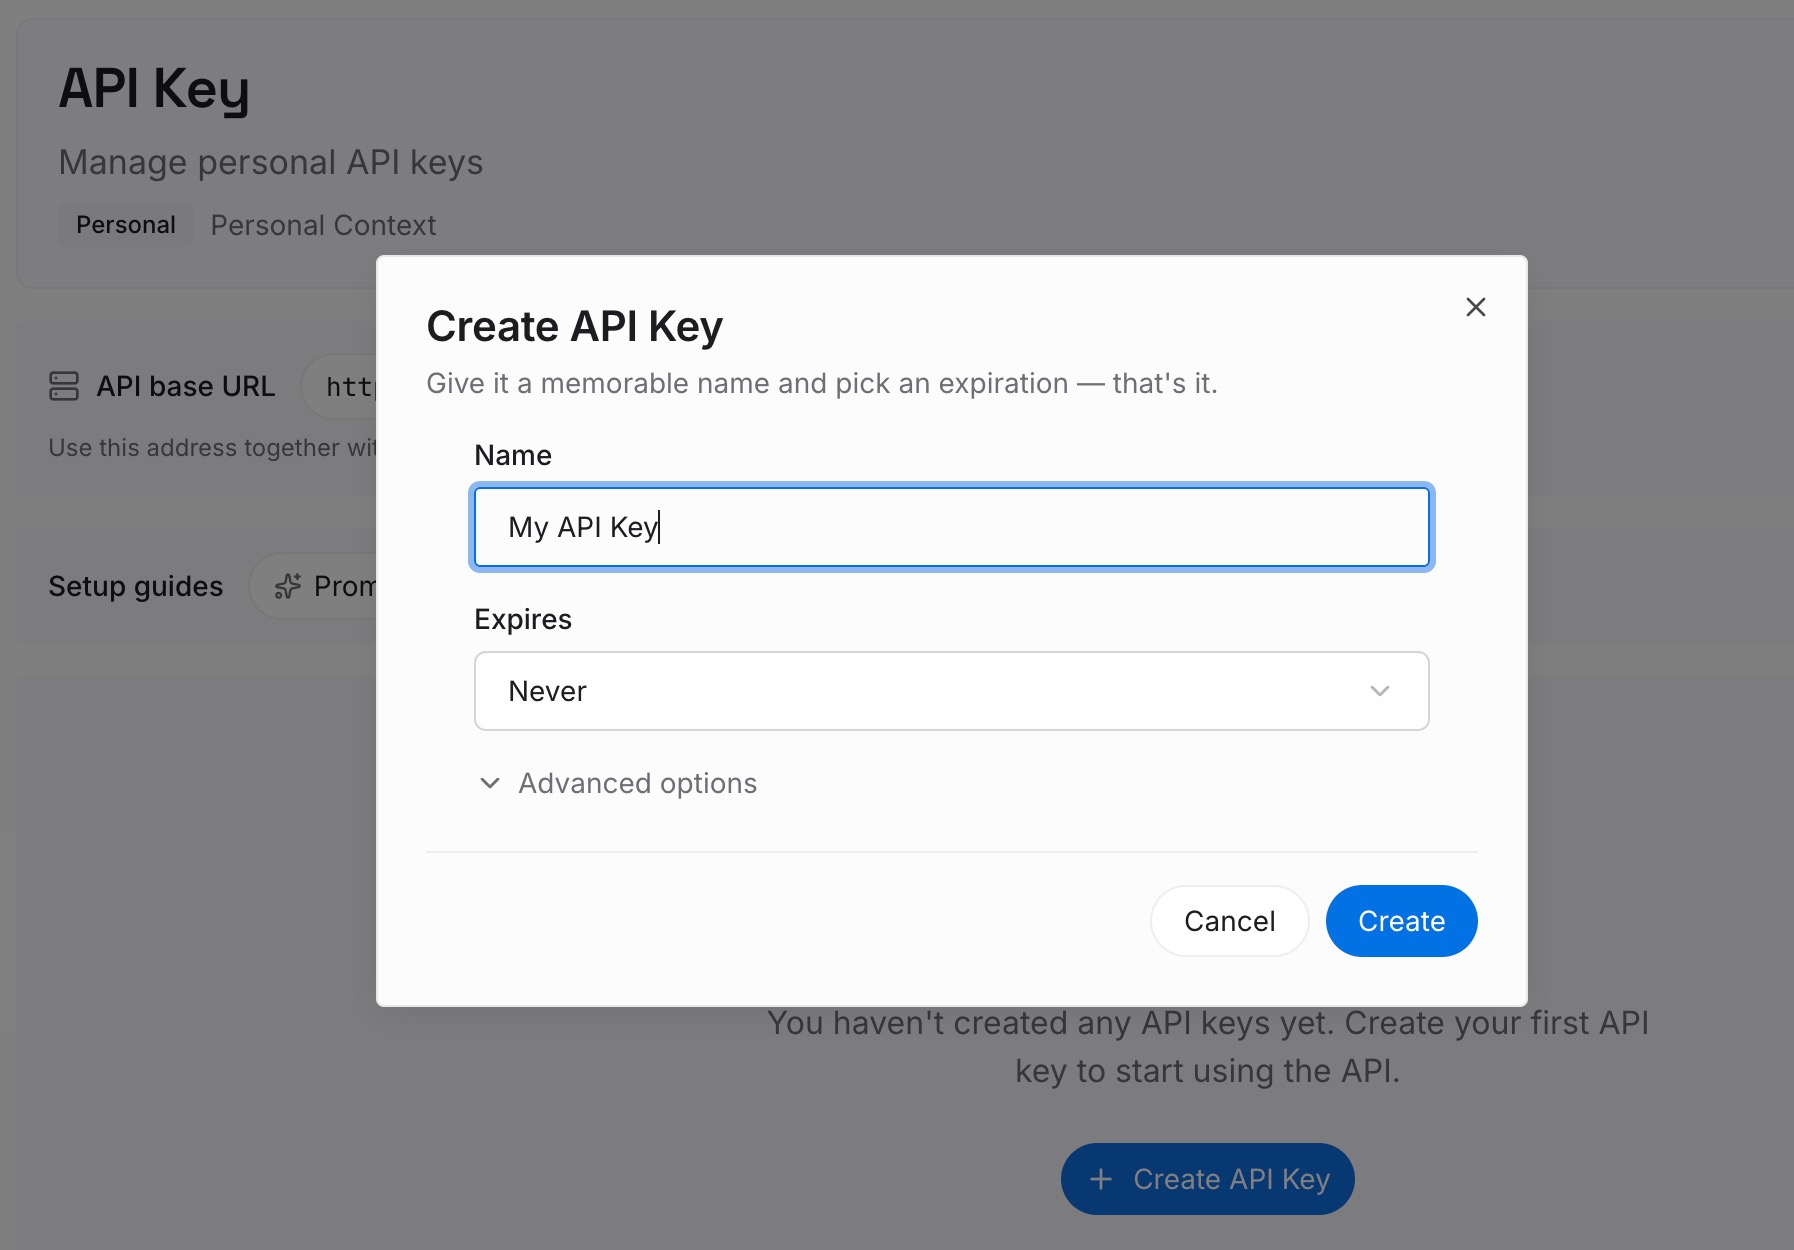
第 1 步:创建 API 密钥
登录并从仪表板生成密钥。该密钥属于你的 MemoryLake 工作区,与你的 OpenAI 账户分开。
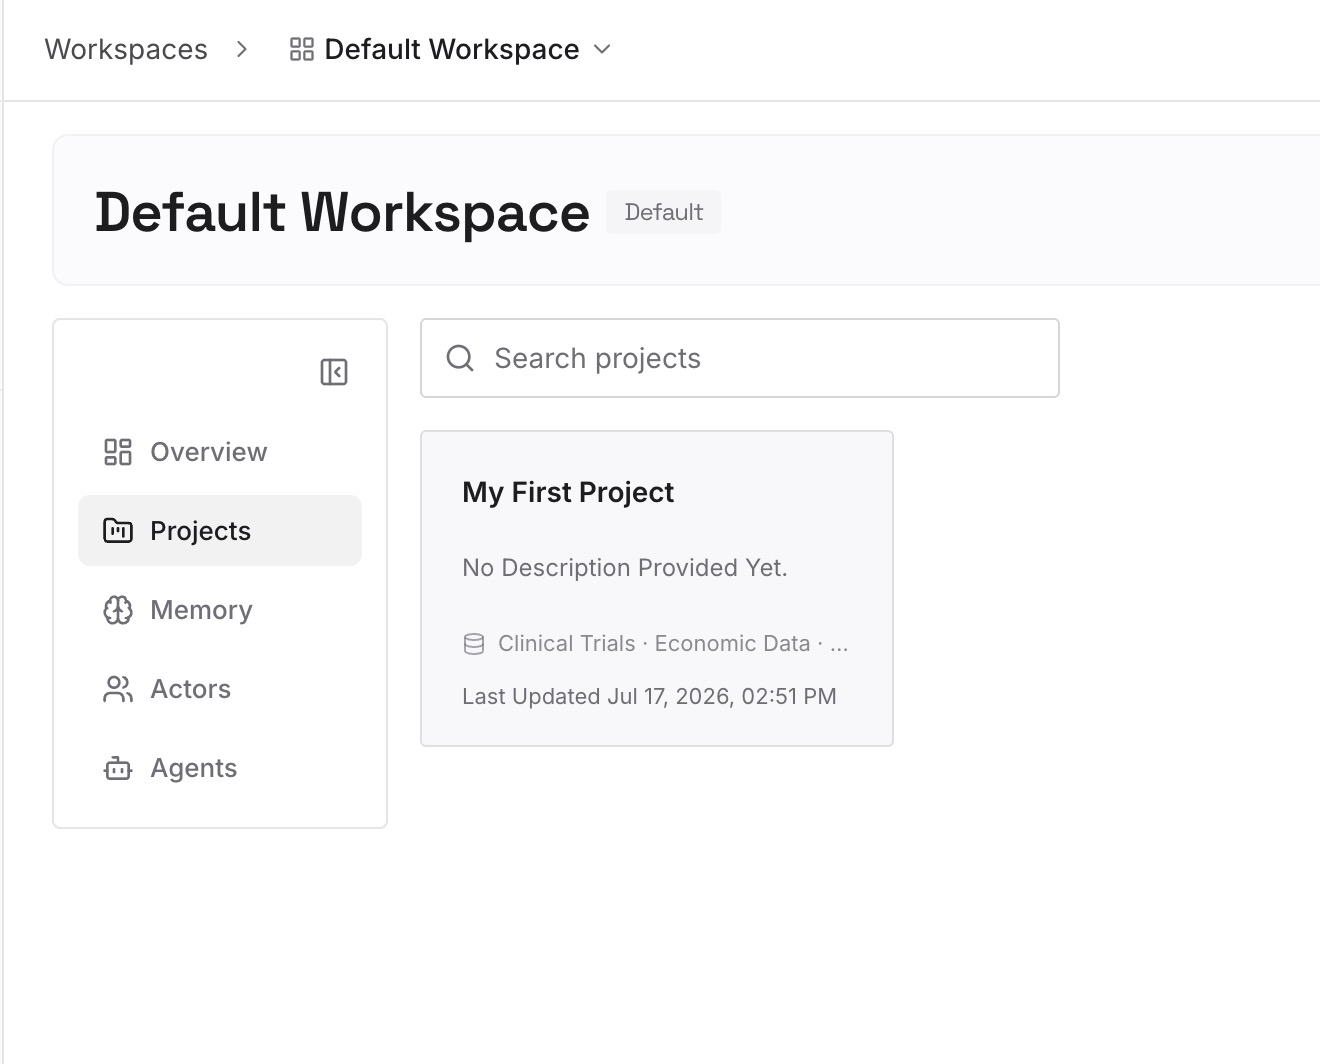
第 2 步:上传你的第一批记忆
从你希望新聊天开始的总结开始:当前任务背后的决策、Codex 应遵循的约定以及剩余的工作。每个条目一项内容,这样你就可以在不重写其余部分的情况下更新其中一项。
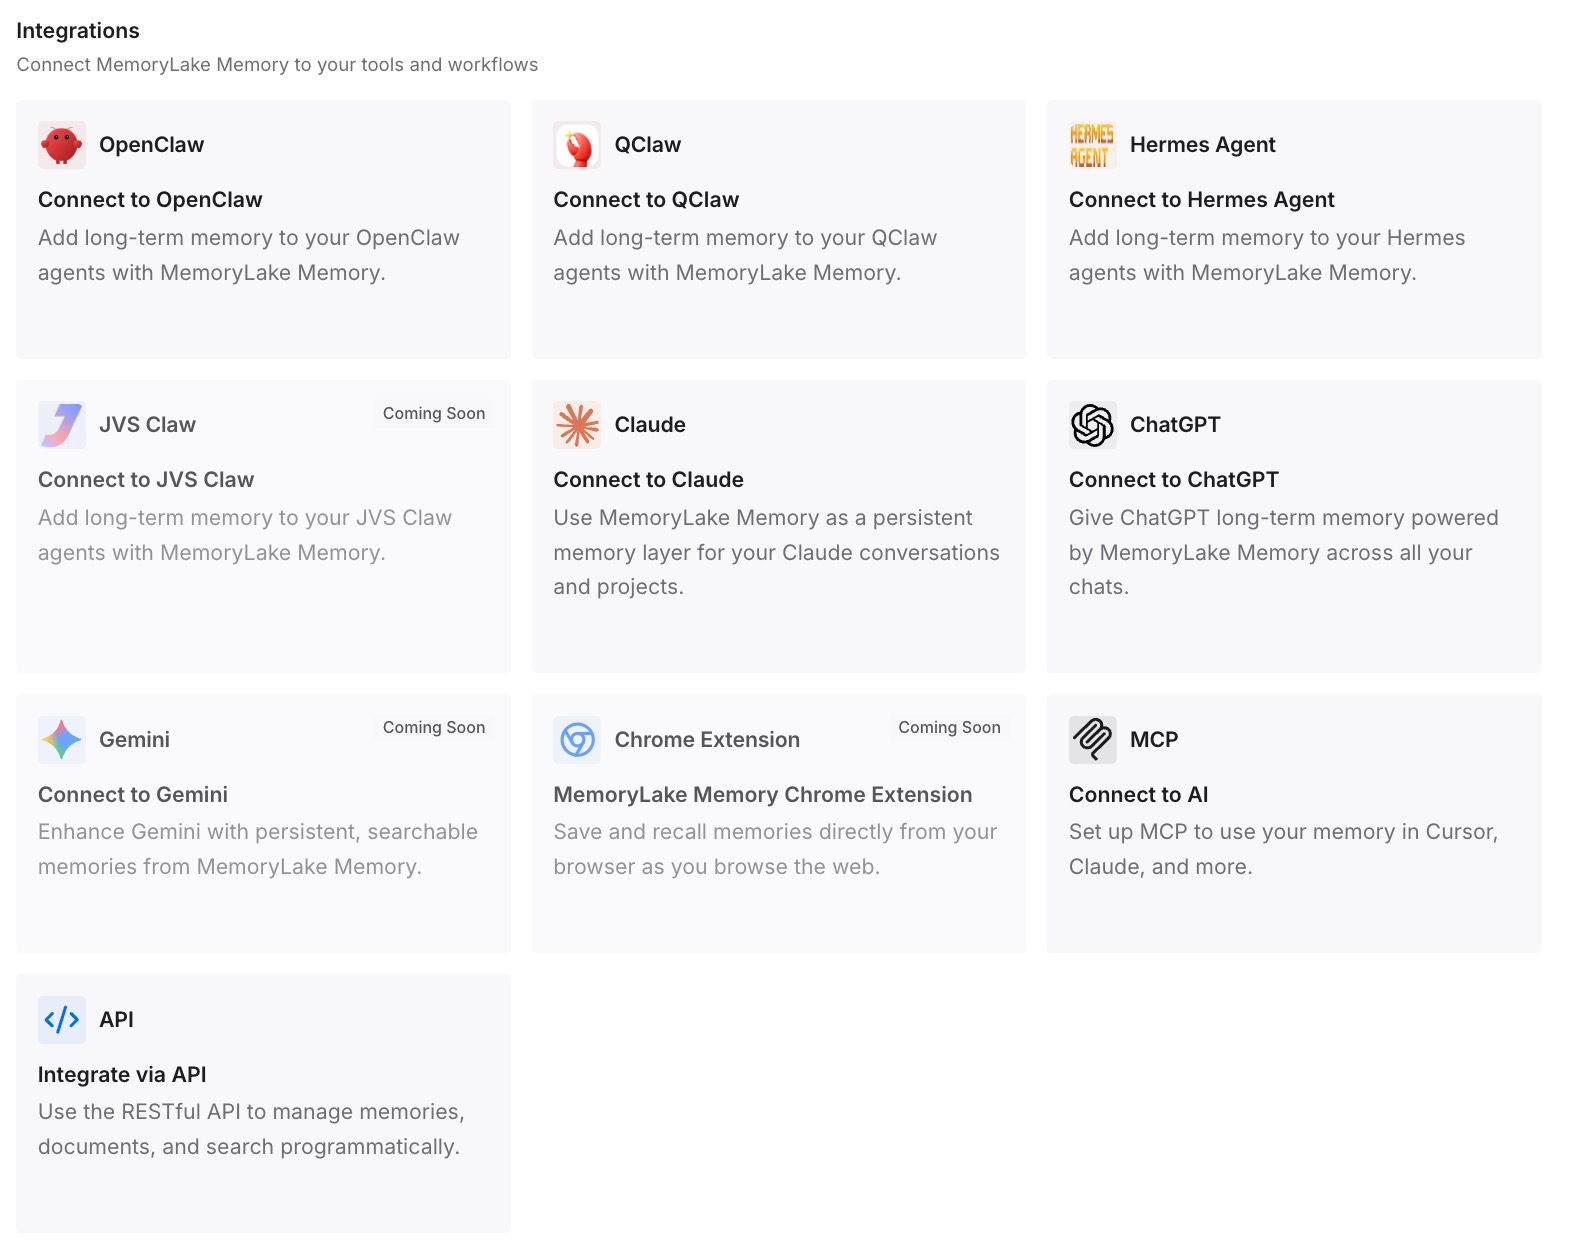
第 3 步:连接你的 AI 和代理
连接 Codex 和你使用的任何其他助手。新聊天可以从相同的书面上下文 (context) 开始。
这在实践中改变了什么
第一个区别是更轻松的重启。当限制重置时,新聊天可以从几个条目开始,而不是从冗长的历史记录开始。
第二个是减少 AGENTS.md 中的内容。经常变化的上下文 (context) 可以存在于你更新的条目中,从而保持指令文件的聚焦。
第三个是跨工具的连续性。如果你在等待时切换到另一个助手,相同的上下文 (context) 依然存在。
Codex 使用限制的最佳实践
让运行中的轮次完成。 OpenAI 表示在你达到限制后它可以继续。
在长会话期间检查 /status。 它会显示你的剩余限制。
每隔一两周查看一次仪表板。 OpenAI 建议这样做以了解你的进度。
保持 AGENTS.md 聚焦。 嵌套文件可以限制每个任务携带的上下文 (context) 量。
禁用不需要的 MCP 服务器。 每一个服务器都会为每条消息增加上下文 (context)。
限制紧张时使用 Standard 速度。 更快的模式会以更高的速率消耗限制。
长会话后重新开始。 总结可以携带工作状态而无需完整的历史记录。
结论
当 Codex 提示你已达到使用限制时,意味着你目前已用完方案包含的配额,且 Codex 和 ChatGPT Work 共享该配额。已经在运行的轮次可以完成。之后,你可以查看 /status 或使用情况仪表板了解重置时间,如果 /usage 提供则兑换赚取的重置,在符合条件的方案上购买额度,使用 API 密钥进行本地聊天,或询问你的工作区所有者。
当使用量恢复时,你的聊天仍然存在,codex resume 可以将其带回。由于长会话每条消息的消耗更多,在新聊天中使用简短总结可能是更好的继续方式。保持 AGENTS.md 和你的 MCP 服务器精简,并写下工作状态,这样重启就不意味着从头开始。