
为什么这两种机制感觉可以互换
它们在表面上有所重叠,因为智能体都可以根据描述来选择它们。
在规则(rules)方面,Cursor 记录了四种应用模式:Always Apply(“应用于每个聊天会话”)、Apply Intelligently(“当智能体根据描述决定其相关时”)、Apply to Specific Files(“当文件匹配指定模式时”)以及 Apply Manually(“在聊天中被 @ 提及时代入”)。其底层机制的表述更为简单:“如果 alwaysApply 为 true,该规则将应用于每个聊天会话。否则,该规则的描述将呈现给 Cursor Agent,由其决定是否应用。”
在技能(skills)方面,选择逻辑听起来几乎完全相同:“当 Cursor 启动时,它会自动从技能目录中发现技能并提供给 Agent。智能体将看到可用技能,并根据上下文决定它们何时相关。”驱动这一过程的 frontmatter 字段描述也完全相同——description 是“智能体用于判断相关性的字段”。
因此,两者都可以通过描述进行选择,也都可以限定文件范围。Skills 拥有一个 paths 字段,“设置后,只有当智能体处理匹配的文件时,该技能才会显现”,这与 rules 的 globs 概念相同。Skills 也可以被锁定:disable-model-invocation,“为 true 时,该技能仅在通过 /skill-name 显式调用时才会被包含。智能体不会根据上下文自动应用它。”
它们真正的区别在于各自可以承载的内容以及何时被读取。
Rule 是进入提示词的文本。Cursor 对规则存在意义的阐述非常值得引用,因为它指出了底层的问题:“大型语言模型在多次补全之间不会保留记忆。Rules 在提示词级别提供了持久且可重用的上下文。”
Skill 是一个包。“Skill 是一个便携的、版本控制的包,用于教导智能体如何执行特定领域的任务。Skills 可以包含脚本、模板和参考资料,智能体可以使用其工具对这些内容进行操作。”而且它并不是 Cursor 特有的:“Skills 可以在任何支持 Agent Skills 标准的智能体上运行。”
最后这句话改变了决策。其中一种格式可以随你迁移,而另一种则是 Cursor 独有的构建。便携性也是为什么每当团队在不同智能体之间迁移时,都会反复出现相同问题的原因,正如在将 Cursor 规则迁移到 Codex中所讨论的那样。
人们尝试的其他替代方法
对所有内容运行转换器。 既然这个命令存在,看起来就像是 Cursor 已经替你做好了决定。但它转换的是符合条件的动态规则和斜杠命令——“符合条件”这个词至关重要,一个“始终应用”的规范并不是一个等待被打包的多步骤程序。
因为一切运行正常,所以把所有内容都保留为 rules。 这无可厚非,但它有文档中提到的代价:rules 会在开始时进入模型上下文。Cursor 官方的最佳实践不建议规则过于臃肿——“保持规则在 500 行以内”、“将大型规则拆分为多个可组合的规则”以及“引用文件而不是复制其内容——这可以保持规则简短,并防止它们随着代码更改而过时”。
在 rules 目录中放置一个纯 Markdown 文件。 这是文档中说明得最清楚的错误,Cursor 现在明确指出:“项目规则必须使用 .mdc 扩展名。.cursor/rules 中的纯 .md 文件会被规则系统忽略,因为它没有 frontmatter 来指定 description、globs 和 alwaysApply。”文档还给出了替代方案:“如果你更喜欢纯 markdown,请改用 AGENTS.md。”是否要完全整合到该文件中本身就是一个决定,我们在将 CLAUDE.md 迁移到 AGENTS.md中详细讨论过。
假设你家目录(home directory)中的 skills 会随你的工作一起迁移。 它们大部分不会,Cursor 明确指出了这一边界:“Cursor 不会将 ~/.agents/skills/ 或未同步的本地技能复制到 Cloud Agents、Agents 窗口远程 SSH 会话或自托管工作节点(self-hosted workers)。”文档给出了其中一种情况的补救措施——“在自托管工作节点上,使用仓库中的项目技能,或将技能打包进工作节点镜像中。”
每当智能体犯错时就编写更多规则。 Cursor 的指导建议显然更为谨慎:“从简单开始。只有当你注意到 Agent 反复犯同样的错误时,才添加规则。”它列出的避免清单同样一针见血——“复制整个风格指南:请改用 linter”、“记录每一个可能的命令”、“为极少适用的边缘情况添加指令”以及“重复代码库中已有的内容”。堆积如山的规则往往会导致当 Cursor 忘记你的项目规则时中所描述的偏差。
将 skills 视为智能体的记忆。 它们是打包好的程序,而不是你团队决策的记录。这种区别比听起来更重要,我们在为什么智能体技能不是记忆中进行了阐述。
解决方案:按内容的本质分类,而不是按格式的新旧分类
有一个问题几乎可以决定所有情况:这件事是始终成立的,还是你要做的事情?
步骤 1:将每个项目分类为始终成立、文件范围或程序性
始终成立(Always true) 的内容属于开启了 alwaysApply 的 rule。版权头部信息、在提出修改建议前阅读源文件的指令、绝不能编辑的目录——Cursor 官方的始终应用示例正是这类清单。这些内容消耗的 token 很少,但一旦遗漏代价极高,你绝对不希望智能体去判断它们是否相关。
文件范围(File-scoped) 的内容两者皆可,而最实在的决定因素是便携性。带有 globs 的 rule 和带有 paths 的 skill 做的是同样的工作。如果该规范在其他智能体中也可能起作用,那么 skill 格式是更便于迁移的选择。
程序性(Procedural) 的内容属于 skill,这也是转换器发挥作用的地方。任何带有步骤、需要填充的模板、需要运行的脚本或附带参考资料的内容,都是为 skill 格式量身定制的——它可以承载“智能体可以使用其工具进行操作的脚本、模板和参考资料”,并且仅在需要时加载。将这些内容强行塞进 rule 意味着,无论今天的任务是否涉及该流程,整个步骤都会占用你的提示词空间。
Cursor 自身的仓库范围限定是一个关于设计意图的有用提示:“嵌套项目目录中的 Skills 会自动将范围限定在该目录内的文件”,因此放置在所应用包旁边的 skill 无需任何配置即可限定范围。这与我们在将指令范围限定到文件中探讨的文件局部性原理相同。
步骤 2:决定由谁来选择每个项目,并设置相应的字段
对于每个项目,写下应该由谁来选择它:始终加载、智能体选择、文件匹配还是手动调用。然后设置对应的字段,因为两边的默认值并不相同。
Rule 通过设置 alwaysApply: true 来实现始终加载,设置 description 来实现智能体选择,设置 globs 来实现文件匹配,或者两者都不设置来实现手动调用——Cursor 指出,在没有描述和 globs 的情况下,规则“仅在你在聊天中 @ 提及该规则时才会被包含”。
Skill 默认是由智能体选择的,因为 Cursor 会展示可用技能,而智能体根据描述决定相关性。要将其设为仅手动调用,请设置 disable-model-invocation。要将其设为文件范围,请设置 paths。并注意调用行为:使用斜杠调用的技能“仅附加到单条消息”,因此你希望在整个会话中保持活跃的技能,与你只想在单轮对话中使用的技能,在设置上是不同的。
需要遵守的一个命名规则:skill 的 name 必须“仅包含小写字母、数字和连字符”,并且“必须与父文件夹名称匹配”。
步骤 3:在两种格式都不管辖的地方,写下每个规范存在的原因
Rules 和 skills 都承载着指令。但它们都不是存放指令背后论据的好地方,Cursor 自身的建议也是将内容移出这些文件,而不是塞进去——引用文件而不是复制它们、指向经典示例、保持规则简短。
这就留下了一个空白。“绝不要就地修改列类型”是一条规则。但为什么——哪次迁移失败了、在几月份、团队随后达成了什么共识——才是阻止别人在下个季度删除该规则的关键。把它放在一个比这两种格式更长久的地方。
在 MemoryLake 中进行设置
Rules 和 skills 解决了智能体应该如何表现的问题。但它们并不适合存放你团队的决策和原因,而这恰恰是人们一直试图存储在其中的内容。MemoryLake 是一个你专门用来记录这些决策的存储库,它独立于任何单一编辑器的配置,并且可以从你连接的每个助手进行读取。你用自己的语言亲自编写这些条目。没有任何内容会从 Cursor 的系统或其他厂商的存储库中读取、写入或删除——你的 rules、skills 和仓库完全保留在它们自己的控制之下。
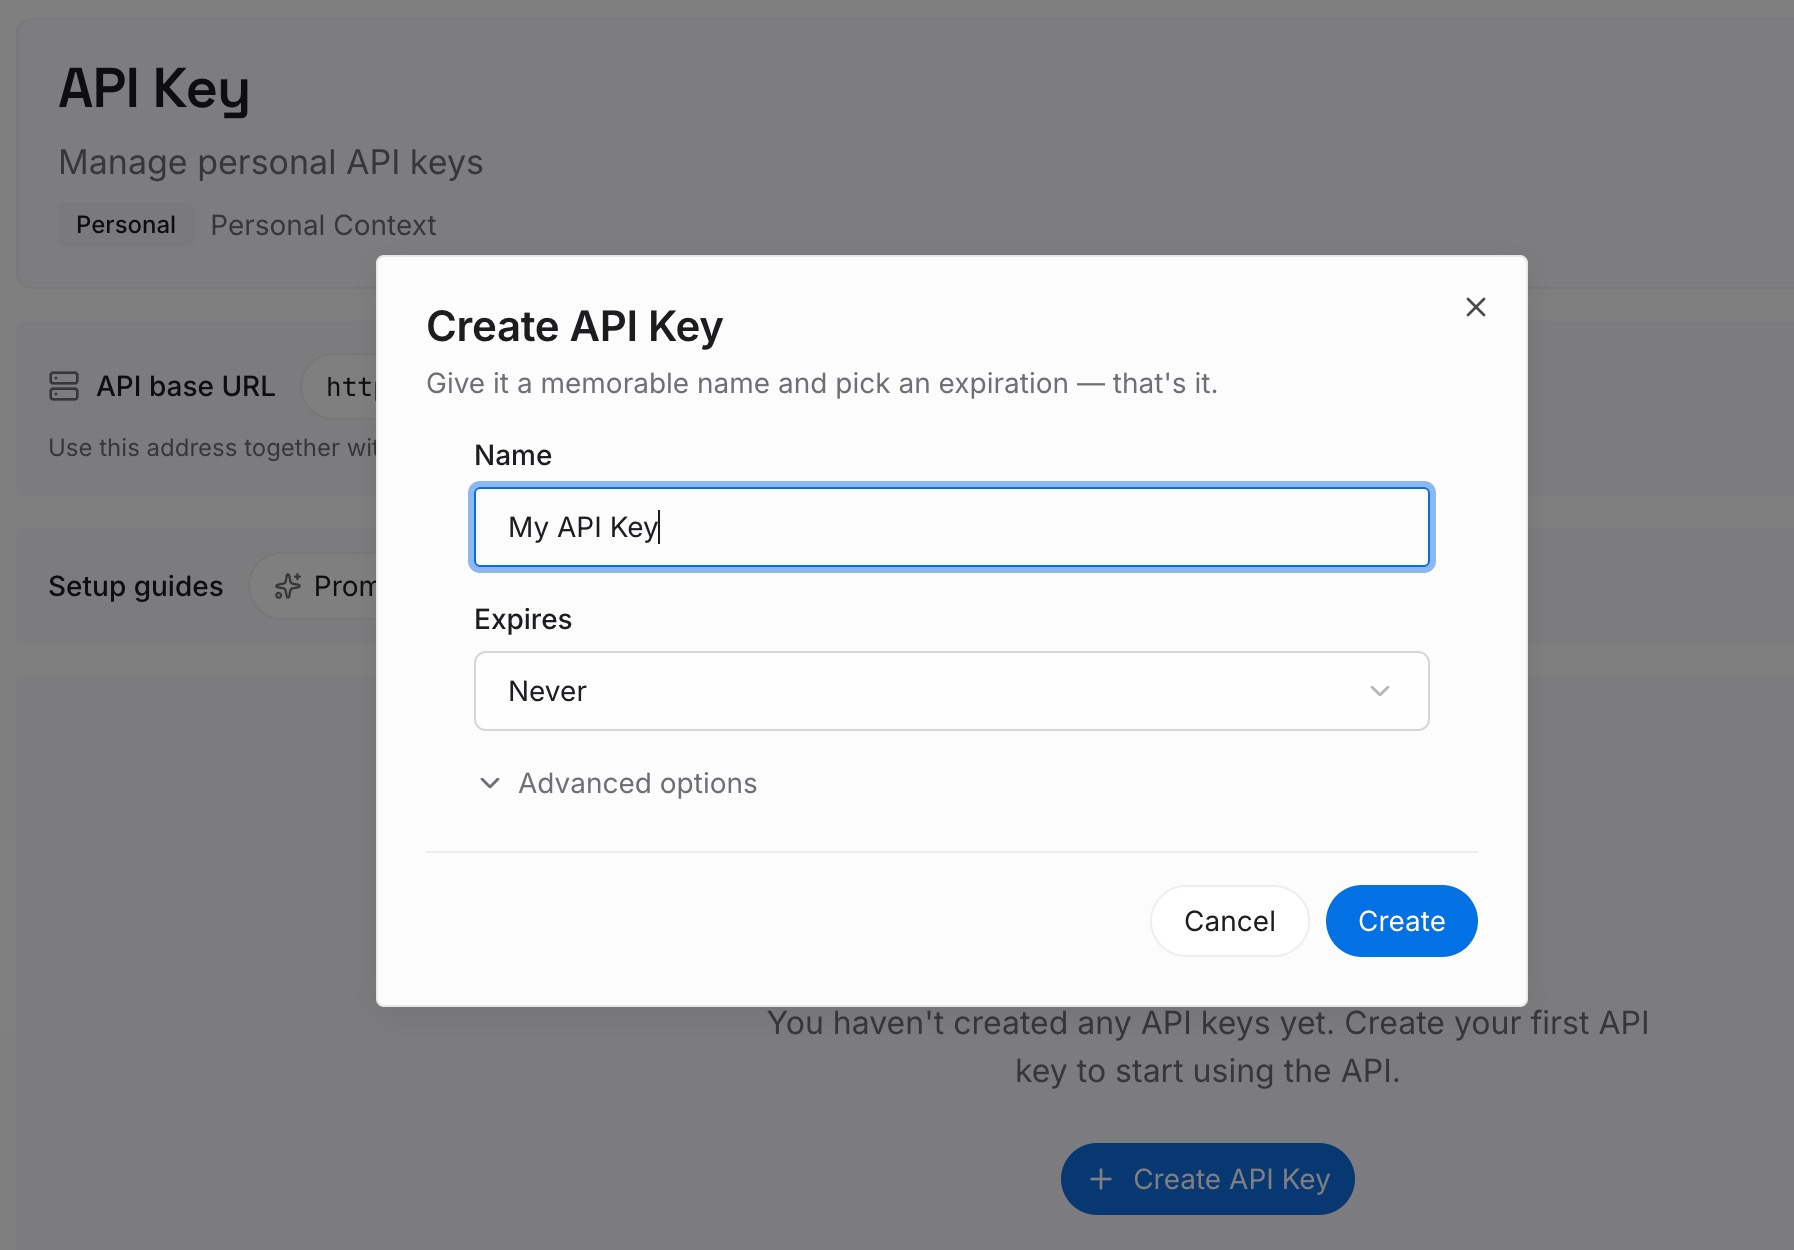
步骤 1:创建 API 密钥
从控制面板生成一个密钥。正是它让 Cursor、终端智能体和聊天助手能够访问同一组事实,而无需各自携带一份推理逻辑的副本。
步骤 2:上传你的第一批记忆
从规则背后的决策开始:被否决的方法及其依据、规范旨在预防的事件、在接触特定服务前需要询问的人。规则文件承载着指令,但它几乎从不承载原因。
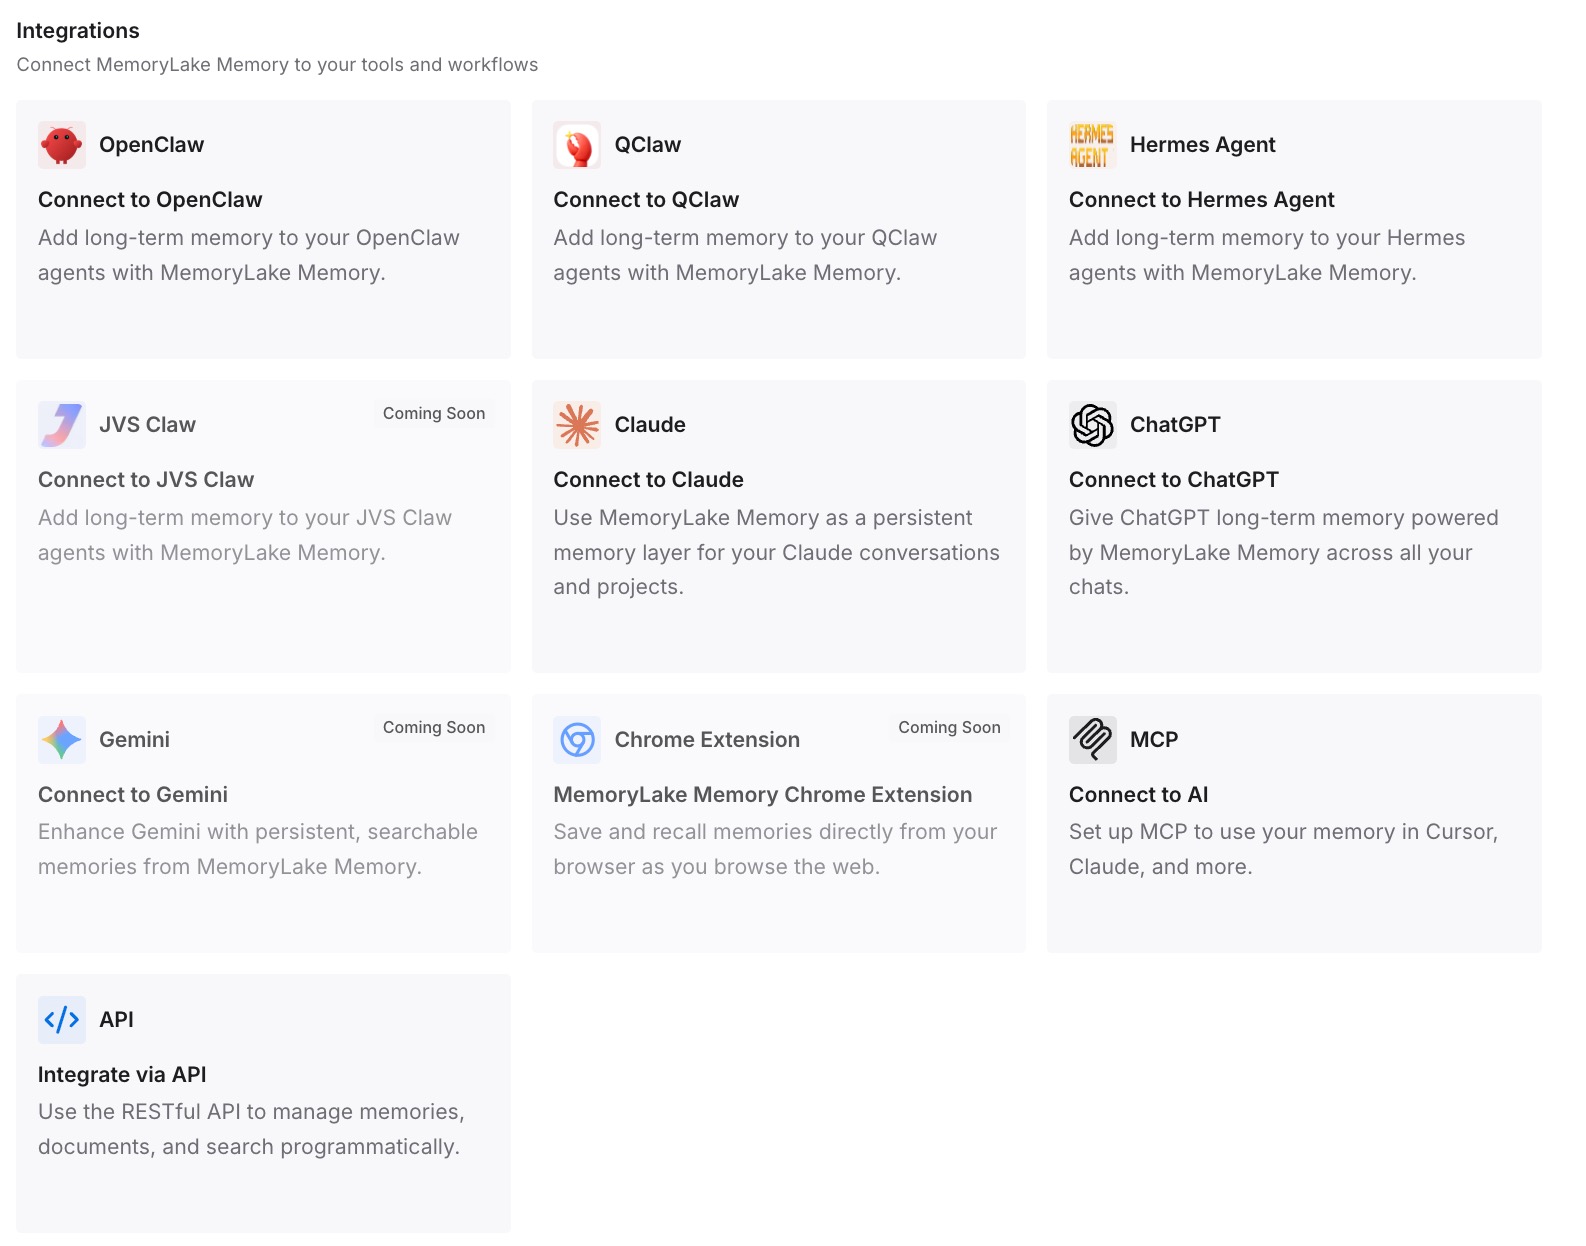
步骤 3:连接你的 AI 和智能体
将你的工具指向该层,以便这些事实在会话开始时加载,而不是从配置文件中推断出来。然后运行一个真正能证明效果的测试:向另一个不同的助手询问其中一个决策。如果它能回答,说明你的推理逻辑已经不再受限于某一个编辑器的文件格式。
这在实践中改变了什么
第一个改变是转换器变得可以安全使用,因为你清楚该给它喂什么内容。带有步骤、脚本或模板的流程放进去。始终应用的规范保留在原处。
第二个改变是你的提示词变小了。所有开启了 alwaysApply 的内容在每个会话中都会被读取;而移入 skills 的流程则是按需加载。这是实实在在的机制优势,而且只有在你移动了正确的内容时才会实现。
第三个改变是 .mdc 的要求不再会浪费任何人一下午的时间。rules 目录中的纯 .md 文件会被规则系统忽略,Cursor 现在在说明修复方法的同一段落中指出了这一点。
第四个改变是远程和云端运行不再会给你带来意外。未同步的本地技能和 ~/.agents/skills/ 无法到达 Cloud Agents、远程 SSH 会话或自托管工作节点,因此云端运行所依赖的任何内容都应该放在仓库中。
第五个改变是便携性变成了你主动选择的结果,而不是事后才发现的限制。Skills 被描述为可以在任何支持该标准的智能体上运行;而 rules 是 Cursor 的专属构建。了解你的上下文分别处于哪种格式,是决定了这是一次迁移还是一次重写的关键——这也是另一个厂商从另一个角度记录的相同问题,正如在哪个 Copilot 指令文件会被读取中所讨论的那样。
拆分 Cursor 规则和技能的最佳实践
保持“始终应用”清单简短且绝对。 它们在每个会话中都会被读取,因此每一行都会与实际任务竞争空间。
为每个描述提供一个“何时”(when),而不仅仅是“什么”(what)。 在两边,描述都是智能体用来判断相关性的依据。
将云端运行所需的技能放入仓库中。 项目级别的技能目录可以随项目迁移;而未同步的本地技能在文档中被明确指出会留在你的机器上。
每个流程一个技能,放在其专属文件夹中。 技能的身份来自包含 SKILL.md 的文件夹,其上级的分类文件夹仅用于组织管理。
尽可能使用嵌套而不是 glob 列表。 包目录内部的技能会自动将范围限定在该目录。
遵守扩展名规则。 项目规则使用 .mdc;纯 Markdown 则应放入 AGENTS.md 中。
将推理逻辑保存在其他地方。 一个同时承载自身历史记录的规则文件将无法保持简短,而简短正是其发挥作用的关键。
结论
Cursor 对这两种机制都进行了清晰的记录,只是没有把它们放在同一个页面上。Rules 是提示词级别的上下文,包含在模型上下文的开头,具有四种应用模式,并且硬性要求项目规则使用 .mdc 扩展名。Skills 是便携的、版本控制的包,可以承载脚本、模板和参考资料,按需加载资源,并可在任何支持 Agent Skills 标准的智能体上运行。
分类问题其实比功能对比所暗示的要简单得多。始终成立的规范保留为“始终应用”的规则,因为你不需要去判断其相关性。带有步骤和附件的流程则变成技能,因为这正是按需加载的用武之地。限定文件范围的指南两者皆可,而便携性是合理的决定因素。
有两个边界值得写在便签纸上:.cursor/rules 中的纯 .md 会被规则系统忽略,未同步的本地技能无法到达 Cloud Agents、远程 SSH 会话或自托管工作节点。
然后,迈出这两种格式都不支持的一步。在规则文件或技能包之外的地方记录每个规范存在的原因,这样下一个阅读该规则的人也能找到它存在的原因。