
实际传输的内容
您的 Claude 技能存放在哪里
Claude 技能可以存放在三个不同的地方,Anthropic 明确表示它们不共享:“自定义技能不会跨界面同步。”
- Claude Code。 技能是磁盘上的文件夹,对于个人技能,位于
~/.claude/skills/;对于项目内部,位于.claude/skills/。较旧的自定义命令也算在内:“位于 .claude/commands/deploy.md 的文件和位于 .claude/skills/deploy/SKILL.md 的技能都会创建 /deploy,且工作方式相同。” - claude.ai。 自定义技能是通过“设置”作为 zip 文件上传的,并且“自定义技能针对每个用户都是独立的”。如果您仍保留压缩的文件夹,那就是您的源副本。
- Claude API。 在此处上传的技能会在 API 工作区中共享,并与 claude.ai 分开保存。
如果您的 claude.ai 技能仅存在于您的账户中,有一种记录在案的方法可以将这些文件获取到磁盘上。当您在终端中使用您的 claude.ai 账户登录 Claude Code(v2.1.273 或更高版本)时,Claude Code 会将该账户启用的技能同步到 ~/.claude/skills/synced/ 中。该同步是单向的:“Claude Code 会下载同步的技能,绝不会上传它们。”这使得同步文件夹成为一个可读的迁移源副本,而不是一个进行编辑的地方。
格式保证了什么,以及没有保证什么
开放标准定义了六个 frontmatter 字段:name、description、license、compatibility、metadata 和 allowed-tools。OpenAI 的要求则更为简短:“技能是一个包含 SKILL.md 文件以及可选脚本和引用的目录。SKILL.md 文件必须包含 name 和 description。”
Claude Code 则更进一步。它接受一大串自己的字段,包括 when_to_use、argument-hint、arguments、disable-model-invocation、user-invocable、disallowed-tools、model、effort、context、agent、hooks 和 paths。Anthropic 自己的文档划清了界限:“在 Claude Code 之外,您只能使用 Agent Skills 规范中的字段”。甚至 claude.ai 在上传时也会拒绝这些额外字段并抛出硬错误。
技能的正文也有同样的分歧。Anthropic 指出:“仅限 Claude Code 的正文功能(例如动态上下文注入)在 claude.ai 聊天中或通过 API 无法运行。”如果它们在 Anthropic 自己的聊天产品中都无法运行,那么请做好它们在 ChatGPT 中也无法运行的准备。
在实践中,仅使用 name 和 description 加上纯 Markdown 指令的技能是最具移植性的。依赖于 context: fork、paths、参数占位符或内联 Shell 命令的技能则需要重写。
技能在 ChatGPT 中的显示位置
这是首先需要检查的部分。OpenAI 的文档指出:“独立技能可在 ChatGPT 桌面应用、Codex CLI 和 IDE 扩展中使用。打包在插件中的技能也可在 Web、桌面和移动端的 ChatGPT Chat 和 Work 中使用。”
因此,您单独添加的技能文件夹可以在桌面应用上运行。要在 Web 端或手机上的 ChatGPT 中使用它,必须将其打包到插件中。OpenAI 的表述是:“使用技能来设计工作流本身,然后在希望其他人安装时将其打包为插件。”如果您还要迁移自定义 GPT 工作流,我们关于将自定义 GPT 迁移到 ChatGPT 插件的指南详细介绍了插件方面的内容。
OpenAI 的桌面端说明:“在 ChatGPT 桌面应用中,打开侧边栏中的 Skills,以查看和探索在您的各个项目中创建的技能。”对于 Codex,本地技能从文件夹加载。Codex “会扫描从当前工作目录一直到存储库根目录的每个目录中的 .agents/skills”,个人位置位于 $HOME/.agents/skills。请注意文件夹名称:是 .agents/skills,而不是 .claude/skills。
调用方式与在 Claude 中非常相似:“在 ChatGPT 中,输入 @ 来选择技能。”当您的请求与技能的描述相匹配时,ChatGPT 也可以自行选择技能。
导入流程涵盖的内容
如果您的技能存放在 Claude Code 或 Claude Cowork 中,AI 的导入流程可以将其迁移过来。“桌面应用可以从 Claude Code、Claude Cowork 或 Cursor 导入。”其导入表将技能(Skills)映射到技能,将斜杠命令(Slash commands)映射到技能,并且“导入不会更改或删除您现有的智能体设置”。
OpenAI 还列出了之后需要审查的内容,其中有两项直接适用于技能:“导入的技能和智能体中的工具限制或权限。”以及“依赖于参数、Shell 插值或文件路径占位符的提示词模板或命令式提示词。”这些正是上面描述的那些 Claude Code 扩展。导入器只是将文件迁移过来,它不会重写只有 Claude 才能理解的内容。
导入源是 Claude Code 和 Claude Cowork。您上传到 claude.ai 以在常规聊天中使用的技能,最好直接从文件本身进行迁移。
遗留的内容
技能是一个流程,而不是记忆。它告诉助手如何做某事,但它不承载助手在使用过程中了解到的关于您、您的项目或您的客户的信息。我们关于为什么智能体技能不是记忆的解释涵盖了这一区别。
Claude 的记忆、项目知识和聊天记录是独立的迁移内容。我们关于将 Claude 记忆迁移到 ChatGPT 的指南以及我们关于将 Claude Projects 迁移到 ChatGPT 的指南涵盖了这些内容。
共享必须重新设置。在 ChatGPT 内部,OpenAI 指出:“移动技能不会转移 ChatGPT 工作区所有权、共享、角色分配、插件安装状态或连接器授权。”
手动迁移
步骤 1:收集您的技能文件夹并使其具备可移植性
收集您想要保留的每个技能:
- 来自 Claude Code:
~/.claude/skills/中的文件夹和每个项目的.claude/skills/,以及您仍在使用的任何.claude/commands/文件。 - 来自 claude.ai: 您的原始文件夹,或者在使用该账户登录 Claude Code 后在
~/.claude/skills/synced/中的副本。 - 来自 API: 您上传的源文件夹。
对于每个技能,打开 SKILL.md 并逐项处理 frontmatter:
- 保留
nameanddescription。检查name是否使用小写字母、数字和连字符,并与文件夹名称匹配,这是标准所要求的。 - 将
when_to_use合并到description中。 Claude Code 将when_to_use描述为“Claude 何时应调用该技能的附加上下文,例如触发词或示例请求。”ChatGPT 的隐式匹配运行在描述上,OpenAI 的建议很直接:“因为隐式匹配取决于描述,所以请编写范围和边界清晰的简明描述。” - 转换
disable-model-invocation。 在 Claude Code 中,它是“设置为 true 以防止 Claude 自动加载此技能。”OpenAI 文档中最接近的等效项位于技能文件夹中可选的agents/openai.yaml文件中,在policy下,名为allow_implicit_invocation。文档解释道:“当为 false 时,Codex 不会根据用户提示词隐式调用该技能;显式的 $skill 调用仍然有效。” - 删除或重写其余部分。 像
context、paths、model、effort和hooks这样的字段是 Claude Code 的功能。如果技能依赖于它们,请尽可能将这些行为写入指令中,或者接受该技能将以更简单的方式运行。
然后阅读正文。将参数占位符和内联 Shell 命令替换为纯指令,并检查任何捆绑的脚本在 Claude 之外是否仍然合理。
如果您的技能来自 Claude Code 或 Cowork,您可以先运行 OpenAI 的导入,然后对导入的副本进行此审查。无论哪种方式,审查内容都是相同的。
步骤 2:在 ChatGPT 中安装技能并测试每一个
选择每个技能需要工作的位置。
- 在桌面应用或 Codex 中: 对于 Claude Code 或 Cowork 中的技能,使用“设置”,然后选择“导入”。对于桌面应用、CLI 或 IDE 扩展中的 Codex,将您自己清理过的文件夹放在
$HOME/.agents/skills(个人使用)或存储库中的.agents/skills(与团队共享)中。Codex 还“支持符号链接的技能文件夹,并在扫描这些位置时遵循符号链接目标”,如果您为每个技能保留一个副本,这将非常有用。 - 在 ChatGPT Web 端或移动端: 将技能打包在插件中。
- 对于您宁愿重建的技能: 使用内置的创建器(ChatGPT Work 中的
@skill-creator),并粘贴您的 Claude 指令作为起点。OpenAI 的描述模板是一个很好的提示词:“准确解释该技能何时应该触发,何时不应该触发。”
然后对每个技能测试两次:一次是通过使用 @ 选择它,另一次是用通俗的语言要求执行任务,看看 ChatGPT 是否会自行选择它。将结果与 Claude 生成的结果进行比较。如果显式调用有效而隐式调用无效,则需要修改描述。
如果您还在整理哪些指令应该是技能,哪些应该是始终开启的规则,我们关于 Cursor 技能与规则的指南针对另一个工具进行了相同的判断。
更好的方法:将技能依赖的上下文保存在您控制的一个地方
技能告诉助手如何撰写周报。它不会告诉助手您本季度关注哪些客户、团队上个月做出了什么决定,或者新的利益相关者更喜欢哪种格式。这种上下文可能会逐周发生变化,而过程保持不变,将其放入技能中意味着每次发生变化时,您都必须在它们所在的每个工具中编辑技能。
MemoryLake 是一个记忆层,用于将此类上下文保存在您维护的一个列表中,供 ChatGPT、Claude Code 以及您连接的其他助手使用,从而让您的技能可以专注于过程。
您可以用自己的语言亲自编写这些条目。不会从您的 Claude 技能、您的 claude.ai 账户、您的 ChatGPT 技能或插件或任何供应商的存储中读取、写入或删除任何内容。在将工作细节存储在公司系统之外之前,请检查您组织的政策。
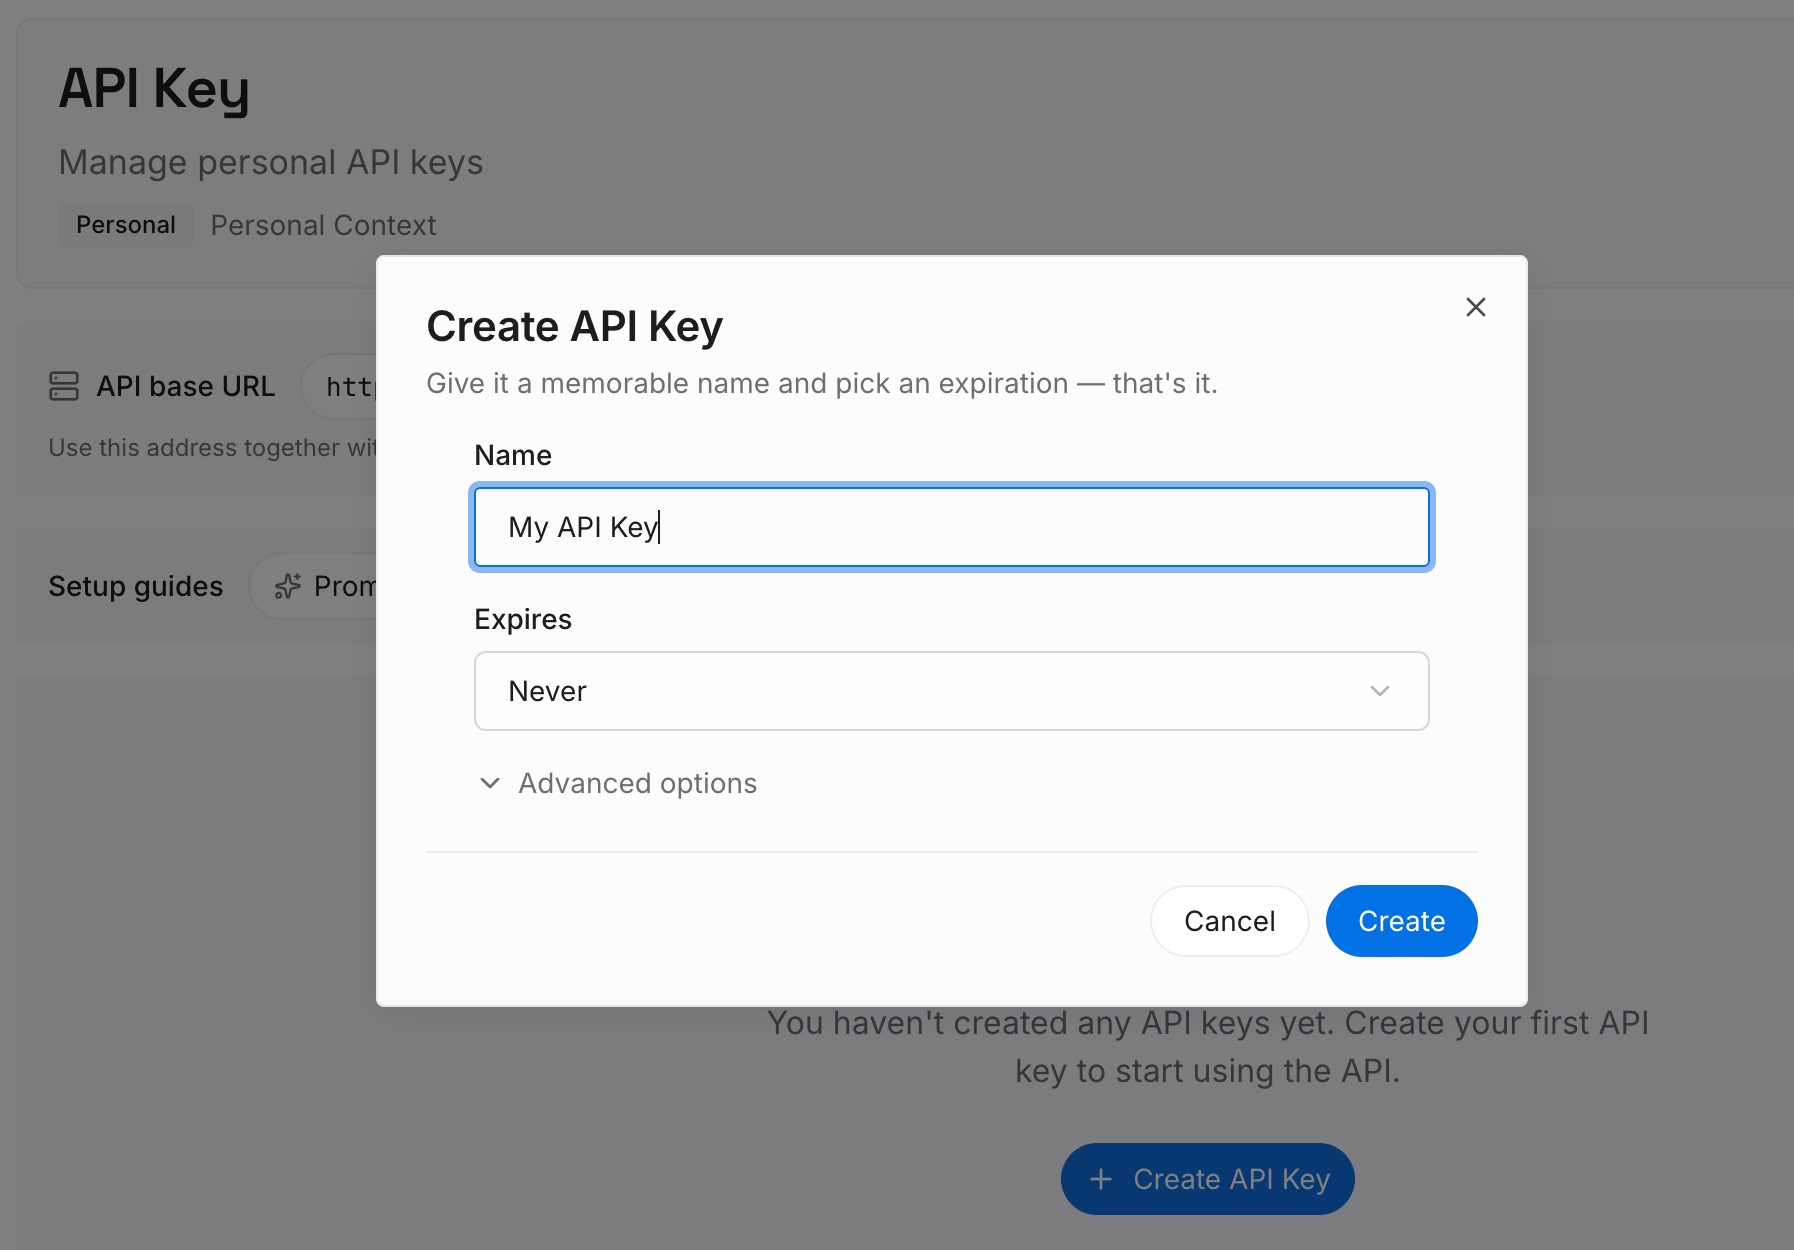
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 Anthropic 和 OpenAI 账户是分开的。
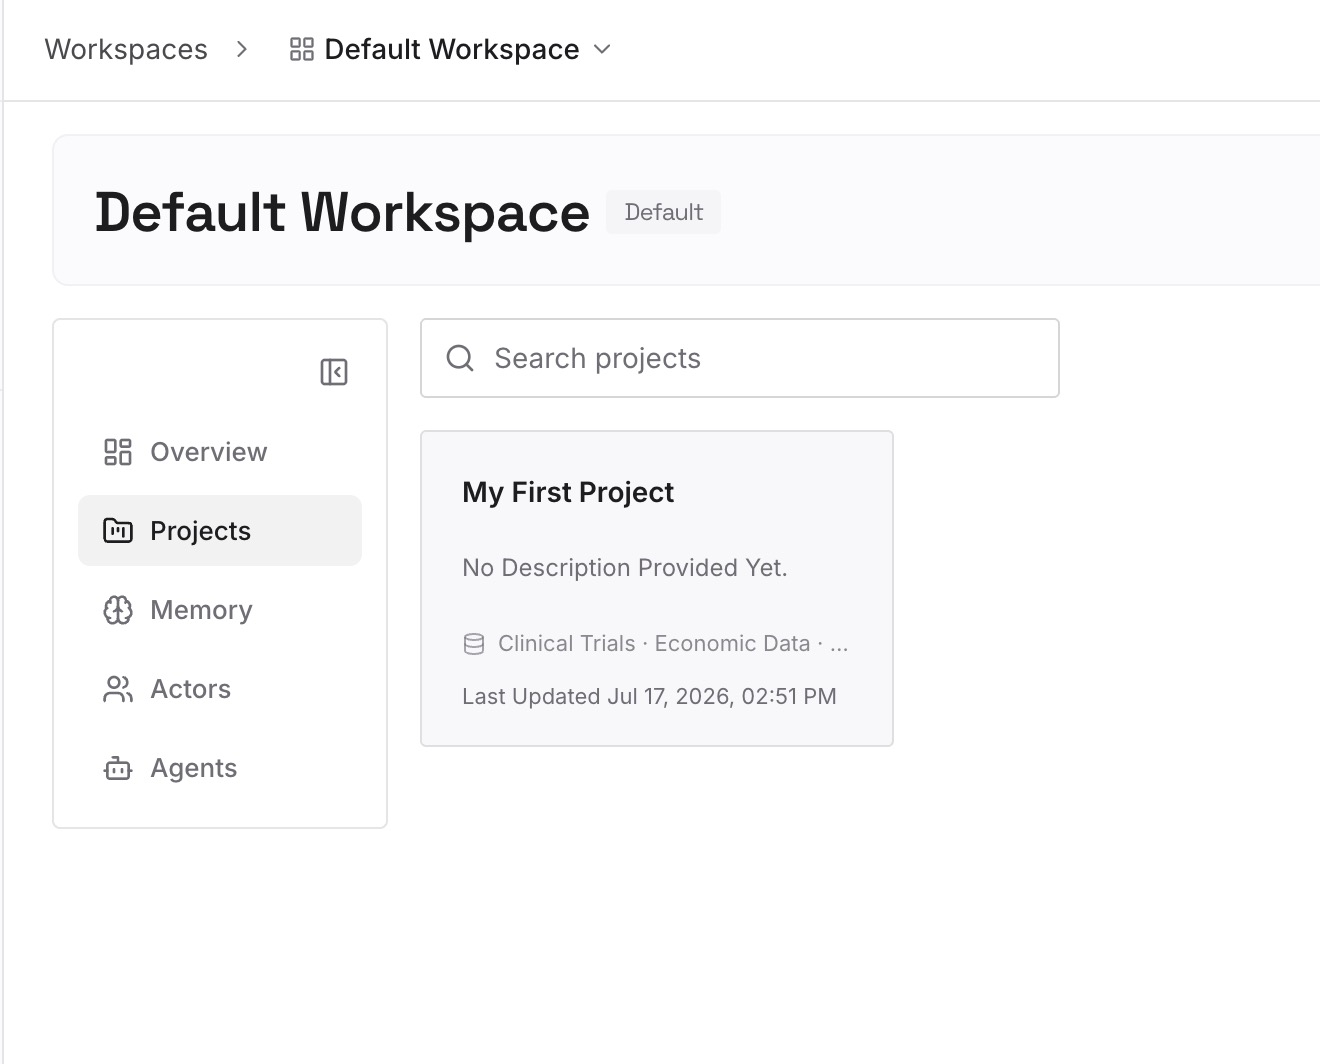
步骤 2:上传您的第一批记忆
从您的技能不断需要的事实开始:当前优先级、客户偏好、改变任务执行方式的决策。每个条目包含一个事实或决策,并附带日期。
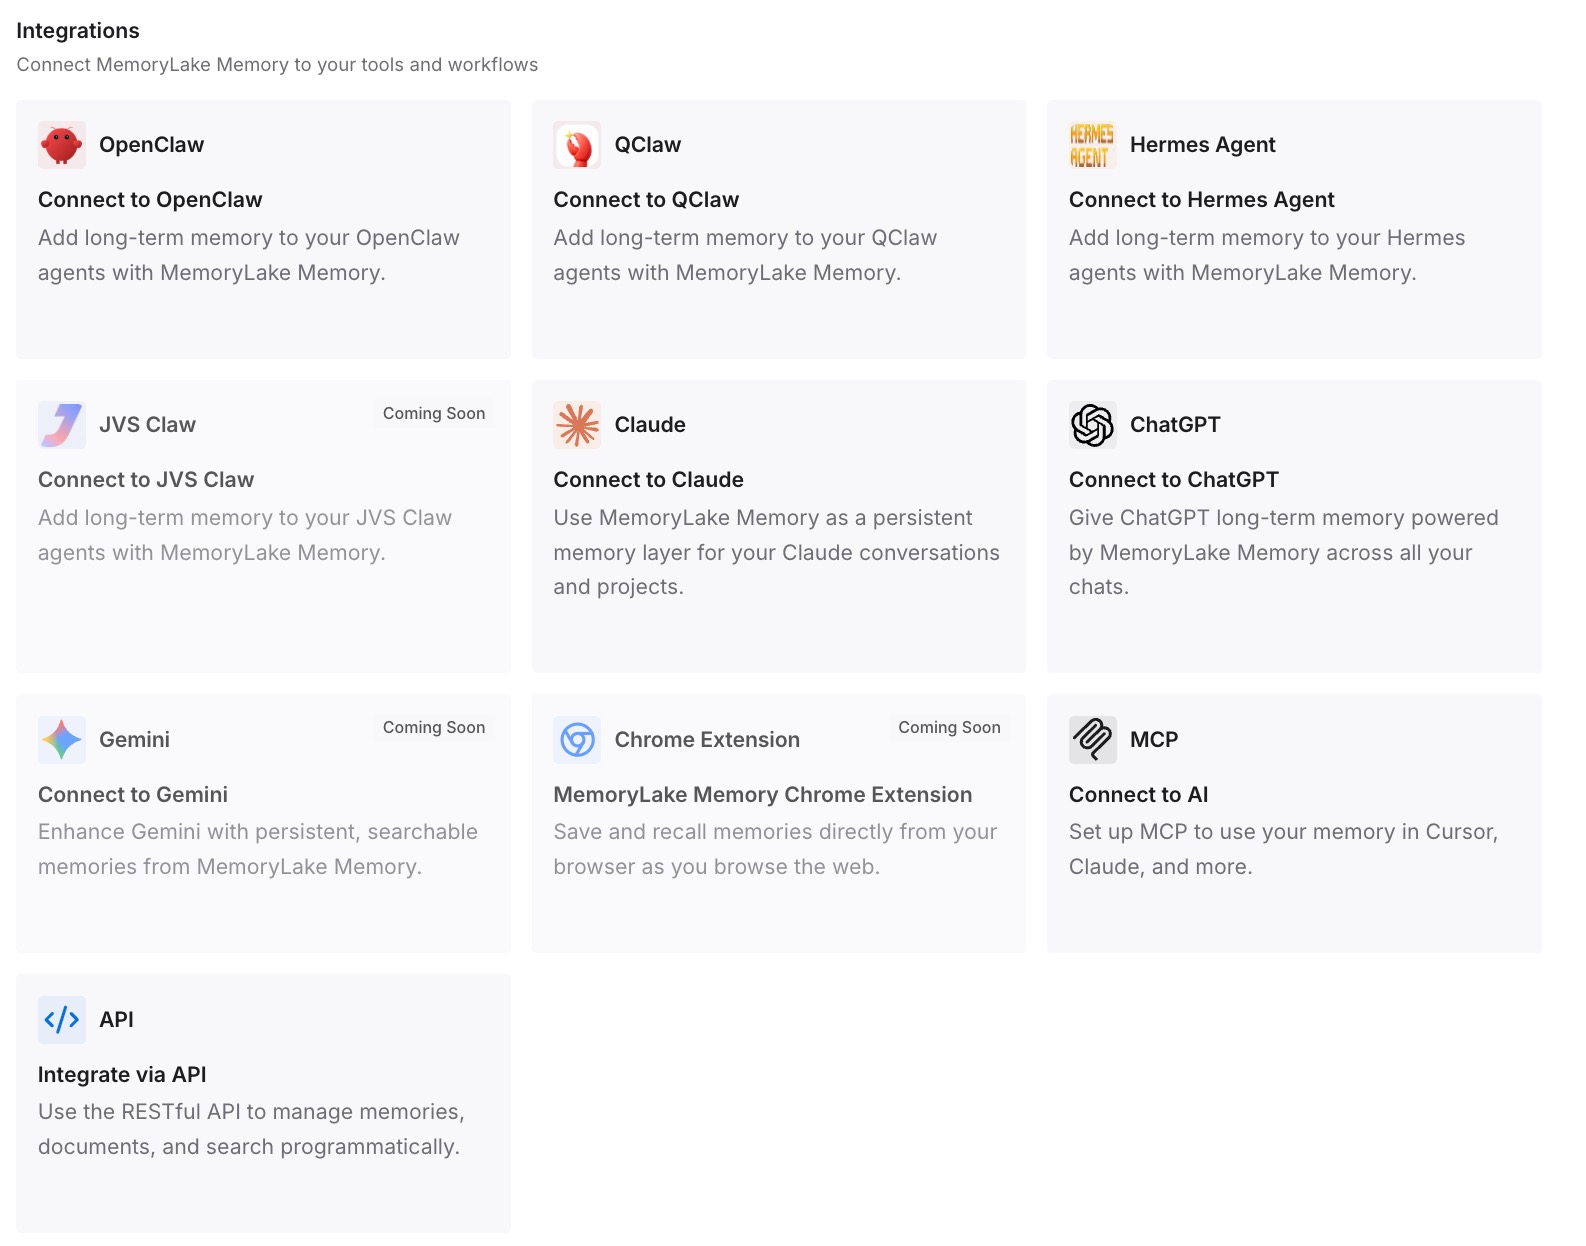
步骤 3:连接您的 AI 和智能体
连接 ChatGPT 和 Claude Code,以及您使用的任何其他助手。然后,您的技能将承载过程,并且当前上下文将在每个工具中与它们并存。
这在实践中带来了什么改变
第一个区别是技能集更加干净。迁移它们会迫使您进行审查,而最终保留下来的技能会使用可移植的字段,描述它们应该何时触发,并包含指令,而不是与单一工具绑定的功能。
第二个是清楚地知道每个技能将在哪里工作。仅限桌面端的技能和打包在插件中的技能是刻意的选择,而不是当技能没有出现在手机上时感到意外。
第三个是以后需要编辑的次数更少。由于不断变化的上下文被保留在技能之外,新的优先级或新的客户并不意味着要重写过程。我们关于将 Claude 对话迁移到 ChatGPT 的指南涵盖了对话历史记录,目前大部分上下文可能都保存在其中。
将 Claude 技能迁移到 ChatGPT 的最佳实践
从文件迁移,而不是从记忆迁移。 从技能文件夹开始工作,包括 claude.ai 技能的同步副本。
仅使用标准字段。 name 和 description 在两边都是必需的。Claude Code 的其余字段都是 Claude 专属的。
在描述中放入触发词。 隐式匹配取决于它。
提前决定是桌面端还是插件。 独立技能不会出现在 Web 端或移动端。
测试显式和隐式调用。 在您依赖某个技能之前,两者都应该正常工作。
每个技能保留一个副本。 在一个地方进行编辑,并将每个工具指向它。
将不断变化的上下文保留在技能之外。 流程比优先级更持久。
结论
Claude 和 ChatGPT 都基于相同的开放标准构建技能,因此 SKILL.md 文件可以在它们之间迁移,而无需从头重写。无法自行迁移的是所有 Claude 特有的内容:扩展字段、正文功能、技能存储位置以及围绕它们的共享。
从 Claude Code、claude.ai 和 API 中收集您的技能文件夹。将每一个修剪为标准字段,将触发短语合并到描述中,并转换调用设置。将它们安装在桌面应用上,或将其打包为 Web 端和移动端的插件,然后以两种方式测试每一个。将您的技能所依赖的上下文保存在某个您可以更新而无需触及技能的地方。