
究竟能迁移什么
以下是 SillyTavern 官方对这种划分的描述。有些字段被其称为永久 Token(permanent tokens)——"这些内容在每次生成请求时都会发送给 AI:角色名称(Character Name)、角色描述框(Character Description Box)、角色性格框(Character Personality Box)、场景框(Scenario Box)。"
而有些则不是:"首条消息框(first message box)——仅在对话开始时发送一次"以及"示例消息框(Example messages box)——仅保留到对话历史填满上下文为止(可选强制保留在上下文中)。"
第二堆信息通常是创作者倾注心血最多的地方。首条消息是创作者设定语气和长度的地方;SillyTavern 明确指出,模型"比其他任何内容都更容易从首条消息中吸取风格和长度限制"。示例消息则是人们用来训练节奏的地方。这两者在设计上都被归为非永久性内容,且在另一端(ChatGPT)都没有显而易见的对应归宿。
永久性信息是比较容易处理的一半。描述、性格和场景是始终启用的文本,SillyTavern 明确说明了这意味着什么:"这些信息总是包含在提示词中,因此所有重要的事实都应该包含在这里。"ChatGPT 的 Custom Instructions(自定义指令)也是类似的设计——OpenAI 将其描述为存放您希望应用的"明确信息或指令"的地方。这两者几乎完全吻合,这也是角色卡中可以通过复制粘贴完整保留的部分。
有些内容完全无法迁移,在开始之前,有必要了解是哪些内容。
创作者的元数据从一开始就不会发送给模型。 SillyTavern 指出,Created by(创建者)、Character Version(角色版本)、Creator's Notes(创作者笔记)和 Tags to Embed(嵌入标签)字段"不用于构建提示词,而是提供关于角色的附加元数据"。如果您一直在 Creator's Notes 中写入重要设定,那么实际上没有任何模型阅读过它。在开始迁移之前,请将其移至描述中,或者接受它原本就只是给人类看的事实。文档还指出,嵌入的标签"在导入角色时默认不会被导入",因此即使在不同的 SillyTavern 实例之间,标签结构也是脆弱的。
一张角色卡只能携带一本世界书(lorebook)。 SillyTavern 支持将世界信息(World Info)绑定到角色,并在导出时"该文件也将嵌入到角色卡数据中"——但它直接加上了限制:"请注意,只有主要的 World Info 文件会随角色一起导出。"您通过 Shift 点击添加的任何额外世界书,以及绑定到 Persona(角色人设)和绑定到对话的世界书,都是具有独立范围的独立文件。
关键词触发是 SillyTavern 引擎的一项功能。 世界信息条目通过关键词触发,SillyTavern 指出"触发关键词、标题以及 Content 字段之外的其他信息不会被插入到上下文中"。ChatGPT 官方文档中提到的个性化界面包括 Custom Instructions、记忆摘要(memory summary)和旧版的已保存记忆(saved memories);其文档并未描述类似于世界信息触发的关键词触发机制。条目文本可以很好地迁移,但触发机制需要您手动重建。
提示词覆盖即使在 SillyTavern 内部也是有条件的。 Main Prompt(主提示词)和 Post-History Instructions(历史后指令)框只有在启用了相应的用户设置(分别为"Prefer Char. Prompt"和"Prefer Char. Instructions")时才会生效。其他人制作的角色卡在分发时通常会填满这些内容,但在您的安装版本中可能处于静默未启用状态。
聊天记录导出存在文档中记录的损失。 JSONL 格式的导出才是真正的备份:SillyTavern 建议"使用此格式来共享或迁移包含所有元数据的聊天记录(但不包括图片和文件附件)"。纯文本导出只是一个阅读副本,文档警告说"它无法再次重新导入,因为它会丢失重要的元数据"。
如果您来自托管平台而非本地安装,Character.AI 基于关键词触发的条目的等效操作可以参考将 Character AI 世界书迁移至 ChatGPT,该文讨论了一个其自身导入文档将顺序和位置设置列为遗漏项的平台。本文则专注于在保留角色卡的平台上对卡片本身进行处理。
手动迁移
步骤 1:按生命周期而非字段顺序拆分角色卡
在接触 ChatGPT 之前,打开一张角色卡并将其重写为两个列表。
始终启用的列表。 包含描述、性格和场景框中的所有内容。这是 SillyTavern 在每次生成时都会发送的内容,因此它已经被编写为始终成立的事实。检查其中是否包含实际上特定于场景的内容并将其剔除——许多角色卡在描述中写了剧情,这导致每次回复都在消耗 Token。
初始设置列表。 首条消息和示例消息。这些是披着对话外衣的风格指令。阅读它们,并用散文的形式回答一个问题:它们在语气、长度、节奏和格式方面向模型传授了什么?将答案写成句子。"回复长度为两到四段。动作使用斜体,说话使用引号。绝不代表用户发言。"这一段话就是示例块的便携版本。
在此期间,对任何绑定的世界信息(World Info)进行同样的操作,并检查角色实际使用了多少本世界书。绑定到 Persona 的条目只要选择该 Persona 就会激活,无论是什么角色;绑定到对话的条目仅存在于单次对话中。这些作用域在另一端并不存在,因此它们需要转化为文字中的普通条件。
此外,还有必要进行一次 Token 实际情况检查,因为 SillyTavern 毫不避讳地指出:"如果您使用的 AI 模型具有 2048 个上下文 Token 限制,那么一个 1000 Token 的角色定义就会使 AI 的‘记忆’减半。"大多数角色卡是在比您现在迁移到的环境更紧张的预算下编写的。其中的一些压缩现在已无必要,而有些压缩现在甚至变得无法读取。
步骤 2:通过 ChatGPT 官方文档中记录的界面进行重建,然后检查哪些内容生效了
始终启用的列表放入 Custom Instructions 中。尽量保持简短——它在每次回复中都会起作用,这与 SillyTavern 的永久 Token 所描述的权衡是一样的。
初始设置列表作为常驻的风格指南输入,而不是作为示例对话。示例对话在 SillyTavern 中有效,是因为引擎对其进行了刻意的定位;直接粘贴到对话中,它只是一条会被滚动刷走的长消息。
条件性设定是需要做出真正选择的部分。您可以将某个条目提升到始终启用的堆栈中,这很简单,但会把预算花在几周都没人提及的阵营上。您可以将一个世界放入一个 Project(项目)中,让边界来处理作用域工作——OpenAI 记录了该边界的行为方式,指出在仅限项目的记忆中,"对话可以引用同一项目中的其他对话,但不能引用项目之外的对话,且项目之外的对话也不能引用项目内的对话。"或者,您可以在场景开始时粘贴条目,这确实可行,但这正是您为了避免手动操作而创建世界书的初衷。
然后进行检查,而不是凭空假设。OpenAI 自己的建议是"如果您想知道 ChatGPT 是否记住了某些内容,只需在对话中询问即可",并警告说记忆摘要"不会包含 ChatGPT 根据您的对话记住的所有内容"。在确定迁移成功之前,询问角色的三个核心特征,看看会返回什么。
更好的方法:保留关于角色的决策,而不仅仅是输入它们的输入框
剥离角色卡的外壳,真正有价值的不是字段布局。而是一系列的决策:这个细节在每个场景中都成立,那个细节仅在港口篇章中成立,这个语气偏向简短,这个角色从不使用主角的名字。SillyTavern 将这些决策编码为字段位置和插入设置。而另一个工具可能会以不同的方式编码它们,或者根本不进行编码。
将这些决策作为决策记录下来,它们就不再受限于单一引擎的输入框。
MemoryLake 是一个可以存放这些决策的理想场所。您可以用自己的语言亲自将条目写入其中,并注明每个条目的范围和原因,您连接的任何助手都会读取相同的数据集。无需从任何工具的文件中提取任何内容;这一层只保存您放入其中的内容。
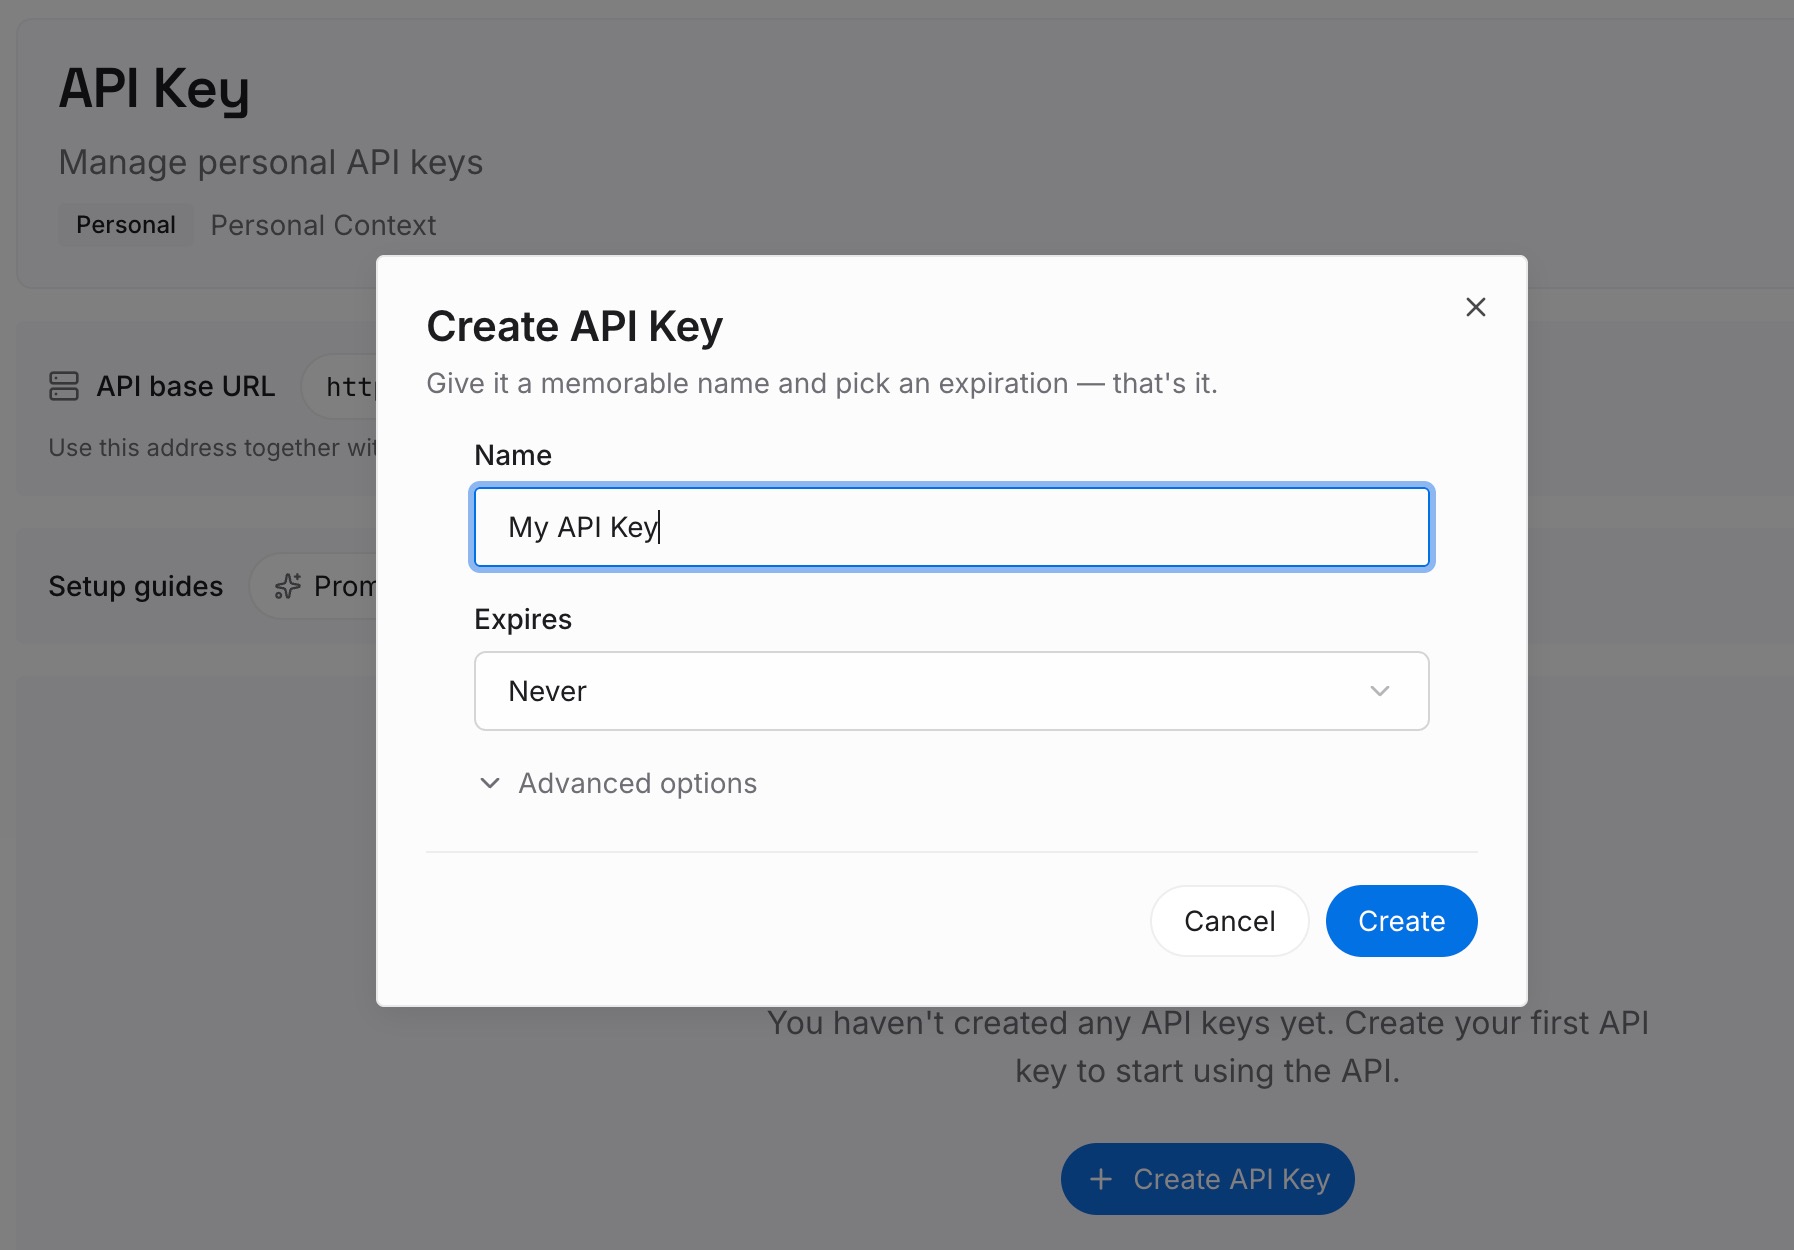
步骤 1:创建 API 密钥
登录,打开您的工作区设置,并生成一个 API 密钥。这是您的助手用于读取相同条目的凭据,因此只需创建一次,并将其保存在您编写的每个工具中都可以访问的地方。
步骤 2:上传您的第一批记忆
将这两个列表导入,并保持 SillyTavern 启发您的那种区分。每个主题一个条目。始终启用的事实标记为始终启用;有条件的条目则将条件写成句子,而不是关键词列表。从您实际创作的角色开始,而不是整个文件夹。
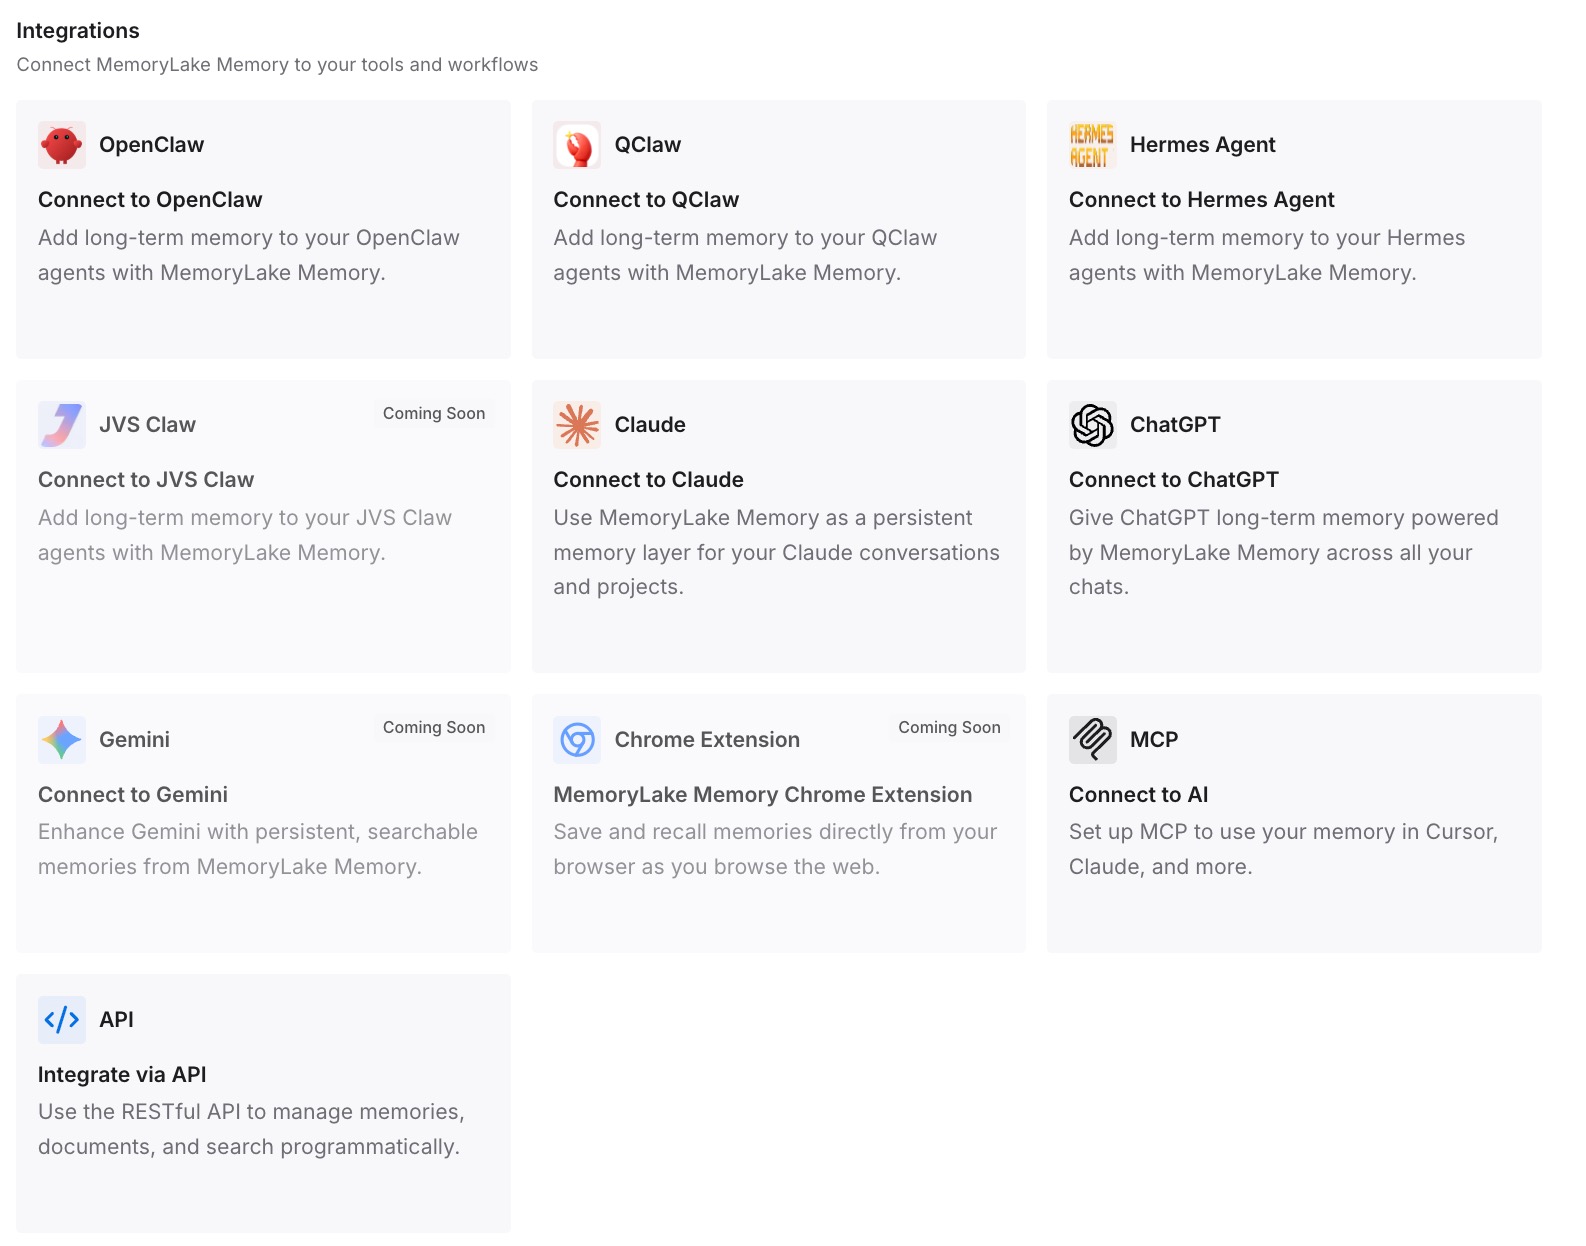
步骤 3:连接您的 AI 和智能体
连接 ChatGPT 以及您使用的任何其他工具。相同的角色会同步到每个工具中,当某个场景需要港口区的历史背景时,它就会自动获取,而无需您凭记忆重建港口。
这在实践中改变了什么
第一个区别是,您的创作不再受限于单一引擎的字段列表。卡片只是一种格式;角色才是一套决策。一旦这些决策被写成句子,导入到不同的前端或向托管助手发送提示词就变成了相同的工作。
第二个区别是非永久性的那一半不再是隐形的。超出上下文而被刷掉的示例消息在悄无声息地失去作用。而在示例消失后,书面形式的风格规则仍然有效——这与上一层讨论的当 Janitor AI 遗忘您的世界观设定时所描述的失效情况相同。
第三个区别是 Persona(人设)和角色不再混淆。SillyTavern 对它们进行了妥善的分离,而托管助手通常做不到。在您自己的笔记中保持这种区分,可以防止当 Character AI 遗忘您的 Persona 时所讨论的设定漂移。
第四个区别是可审计性。选择不当的关键词会静默失效;而用文字编写的条件则可以被阅读和纠正。这种审查习惯正是审计您的 AI 记住了什么的主题。
迁移角色卡的最佳实践
按生命周期而非字段进行迁移。 弄清楚哪些内容每次都会发送,哪些内容只发送一次。SillyTavern 对这两者都有文档记录;而大多数其他工具只有第一种。
将示例消息转化为风格段落。 它们原本的作用是传授语气、长度和格式。用直白的语言表达出来,它们就能在任何地方适用。
拯救 Creator's Notes 中的任何内容。 SillyTavern 指出创作者元数据不用于构建提示词。如果它承载了重要设定,它应该属于描述部分。
先迁移一个角色。 在对整个文件夹进行操作之前,先在您实际使用的一张卡片上运行整个流程。从托管平台而非本地安装进行迁移的更精简版本,可以参考我们的指南将 Character AI 迁移至 ChatGPT。
在导出前清点您的世界书。 只有主要的 World Info 文件会嵌入到导出的卡片中。额外的、绑定到 Persona 的以及绑定到对话的文件都是独立的。
将聊天记录导出为 JSONL,而不是文本。 文档指出,纯文本版本无法重新导入,因为它会丢失元数据。
在分享前清理导出文件。 SillyTavern 自身也给出了这个建议:如果您注重隐私,请检查导出的 JSONL 并删除您不想分享的任何内容。在文件离开您的电脑之前完成这一步。
做好目标平台列表不完整的心理准备。 OpenAI 表示记忆摘要不会包含所有内容,并建议在对话中询问。实际影响在ChatGPT 的记忆局限性中有所讨论。
结论
SillyTavern 做了一件真正有用的事情:它告诉您角色的哪些部分是每次都发送的,哪些是只发送一次的,并将这些事实写进了文档中,而不是让您从行为中去推测。这种区分是整个格式中最具可移植性的思想。
迁移之所以有些棘手,是因为目标平台文档中记录的界面几乎完全是围绕永久性的一半构建的。Custom Instructions 的行为类似于描述框。但在文档中,并没有与"先奠定语气然后退场"的首条消息,或者"一直保留到上下文填满"的示例块等效的机制。
因此,请保留这种拆分思路,而不是死守输入框。写下始终成立的事实,写下示例所传授的内容,并将这两者保存在您的下一个工具可以读取的地方。卡片格式还会再次改变。其中的决策是属于您的,只有用直白的语言表达出来,它们才能得以延续。