OpenAI 在 10 月 20 日添加了什么
此更改适用于 Responses API 中的 GPT-5.6 及更高版本模型。您可以通过 prompt_cache_options.ttl 设置生命周期,该参数接受两个值:默认的 30m 和 12h。OpenAI 的指南描述了何时使用它们。30 分钟的生命周期适用于“频繁重用上下文的对话和智能体步骤”。12 小时的生命周期适用于“在较长间隔内重用的稳定指令或参考资料”。
You can set the lifetime for a whole request or for individual breakpoints. The guide says "The request-level ttl applies to the implicit breakpoint and to explicit breakpoints without their own ttl." An explicit breakpoint can override it with prompt_cache_breakpoint.ttl。
写入 12 小时缓存的计费费率高于 30 分钟缓存,而两者的读取成本相同。OpenAI 官方的建议是进行对比:“将较高的 12 小时写入费率与 30 分钟覆盖失效后重新写入前缀的成本进行对比。”请在 OpenAI 的定价页面上查看您所使用模型的当前费率。
旧模型保留其自身的设置。指南指出,这些新设置“不会改变旧模型的 prompt_cache_retention 参数”,并且迁移清单建议,在迁移到 GPT-5.6 或更高版本时,“将 prompt_cache_retention 替换为 prompt_cache_options.ttl”。
提示词缓存实际存储了什么
缓存并不以文本形式存储您的提示词。OpenAI 解释说,模型在处理输入时会计算中间键值状态,并且“提示词缓存为可重用的前缀保留了该状态:即提示词开头未更改的 token。”它补充道:“提示词缓存存储的是键值(KV)张量,而不是 token 本身。”
由此产生两个后果。首先,匹配必须完全一致。“缓存重用要求整个渲染后的前缀完全匹配。”其次,缓存不会改变模型对该前缀的处理方式。在常见问题解答中提到:“提示词缓存不会改变模型生成输出 token 的方式。”
换句话说,缓存是为了降低模型已经处理过的输入的成本和延迟。它不是存储信息的地方,也不会让模型记住任何东西。
12 小时生命周期承诺了什么,又留下了哪些不确定性
名称中的数字是一个最小值。OpenAI 的指南指出“OpenAI 保留条目的时间可能会长于请求的最小值”,并且该设置“不会设定删除截止日期,也不会改变最大数据保留政策”。数据控制页面也做出了同样的区分:prompt_cache_options.ttl “控制的是最小缓存生命周期,而不是这个最大应用状态保留期”。
最小值关系到定价资格,而不是重用的保证。“最小生命周期决定了是否适用缓存读取定价。它并不保证每个请求都能重用存储的 KV 张量或降低延迟。”位置也很重要:“缓存状态存在于单台机器上,”并且“只有当请求到达保存有未过期匹配条目的机器时,才能重用缓存前缀。”缓存也是有范围限制的:“缓存不会在组织之间共享,也不能跨区域处理边界重用。”
读取不会重新启动 12 小时的计时。“30 分钟的读取会将覆盖范围刷新到该读取后至少 30 分钟。”当该读取命中具有 12 小时覆盖范围的条目时,该条目将保留较晚的过期时间,指南指出“它不会重新启动 12 小时计时,也不会产生另一次写入费用。”
升级需要支付新的写入费用。“将有效的 30 分钟覆盖范围升级到 12 小时会针对这些 token 收取新的 12 小时写入费用,且不退还之前的写入费用。”如果您将一个繁忙的前缀从 30 分钟切换到 12 小时,切换后的第一个请求将支付全新的写入费用。
此外,目前无法手动控制过期。“目前无法手动清除缓存。”
哪些内容适合放在 12 小时断点之后
OpenAI 的建议是根据提示词各部分的更改频率来拆分提示词。将您整天重复使用的材料放在提示词的开头,并设置 12 小时断点。将更改更频繁的会话上下文设置为 30 分钟的默认值。将当前问题留在最后一个断点之后,在仅显式模式下,它“不会产生缓存写入费用”。
长寿命前缀适用于:
- 开发者指令:定义智能体的角色和规则。
- 工具定义:指南建议保持其稳定:“保留工具定义、顺序和 schema。”
- 参考资料:智能体在大多数请求中需要咨询的内容。
不应该放在那里的是任何因用户或因天而异的内容。指南明确指出:“如果开发者指令或共享材料包含时间戳、用户特定内容或其他动态内容,请将这些内容放在末尾而不是开头,或者将它们移到后面的对话消息中。”
有两个结构细节需要注意。“顶层 instructions 不能包含显式断点”,因此您想要标记的可重用指令应放在“开发者消息内的 input_text 块中”。并且前缀必须超过最小尺寸。对于 GPT-5.6 及更高版本,指南将其设定为 1,024 个可见输入 token。
什么会破坏长寿命前缀
因为匹配必须从第一个 token 开始完全一致,所以断点之前的任何更改都会使后面的内容失效。“如果内容或相关设置在断点之前发生更改,则该更改之后的前缀将无法与现有缓存条目匹配。”
这不仅包括文本,还包括设置。指南列出了 model、tools、parallel_tool_calls、text.format、reasoning.effort、text.verbosity 和 context_management 等可能影响缓存前缀的设置。在 GPT-6 模型上,它建议追加一个 configuration_update 项来更改推理努力程度(reasoning effort),而不是更改请求级别的设置。
重写历史记录也会破坏它。指南的建议是“追加新消息,而不是重写先前的轮次”,因为“摘要、压缩或上下文截断可能会改变前缀并重置缓存重用。”我们关于 Claude Code 空闲压缩的指南 从另一方面展示了相同的权衡,即压缩恰好在缓存过期之前发生。
甚至扩展消息也可能导致这种情况。如果一个请求以包含一个内容块的消息结束,而下一个请求向该同一消息添加内容,则旧的终点现在位于消息内部而不是其末尾,并且如果在那里没有显式断点,则保存在该点的先前前缀将无法重用。
您的智能体仍会忘记什么
这是更长缓存无法改变的部分。OpenAI 的会话状态指南从最基础的开始:“虽然每个文本生成请求都是独立且无状态的,但您仍然可以通过在文本生成请求中提供附加消息作为参数来实现多轮对话。”模型应该知道的任何内容都必须通过请求传递给它,无论是由您自己发送还是引用存储的会话状态。
缓存只是让再次发送稳定的前缀变得更便宜。它不会向其中添加任何内容。如果您的智能体在周二早上得知某位客户更改了套餐,这一事实并不会包含在您早上 8 点写入的 12 小时前缀中。要包含它,您要么将其追加到对话中,要么编辑前缀。编辑前缀属于断点之前的更改,这意味着需要重新写入。
因此,设计问题发生了转移。长寿命前缀鼓励在数小时内保持共享材料的稳定。而整天都在不断进步的智能体会积累属于其他地方的事实:在对话中、在您的应用程序检索的存储中,或者在您更新并定期折叠回前缀的精选列表中。对于对话,OpenAI 的 Conversations API 是一种途径。指南指出它可以“将会话状态持久化为具有其自身持久标识符的长期运行对象”。对于跨对话的持久事实,您需要一个自行维护的数据源。我们对面向开发者的 AI 记忆 API 的对比 介绍了这些选项。
人们首先会尝试的做法(常见误区)
把所有内容都放入 12 小时前缀中。 用户姓名、今天的日期、最新的工单。这些内容中的每一个都会发生变化,而断点之前的每一次更改都会强制进行新的写入。
假设 12 小时就意味着整整 12 小时。 这只是定价资格的最小值。条目可能会存活更长时间,而且如果请求没有到达存有该条目的机器,仍然可能会发生缓存未命中。
期望读取操作能延长 12 小时的窗口。 读取操作只会将覆盖范围刷新到读取后至少 30 分钟,并不会重新启动 12 小时的计时。
将缓存视为智能体的记忆。 缓存保存的是您发送的前缀的处理后状态。它本身不保存任何事实,也不会改变输出的任何内容。
在不进行衡量的情况下切换设置。 12 小时写入的成本更高。它是否划算取决于前缀被重用的频率以及时间间隔有多长。
解决方案:根据更改频率拆分提示词,仅给稳定部分设置 12 小时,并将事实保存在您维护的数据源中
步骤 1:将您的提示词分类为稳定、会话和当前
从您的智能体中获取一个真实的请求,并标记每个部分:
- 稳定(Stable): 指令、工具定义和参考资料,这些内容在不同用户之间是完全相同的,并且在数小时内保持不变。
- 会话(Session): 当前对话或任务的上下文,在接下来的几分钟内会被重复使用。
- 当前(Current): 此请求中的新问题或工具结果。
任何带有时间戳、用户标识符或单次请求数据的内容都要移出稳定部分。如果稳定部分低于最小可缓存尺寸,指南建议“将其缩短,或使用有用的、稳定的指令、示例或参考资料进行扩展”并衡量结果。
步骤 2:放置断点并衡量结果
将稳定部分放在最前面,置于开发者消息中,并将显式断点设置为 12h。在其后放置会话上下文,使用 30 分钟的默认值。将当前输入留在最后一个断点之后。在 GPT-5.6 及更高版本上,一个请求最多可以创建四个缓存写入,因此您有空间设置几个层级。
然后进行衡量。usage 对象会报告 cached_tokens 和 cache_write_tokens,对于这些模型,cache_write_tokens_details 会将写入拆分为 ttl_30m_tokens 和 ttl_12h_tokens。观察 12 小时前缀被写入的频率。如果它一天被重写好几次,请检查其中是否有内容发生了变化。
步骤 3:将智能体学到的事实保存在您维护的数据源中
决定新知识的去向。生命周期短的上下文留在对话中。应该比对话存活更久的事实(例如客户的套餐、团队做出的决定或用户给出的纠正)则放入您精选的存储中。
按照适合您重用模式的时间表,将每个请求都需要的事实折叠到稳定前缀中。这使得重写成为一个刻意的事件,而不是由每个新细节触发的。按请求检索其余内容,并将其放在断点之后。
在 MemoryLake 中进行设置
当您的提示词稳定部分按照您的时间表(而非智能体的时间表)发生变化时,12 小时缓存的效果最好。这意味着您的智能体所依赖的事实需要一个独立于缓存和任何单一对话的归宿。
MemoryLake 是一个记忆层,用于将这些事实保存在您维护的一个列表中,供您连接的助手(如 Codex、Claude Code 和 ChatGPT)使用。
您可以用自己的语言亲自编写这些条目。不会从 OpenAI 的提示词缓存、您的 API 对话、您存储的响应或任何供应商的存储中读取、写入或删除任何内容。请排除您的政策不允许留在系统之外的机密和个人数据。
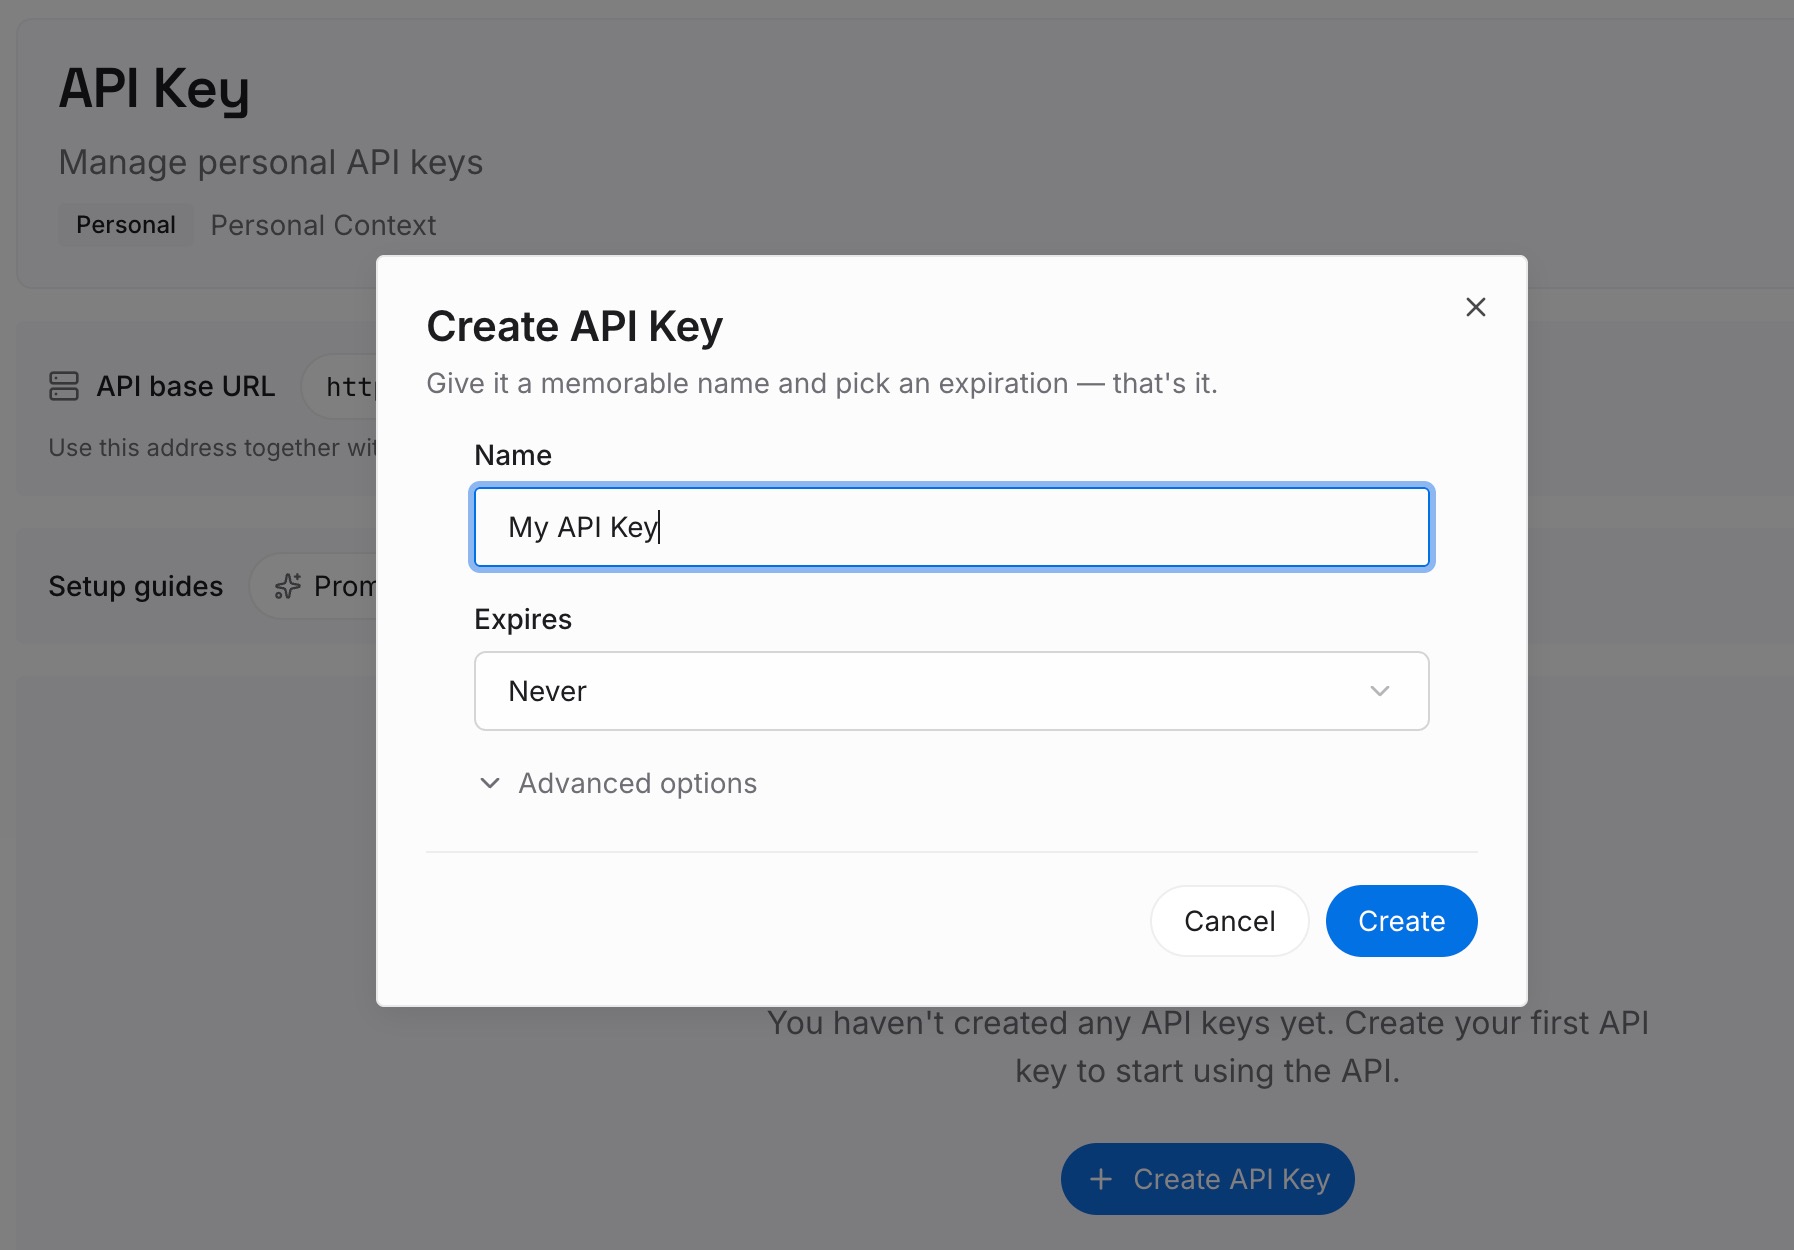
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 OpenAI API 密钥是分开的。
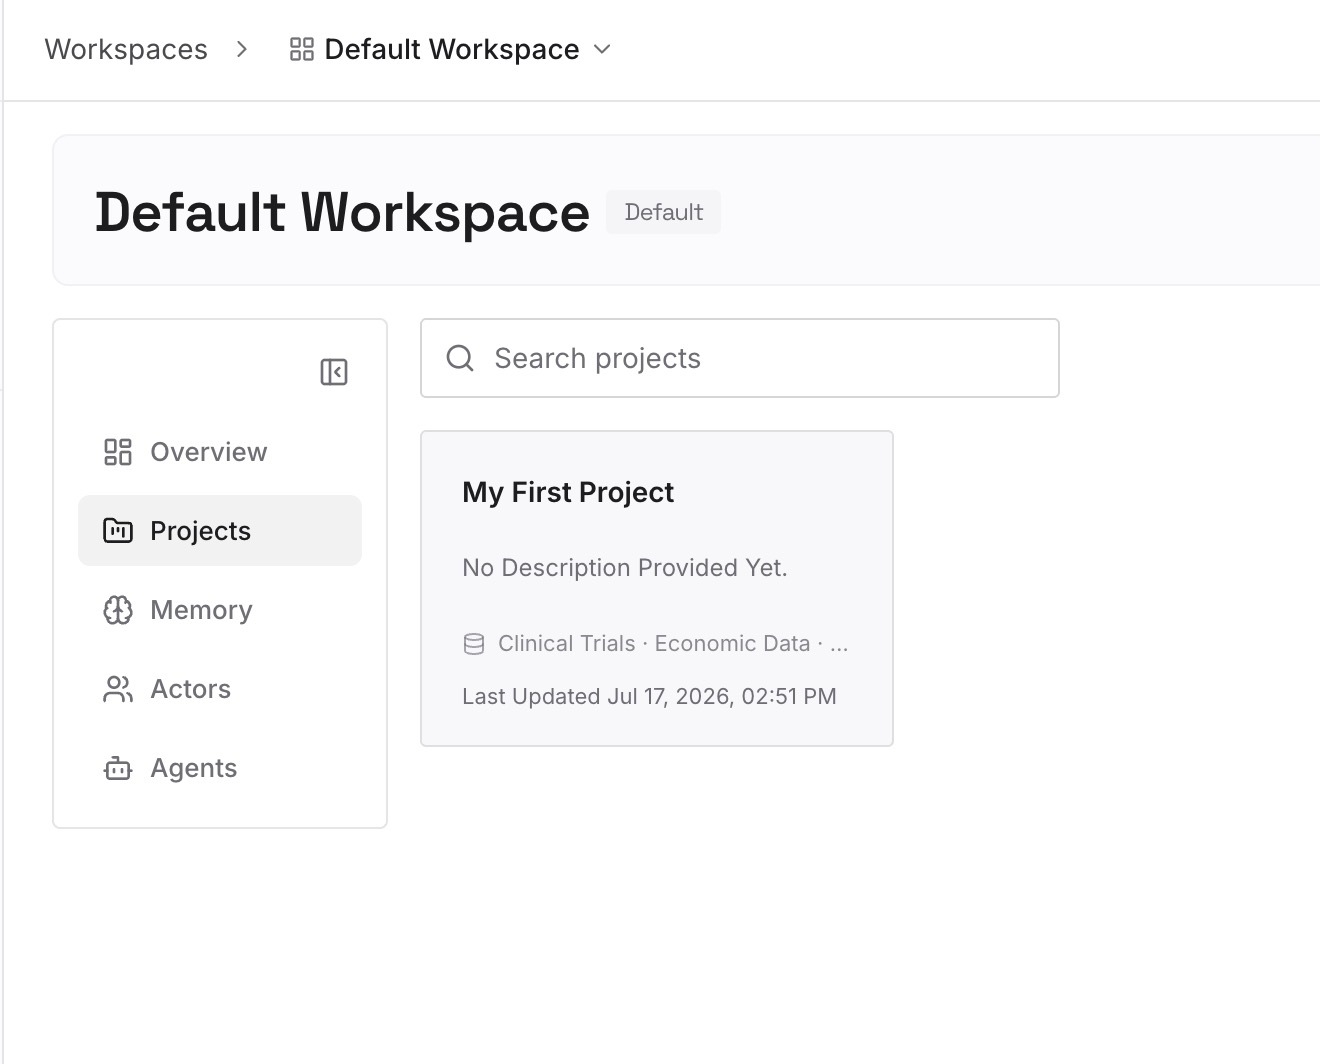
步骤 2:上传您的第一批记忆
从您在解决方案的步骤 3 中整理出来的事实开始:您的智能体应该跨对话了解的决定、纠正和参考点。每个条目记录一个要点,并注明日期,以便您可以查看自上次前缀重建以来发生了什么变化。
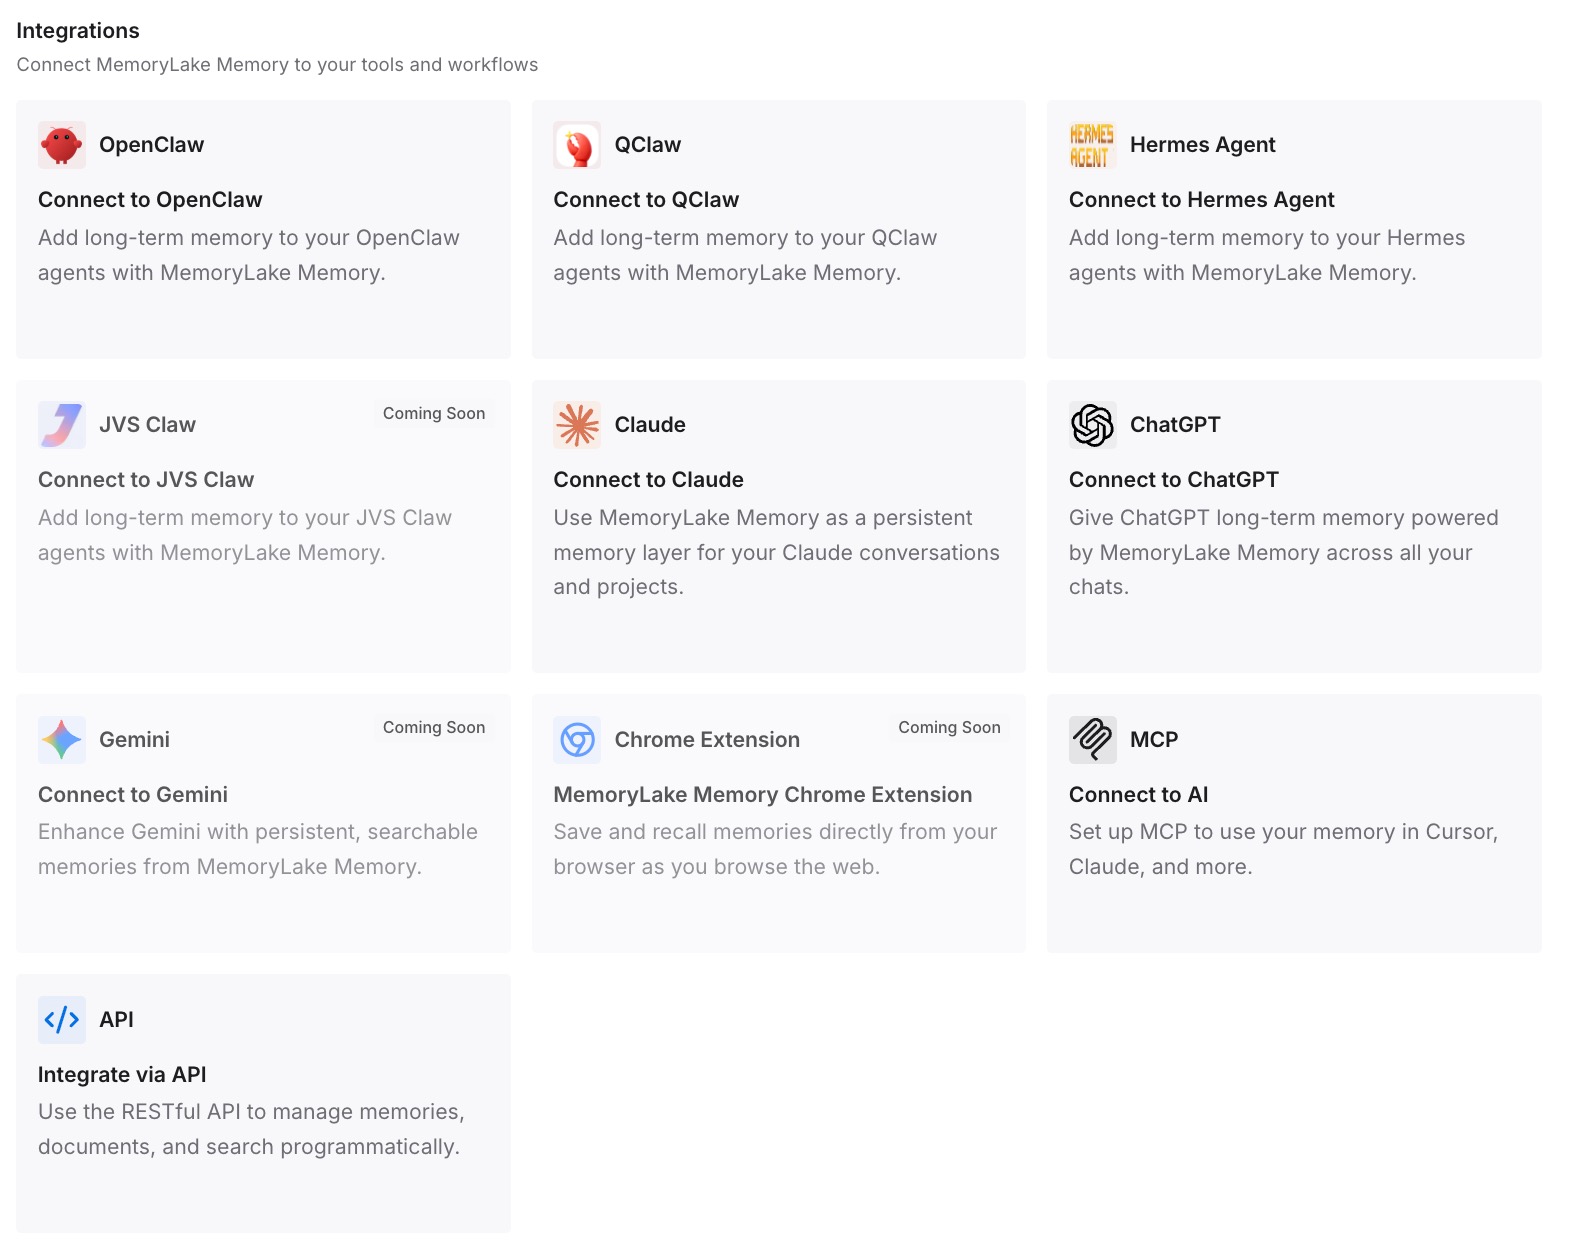
步骤 3:连接您的 AI 和智能体
连接您使用的助手和编码智能体。当需要重建稳定前缀时,您可以从一个列表中进行操作,而无需从旧对话中重新构建。
这在实践中带来了什么改变
第一个区别是 12 小时前缀保持稳定。移除了每用户和每日数据后,它仅在您重建它时才会发生变化,使用情况对象中的写入次数也表明了这一点。
第二个区别是新知识有了明确的去向。它会进入对话或您维护的列表中,而不是在一天当中去编辑已缓存的前缀。
第三个区别是成本决策变得可衡量。您可以在真实流量上对比 12 小时和 30 分钟的写入,而不是凭空猜测。对于精简提示词与保留上下文之间更广泛的权衡,我们关于为什么仅靠缩短提示词还不够的指南 介绍了其他杠杆。
12 小时提示词缓存的最佳实践
仅对数小时内完全相同的内容使用 12 小时。 例如指令、工具和共享参考资料。
避免将时间戳和用户数据放入稳定前缀中。 将它们移到末尾或后面的消息中。
追加内容而不是重写。 压缩和截断会改变前缀。
将可重用的指令放在开发者消息中。 顶层 instructions 无法容纳显式断点。
阅读写入明细。 ttl_12h_tokens 显示了长寿命前缀被重写的频率。
按计划重建前缀。 刻意地折叠进新的事实,而不是一次折叠一个。
将持久事实保留在缓存之外。 我们关于应该给 AI 智能体多少记忆的指南 介绍了该保留什么以及该排除什么。
结论
OpenAI 的 12 小时提示词缓存允许智能体以已缓存输入费率,在更长的时间间隔内重用稳定的指令、工具和参考资料。官方文档对其限制进行了谨慎的说明:12 小时是定价资格的最小值,而不是删除截止日期或重用保证,读取不会重新启动 12 小时计时,并且断点之前的任何更改都会破坏匹配。
此外,缓存并不保存知识。每个请求仍然必须携带模型应该知道的内容。根据提示词的更改频率对其进行拆分,仅给稳定部分设置 12 小时,并将您的智能体学到的事实保存在您维护的数据源中,并按照您自己的时间表折叠进去。