
OpenAI 究竟发布了什么
首先来看看 Habitat 是什么,以及谁在读取它。OpenAI 将其描述为“我们构建的在线存储平台,以便 OpenAI 产品能够快速、可靠地访问所需信息”,并在开头列出了它所服务的请求类型:“每个 OpenAI 产品都依赖于对数据的快速、可靠访问,无论是有人登录、检查其 Codex 设置,还是在 ChatGPT 中开始新对话。在产品做出响应之前,这些操作中的每一个都可能需要多次独立的数据查找。”
其规模被清晰地阐明。Habitat“现在每秒处理超过 7000 万次请求,支持每周超过 10 亿人使用的产品,横跨近 40 个地理区域”,并且“如今,它是一个复杂的分布式系统,服务着超过 500 PB 的数据”。
接下来是这里至关重要的设计决策,OpenAI 将其标记为一个决策,而非一个限制:
“Habitat 暴露了一个简单的 NoSQL API,而不是允许客户端构建可能导致大表扫描或跨多表连接(join)的任意 SQL 查询。缺乏强大的 API 是 Habitat 设计中的一个明确权衡。”
其原因在于可预测性。“我们的目标是针对简单、可预测、恒定工作量的请求进行优化。根据我们的经验,这些系统明显更容易扩展,且不易出错或被滥用。具有不可预测扇出(fanout)的请求在运维上是危险的:它们使隔离、负载均衡变得复杂,并引入了难以针对服务和客户端进行扩展的延迟悬崖(latency cliffs)。”
数据模型也由此而来。“Habitat 暴露了一个围绕客户端定义的对象和边(edge)类型建模的 NoSQL API,灵感来自 TAO。客户端预先定义对象和边以及它们之间的关系,但不定义每个类型的具体内容。”OpenAI 在这里指出了其灵感来源,这值得注意 —— 这是一个经过实践检验的成熟模式,而不是为了偷工减料而发明的新东西。
然后是媒体报道忽略的那句话:
“我们对这个图进行分区,以便每个对象及其对应的边在存储级别分区中协同定位(colocate),但我们在数据库级别没有做出协同定位对象与其边所指向的远程对象的协同努力。结果是,该模型很容易进行分区以实现水平扩展,但图遍历效率低下,因为对象之间的任何特定跳转(hop)可能需要从存储在不同区域的两个完全不同的 Azure Cosmos DB 账户中进行获取。”
把这段话读两遍。一个对象和它的直接边坐在一起。而这些边所指向的东西可能位于世界的另一端。OpenAI 明确地划定了界限:“由此产生的关系类似于图,但 Habitat 本身不支持查询特定对象的直接边之外的典型图遍历查询。”
任何更复杂的需求都会被完全移出实时路径:“对于有更复杂查询需求的客户端,我们确实通过 Rockset 暴露了 Habitat 的离线二级视图。”更改通过变更数据捕获(change data capture)进行流式传输,每个团队运行自己的实例,OpenAI 明确解释了原因:“这种设计将我们的在线存储与读密集型的分析和搜索工作负载隔离开来。”
这改变了什么,又没有改变什么
它没有改变 ChatGPT 今天的任何行为。这是一篇关于基础设施层的工程文章,而不是产品发布,OpenAI 也没有声称它是。
它也没有告诉你任何特定功能的数据存放在哪里。该文章将 ChatGPT、API、Codex 和内部服务列为 Habitat 的客户端,并以“在 ChatGPT 中开始新对话”作为请求示例。它没有公布任何产品功能的模式(schema),本文也不打算凭空捏造一个。
它改变的是你所能做出的推测的质量。在这篇文章发表之前,“为什么我的助手能记住单个事实,却似乎永远无法将它们联系起来”只是一种猜测。现在,有一个记录在案的架构原因解释了为什么在存储层关联事物是高成本操作,这是由构建它的团队亲口说的:单对象查找及其直接边是廉价的、恒定工作量的场景,而对象之间的跳转则是可能跨区域的场景。
这与“AI 记忆力差”是不同的说法,而且是一个更有用的说法。为什么长上下文不等于记忆中描述的差距通常被归结为模型问题。而在这里,同样的问题出现在更低的一层 —— 存储层,由一家厂商针对其自身系统发布。
还有一句话值得牢记,因为它用十几个字解释了整个设计哲学:“当用户的平均请求导致数百次数据库调用时,用户感受到的是最慢的那次数据库调用。”
人们会从中得出什么误解,以及为什么不应该
认为 OpenAI 在存储上偷工减料。 文章详尽地论证了相反的观点,并给出了理由。限制 API 是使这种规模的系统具有可预测性的原因;OpenAI 将无限制的查询称为“运维上危险的”,并直接描述了成本的不平衡:“编写昂贵且难以运行的 SQL 查询是廉价且容易的。”一个拒绝让产品团队编写可能导致 10 亿人数据库崩溃的查询的平台,才是一个尽职尽责的平台。
认为这是 OpenAI 独有的问题。 事实并非如此。OpenAI 将 TAO 列为灵感来源,这是另一家公司在不同规模下发布的设计,它所体现的权衡 —— 将对象与其边协同定位,接受远程跳转成本高昂 —— 是使图形状的存储进行水平分区的标准方法。任何运行超大型在线数据存储的人都面临着同样的算术题。
认为离线副本可以为你解决这个问题。 Habitat 的逃生通道是真实存在的,OpenAI 也坦言这需要付出代价:“这种 Rockset 配置给我们的客户端带来了额外的摩擦”,并且每个团队“负责扩展他们自己的 Rockset 实例”。这是一个有负责人和预算的内部工程选项。它不是一个面向用户的特性,文章中也没有任何内容表明它是。
认为解决方案是更长的上下文窗口。 遍历成本和上下文长度是两个独立的问题。更大的窗口改变了在一次请求中可以向模型展示多少内容;它并不会改变存储层将哪些查找视为廉价的。这种混淆的检索版本在为什么 RAG 不等于记忆中有所提及 —— 找到一份文档并不等同于得出一个结论。
解决方案:将连接保存在专门负责连接的地方
如果单对象查找在任何地方都是廉价的场景,那么持久的对策就是停止指望按需推导连接,而是开始将连接作为其自身的对象记录下来。
步骤 1:将事实与它们之间的关系分开
梳理你实际上依赖助手了解的内容,并将其分为两类。
第一类是事实。“我们按整天计费。”“测试数据库在法兰克福。”“Priya 负责支付集成。”每一个都是独立的,对于任何系统来说,获取它们都是廉价的。
第二类是关系,而这正是价值所在。“我们按整天计费,因为财务系统拒绝接收非整天的账单。”“测试环境在法兰克福,因为 2025 年合同中的数据驻留条款。”“自重组以来,Priya 负责支付,这就是为什么旧的运行手册中写的是别人的名字。”
第二类是没人会写下来的内容,因为在当时看来,每一半都是显而易见的。它也是重新构建成本最高的内容,并且是任何针对恒定工作量单次查找进行优化的存储最不擅长为你重新组装的内容。
步骤 2:将关系写成一句话,而不是两个条目加上“希望”
写成一句话的关系是一个单一对象。而在两个条目之间保持隐式关系则是一种遍历 —— 而你刚刚读完了一家厂商关于为什么遍历是高成本路径的描述。
因此,将“法兰克福,因为 2025 年的驻留条款”写成一条记录,而不是写成一个位置记录和一个合同记录,然后期望某种机制为你进行连接。这是一个付出小、回报大的习惯,它与写好 commit 信息的本能是一样的:diff 是事实,commit 信息是关系。
如果两条记录确实存在冲突,请在记录本身中说明,而不是把矛盾留给以后去发现。没人这样做时的失败模式是记忆冲突检测的主题。
步骤 3:给该层一个每个助手都能访问的地址
你写入某个产品记忆中的关系,是下一个产品无法看到的。将该层保持在任何单一厂商的存储之外,这样更换工具或同时使用三个工具时,就不需要从头开始重新编写你的关系。该问题的实际应用在跨 ChatGPT、Claude 和 Gemini 的统一记忆中得到了解决。
在 MemoryLake 中进行设置
MemoryLake 就是为第二类内容而构建的。你可以用自己的话将决策及其背后的原因写入其中,你连接的每个助手都会读取相同的内容。没有任何内容是从任何厂商的存储中提取的;该层只保存你放入其中的内容。
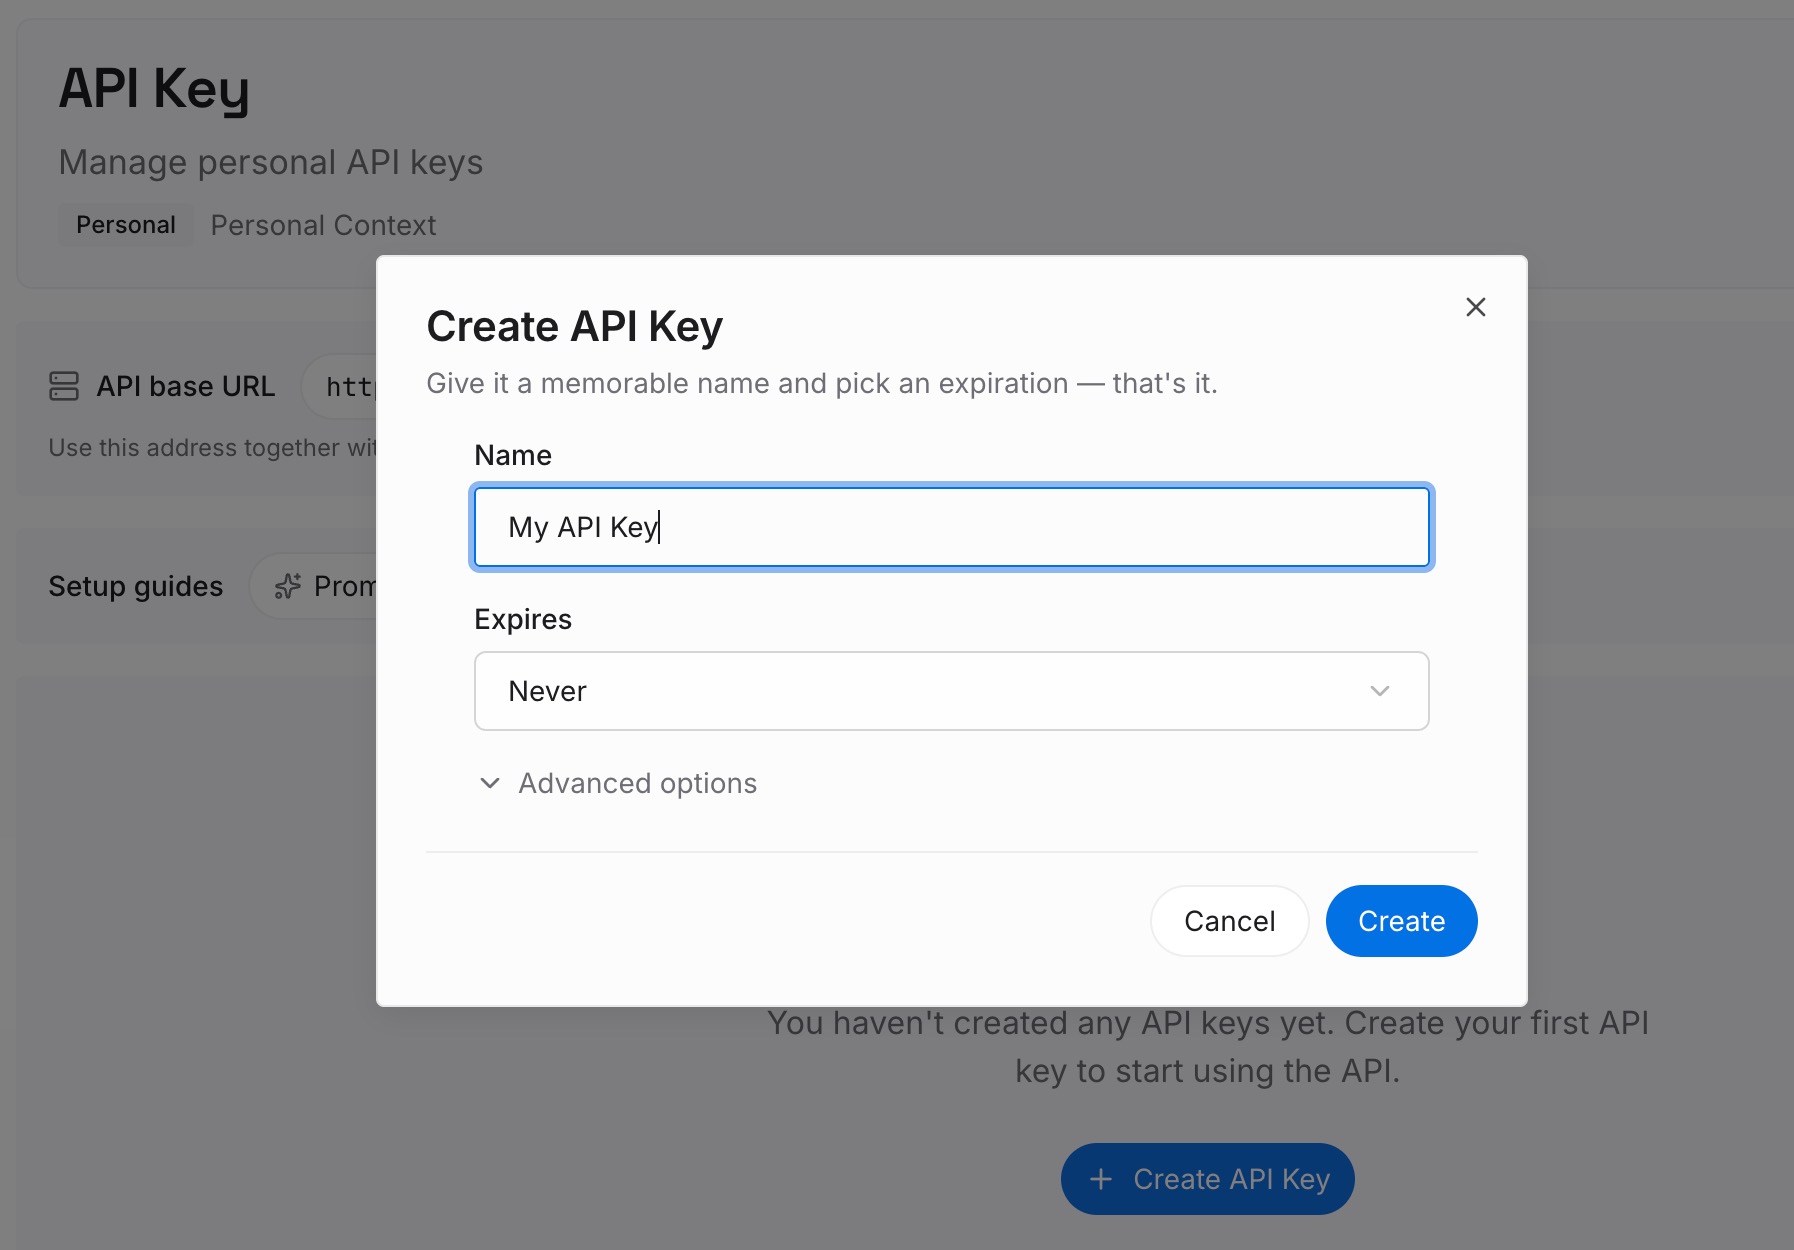
步骤 1:创建 API 密钥
登录,打开你的工作区设置,并生成一个 API 密钥。这是你的助手用来读取同一层的凭据,因此只需创建一次,并确保你使用的每个工具都能访问它。
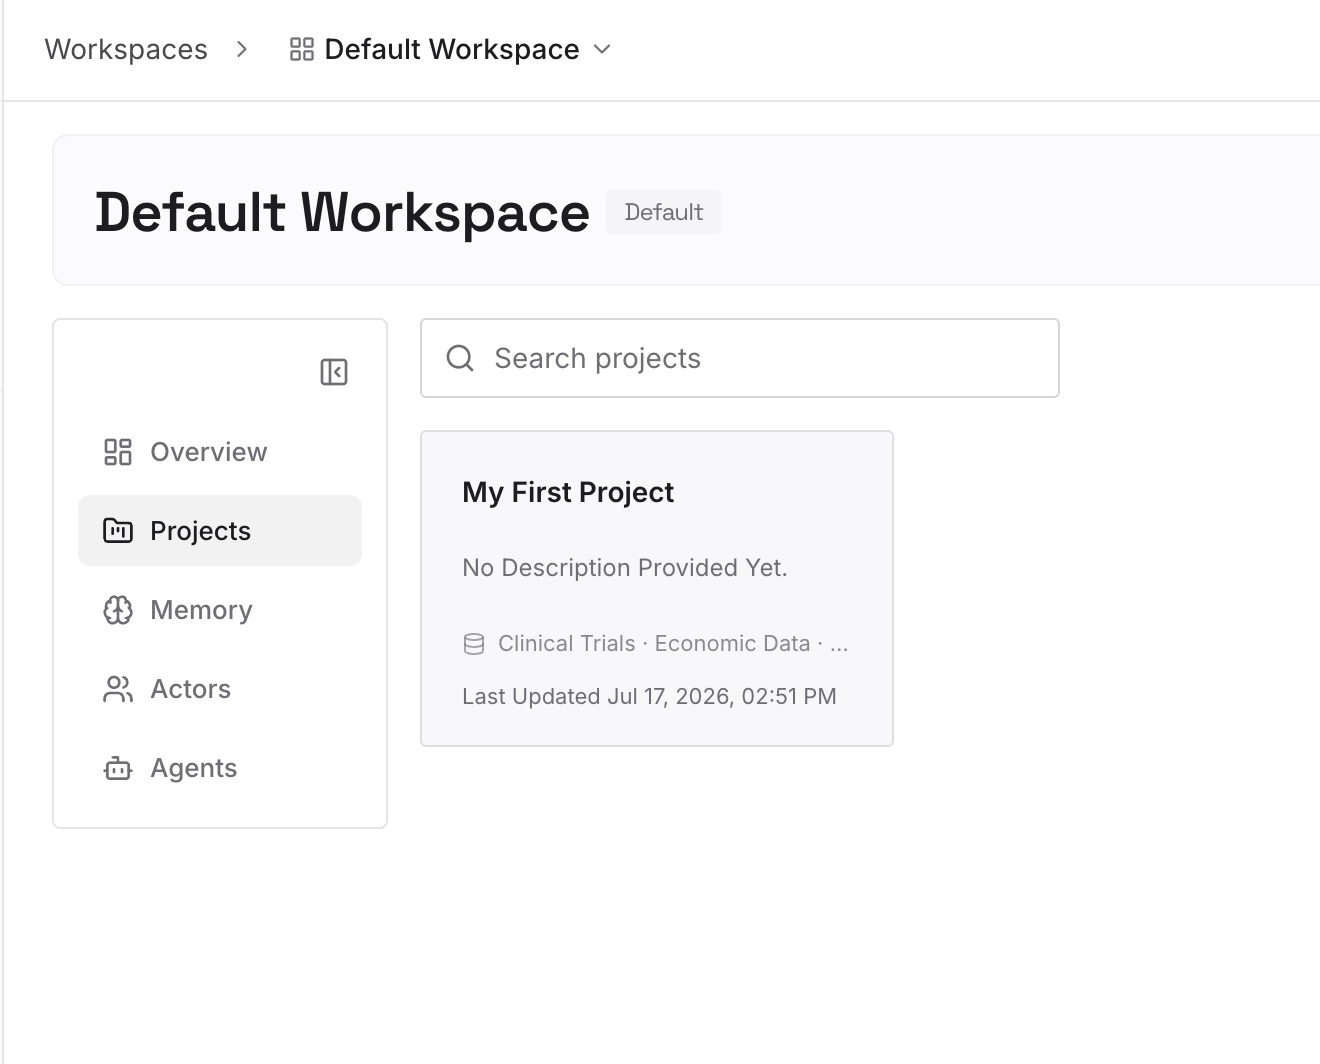
步骤 2:上传你的第一批记忆
从关系开始,而不是事实。把你本季度解释过两次的五件事拿出来,将每一件写成一句话,其中既包含规则也包含原因。添加那些重新发现成本高昂但记录成本低廉的限制条件。
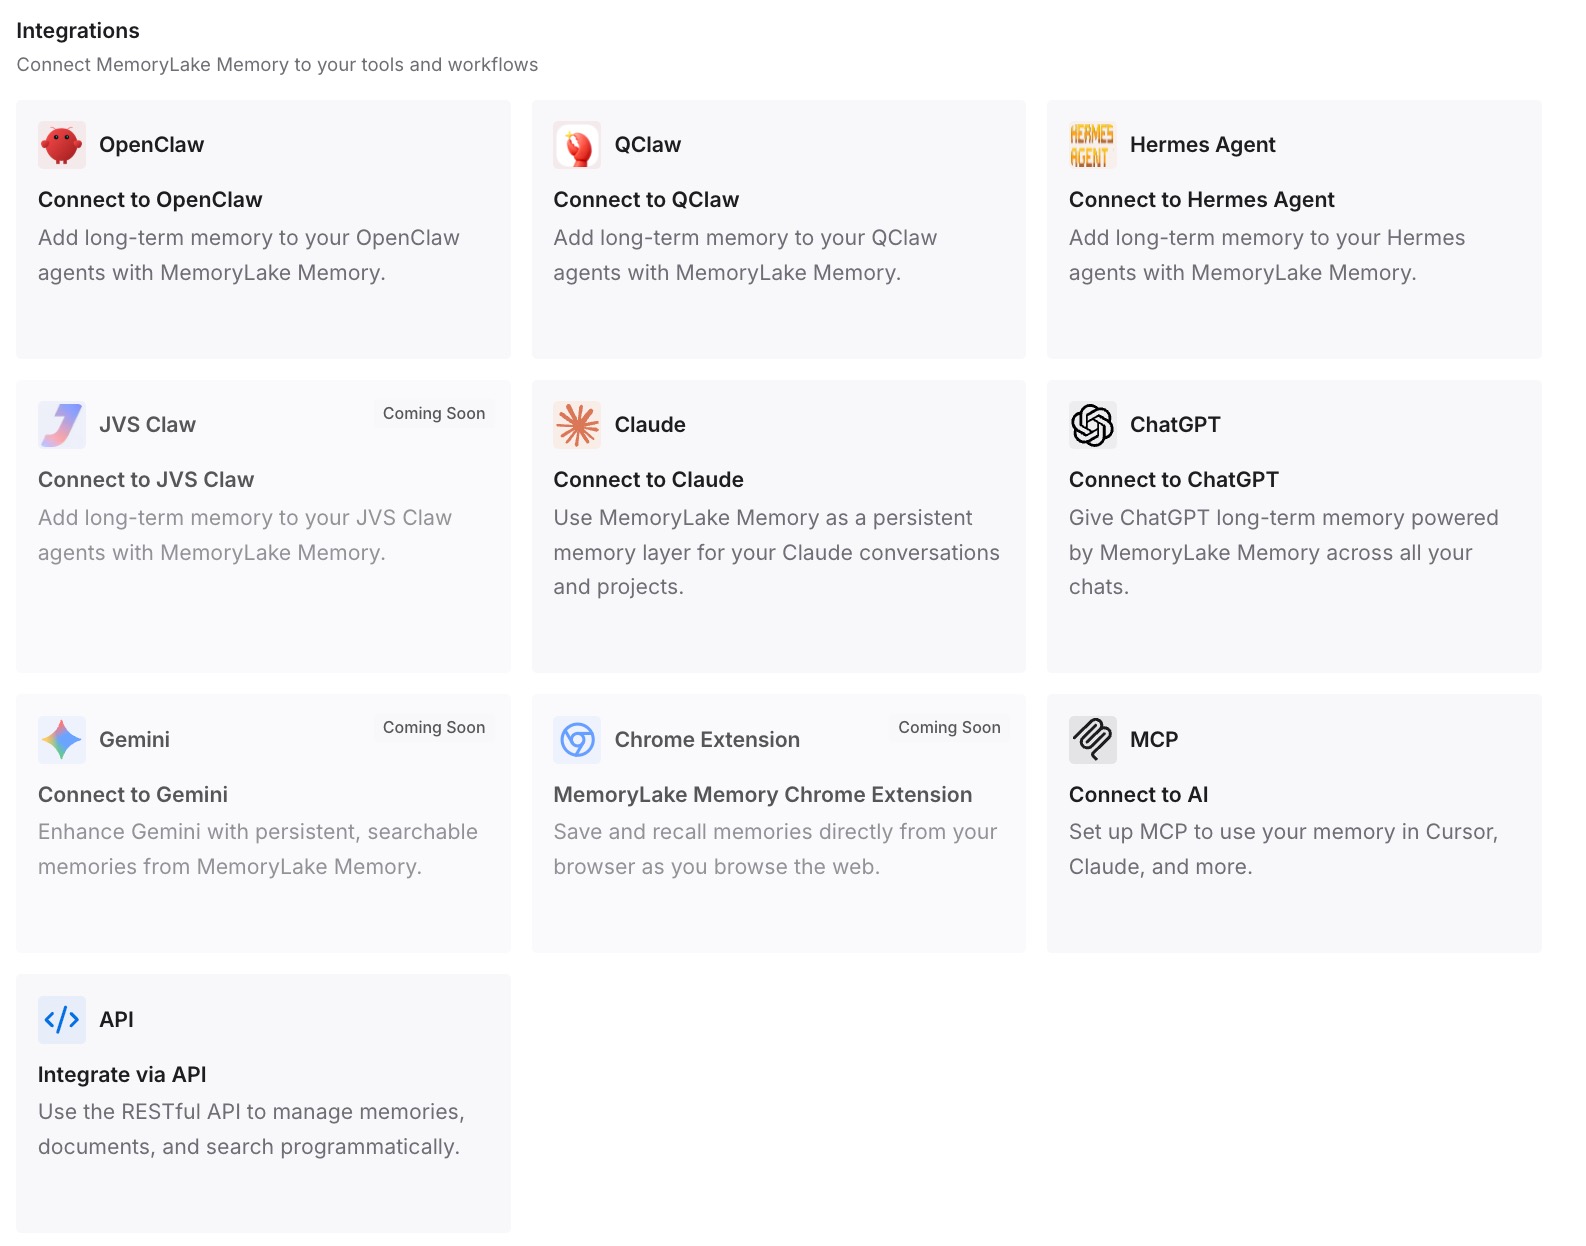
步骤 3:连接你的 AI 和智能体
连接 ChatGPT 以及你使用的任何其他工具。相同的推理会应用到每一个工具中,因此新的对话将从你已经得出的结论开始,而不是从头开始。
这在实践中改变了什么
第一个区别是,你不再为错误的事情感到恼火。一个记住了你所在的城市却记不住你为什么搬到那里的助手,并不是粗心大意;它是由一个非常擅长获取单个对象及其直接边的存储层提供服务的。了解这一点可以将模糊的抱怨转化为具体的习惯。
第二个区别是,你的笔记变得更短、更有用。一条承载了自身原因的记录不需要第二条记录来解释,这意味着它在被孤立读取时也能存活下来 —— 这正是这些系统所优化的访问模式。
第三个区别在情况发生变化时显现。一旦写下了原因,你就可以回头检查它们是否仍然成立,这与重新阅读事实列表并琢磨哪些已经过时是完全不同的活动。这种审查习惯是审计你的 AI 记住了什么的主题。
第四个区别是跨会话的连续性。当 ChatGPT 在会话之间丢失上下文时中描述的失落感,主要是因为那些从未在任何地方记录过的关系,每次都需要你手动重新推导,从而付出了高昂的代价。
使用查找型记忆的最佳实践
每个决策写一条记录,并在其中包含原因。 只有放在一起才有意义的两条记录,是注定会失败的遍历。
偏好具体而非结构化。 一句通俗易懂的话胜过一个你不会去维护的聪明模式(schema)。负责获取数据的系统擅长返回你存储的内容;它们不擅长推断你想要关联的内容。
记录改变了什么,而不仅仅是当前属实的内容。 “我们在三月份停用了共享账户”比“我们有自己的账户”更有用,因为它告诉读者哪些旧材料是不可信的。
每季度重新阅读一次你最旧的条目。 事实会悄无声息地腐烂。原因会显而易见地腐烂,并且更容易被发现是错误的。
将该层保持在任何单一产品之外。 厂商会重构架构。OpenAI 刚刚发表了一篇文章,描述了一个从库到服务再到重写的服务,并承诺会推出关于存储层的第二部分。你的推理不应该需要关心这些。
不要将工程文章视为产品规格说明。 这篇文章描述了一个平台及其权衡。它没有记录任何功能的数据模型,将其解读为产品规格说明纯属猜测。
结论
关于 Habitat 的文章是一篇优秀的工程写作,值得保留的部分不是重写。而是一家厂商在未被要求的情况下声明,其在线存储是故意为简单、可预测、恒定工作量的查找而设计的,对象之间的关系可能会落在不同的区域,任何需要真正遍历的操作都会转到具有自己负责人的离线副本中。
从字面上理解这一点,对我们其他人来说,结论既平凡又令人释怀。不要再等待你所说的两件事之间的联系在需要时被重新发现。将这种联系作为其自身通俗易懂的句子记录一次,保存在你使用的每个工具都能读取的地方。这把高成本的操作变成了廉价的操作 —— 这正是 OpenAI 的平台团队在上一层所使用的相同技巧。