
Anthropicが実際に公開した内容
状況は明快に記録されています。Anthropicのエンジニアは「2021年から2025年にかけてと比較して、四半期あたり8倍のコードを出荷している」とし、「コードを書くことはもはや制約ではなく、PRレビューが加速されると、CIがプレッシャーを感じ始める」と述べています。一方で「コードベース全体のテスト量は10倍に増加し、エンジニアの増員はわずかだった」とのことです。その結果、「当社のCIジョブの量は6ヶ月間で25倍に増加しました」。
すべての変更に対してすべてのテストを実行するのではなく、Anthropicは記事の中で「過去のパフォーマンスとパッケージの関連性に基づいて、各変更でどのテストを実行するかを決定する、決定論的なテスト影響分析またはテスト選択サービス」と呼ばれるものを構築しました。これには2つの半分があります。「『リスナー』がすべてのCI実行からテスト結果を記録する」。「『セレクター』がテスト結果の履歴を読み取り、開かれたPRでどのテストを実行するかを決定する」。
この2部構成のデザインがストーリーのすべてです。一方のコンポーネントが何が起こったかを書き留め、もう一方が書かれた内容を読み取って決定を下します。書き手が現実に追いついている限り、読み手の決定は根拠に基づいたものになります。しかし、書き手が遅れると、何も壊れません。読み手は単に、世界ともはや一致していない記録に基づいて、自信を持って決定を下し続けるだけです。
そして、実際に遅れが生じました。「リスナーがPRキューに対してますます遅れ始めました」。その規模は具体的です。「リスナーの20分の遅延は、数万件のテスト更新がセレクターに適用されないことを意味します」。原因も同様です。「テストごとの実行履歴を保持するために単一のライターが結果を適用する必要があったため、これらすべてが単一のプロセスとして実行されていた」ため、「水平シャード(分散)ができなかった」のです。
そして、例の段落が登場します。長期的な修正をどのように進めたかについて、Malhotraは次のように書いています。「私は、サービスの監視に特化したClaude Tagの社内バージョンで、長期実行セッションを開始しました」。それはイベント駆動型でした。「リスナーの遅延が50,000ジョブ以上になるたびに、Claudeが私に通知し、次のステップについての会話を再開しました」。そして、重要な一文がこれです。「これは数ヶ月間続き、過去の取り組みやコンテキストを常に思い出させる必要がないのは非常に役立ちました」。
彼はさらに、じっくり考える価値のある一文を付け加えています。「Claudeはしばしばオーバーホール(全面刷新)を主張しましたが、私たちは通常、別のパッチ(応急処置)で済ませていました」
これが変えること、変えないこと
主張されている内容について正確に理解しましょう。誇張されやすい部分だからです。
Anthropicはここで記憶(メモリ)製品を発表しているわけではありません。この記事はテスト選択に関するエンジニアリングの回顧録であり、問題のセッションは社内ツールの社内ビルドで実行されたものです。他者もこのように働くべきだとはどこにも書かれていませんし、今すぐ有効にできる機能について説明しているわけでもありません。
また、Anthropicは被害を誇張しないよう注意を払っています。サービスが大幅に遅れたとき、記事にはこうあります。「明確にしておきますが、これはそれらのPRでCIが全く実行されなかったことや、未テストのコードが本番環境にプッシュされたことを意味するわけではありません」。起こったことはもっと限定的です。セレクターが「古いデータを使用して、PRで何を実行し、何を実行しないかを決定していた」のです。これは、失敗に対する誠実で限定的な説明であり、ドラマチックに仕立て上げるのではなく、そのまま引用するに値します。
この記事が確立しているのは、どちらも実体験に基づく2つのことです。
1つ目は、決定までに数ヶ月を要した判断が、途切れることのない1つの会話によって維持されたということです。ここで評価されている価値は、知能でも速度でもありません。「過去の取り組みやコンテキストを常に思い出させる必要がないこと」――つまり、すでに到達していた場所を再構築するためのコストの削減です。6週間前のスレッドを再度開き、なぜ2週目に明白な解決策が却下されたのかを思い出すのに20分を費やしたことがある人なら誰でも、そのコストを理解できるでしょう。
2つ目は、まったく独立して、書かれた記録がそれに基づいて下される決定から遅れたときに何が起こるかを、同じ記事が説明しているということです。その遅延は目に見えませんでした。エラーも発生しませんでした。古い状態に基づいて、自信に満ちた決定が下されていたのです。
これら2つの観察は、逆の方向を向いた同じ観察です。記録が追いついているとき、数ヶ月に及ぶ議論は一貫性を保ちます。記録が遅れると、下流のすべての決定が静かに劣化し、それを知らせるものは何もありません。
人々がここから誤解しがちなこと
「長いコンテキスト(Long context)がこれを解決する」 解決しません。そしてこの記事は、意図せずその理由を示しています。未知の数のアラートにわたって数ヶ月間実行されるセッションは、コンテキストウィンドウの問題ではありません。それは、アクティベーション(起動)の間に何が生き残るかという問題です。私たちはこの違いを、なぜ長いコンテキストウィンドウは記憶ではないのかという記事で別途解説しました。
「チャットログに対する検索(Retrieval)があれば機能したはずだ」 検索は、クエリに類似したテキストを見つけ出すだけです。この議論を前進させたのは、合意された立場(オーバーホールが必要であること、3つのパッチが試されたこと、それぞれのパッチが稼いだ時間は前回よりも短かったこと)でした。これは結論であり、単なる一節ではありません。トランスクリプト(会話履歴)からそれを検索することは、それを保持することとは異なる操作です。私たちはその境界線を、なぜRAGは記憶ではないのかで引きました。
「Anthropicはエージェントがアーキテクチャを決定すべきだと証明した」 記事は、控えめにその逆を述べています。Claudeは繰り返しオーバーホールを主張しましたが、他の優先事項を持つ人間によって繰り返し却下されました。記事は、最終的な合意をエンジニア自身の教訓(「常に指数関数的な成長を想定して計画を立てる」)として位置づけています。セッションが貢献したのは継続性であり、権限ではありません。
「これはコーディングエージェントの話だ」 このメカニズムはコードとは何の関係もありません。記録レイヤーが決定レイヤーから遅れるというのは、アシスタントに保存されたあなたの好みの要約が6月に書かれ、あなたが8月に考えを変えたときに起こることと同じです。エラーは表示されません。ただ、回答が微妙に間違っていくのです。
解決策:それを生み出した会話だけでなく、結論を書き留める
数ヶ月に及ぶセッションが機能した理由は、多数の中断を挟んでも、合意された少数の事実が維持されたからです。特定のベンダーのセッションが開いたままになっていることに依存せず、意図的にこの特性を得ることができます。
ステップ 1: 実行ログと合意された立場を分離する
複数回にわたる議論の終わりには、2つの成果物が存在します。1つはトランスクリプト(会話履歴)で、これは長く、主に却下した選択肢で構成されています。もう1つは「立場(ポジション)」で、これは短く、何が決定され、何が試され、それにいくらかかり、何がその回答を変えるかを示します。
トランスクリプトとは別に、自分の言葉で散文として立場を書き留めてください。通常は4〜5文で十分です。「より大きなマシンを試したが、約70日間しか持たなかった。パッケージごとのシャードを試したが、約1ヶ月しか持たなかった。毎日の再起動を試したが、1日しか持たなかった。次のステップは、4つ目のパッチではなく、再設計である。」
この段落こそが、数ヶ月に及ぶセッションが実際に運んでいたものです。残りはすべて足場(スクラップ)にすぎませんでした。
ステップ 2: 立場に日付を付け、何に取って代わったかを記録する
Anthropicの記事における失敗モードは、通知なしに遅れてしまった記録でした。あなた自身のメモも同じように失敗します。あなたが新しくなる一方でメモは古くなり、そのギャップを示すものは何もありません。
したがって、立場が変わったときは、黙って上書きしないでください。新しい立場を書き、日付を記入し、それが何に取って代わるかを1行残しておきます。「3月の時点で、再起動はもはや解決策とはみなされない。」何に取って代わったかを知っている保存された事実は検証可能ですが、そうでない事実は信じるしかありません。ご自身のストレージ内で矛盾するバージョンがどのように解決されるかを見たことがない場合は、まずメモリの衝突検出を理解する価値があります。
ステップ 3: 次のセッションが指示されずに読み取れる場所に置く
最後の特性が、それを永続的なものにします。Anthropicのセッションが機能したのは、アシスタントが通知を送った時点で、すでにコンテキストを持っていたからです。午前2時に遅延アラートが鳴ったとき、誰もアシスタントに再説明(ブリーフィング)しませんでした。
これを再現するには、ドキュメントをコピー&ペーストするのを思い出すのではなく、作業開始時にツールが読み取るストレージに立場を保持します。テストは簡単です。任意のアシスタントで完全に新しい会話を開き、何が決定されたかを尋ねてみてください。最初に説明しなければならない場合、その立場は「記憶」されているのではなく、単に「書き留められている」だけです。この違いは、セッション間でのコンテキストの共有のテーマです。
MemoryLakeでの設定方法
MemoryLakeは、他社の製品に入り込む場所ではなく、すべてのアシスタントにすでに持たせておきたい決定事項を保存する場所として、独立したアドレス可能なレイヤーとなるために存在します。エントリーはあなた自身の言葉で、あなた自身が書き込みます。Anthropicのシステム、OpenAIのシステム、またはその他のベンダーのストレージから何も引き出されませんし、それらのベンダーが保持しているものを読み取ったり、復元したり、変更したりすることもありません。
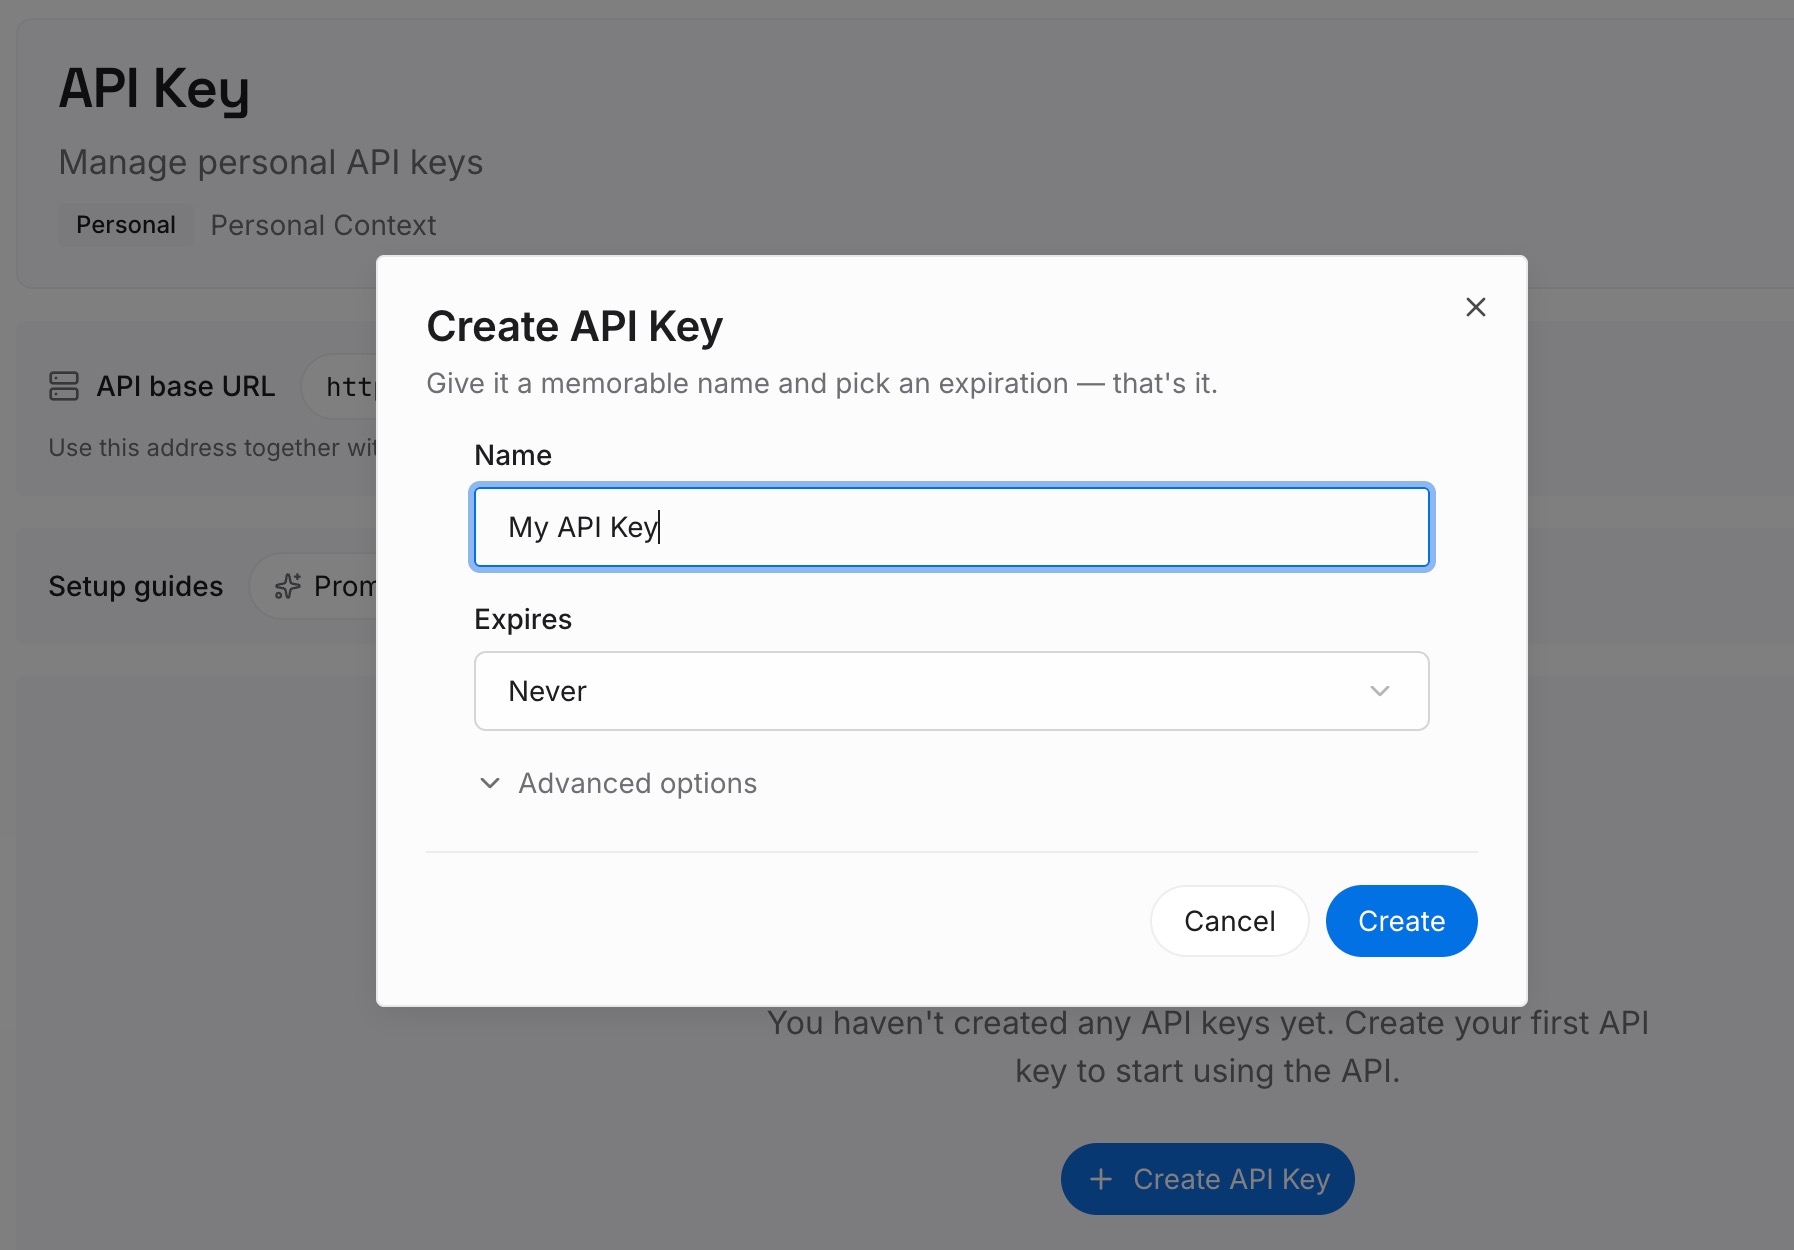
ステップ 1: APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーにより、アシスタントやエージェントが同じレイヤーにアクセスできるようになります。これにより、すべてのインターフェースが、各ツールの独自の履歴ではなく、1つの共通の立場セットを読み取るようになります。
ステップ 2: 最初の記憶をアップロードする
トランスクリプトではなく、立場から始めましょう。現在あなたの仕事で進行中の2つか3つの議論(アーキテクチャに関するもの、プロセスに関するもの、どのベンダーに標準化するかに関するものなど)を取り上げ、それぞれを日付付きの短い段落として、試したこととそのコストを含めて書き留めます。これは再構築に最も時間がかかるため、保存する価値が最も高いものです。
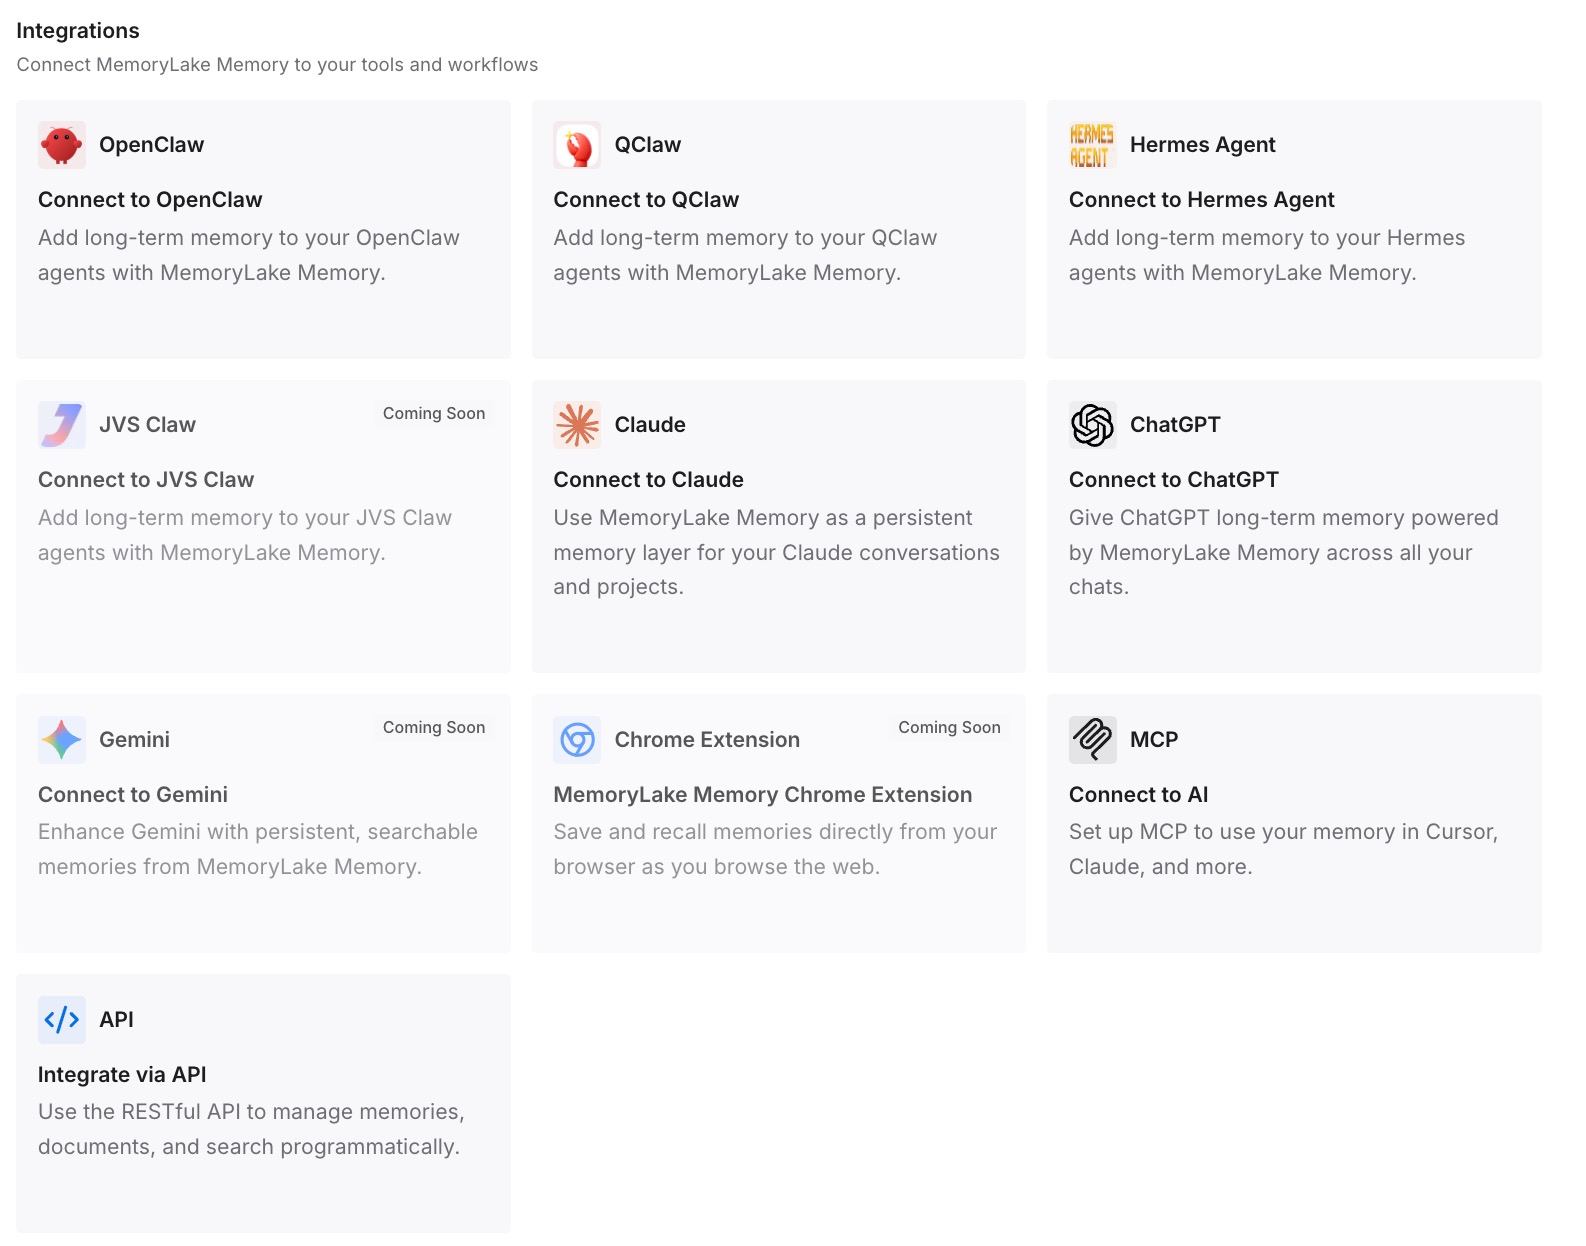
ステップ 3: AIとエージェントを接続する
アシスタントがセッションの開始時に立場を読み込めるように、このレイヤーに接続します(セッションにペーストする必要はありません)。その後、完全に新しい会話を開き、現在の立場が何であるかを尋ねて確認します。それを読み戻せることが、接続が機能している唯一の証明です。緑色のステータスを示すパネルが表示されていることとは異なります。
実務においてこれが変えること
実質的な違いは、何も起こっていない瞬間に現れます。
数ヶ月に及ぶ議論とは、数ヶ月間ずっと会話が続いているということではありません。それはおそらく、100日間の間に15回ほどの実質的なやり取りがあり、その間に数週間の沈黙があるということです。沈黙こそが、立場が腐敗する場所です。誰かが何かを試し、それが機能せず、次のことに移り、3週間後に同じ提案が戻ってきます。なぜなら、前回の試みのコストが永続的な場所に書き留められていなかったからです。
Anthropicの記事は、人ではなく機械について同じ指摘をしています。記録が1時間以上遅れたとき、「大量のジョブ結果がリスナーによって記録されず」、セレクターはそのまま決定を下し続けました。アラートは何も鳴りませんでした。ただ決定が悪化しただけです。
2つ目の違いは、アテンション(注意)の規模です。記事では、「エージェントは夜間や週末にもプッシュしますが、人間のエンジニアが依然としてかなりの量のPRを主導し承認するため、バースト的(一時的に集中する状態)なままです」と指摘されています。活動の最低ラインは上がりましたが、人間の時間は増えていません。より多くのインターフェースにわたってより多くの作業を監督する場合、再説明と熟考の比率が、それを実行できるかどうかを決定します。これはまさに、AIエージェントにどの程度の記憶を与えるべきかという問いです。
3つ目は監査可能性です。再設計が機能したのは、チームがようやく遅延を数値として視認できるようになったからです。あなたの立場も同様の扱いを受けるに値します。端から端まで読み通して、「これは最新、これは古い、これはあれと矛盾している」と言えるストレージです。そのような確認を行ったことがない場合は、AIが実際に何を記憶しているかを監査することから始めるのが良いでしょう。
数ヶ月に及ぶ決定を明瞭に保つためのベストプラクティス
次のセッションの開始時ではなく、そのセッションの終了時に立場を書き留める。 選択肢を却下した直後の10分間ほど、なぜそれを却下したのかについてのコンテキストが豊富な時間はありません。
散文(文章)で書く。 「シャード化 — 機能しなかった」という箇条書きは、8週間後には使い物になりません。「パッケージごとのシャード化により、各ワーカーが1つのセクションを所有できるようにした。遅延が再発するまで約1ヶ月間維持された」という文章であれば、1年後でも役に立ちます。
結果だけでなく、コストも保存する。 Anthropicの記事が印象的なのは、各パッチがどれくらい持続したかを述べているからです。「機能しなかった」は再試行を促します。「29日間持たせた」は議論を終わらせます。
何が考えを変えるかを明記する。 トリガーが明記された立場は、有用な形で自己無効化します。それがないと、新しい人が来るたびに同じ議論を蒸し返すことになります。
トランスクリプトを記録として保存しない。 トランスクリプトは証拠です。立場が記録です。これらを混同すると、ストレージが肥大化し、同時に役に立たなくなります。
定期的に立場を読み直す。 Anthropicの遅延は、測定されるまで目に見えませんでした。あなたの遅延も同様です。
結論
大々的な発見は、エージェントによるコーディングが半年でAnthropicのCIに25倍の負荷をかけたこと、そして単一ライターのサービスに3回パッチを当てることは、1回再構築するよりもエンジニアリング時間の無駄であったということです。その再構築は「1人のエンジニアが3週間で完了」しました。
より静かな発見は、その手法にあります。その再構築への議論は、パッチを選択し続ける人間に対して、議論の状況を思い出す必要のないアシスタントによって、数ヶ月にわたって行われました。それが勝利したのは、反対意見よりも長く一貫性を保ち続けたからです。
これは特定のツールの機能ではありません。結論を会話から分離し、日付を付け、次に開くものが何であれ読み取れるようにしておくという特性です。Anthropicは、たまたま終了しなかったセッションからそれを得ました。あなたはそれを意図的に手に入れることができます。