
結論から言うと
どちらのエージェントもチャットで構築されたメモリから開始され、どちらもチャットと同じアカウント内にタスクを保持します。
Anthropicは、Coworkのクラウドセッションにおける双方向の流れを次のように説明しています。「Claudeはチャットからすでに記憶している内容から開始し、Coworkタスクで発生した内容はチャットに引き継がれます。」
OpenAIは、WorkをChatGPT自体の一部として説明しています。「ChatGPTにはChatとWorkが含まれます。」Workは「アカウントとワークスペースで利用可能なメモリ設定を使用」し、ChatとWorkのチャットは同じ履歴内に配置されます。
違いは細部にあります。作業がローカルで実行される場合に何が起こるか、プロジェクトがどのようにメモリの範囲を制限するか、そしてスケジュールされたタスクや共有されたタスクが何を引き継ぐかです。
一目でわかる比較
| ChatGPT Work | Claude Cowork | |
|---|---|---|
| チャットメモリから開始するか | はい(アカウントおよびワークスペースのメモリ設定に従う) | はい(クラウドでのセッション時) |
| タスクがメモリに追加するもの | ChatGPTのメモリ設定に従う | チャットに引き継がれる |
| 履歴 | 「最近のチャット」でChatと共有 | Cowork内のタスクリスト(同じClaudeアカウント) |
| プロジェクト | Chatと共有。デフォルトまたはプロジェクト限定メモリを選択可能 | Claudeと共有。各プロジェクトが独自のメモリを持つ |
| ローカル作業 | デスクトップアプリ。許可したファイルを使用 | デスクトップアプリ。クラウドセッションのためにコンピュータにアクセス |
| スケジュールされたタスク | スケジュール、トリガー、または監視 | クラウド上で定期的に実行 |
それぞれのメモリ処理方法
ChatGPT Work
WorkはChatGPTのモードの一つであり、別の製品ではありません。OpenAIのメモリに関するドキュメントには、「ChatGPT Workはアカウントとワークスペースで利用可能なメモリ設定を使用します。ローカルのCodexメモリ保存場所やローカルのメモリコントロールは使用しません」と記載されています。保存されたメモリ、および設定に含まれている場合は過去のチャットへの参照は、Chatと同じように機能します。
メモリのFAQでは、これら2つの要素の関係について次のように説明されています。「保存されたメモリはチャット履歴とは別に保存されます。」設定で「チャット履歴の参照」をオンにすると、「ChatGPTが過去の会話から関連情報を利用して、将来の回答をパーソナライズできる」ようになります。
履歴も共有されます。「ChatとWorkのチャットは『最近のチャット』にまとめて表示され、並べ替え、フィルタリング、ピン留めが可能です。」Workはタスクのコンテキストを収集する際、「プロジェクト、メモリ、ChatGPT Library、およびインストール済みのプラグイン」を取り込むこともできます。
優れた点: 1つのアカウント、1つの履歴、ChatとWorkで共通のメモリ設定セット。管理すべき第2のメモリが存在しません。
Claude Cowork
CoworkはClaudeのメモリをチャットと共有します。Anthropicの発表では、「本日より、チャットで使用するメモリはClaude Coworkと同じになります」と明言されています。ヘルプセンターでは双方向性について次のように説明されています。「Claudeがチャットから記憶している内容は、クラウド上のCoworkでタスクを渡す際に利用可能であり、Coworkタスクで発生した内容はチャットに引き継がれます。」
Claudeのメモリは作業中に更新されます。Anthropicによると、「Claudeは会話が終わった後に要約するのではなく、チャット中にトピックをメモリに追加するようになりました。」そして、それは可視化されています。「Claudeが記憶しているすべての内容は、メモリ設定の『トピック』にあるファイルリストにあり、そこで各項目を閲覧、編集、または削除できます。」
最初のメッセージを送信する前にタスクのメニューでメモリをオフにすることで、メモリなしで単一のタスクを実行できます。Anthropicは、「メモリ設定はタスク開始時に設定され、後で変更することはできません」と注意を促しています。
優れた点: チャットとタスク間の明示的な双方向の流れ。メモリがトピックごとに整理されており、ファイル単位で閲覧・編集が可能です。
最も異なる点
コンピュータ上で作業が実行される場合
どちらのエージェントもデスクトップアプリを介してコンピュータにアクセスでき、どちらもタスクのコンテキストをクラウドに保存します。
Workについて、OpenAIは「作業がローカルで実行される場合でも、メッセージとタスクのコンテキストはクラウドに保存される場合があります」と述べています。デスクトップでは、Workはあなたが許可したファイルやアプリを使用できます。ChatGPT Workのクラウドとローカル間でコンテキストを維持するためのガイドで、この切り分けについて詳しく解説しています。
Coworkの場合、メモリのリンクはクラウドに紐付けられています。ヘルプセンターには、「Coworkとチャット間のメモリ共有は、Coworkがクラウドで実行されている場合にのみ機能します。コンピュータ上でローカルに実行されるCoworkセッションでは利用できません」とあります。現在、Coworkはクラウドでタスクを実行し、タスクがローカルファイルやブラウザを必要とする場合にデスクトップアプリを介してコンピュータにアクセスします。スタートガイドによると、ProおよびMaxプランのローカルセッションは、10月6日より前にコンピュータ上で開始されたタスクを指します。
プロジェクトによるメモリの範囲制限
どちらの製品にもプロジェクト機能があり、プロジェクトごとにメモリを分離しておくことができます。
ChatGPTのプロジェクトには2つの設定があります。「プロジェクトはデフォルトのメモリ、またはプロジェクト限定メモリのいずれかを使用できます。」プロジェクト限定メモリを使用すると、OpenAIによれば「そのプロジェクトからの情報は、プロジェクト外で使用されるメモリから削除されます。」共有プロジェクトは「自動的にプロジェクト限定メモリに設定され、デフォルトのメモリに切り替えることはできません。」ChatGPTプロジェクトのメモリモードに関するガイドで、各設定で何が可能になるかを説明しています。
Claudeのプロジェクト(「CoworkでもClaudeでも同様に機能する」)は、それぞれ独自のメモリを持ちます。「Claudeがあるプロジェクトで学んだことは、他のプロジェクトには引き継がれません。」プロジェクトのページでアカウントメモリ設定をオフにしない限り、プロジェクトはプロジェクト外のチャットとメモリを共有します。
アプローチは似たような結果になります。プロジェクトは、より広いメモリを活用することも、切り離しておくことも可能です。
スケジュールされたタスクが開始時に持つもの
どちらのエージェントも定期的な作業を実行できます。
OpenAIは、「Workは1回限りの実行、スケジュールやトリガーによる繰り返し、または『スケジュールされたタスク』を通じた変更の監視が可能です」と述べています。イベントトリガーには、対象プランにおいて新しいGmailメッセージ、Slackチャンネルメッセージ、GitHubのプルリクエストアクティビティなどが含まれます。
Anthropicは、Coworkの「スケジュールされたタスクはクラウドで実行され、デバイスのオンライン状態は不要です」と述べています。クラウドで実行されるため、これらはメモリがチャットと共有されるCoworkの側に位置します。Coworkのスケジュールされたタスクとメモリに関するガイドで、タスクごとにこれを制御する方法を解説しています。
共有によって引き継がれるもの
スケジュールされたWorkタスクを共有する場合、OpenAIは具体的です。共有によって「チャット履歴、ローカルファイル、フォルダ、デバイスへのアクセス権、連携アプリの認証情報、保存されたメモリ、カスタム指示、またはワークスペースの権限は転送されません。」受信者は、自身のアクセス権を使用して別のコピーをスケジュールします。
Claude側では、TeamおよびEnterpriseプランでのプロジェクト共有により、メンバーは選択した権限レベルでプロジェクトのナレッジや指示にアクセスできるようになります。
よくある誤解
タスクが何もない状態から始まると想定すること。 両製品とも、設定によりますが、チャットで構築したメモリからタスクを開始できます。
タスクが学習したすべてが保存されると想定すること。 Claudeでは、クラウドのCoworkタスクで発生した内容はチャットに引き継がれます。ChatGPTでは、保存はメモリ設定に従います。どちらの製品でもメモリは完全な記録ではありません。詳細はタスク自体のチャットに保持されます。
ローカルのCoworkセッションでメモリが共有されると期待すること。 Anthropicは、Coworkとチャット間のメモリ共有はクラウドで機能すると述べています。
プロジェクトメモリをアカウントメモリとして扱うこと。 両製品とも、メモリの範囲をプロジェクトに限定することができます。
ベンチマークだけで比較すること。 継続的な作業においては、どのモデルがタスクを実行するかと同じくらい、コンテキストがどこに存在しているかが重要です。
解決策:各エージェントが何を知っているかを確認し、意図的に範囲を定め、重要な要素を自分で管理できる場所に保管する
ステップ1:大きなタスクの前に、エージェントに何を知っているか尋ねる
どちらの製品でも、タスクの開始時に、エージェントが何を参照しているかリストアップするよう求めてください。あなたに関するメモリ、プロジェクトのファイルと指示、そして過去のチャットから関連性があると考えている内容などです。作業を開始する前に、誤りがあれば修正してください。Claudeでは、メモリ設定を開いてトピックファイルを直接編集することもできます。ChatGPTでは、「設定 > パーソナライズ」からメモリを管理できます。
ステップ2:どのタスクにメモリを使用するかを決定する
機密性の高い作業や単発の作業については、メモリなしでタスクを実行してください。Coworkでは、最初のメッセージを送る前にタスクのメニューでメモリをオフにします。ChatGPTでは、プロジェクト限定メモリを使用するプロジェクトを利用するか、メモリ設定を調整してください。継続的な作業については、コンテキストがまとまるようにタスクをプロジェクトに入れてください。
ステップ3:依存している決定事項を一箇所にまとめる
どちらのエージェントも、コンテキストを自社製品の中に保持します。両方を使用する場合や、一方から他方へ移行する場合、信頼している決定事項や慣習をそれぞれの側で再構築する必要があります。それらの短いリストを自分で管理できる場所に保管し、作業するエージェントへのブリーフィングに使用してください。
MemoryLakeでのセットアップ
ChatGPT WorkとClaude Coworkは、それぞれタスクをその会社のチャット製品で構築したメモリに接続し、それぞれの会社のメモリを参照します。
MemoryLakeは、信頼するコンテキストを自分で維持する1つのリストに保持し、ChatGPTや、Claude CodeやCodexなどの接続した他のアシスタントで利用できるようにするためのメモリレイヤーです。
エントリはあなた自身の言葉で書きます。ChatGPT、Claude、Cowork、プロジェクト、保存されたメモリ、またはベンダーのストレージから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。業務内容については、ツールの外部に保管するものに関する組織のポリシーに従ってください。
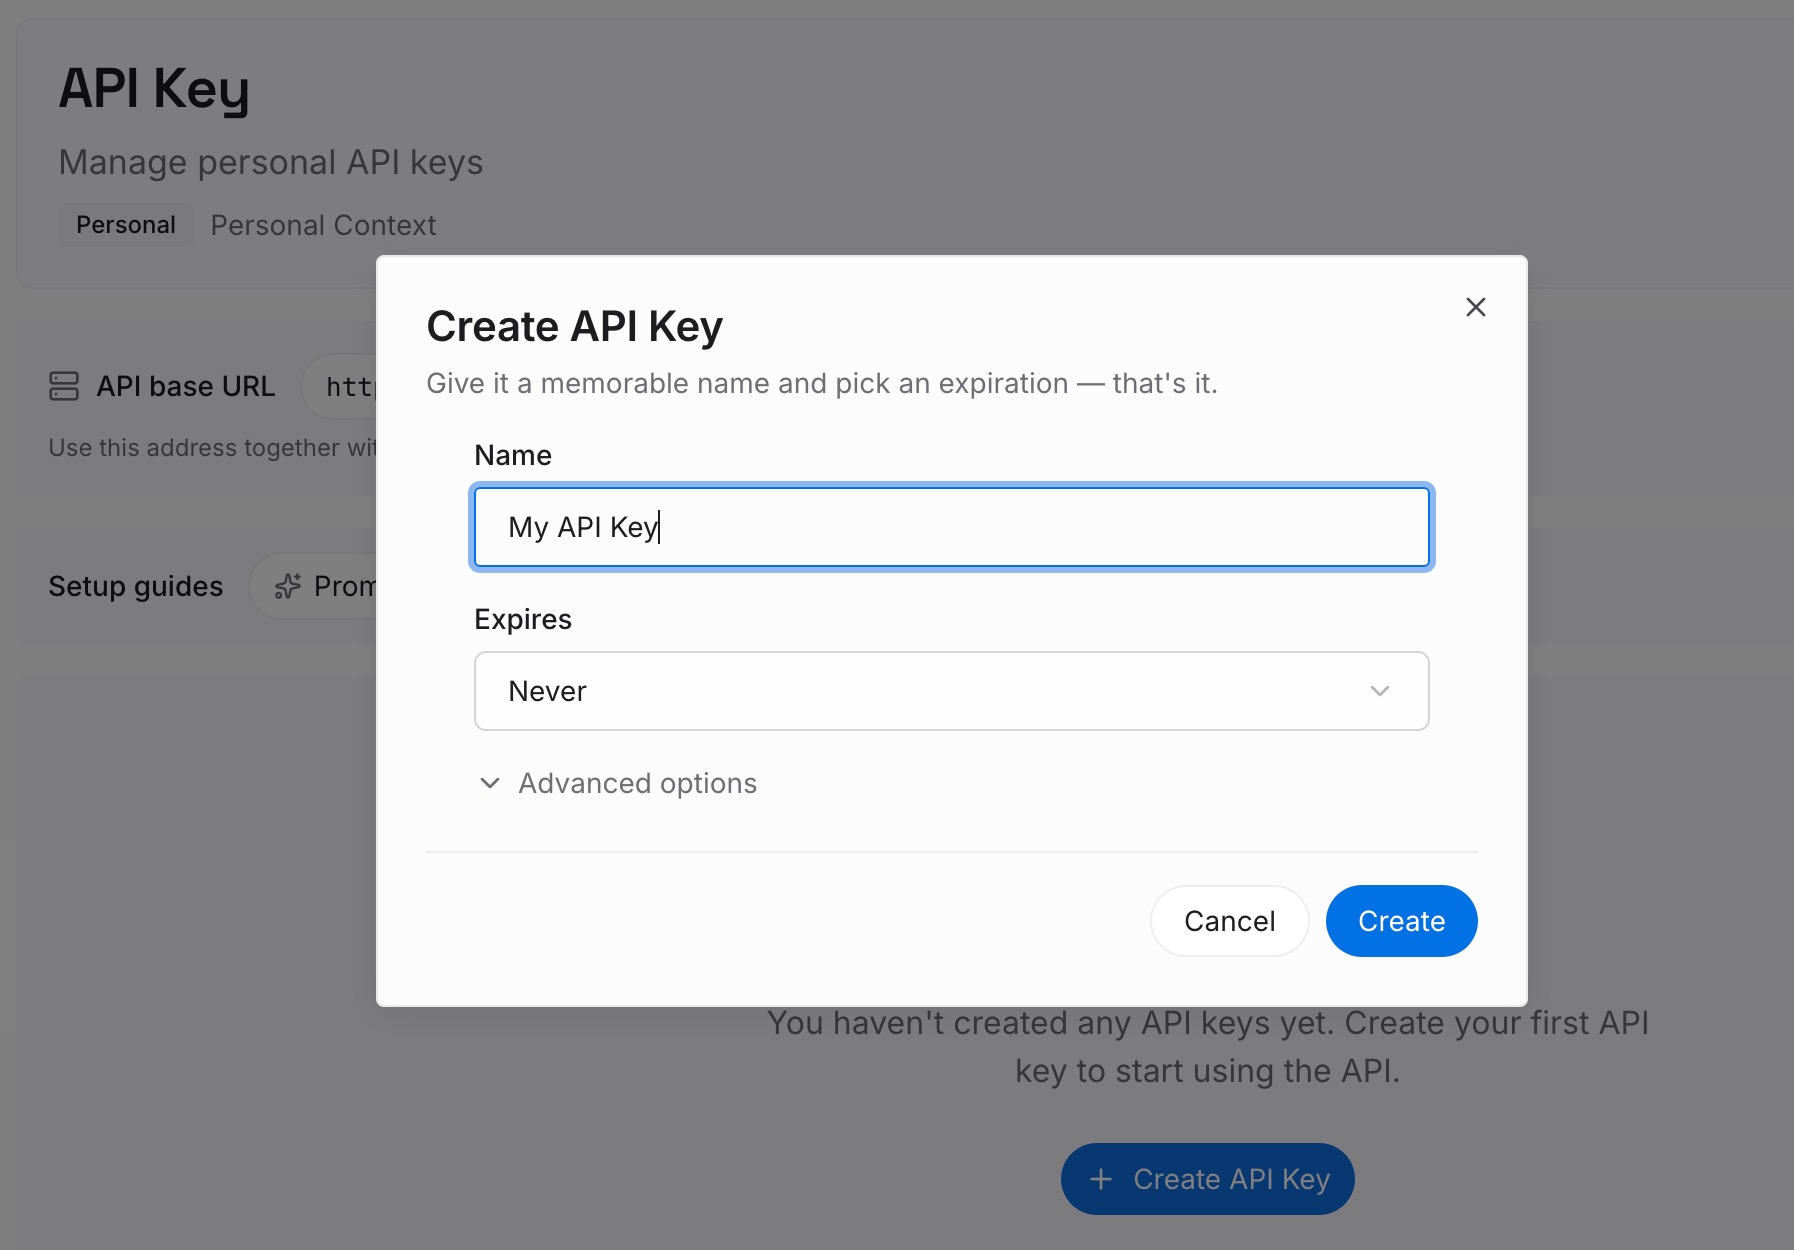
ステップ1:APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーはMemoryLakeワークスペースに属し、ChatGPTやClaudeのアカウントとは別個のものです。
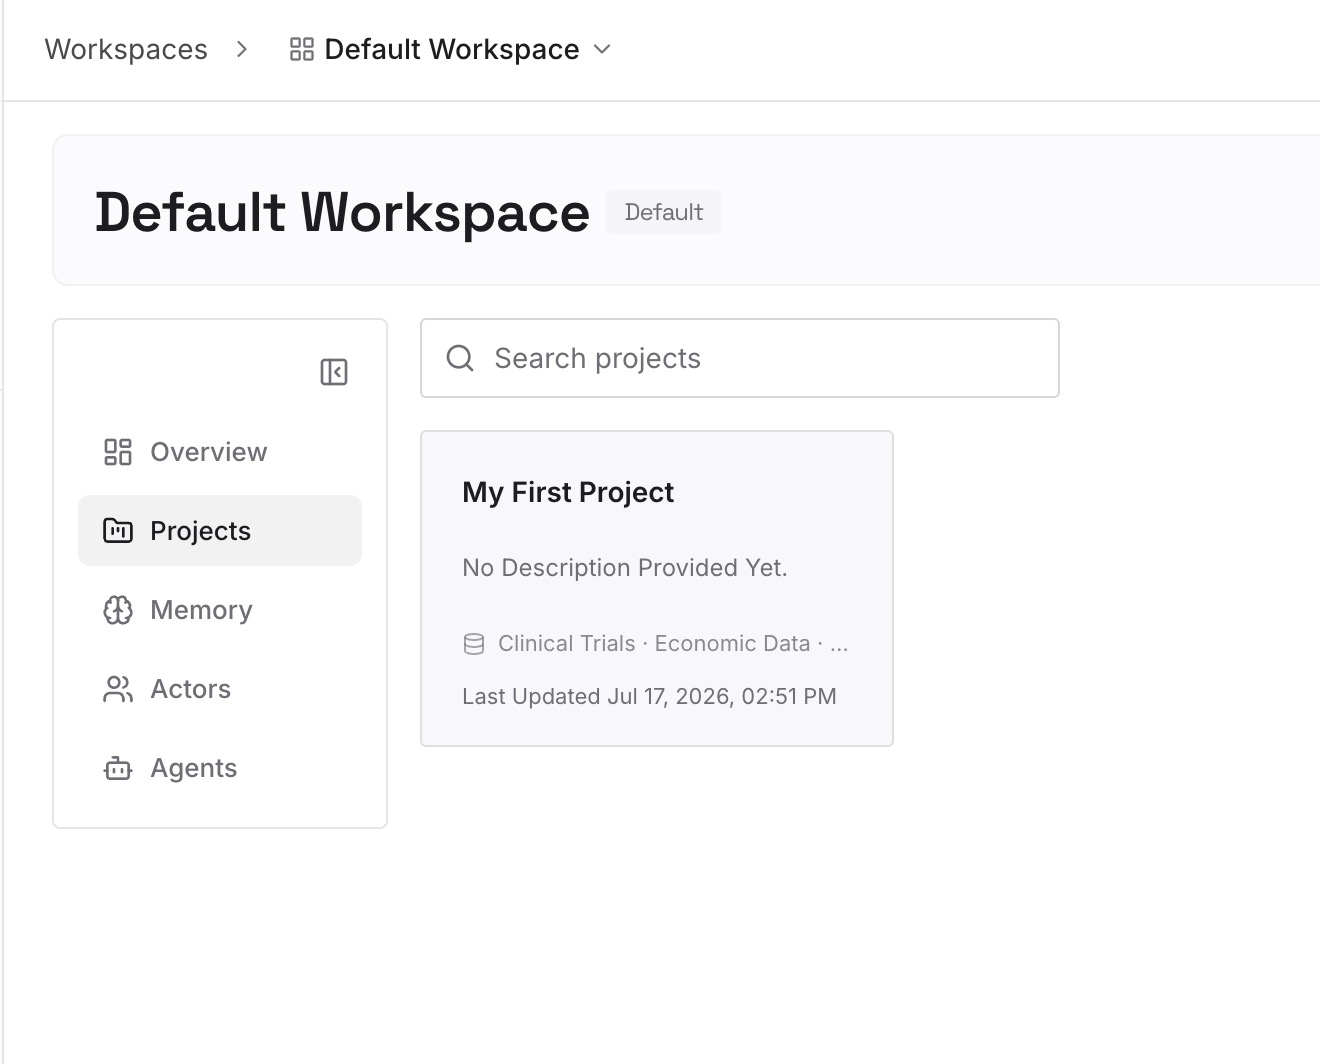
ステップ2:最初のメモリをアップロードする
解決策のステップ1で修正した内容、つまり各エージェントが開始時に知っておくべき事実や好みを入力することから始めましょう。1つのエントリにつき1つのポイントを記述し、日付を入れ、所属するプロジェクトのラベルを付けます。
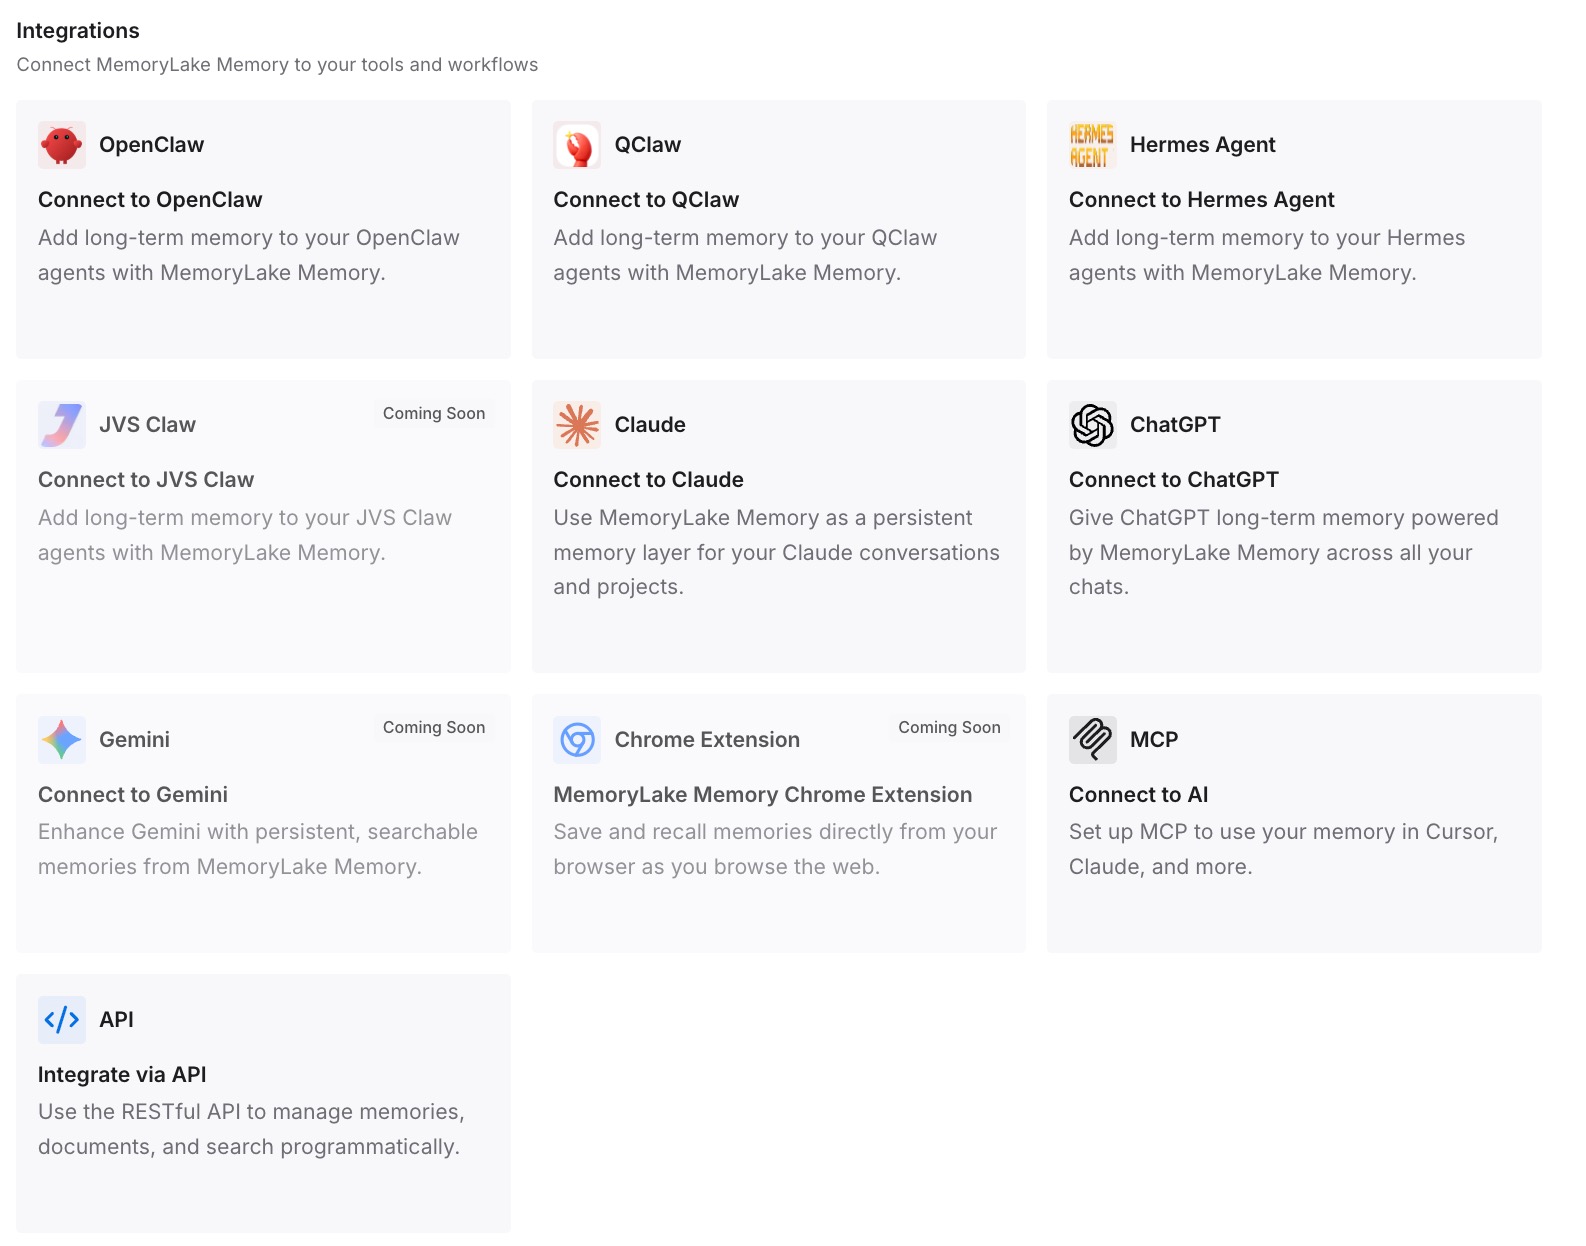
ステップ3:AIとエージェントを接続する
ChatGPTや、使用している他のアシスタントを接続します。次のタスクがどこで実行されても、コアとなるコンテキストは同じです。
実務で何が変わるか
第一の違いは、適切な問いを持って選択できるようになることです。どちらのエージェントも多段階の作業をうまくこなしますが、異なるのは、それぞれがタスクをチャットにどのように接続するかです。
第二に、タスクがあなたの意図した通りに開始されるようになります。作業が始まる前に、メモリを確認、修正し、範囲を定めることができます。
第三に、依存しているコンテキストがすでに製品の外に書き留められているため、切り替えのコストが低くなります。Coworkのブラウザについては、Coworkの内蔵ブラウザが保持するログイン情報に関するガイドで、別の種類の保存された状態について解説しています。
ChatGPT WorkとClaude Coworkにおけるメモリのベストプラクティス
作業が継続する場合はプロジェクトからタスクを開始する。 両製品ともプロジェクトのコンテキストをまとめて保持します。
長いタスクの前に、エージェントが何を知っているか尋ねる。 それに基づいて構築される前に修正してください。
単発の機密タスクではメモリをオフにする。 両製品ともメモリなしでの実行をサポートしています。
チャットとメモリを共有したい場合は、Coworkをクラウドで実行する。 Anthropicは、ローカルセッションでは共有されないと述べています。
共有するWorkタスクを送信前に確認する。 指示はリンクと共に送られますが、あなたのメモリは送られません。
重要な要素はどちらの製品の外にも保管しておく。 そうすれば、エージェントの選択は常に「選択」であり続けます。
まとめ
ChatGPT WorkとClaude Coworkは、どちらもタスクをチャットで構築したメモリに接続します。OpenAIはWorkをChatGPTのモードとし、アカウントのメモリ設定を使用し、Chatと履歴を共有します。AnthropicはCoworkのクラウドセッションを、チャットと双方向で1つのメモリを共有するものとして説明しており、メモリは編集可能なトピックファイルに整理されます。どちらもプロジェクトでメモリの範囲を制限でき、スケジュールされたタスクを実行でき、タスクのコンテキストをクラウドに保持します。
チャットがすでに存在している場所に合わせて選択し、大きなタスクの前に何を知っているかを確認し、依存している決定事項を自分で管理するリストに保持しましょう。