
なぜAnthropicは1つのエージェントに2つのメモリストアを与えたのか
このガイドは、よくある問題から始まります。Anthropicは、自動化プログラムが「誰も気づかないうちにソースへのアクセスを失ったり、ユーザーの設定に従わなくなったりすることがある」と書いています。この文章のどちらの半分も、形を変えたメモリの問題です。
メモリが必要なのは、「各実行が、前回の実行のメモリを持たない新しいサンドボックスで開始される」ためです。ガイドはその結果について率直に述べています。「メモリがなければ、フィードバックは定着しない」。しかし、逆のリスクについても同様に率直です。「古いメモリはエージェントを混乱させる可能性がある」。その例として、古いメモを持つエージェントは、問題が解決された後もその項目がまだ保留中であると報告したり、すでに報告したと思い込んで未解決の項目を落としたりします。
リファレンス実装では、/mnt/memory/ の下にマウントされた2つのストアでこれに対応しています。
1つ目は preferences(ユーザー設定) で、「ユーザーのものであり、エージェントにとっては読み取り専用」と説明されています。これには「どのチャンネルやリポジトリを読み取るか、何を除外するか、長さの制限、送信先、そしていつ停止するか」が保持されます。
2つ目は state(状態) で、「エージェントのものであり、読み書き可能」と説明されています。これには「ブックマーク、報告内容の台帳、実行ごとの記録、ユーザー設定に対して提案する変更、および各ソースの挙動に関するメモ」が保持されます。
これら2つのリストを並べて読めば、その論理は明らかです。最初のストアにあるものはすべて、ユーザーが下した決定です。2番目のストアにあるものはすべて、エージェントが観察したこと、または行ったことです。エージェントはユーザー設定への変更を提案することは許可されていますが、その提案はエージェント自身のストアに入ります。ユーザーのルールは、ユーザー自身が変更したときにのみ変更されます。
なぜ読み取り専用の境界線が重要なのか
Anthropicのメモリに関するドキュメントは、この分割が防ごうとしているリスクを説明しています。「メモリストアはデフォルトで read_write アクセスでアタッチされます」。そして、他人のテキストを読み取るエージェントにとって、そのデフォルトが何を意味するのかを詳しく説明しています。「エージェントが信頼できない入力(ユーザーが提供したプロンプト、取得したWebコンテンツ、またはサードパーティツールの出力)を処理する場合、プロンプトインジェクションが成功すると、ストアに悪意のあるコンテンツが書き込まれる可能性があります。その後のセッションでは、そのコンテンツが信頼できるメモリとして読み取られてしまいます」
推奨事項は次のとおりです。「参照資料、共有ルックアップ、およびエージェントが変更する必要のないストアには read_only を使用してください」。そして、これはモデルに遵守を求めるだけの単なる約束事ではありません。「access はファイルシステムレベルで強制されます。read_only マウントは書き込みを拒否します」
自動化ガイドはこれを正確に適用しています。このエージェントは他人が書いたSlackメッセージやGitHubのイシューを読み取りますが、ガイドは「そのテキストが指示として解釈される可能性がある」と認めています。そのため、「GitHubトークンと設定ストアは読み取り専用であり、環境は許可リストにあるホストにのみアクセスします」。ガイドは、これが何を保護し、何を保護しないかについて正直に述べています。「仕込まれた指示によって、エージェントが実行間に保持するメモなどを通じて、要約の内容が変更される可能性は依然としてあります。しかし、GitHubに書き込んだり、ユーザーのルールを編集したりすることはできません」
この最後の文こそが、議論のすべてを縮図にしたものです。エージェント自身のメモは読み取る対象にさらされているため、間違っている可能性があります。ユーザーのルールはエージェントが書き込めないストアにあるため、ユーザーのルールのまま維持されます。
なぜ設定のコピーはポインタよりも劣るのか
ガイドは、2つ目の、より目立たない失敗を挙げています。「よくある問題は、設定のコピーがプロンプトに埋め込まれてしまい、すでに変更したルールが適用され続けてしまうことです」。解決策は、毎回ソースを読み取ることです。「エージェントに、毎回の実行でファイルを新しく読み取らせます。ファイルを読み取れない場合は、デフォルトで実行するのではなく、停止してその旨を伝える必要があります」
これはManaged Agentsに限らず、メモリ全般に関する教訓です。システムプロンプト、貼り付けられたブリーフィング、キャッシュされた要約など、設定のコピーは作成された瞬間から古くなり始めます。ガイドの答えは、毎回の実行の開始時に読み取られる、1つの信頼できる場所を用意することです。
代わりに試されがちなアプローチ
1つのメモリストアの方がシンプルだと仮定する。 セットアップは確かにシンプルです。しかし、エージェントが従うべきルールを書き換えることを許してしまい、読み取った内容がそれらのルールに紛れ込む原因にもなります。Anthropicのドキュメントでは、「メモリの異なる部分で所有者やアクセスルールが異なる場合」は、複数のストアをアタッチすることを推奨しています。
設定をシステムプロンプトに埋め込む。 手軽ですが、ガイドが指摘するように、これはよくある問題を引き起こします。プロンプトは、すでに変更したルールを適用し続けてしまいます。
エージェント自身にルールを管理させる。 エージェントはパターンの検出が得意であり、リファレンス実装でもそれが活用されています。しかし、提案された変更をエージェントに直接適用させるのではなく、ユーザーがレビューできるようにエージェント自身のストアにルーティングします。
「新規なし」という報告を信用する。 ガイドは、これがなぜ危険であるかを示しています。「MCPサーバーがダウンしているか、そのトークンが期限切れであっても、実行は開始されます。単にそのサーバーのツールが使えないだけです」。そして、「セッションはエラーをログに記録しますが、エージェントはそのソースから何も検知しません」。明示的なルールがなければ、壊れたソースは単に「更新がない静かな日」とまったく同じに見えてしまいます。
固定された時間枠を読み取る。 ガイドは、エージェントに「過去1日」などの固定された時間枠を読み取らせることに警告を発しています。「実行が遅れると隙間が生じ、実行が早いと項目が重複します」。その解決策は、「代わりに、ソースごとにエージェントにブックマークを与えてください」ということです。
解決策:メモリの各部分を誰が書き込むかを決定し、それを強制する
ステップ 1: エージェントが記憶すべきすべての事項を、誰が書き込むかによって分類する
エージェントが実行間で保持する必要があるものをリストアップし、それぞれの項目を2つの列のいずれかに分類します。
最初の列は「決定事項」です。どのソースを読み取るか、何が重要とされるか、何を除外するか、結果をどこに送るか、長さの制限、およびいつ停止するか。これらはユーザーのものです。これらはユーザーが考えを変えたときに変更されるものであり、エージェントが何かを観察したときに変更されるものではありません。
2番目の列は「観察と進捗」です。エージェントが各ソースでどこまで読み進めたか、すでに何を報告したか、各実行で何が起こったか、および各ソースについて学習した特異な挙動などです。これらはエージェントに属し、エージェントは実行ごとにこれらを更新する必要があります。
どちらにもすっきりと当てはまらないものは、通常、エージェントが影響を与えたいと考えている決定事項です。エージェント自身の列に提案を行う場所を用意し、ユーザーのスケジュールに合わせてそれらの提案をレビューします。これは、リファレンス実装が「ユーザー設定に対して提案する変更」をstate(状態)ストアに保存する方法を反映しています。
ステップ 2: ユーザーの列をエージェントが読み取りのみ可能なストアに配置し、実行ごとに読み取らせる
ユーザー設定用のメモリストアを作成し、read_only アクセスでアタッチします。設定ファイルはユーザー自身が書き込みます。リファレンス実装では、エージェントをデプロイすると「設定ストアは作成されますが、その中のファイルは作成されません」。そして、最初の実行前にシードスクリプトがファイルを書き込みます。
次に、ガイドが推奨する指示を追加します。各実行の開始時に設定を新しく読み取り、ファイルが読み取れない場合は明確なメッセージを表示して停止します。設定をシステムプロンプトにも貼り付けないでください。2つのコピーが存在すると、内容が乖離してしまいます。
チームの規約や用語集など、複数のエージェントが同じ参照資料を共有する場合も、同じ原則が適用できます。ドキュメントでは、「多くのセッションにアタッチされた1つの読み取り専用ストア(標準、規約、ドメイン知識)を、各セッション独自の読み書き可能なストアとは別に管理する」と説明されています。
ステップ 3: エージェント自身のストアに台帳、ブックマーク、および正直なエラー処理ルールを設ける
読み書き可能なストアにおいて、エージェントに3つの構造を与えます。
ソースごとのブックマーク。各実行の最後に書き込まれ、次の実行が前回の停止位置から正確に読み取れるようにします。
台帳。「エージェントは、報告したすべての項目について台帳 ledger.md を保持し、要約が重複しないようにします」。各行には固定のIDと項目の最後に確認されたステータスが記録され、これによりエージェントは重複ではなく変更を報告できるようになります。
エラー処理ルール。ソースが読み取れない場合、ガイドのエージェントは「そのソースのブックマークをそのまま維持し、他のソースから要約を作成し、読み取れなかったソースの名前を1行添えて要約を終了」します。その要約ルールは、一言一句そのままコピーする価値があります。「読み取りの失敗は、静かな日としてではなく、読み取り不能として報告すること」
読み書き可能なストアへのすべての書き込みはバージョンを生成するため、エージェントがいつ何を記録したかをレビューできます。「メモリへのすべての変更は、不変のメモリバージョンを作成します」。要約が間違っているように見える場合は、その履歴を使用して、エージェントがどのメモに依存していたかを確認できます。このような追跡がなぜ重要であるかについては、memory provenance explainedを参照してください。
MemoryLakeでのセットアップ
Anthropicのガイドにおけるこの分割は、特定のプラットフォーム以外でも自然に対応する考え方があります。ユーザーの決定や設定は、ユーザー自身が書き込み、すべてのエージェントに尊重させたい部分です。エージェントは、実行される場所に関わらず、独自の作業メモを保持します。MemoryLakeは、この最初の部分(ユーザーが書き込むレイヤー)を保持する場所であり、使用するエージェントやアシスタント全体で一貫性を保つことができます。
エントリーは、ユーザー自身が自分の言葉で書き込みます。Anthropicのメモリストア、エージェントの作業メモ、またはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。Anthropicのメモリストアはそのままの場所に残り、Anthropic独自のAPIを通じて管理されます。
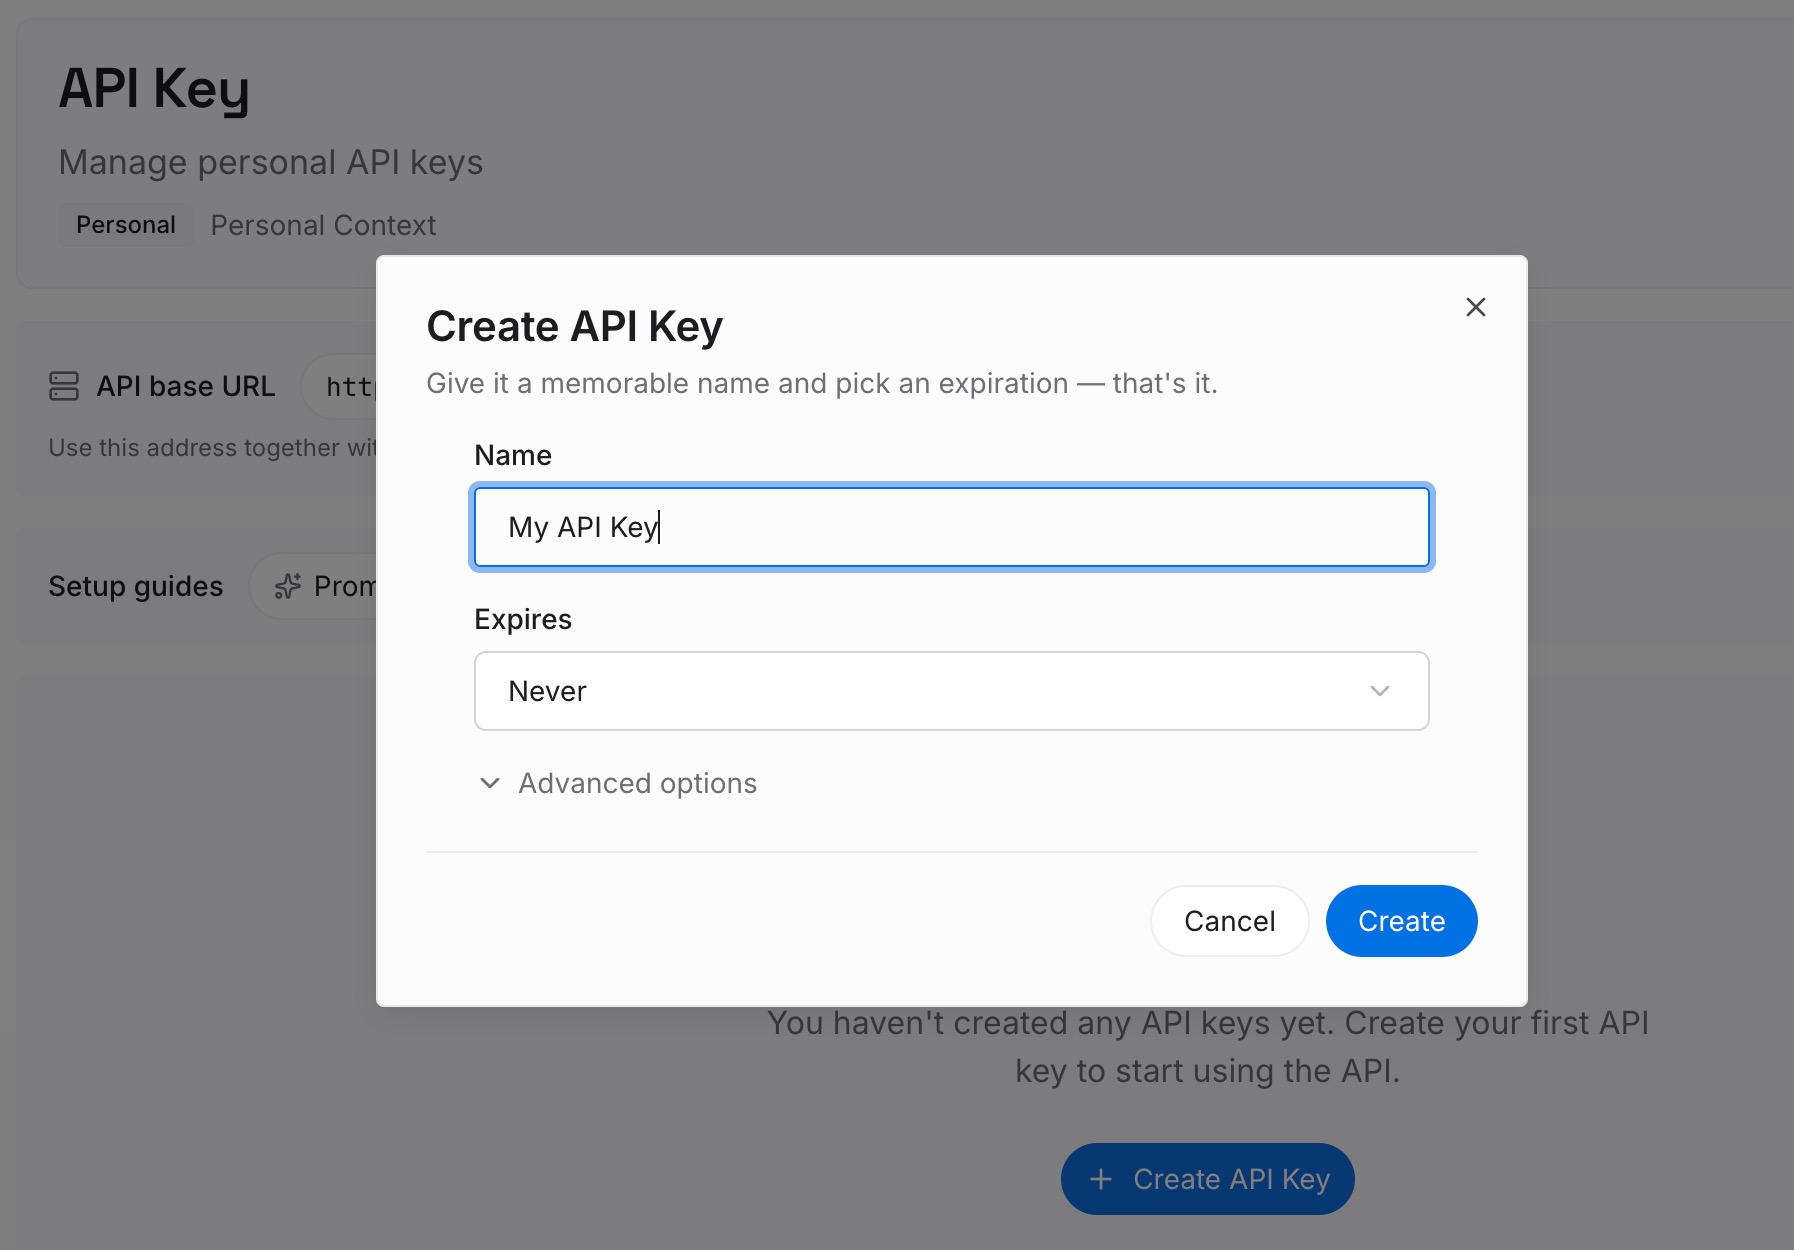
ステップ 1: APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーは、Claude Consoleの組織とは別に、ユーザーの MemoryLake ワークスペースに属します。
ステップ 2: 最初のメモリをアップロードする
ステップ1の「決定事項」の列から始めます。自分にとって何が重要か、何を除外するか、および結果をどのように配信してほしいか。1つのエントリーにつき1つの設定を、変更がわかるように日付付きで登録します。
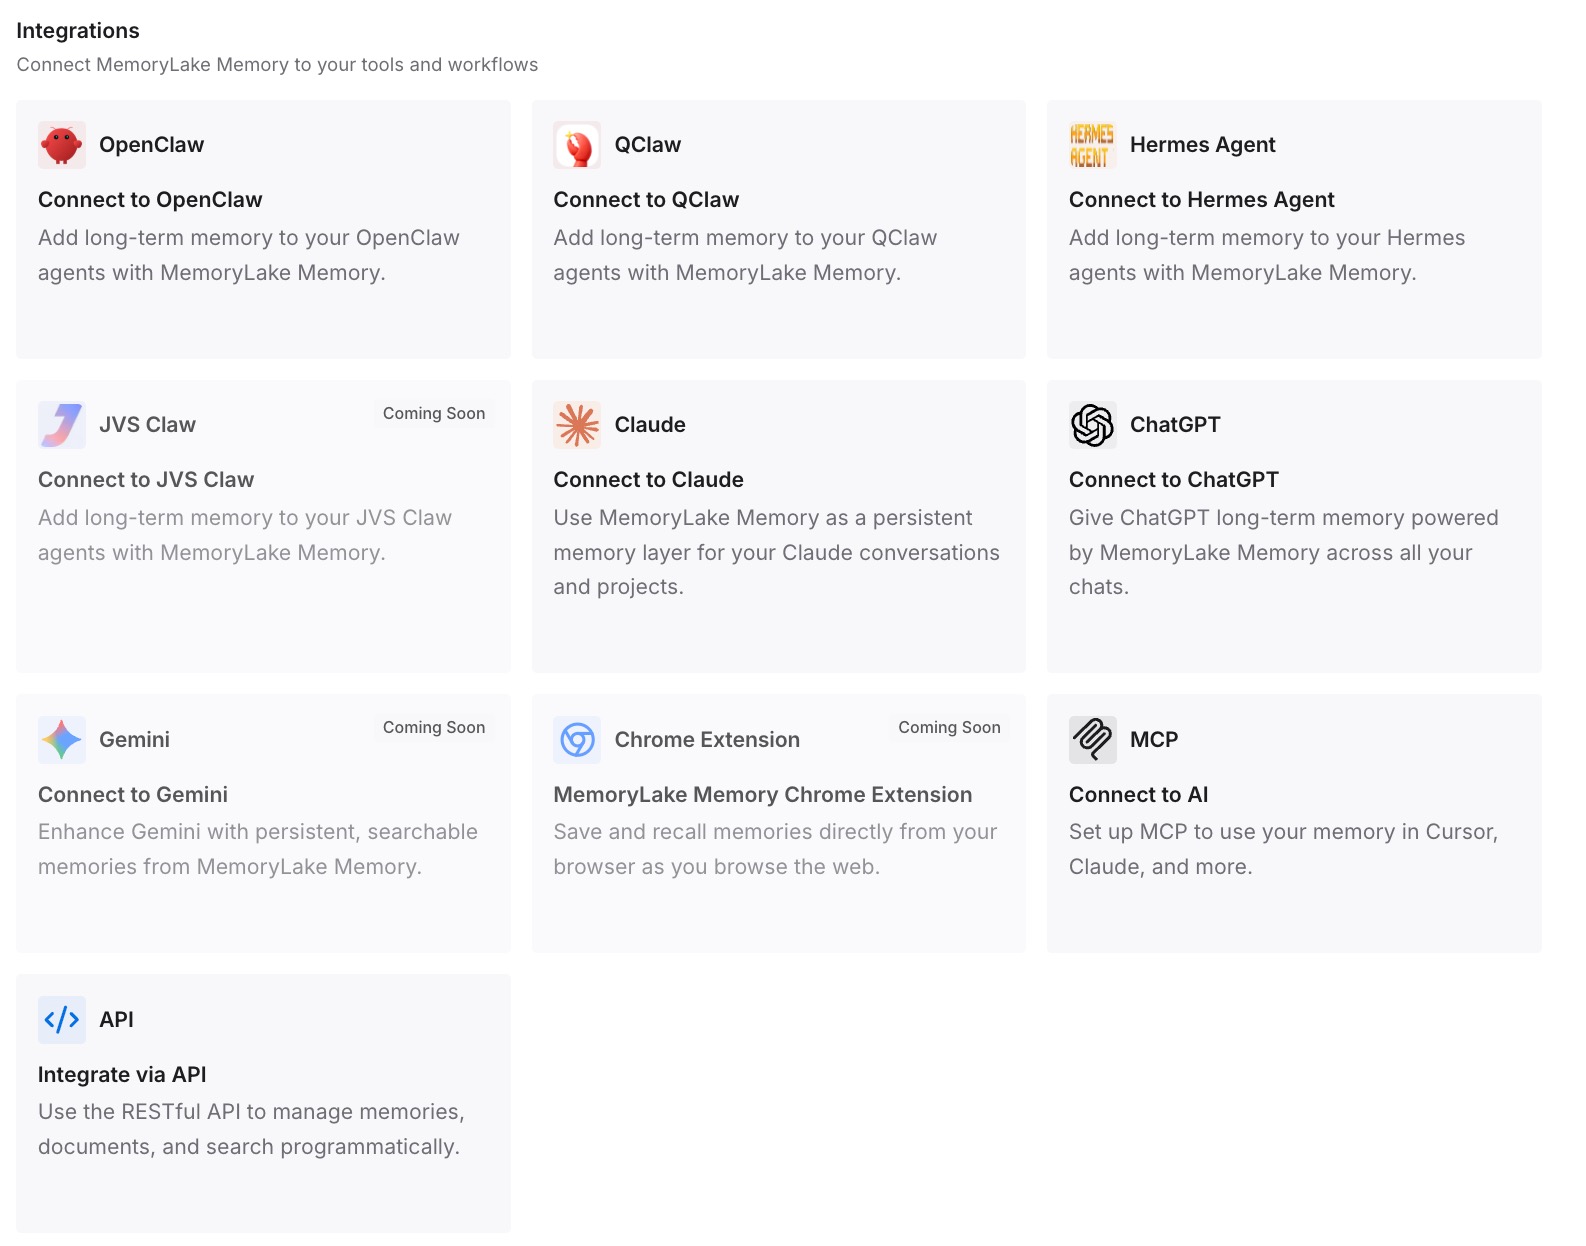
ステップ 3: AIとエージェントを接続する
使用しているアシスタントやエージェントを接続します。これにより、各エージェントのプロンプトにコピーを埋め込むのではなく、1つの書かれたソースとして設定を利用できるようになります。
実務において何が変わるのか
最初の違いは、ルールが乖離しなくなることです。エージェントが編集できないストアから設定が新しく読み取られるため、ユーザーが行った変更は次の実行時に適用され、エージェントがそれを勝手に再解釈することはできません。
2つ目は、影響範囲(ブラスト半径)が小さくなることです。Anthropicが率直に述べているように、エージェントが読み取るテキストは、エージェント自身がメモに書き込む内容に依然として影響を与える可能性があります。しかし、自身を制御するルールを書き換えることはできません。
3つ目は、正直な出力が得られることです。台帳とブックマークにより、エージェントは重複ではなく変更を報告するようになり、エラー処理ルールにより、壊れたソースは壊れたものとして表示されます。同じ問題はコンシューマー向けのツールでも発生します。stopping ChatGPT's scheduled tasks from starting over every runでは、多くの人が最初に直面するこの問題の解決策を扱っています。
4つ目は、レビュー可能な学習です。提案された設定変更は、ユーザーが承認するまでエージェントのストアに留まります。これは、エージェントが自己更新するよりもクリーンなループであり、このテーマはself-improving agents without retrainingで詳しく探求されています。
定期実行エージェントにおけるメモリのベストプラクティス
決定事項と観察事項を分離する。 決定事項はユーザーが書き込むストアに、観察事項はエージェントのストアに配置します。
設定ストアを読み取り専用にする。 Anthropicはこれをファイルシステムレベルで強制しているため、これを活用してください。
実行ごとに設定を新しく読み取る。 プロンプトに2つ目のコピーを保持しないようにしてください。
設定が読み取れない場合は停止する。 デフォルト設定で実行を続けることは、明確なエラーメッセージを表示して停止することよりも悪影響を及ぼします。
時間枠ではなくブックマークを使用する。 各実行は、前回の実行が停止した正確な位置から開始されます。
読み取れないソースは明示的に報告する。 「更新がない静かな日」と「トークンの破損」は、明確に区別して表示される必要があります。
エージェントが書き込む内容をレビューする。 メモリのバージョン履歴は、何が変更されたかを示します。Coworkにおける関連するパターンについては、controlling whether a Cowork scheduled task uses your memoryを参照してください。また、Anthropicのバックグラウンド統合については、how Claude's Dreams rebuild an agent's memory storeを参照してください。メモリがどこに存在し、誰がアクセスできるかというより広い問題については、the security problem nobody discussesで扱っています。
結論
定期実行エージェントに関するAnthropicのリファレンス実装は、1つのエージェントに2つのメモリストアを与えています。1つはユーザーの設定を保持し、エージェントにとっては読み取り専用です。もう1つは、エージェントのブックマーク、台帳、実行記録、提案された変更、およびメモを保持し、読み書き可能です。その理由はAnthropic自身の言葉にあります。古いメモリはエージェントを混乱させ、設定のコピーは古いルールを適用し続け、信頼できない入力にさらされた読み書き可能なストアは、仕込まれた指示をその後の実行に持ち越してしまう可能性があります。
この設計を再現するのは簡単です。メモリの各部分を誰が書き込むかを決定し、アクセスモードでそれを強制し、実行ごとにルールを新しく読み取り、エージェントが何かを確認できなかったときにはそれを報告させるようにします。
ガイドは、このアプローチ全体に適用できるアドバイスで締めくくられています。「これをスタートラインとして捉え、ソース、送信先、またはメモリ設定に合わせてエージェントをカスタマイズしてください」