
11月2日に何が変わったのか
スレッドが登場する前は、すべてのMessages APIリクエストに会話全体を含める必要がありました。発表ではそのコストについて次のように説明されています。「コーディングエージェントは1つのセッションで数百回のリクエストを行うことがあり、各リクエストで過去のすべてのメッセージとツールの実行結果を再送信しています。」
スレッドを使用する場合、Messages APIリクエストに thread というパラメータを1つ追加します。ドキュメントでは、以下の3つのステップのパターンが示されています。
- 作成 (Create): 最初のリクエストで会話全文、
system、toolsを送り、さらにタイプをcreateとしたthreadフィールドを含めます。「APIは会話(Claudeの返答を含む)をレスポンスのidの下に保存します。」 - 継続 (Continue): 「直前のレスポンス以降のメッセージのみを送信」します。また、前のレスポンスの
idを渡し、systemとtoolsは省略します。スレッドが作成時の値を保持しているためです。 - リプレイ (Replay): スレッドを継続できなくなった場合、新しい作成リクエストで会話全文を再度送信します。
スレッドは、ネイティブのClaude Platform、AWS上のClaude Platform、Microsoft FoundryのClaude、およびGoogle Cloud上のClaude Models(Anthropic管理)で利用可能です。Anthropicは「標準のClaudeトークン料金と既存のレート制限が適用される」としています。
サーバーが何を、どのくらいの期間保持するか
ドキュメント自体の要約には、「メッセージスレッドは会話を短期間だけサーバー上に保持する」とあります。
最後のリクエストから5分間。 「スレッドはベストエフォートです。最後のリクエストから5分で期限切れとなり、最後の使用から1時間以内にAPIによって削除されます。APIがレスポンスを保存するたびに、この5分間はリセットされます。」
ディスクではなくメモリ上。 発表によれば、「ターンの間、各スレッドはメモリ内に保持され、暗号化されており、ディスクには書き込まれません。」データ保持のセクションでは、APIは「永続ストレージには一切書き込まない」と付け加えられています。
中身を確認する方法はない。 制限事項のリストは単刀直入です。「スレッドをリスト表示、読み取り、または削除するためのAPIは存在しません。」
呼び出し元に紐付けられる。 継続リクエストが失敗する理由として、ドキュメントには「異なる組織やワークスペース」からのリクエストや、「スレッドを作成したユーザーまたはサービスアカウントとは異なるユーザー」からのリクエストが挙げられています。
つまり、サーバーは1つの会話を、1人の呼び出し元のために、数分間の無操作時間の間だけ、拡張のみ可能な形式で保持します。これは高速なエージェントループには有用ですが、明日また戻ってこられるような記録ではありません。
なぜスレッドは「記憶」ではないのか
Anthropicはこの問いに対し、ページ内で最も重要な指示としてこう答えています。「あなたのアプリケーションが会話の信頼できる唯一の情報源(Source of Truth)であり続けます。すべてのメッセージのコピーを自身で保持し、最初からリプレイ(再送)できる経路を構築してください。」
また、なぜコピーを省略できないのかについても説明されています。「作成または継続リクエストに対するレスポンスには、APIがそのターンを保存したかどうかは示されません。それは次の継続リクエストの時に判明します。」スレッドは、制御できない理由で消失する可能性があります。ドキュメントには、「スレッドの期限切れ」、APIが保存せずにターンを処理した場合、フォールバックモデルが前のレスポンスを書いた場合など、いくつかの理由が挙げられています。
これを、Anthropicが情報を保持するために推奨しているツールと比較してみてください。同社のMemoryツールは、「アプリケーションでMemoryツールのファイル操作を実装することで、Claudeが会話をまたいで情報を保存・取得できるようにする」ものとして文書化されています。そのデータ保持に関する注記では、これを「データ保持を制御できるクライアントサイドのメモリストレージ」と呼んでいます。永続化されるものは、ユーザー側が運用するストレージに存在します。
また、名称が誤解を招く可能性もあります。ドキュメントには次のような注記があります。「メッセージスレッドは、Claude Managed Agentsのセッションスレッドとは異なります。」セッションスレッドはManaged Agentsのセッションに属し、Anthropicはこれを「ステートフルなリソースであり、削除するまでトランスクリプトが保持される」と説明しています。同じ言葉ですが、寿命が異なります。
長いコンテキストウィンドウがなぜ記憶ではないのかに関するガイドでは、モデルが1回のリクエストで保持できるものと、リクエスト間で保持されるものの広範な違いについて解説しています。
なぜコンパクションに新しいスレッドが必要なのか
長時間のエージェントセッションでは、最終的にコンパクション(圧縮)が必要になります。これは、会話を収めるために古いターンを要約に置き換える作業です。スレッドを使用すると、この方法が変わります。
「スレッドは追記専用(Append-only)であるため、以前のターンを要約に置き換えることはできません。会話を圧縮するには、要約から新しいスレッドを開始してください。コード内で要約を作成し、それを新しい作成リクエストで通常のメッセージとして、system および tools と共に送信します。」
サーバーサイドのオプションも利用できません。「スレッドではオンデマンドのコンパクションは利用できません。」thread を含みつつコンパクションを要求するリクエストは、400エラーを返します。コンテキスト編集も同様の状況です。思考ブロックの設定に関する1つの例外を除き、スレッドはこれをサポートしていません。
実務上、スレッドを使用した長いセッションはチェーン(鎖)のようになります。1つのスレッドは会話の圧縮が必要になるまで実行され、コードが要約を書き、その要約から新しいスレッドが始まります。そのたびに、古いスレッドは数分以内に期限切れとなります。引き継がれるのは、要約に入れた内容と、自身で保持しているメッセージのコピーだけです。
編集についても同じルールが適用されます。「以前のメッセージを編集したりブランチ(分岐)させたりするには、作成リクエストで新しいスレッドを開始してください。」system や tools を変更する場合も、継続リクエストではそれらが除外されるため、新しいスレッドになります。
コンパクションされたClaude Codeセッションのテレポートに関するガイドでは、会話が圧縮された後に要約が何を引き継ぎ、何を引き継がないかを示しています。
スレッドが他にできないこと
ドキュメントには、スレッドと併用できない機能がリストアップされています。エージェント開発者にとって重要なものは以下の通りです。
- プロンプトキャッシュは自動ではない。 「スレッドはプロンプトを自動的にキャッシュしません。」依然としてキャッシュのブレークポイントを配置する必要があり、トップレベルの
cache_controlでターンごとのキャッシュを要求する必要があります。 - バッチ処理とトークンカウント。
threadを含むバッチアイテムは失敗し、threadを含むトークンカウントリクエストは400エラーを返します。Anthropicは代わりに会話全文をカウントするように指示しています。 - 一部の組織。 HIPAA対応が有効な組織や、推論フック(Inference hooks)がオンになっている組織ではスレッドを利用できません。
リクエストがスレッドでサポートされていない機能を使用した場合、APIはコード thread_unsupported_request と共に400エラーを返します。ドキュメントでは「認識できない値を受け取った場合は、thread なしで会話全文を送信してください」とアドバイスしています。
データ保持とゼロデータ保持(ZDR)
データ保持要件があるチームにとって、機能のメタデータは明快です。「メッセージスレッドはZDR(Zero Data Retention)の対象外です。この機能を使用しても、他のZDR対象機能の使用には影響しません。」
詳細な注記にはこうあります。「スレッドの内容(会話、システムプロンプト、ツール)はメモリ内に保持され、サーバー管理キーで暗号化され、永続ストレージには書き込まれず、スレッドの最後の使用から1時間以内に削除されます。」
組織がゼロデータ保持に依存している場合は、スレッドを有効にする前にポリシーの責任者に確認してください。SDKはスレッドなしのリクエストにフォールバックすることができ、ドキュメントのリカバリセクションでその方法が説明されています。
Claude Codeを使用している場合
発表の中でClaude Codeについては1行だけ言及されています。「ほとんどのClaude Codeユーザーに対してメッセージスレッドがデフォルトでオンになっており」、続いて長いリクエストのレイテンシの数値が示されています。
これによりリクエストの伝送方法は変わりますが、Claude Codeの履歴が保存される場所は変わりません。Claude Codeのドキュメントには依然として「Claude Codeはセッションを ~/.claude/projects/<encoded-cwd>/*.jsonl に保存する」と記載されています。/resume が読み込むのはこれらのローカルなトランスクリプトであり、自動メモリ(auto memory)はディスク上の独自のフォルダに保持されます。私たちが確認したClaude Codeのドキュメントページには、メッセージスレッドの設定に関する記述はありませんでした。
Anthropicは、離席中にスレッドが期限切れになった場合のClaude Codeの挙動については説明していません。APIにおいて期限切れ後に文書化されている経路はリプレイです。次のリクエストで会話全文を再送信し、新しいスレッドを開始します。Claude Codeセッション間でのコンテキスト共有に関するガイドでは、セッションをまたいで永続化される部分について解説しています。
多くの人が最初に試してしまうこと
スレッドIDを会話IDとして扱う。 スレッドは最後のリクエストから数分で期限切れになります。独自の会話IDとメッセージを保存してください。
クライアントサイドのコピーを捨てる。 ドキュメントには、ターンが保存されたかどうかを知らせるレスポンスはないと書かれています。コピーがなければリプレイできません。
スレッドに対してコンパクションを呼び出す。 400エラーが返されます。コード内で圧縮を行い、要約から新しいスレッドを開始してください。
スレッドがプロンプトをキャッシュすることを期待する。 キャッシュには依然として自身で設定するブレークポイントが必要です。
ZDR設定がスレッドをカバーしていると思い込む。 スレッドはZDRの対象外です。
スレッドを読み戻す方法を探す。 Anthropicの言葉を借りれば、リスト表示、読み取り、削除のためのAPIは存在しません。
解決策:記録を自分の側に保持する
ステップ 1: 送信する前にすべてのメッセージを保存する
会話の独自のコピーを、system や tools と共に、自身で制御するストレージに保持してください。404エラー時のリプレイや、スレッド期限切れ後の復旧に使用します。Anthropicは「SDKのスレッドヘルパーは、ヘルパーオブジェクトが存在する間はこのコピーをメモリに保持するが、他には保存しない」と注記しています。プロセスが再起動する可能性がある場合は、コピーを永続的な場所に書き込んでください。
ステップ 2: 新しいスレッドへコンパクションする
会話が長くなったら、コード内で要約を作成し、それを含む作成リクエストで新しいスレッドを開始します。そして、フルヒストリーは独自のストアに保持し続けます。必要になる前に、要約に何を残すべきかを決めておきましょう。
ステップ 3: 永続的な事実は会話の外に置く
ユーザーやプロジェクトに関する決定事項、規約、事実は、特定の会話が存続することに依存すべきではありません。これらは、各新しいスレッドの開始時にエージェントがロードできる場所(独自のストレージを背景にしたMemoryツールや、リポジトリ内のファイルなど)に置いてください。Claude Codeでは、この役割を CLAUDE.md と自動メモリが担っています。Claude Codeの自動メモリに関するガイドでは、各セッションの開始時に何がロードされるかを説明しています。
MemoryLakeでのセットアップ
スレッドはアクティブなターンを高速化します。しかし、セッション、コンパクション、ツールをまたいでエージェントが必要とする事実は、5分間の沈黙で消えてしまわない場所に保管する必要があります。
MemoryLakeは、これらの事実を管理下の一箇所に保持し、ChatGPT、Claude Code、Codexなどの接続されたアシスタントから利用できるようにするための記憶レイヤーです。
エントリはあなた自身の言葉で書き込みます。メッセージスレッド、APIの会話、Claude Codeのセッション、Memoryツールのファイル、あるいはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。メッセージスレッドは、Anthropicが説明している通りの動作を維持します。
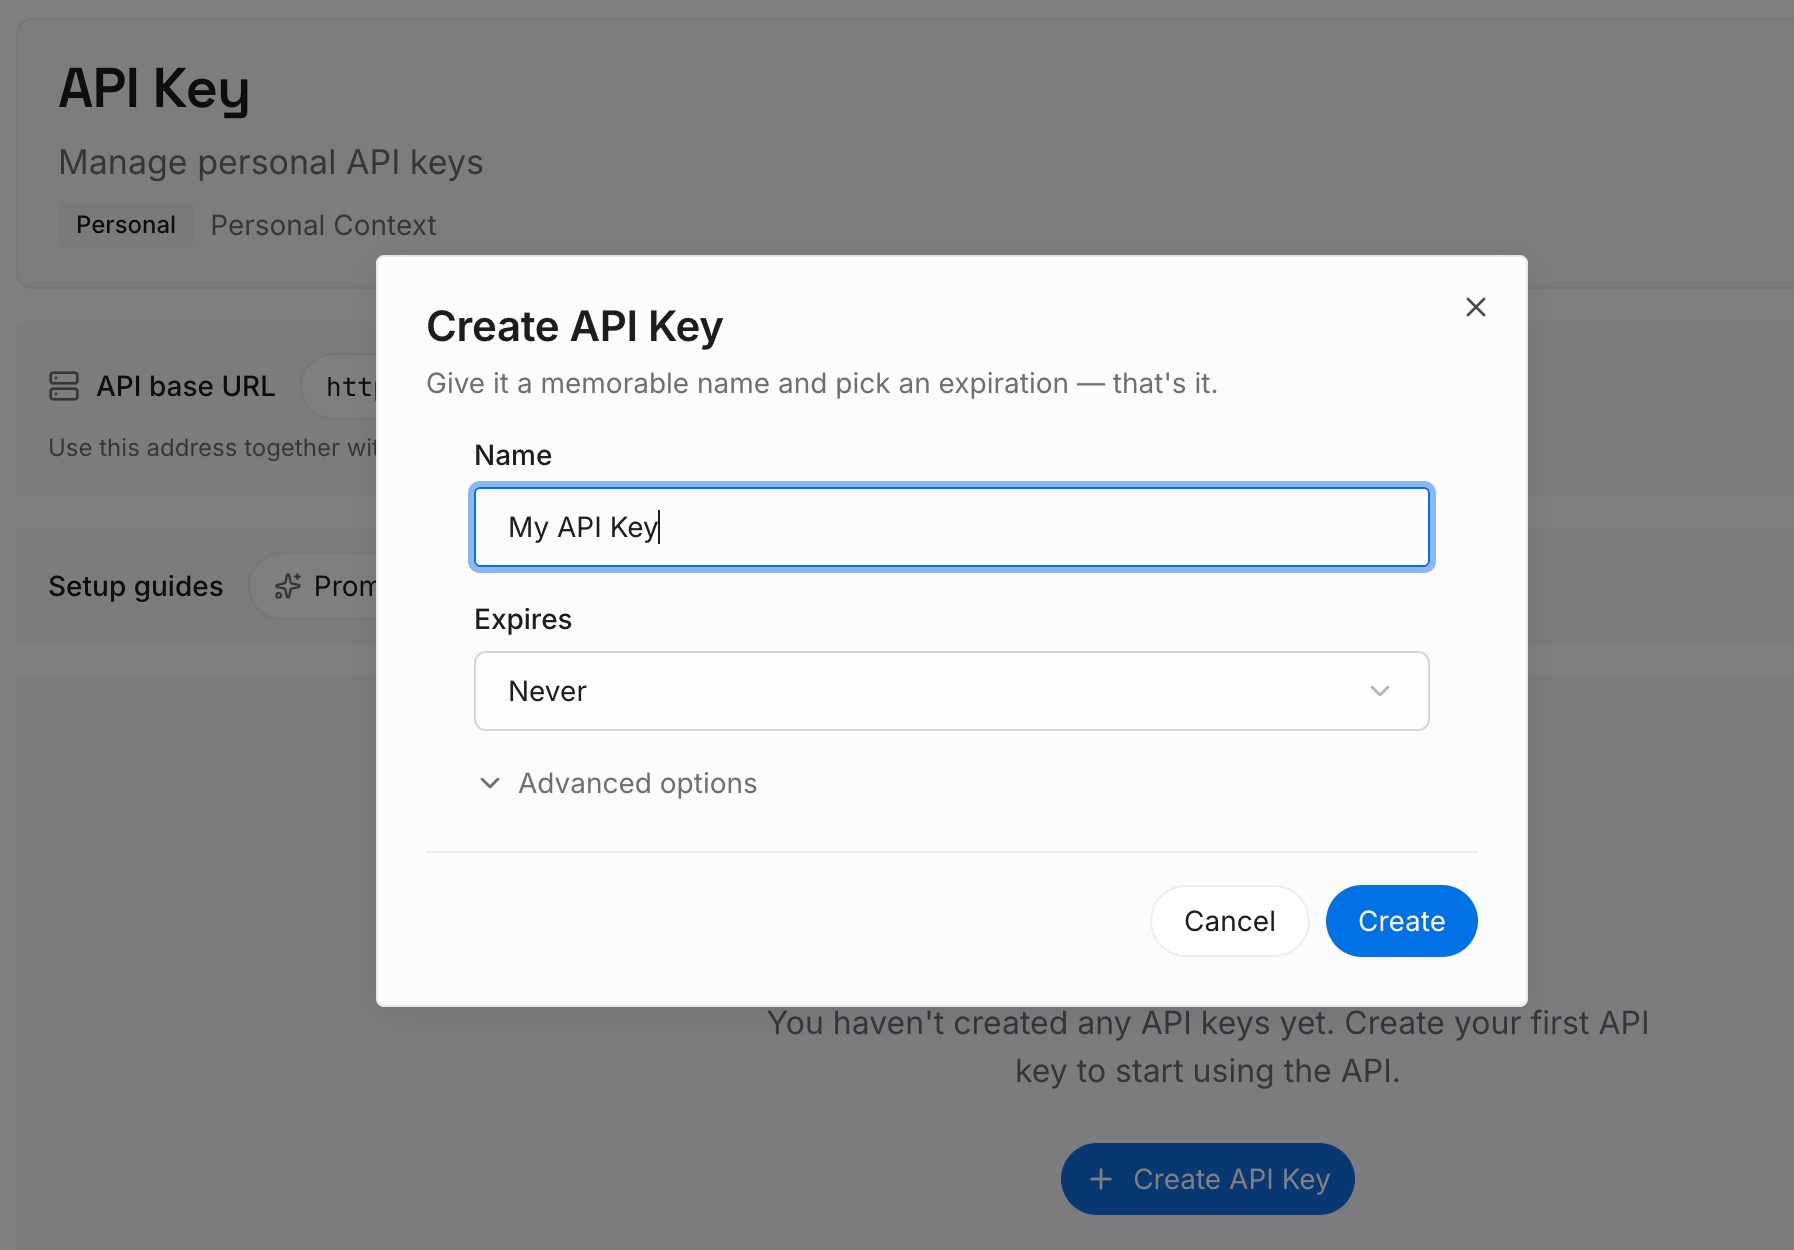
ステップ 1: APIキーを作成する
サインインし、ダッシュボードからキーを生成します。このキーはMemoryLakeワークスペースに属し、Claude Platformのキーとは別物です。
ステップ 2: 最初の記憶をアップロードする
各新しいスレッドが最初のターンから知っておくべきこと(プロジェクトの決定事項、制約、規約など)から始めましょう。1つのエントリに1つのポイントを絞り、日付を入れます。
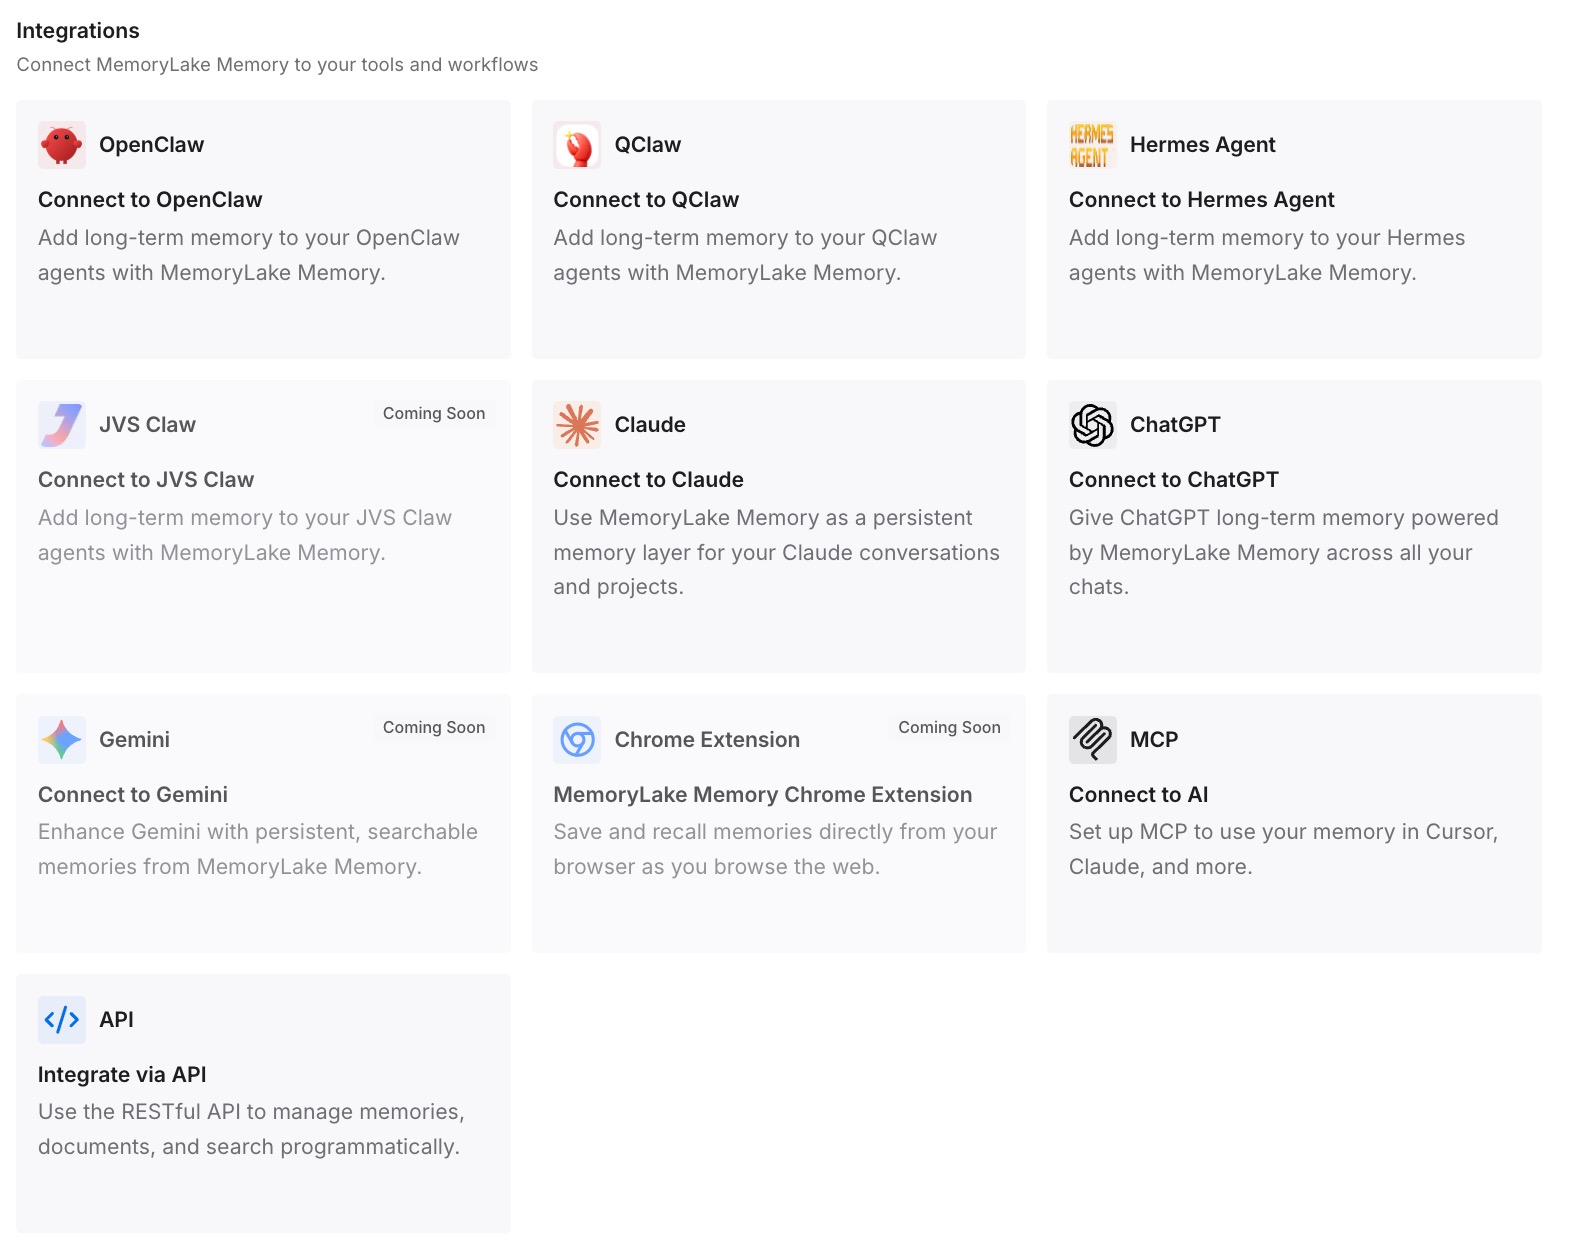
ステップ 3: AIとエージェントを接続する
Claude Codeや、使用している他のアシスタントを接続します。スレッドの開始時、コンパクション後、あるいは別のツールを使用している時でも、同じエントリを利用できます。
実務で何が変わるのか
第一の違いは、役割が明確になることです。スレッドはアクティブなループのスピードを担い、メッセージストアは記録となり、長期的な事実は独自のレイヤーに配置されます。
第二に、コンパクションがより安全になります。すべてのコンパクションが新しいスレッドを開始するため、重要な事実が「1つの要約がいかにうまく書かれたか」だけに依存しなくなります。
第三に、ツール間での再説明が減ります。同じプロジェクトをClaude CodeとCodexで実行する場合、Claude CodeとCodexを併用するためのガイドで、両方を同じコンテキストで動作させ続ける方法を解説しています。
メッセージスレッドのベストプラクティス
スレッドを短命なキャッシュとして扱う。 最後のリクエストから5分で期限切れになります。
まずリプレイ経路を構築する。 404エラーを想定し、コピーから再送信できるようにします。
スレッド全体で同じキーとワークスペースを使用する。 異なる呼び出し元はスレッドを継続できません。
コード内でコンパクションを行う。 要約から新しいスレッドを開始します。
キャッシュのブレークポイントは自身で設定する。 スレッドは自動でキャッシュしません。
保持要件を確認する。 スレッドはZDRの対象外です。
永続的な事実は外に置く。 各スレッドの開始時にそれらをロードします。
結論
メッセージスレッドにより、エージェントは各ターンで新しい内容のみを送信できるようになります。Anthropicは会話をメモリ内に暗号化して保持しますが、それは最後のリクエストから5分間だけであり、1時間以内に削除されます。スレッドを読み戻すAPIはなく、ドキュメントはすべてのメッセージのコピーを自身で保持するよう求めています。
これにより、スレッドは「記憶」ではなく「1回のアクティブなセッションのためのスピード向上機能」となります。コンパクションとは要約を書いて新しいスレッドを開始することを意味します。したがって、引き継がれるのはあなたが保持するもの、つまりメッセージストア、要約、そして単一の会話よりも長生きする場所に保存された事実だけなのです。