
なぜ長いセッションでは同じ指示が異なる挙動を示すのか
まずは、それぞれのレイヤーが何のためにあるのかを整理しましょう。
Workspace knowledge は、「複数のプロジェクト間で一貫させるべきルールや規約に最適」です。一度定義しておけば、「各プロジェクトの knowledge フィールドで同じ指示を繰り返すことを避ける」ことができます。ワークスペースのオーナーと管理者のみが管理できるため、コーディング標準、テスト要件、アーキテクチャのルールといったガードレール(制約事項)を配置するのに自然な場所となります。
Project knowledge は、プロジェクトの編集権限を持つ人なら誰でも編集可能で、そのアプリケーションに特有の情報(目的、スキーマ、ドメイン用語、連携機能など)を保持します。
どちらもすべてのメッセージにおける背景のコンテキストとなります。Lovable は、連携されたサービスからの統合知識やリポジトリ内の指示ファイルとともに、「編集を生成する前に、プロジェクトがどのように動作するかを理解するために、project knowledge、workspace knowledge、およびプロジェクトコードを読み込みます」。
次に制限についてです。各レイヤーは「最大10,000文字までサポート」しています。ワークスペースごとに存在する workspace knowledge は正確に1つだけです。「同じワークスペース内の一部のプロジェクトに対して、異なるワークスペースレベルの指示を定義することはできません」。そして、2つのレイヤーが矛盾する場合の解決策は、原文のまま読む価値のある、含みを持たせた表現でドキュメント化されています。Lovable は「現在のプロジェクトに特化して適用されるため、project knowledge で定義された指示を優先することが推奨されます(is encouraged to prioritize)」。
「保証」ではなく「推奨」です。この表現は異例なほど正直であり、有用な事実を教えてくれています。ここでの競合解決は、ローダーによって強制される優先順位ルールではなく、モデルに示される「好み」に過ぎません。つまり、競合に対処する最も信頼できる方法は、競合を発生させないことです。
文字数制限、単一のワークスペース階層、競合解決の曖昧さ、および長いセッションに関する警告を組み合わせると、明確な指針が得られます。knowledge は、背景情報として機能し、短く保たれ、重複しないものであるべきです。それ以外のものはすべて、別のキャリアを必要とします。これは、長いコンテキストウィンドウが構造化された記憶の代わりとしては不十分であるとする理由と同じです。制約となるのは容量(キャパシティ)ではないのです。
よくある誤ったアプローチ
両方のフィールドを文字数制限いっぱいまで埋める。 これは最も一般的なアプローチですが、長いセッションに関する警告に真っ向から反します。背景テキストを増やしても、指示への準拠度が高まるわけではありません。
「念のため」両方のレイヤーに同じルールを記述する。 これにより、ドキュメントが警告している競合ケースが発生し、ルールではなく「好み」によって解決されることになります。推奨されているアドバイスはその逆です。「共有ルールは workspace knowledge に、プロジェクト固有の詳細は project knowledge に保持してください」。
一部のプロジェクトに対して workspace knowledge を使用する。 ワークスペースには1つの workspace knowledge しか存在せず、ドキュメントにはそれをワークスペース内の一部のプロジェクトだけに適用するルートは記載されていません。12個のプロジェクトのうち3個にしか適用されないルールをワークスペースレベルで記述すると、12個すべてに適用されてしまいます。
knowledge をタスク指示の場所として扱う。 ドキュメントではこれらを明確に区別しています。「Knowledge は常に Lovable の背景コンテキストとして含まれます。Skills は、リクエストがスキルの説明と一致したときにオンデマンドで読み込まれます」。ガイダンスでは、「すべてのメッセージに適用されるルールには knowledge を使用し、特定の種類のタスクにのみ重要な指示には skills を使用する」よう求めています。
長い会話が短い会話と同じように動作すると仮定する。 そうはならないことが明記されています。解決策は、knowledge フィールドを長くすることではありません。
エージェントの挙動が逸れたときに、チャットでルールを再提示する。 これは1つのメッセージに対しては機能しますが、根本的な解決にはなりません。2時間後にルールが守られなくなるのであれば、そのルールは間違ったキャリアに配置されています。
解決策:ルールの適用頻度で整理し、セッションの長さに耐えうるキャリアを選ぶ
3つのキャリア、3つの役割。整理の基準は重要度ではなく、関連性の「頻度」、そして「耐久性」です。
ステップ 1: すべてのルールを適用頻度で分ける
現在 knowledge フィールドにあるすべての記述を、次の3つの山のいずれかに分類します。
すべてのプロジェクトの、すべてのメッセージに適用されるもの: コーディング標準、テスト要件、アーキテクチャの制約など。これは workspace knowledge に該当し、10,000文字ではなく、1ページ程度に短くまとめるべきです。
このプロジェクトのみの、すべてのメッセージに適用されるもの: アプリケーションの役割、スキーマの形状、ドメイン用語、存在する連携機能など。これは project knowledge に該当します。
特定の種類のタスクが発生したときにのみ適用されるもの: マイグレーションの追加方法、リリースチェックリスト、新しいコネクタの接続方法など。これは skill(スキル)に該当します。ドキュメントに記載されている判断基準は、その指示が「すべてのメッセージに関連しているか」どうかです。そうでない場合は、スキルに分類されます。
ほとんどのチームにおいて、3つ目の山が最も大きくなり、その多くが本来のルールを圧迫しながら knowledge フィールドに居座っていたことに気づくでしょう。これらを移動させることが、ここでの最大の改善策です。これは、プロジェクトのドキュメントを、単なるテキストの壁からエージェントが実際に利用できる記憶へと変換するプロセスと同じアプローチです。
ステップ 2: 長いセッションでも維持すべきルールをリポジトリに移動する
次に、2つの knowledge フィールドに残ったものを確認し、各行に対してより厳しい問いを投げかけます。「これはセッション開始から3時間経っても維持される必要があるか?」
ほとんどは必要ありません。長い会話の後半でドメイン用語の表記が揺れたとしても、せいぜいリネームの手間が発生する程度です。しかし、一部のルールは必須です。データの損失を防ぐ制約、セキュリティ要件、絶対にコミットしてはならないものに関するルールなど、一貫性の欠如が致命的なコストにつながるものがこれに該当します。
これらは、ルートレベルの AGENTS.md に配置すべきです。FAQでは、これが「セッションの長さに関係なく、常に Lovable エージェントによって読み込まれる」と説明されています。また、ドキュメントには AGENTS.md や CLAUDE.md などの指示ファイルも「Lovable エージェントにガイダンスを提供できる」と記載されており、リポジトリの指示ファイルがすべてのメッセージで読み込まれるコンテキストソースの1つとして挙げられています。
これは knowledge フィールドを放棄することではありません。一方のキャリアにはドキュメント化された「警告」があり、もう一方にはドキュメント化された「保証」があることを認識し、交渉の余地のない少数のルールを保証のある方に配置するということです。
ステップ 3: 重複をすべて排除し、境界線をテストする
山分けが完了したら、3つのキャリアを並べて読み、重複をすべて削除します。ルールが workspace knowledge にある場合、project knowledge にもあるべきではありません。AGENTS.md にある場合は、どちらのフィールドにもあるべきではありません。
このステップにより、曖昧な競合解決ルールを気にする必要がなくなります。project knowledge の内容が workspace レイヤーと矛盾していなければ、どちらが確実に優先されるかを知る必要はありません。
その後、意図的に境界線をテストします。プロジェクトを開始し、workspace ルールが適用される処理を要求して出力を確認します。次に project ルールが適用される処理を要求して確認します。その後、実際に長いセッション(1時間の実作業)を実行し、AGENTS.md に移動したルールを再確認します。警告は長い会話に特有のものであるため、2分間のテストでは何も検証できません。
同じページからの実用的なメモ:会話の途中で workspace knowledge を更新した場合、「Lovable は以降のメッセージで更新された指示を使用します」。再起動することなくルールを修正できるため、このテストは低コストで実施できます。
MemoryLake での設定方法
整理を行うことで、どのツールで開発するかに関わらず共通して適用される、少数の決定事項(アーキテクチャの制約、ドメイン用語、各標準の背後にある理由など)が浮かび上がります。MemoryLake は、これらの決定事項を保持し、1つのワークスペースの文字数制限に縛られないようにするための場所です。
エントリーは、あなた自身の言葉で記述します。Lovable の workspace knowledge、project knowledge、またはその他のベンダーのストレージからデータが読み取られたり、書き込まれたり、削除されたりすることはありません。
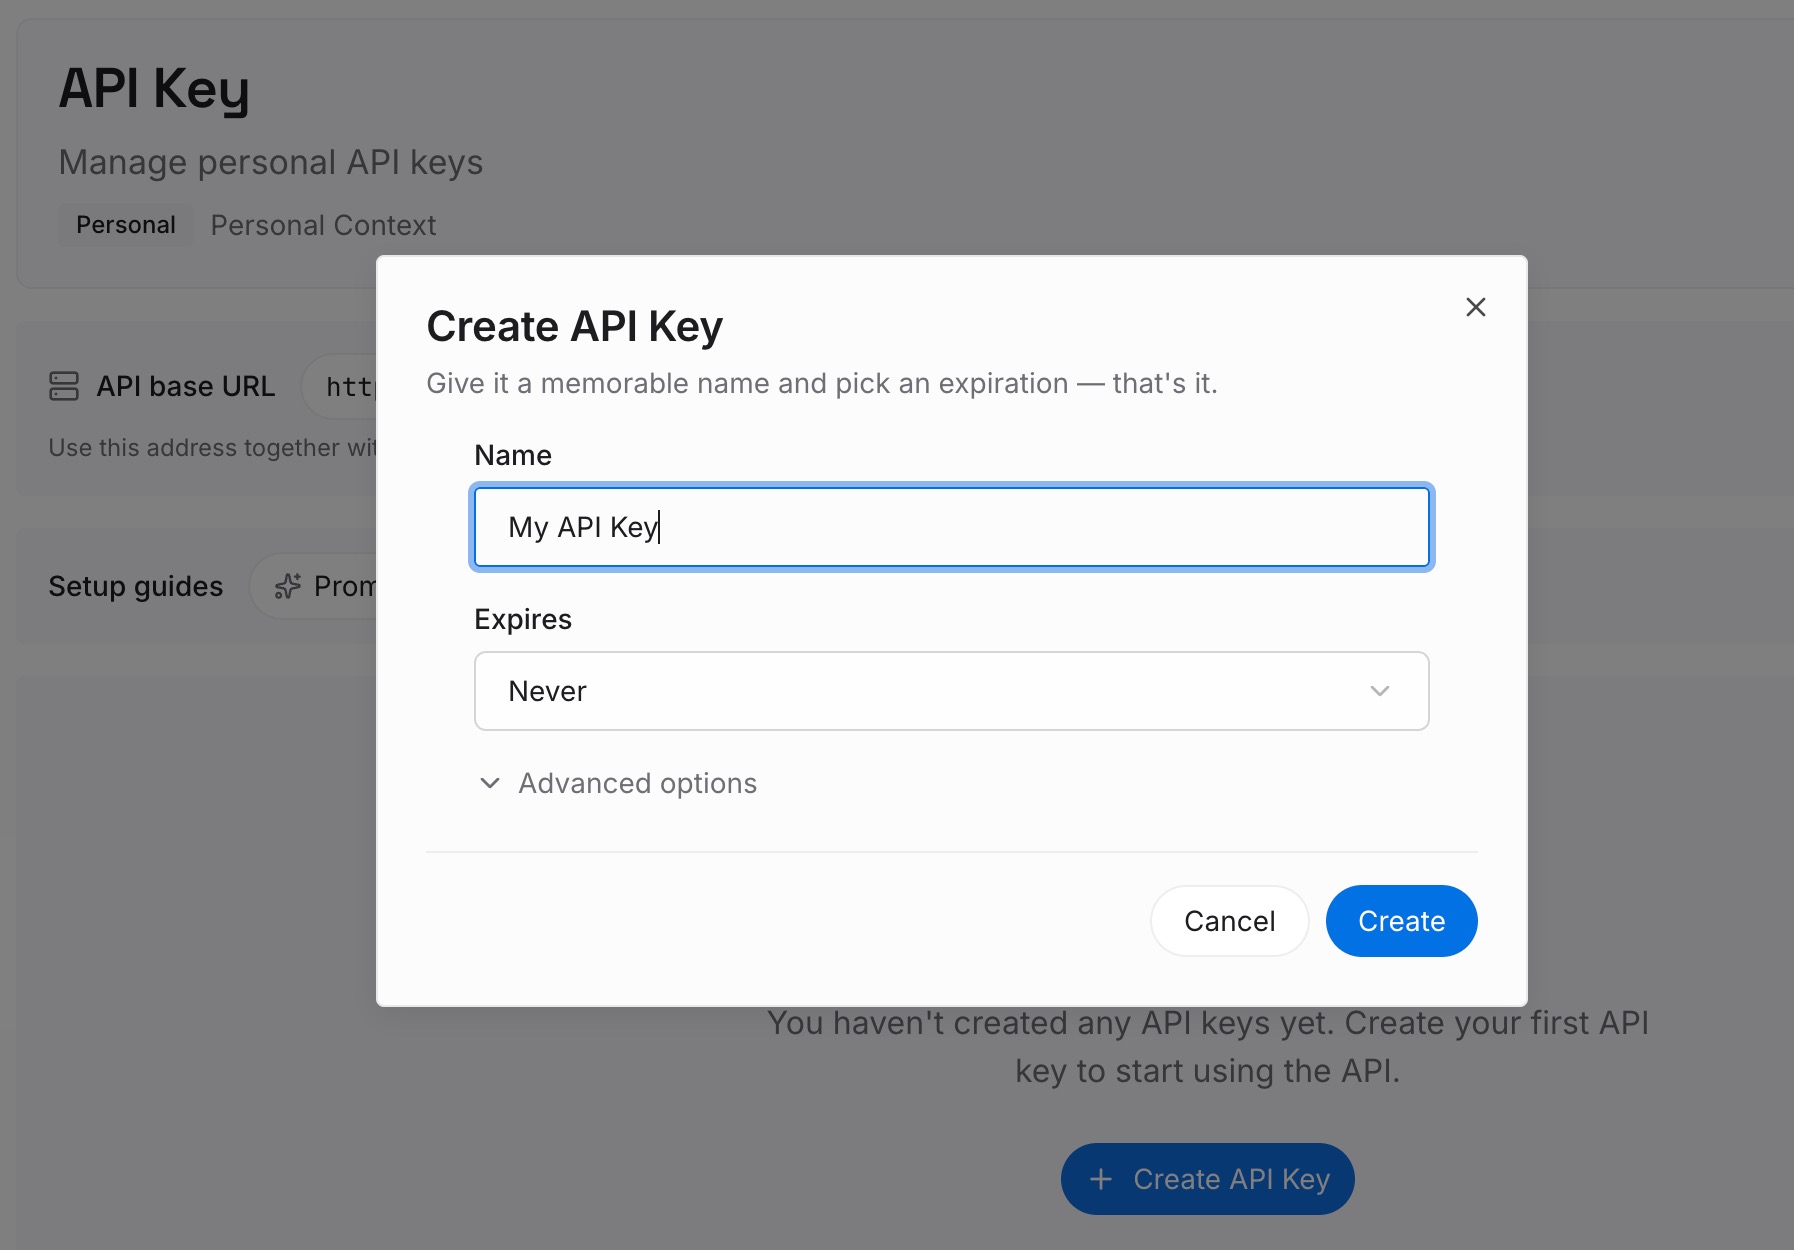
ステップ 1: API キーを作成する
サインインし、ダッシュボードからキーを生成します。このキーを使用することで、Lovable やチームが使用するその他のツールにおいて、エージェントが作成したエントリーを読み取れるようになります。
ステップ 2: 最初の記憶をアップロードする
決定事項とその理由を、1つのエントリーにつき1つの事実として追加します。knowledge フィールドには指示を保持し、エントリーにはそれが存在する理由を保持します。10,000文字の制限があると理由を省略せざるを得なくなりますが、1年後にルールを見直す際にはその理由こそが重要になるため、この切り分けが大切です。
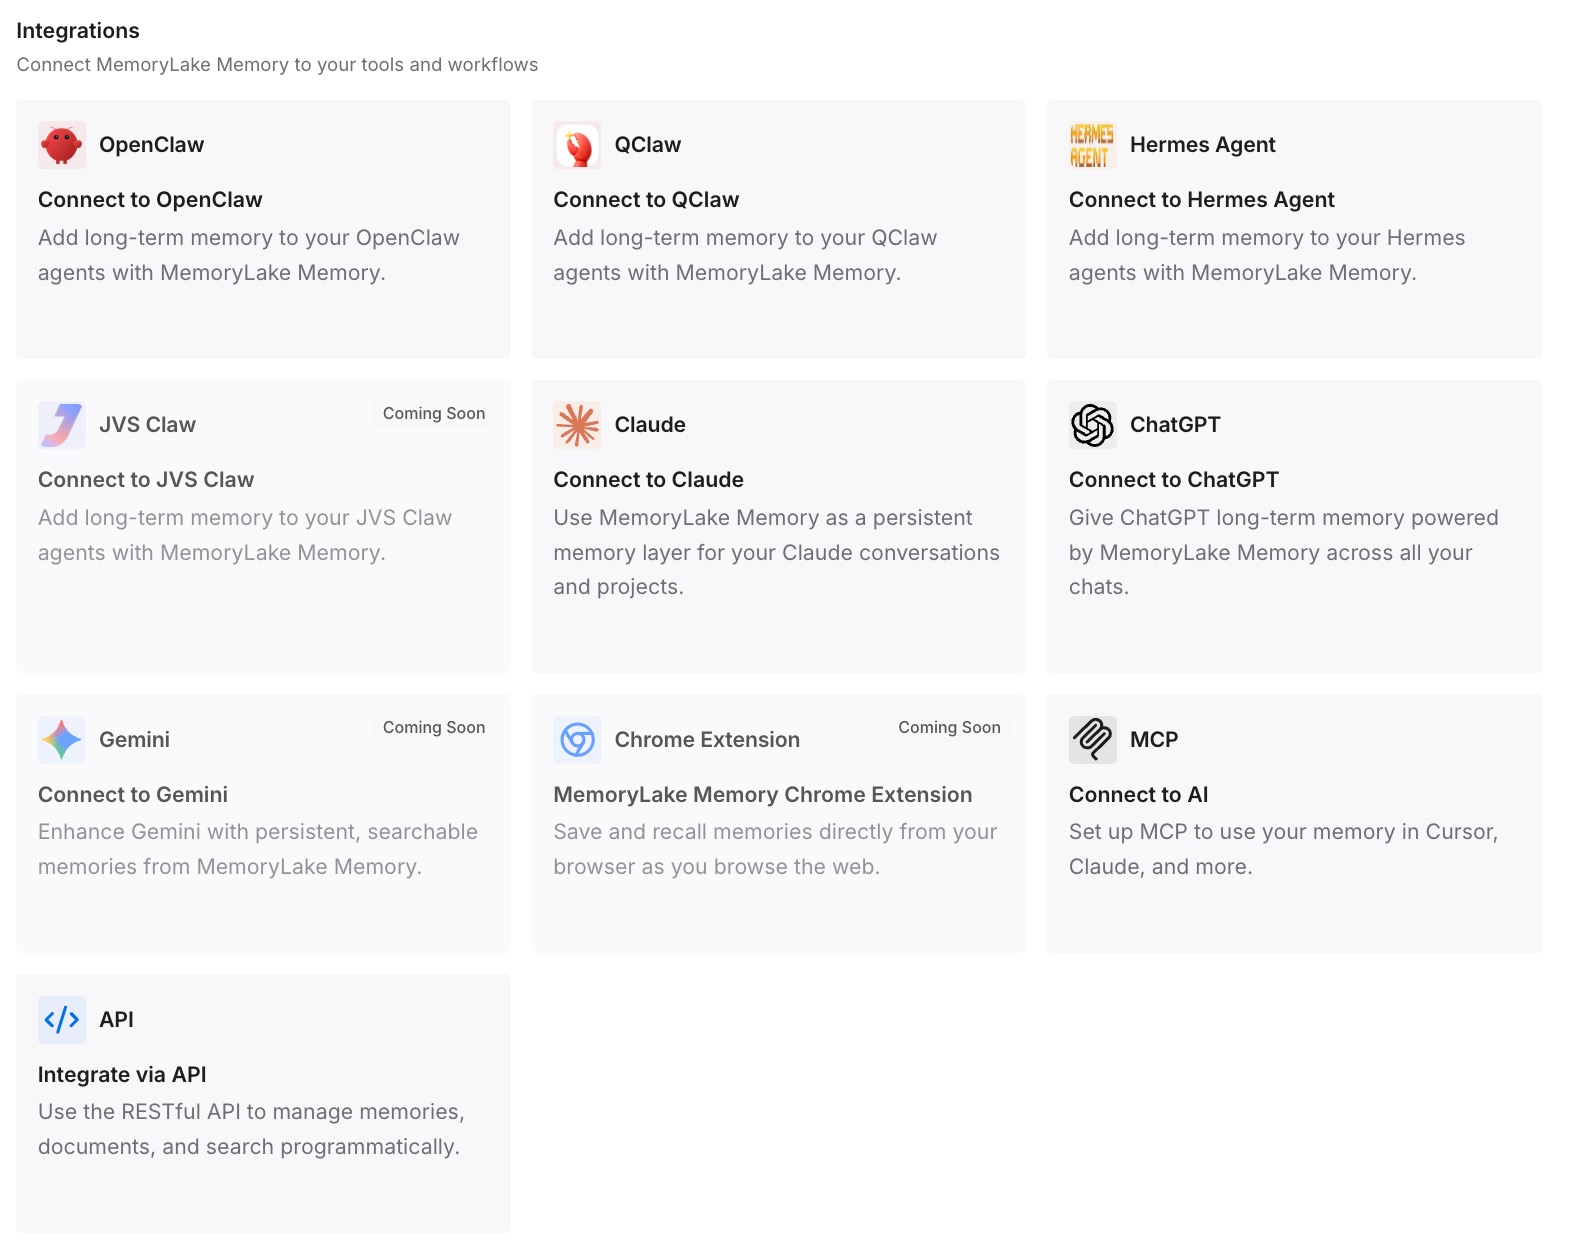
ステップ 3: AI とエージェントを接続する
エージェントをワークスペースに向けます。これにより、ワークスペースの管理者しか workspace knowledge を編集できない場合でも、別のツールで作業しているチームメンバーが同じ決定事項を利用できるようになります。
実践において何が変わるのか
最初の変化は、knowledge フィールドが短くなることです。そして、短くすることこそが目的です。長いセッションに関する警告は「大量のコンテキスト」に起因するため、背景レイヤーをスリムに保つことは、単なる回避策ではなく直接的な解決策となります。
2つ目は、権限構造が味方になり始めることです。オーナーと管理者のみが workspace knowledge を編集できるという仕様は、ガードレールには適していますが、イテレーション(反復開発)には適していません。「すべてのプロジェクトのすべてのメッセージ」に適用される山が十分に小さければ、そのレイヤーは設計上ほとんど変更されないため、管理者のボトルネックがボトルネックでなくなります。
3つ目は、交渉の余地のないルールに対して、ドキュメント化された保証のあるキャリアが与えられることです。これは、背景の指示が維持されることを期待するよりも大幅なアップグレードであり、リポジトリにファイルを1つ追加するだけで実現できます。
1ヶ月後に現れる4つ目の効果もあります。スキルにタスク固有の指示を保持させると、それらを個別にレビューできるようになります。他のすべてを読まなくても、マイグレーションに関する指示だけを読むことができます。10,000文字の knowledge フィールドは誰もレビューしなくなるため、古いルールがそのまま残ってしまいます。この力学は、チームが実際に維持できる知識が、誰も読まない膨大なテキストの山に勝る理由、および知識がいつ適用されるかを決定するトリガーを明示することに価値がある理由を説明しています。
また、ここで対象外となるものについても知っておく価値があります。チャットコネクタは接続されたツールからリアルタイムのコンテキストをもたらし、カスタムコネクタは独自の knowledge ファイルを持ちますが、これらはどちらも2つのフィールドの代替ではなく、追加のコンテキストソースです。ソースを増やしても、大量のコンテキストが存在することによる長いセッションの警告への対策にはなりません。
知識を階層化するためのベストプラクティス
文字数制限は、近づくべきではない「天井」として扱う。 各フィールドの10,000文字は上限であり、目標ではありません。1画面に収まる workspace レイヤーは、入力欄を埋め尽くすものよりも確実に遵守されます。
1つのルールにつき1つの配置場所を徹底し、3つのキャリアを並行して確認する。 重複は、明確な指示を「好み」によって解決される競合へと変えてしまいます。
ワークスペースレベルのルールは、すべてのプロジェクトに適用される場合のみワークスペースレベルに配置する。 ワークスペースには1つの workspace knowledge しかなく、ドキュメントにはその下のスコープ制限メカニズムは記載されていません。3つのプロジェクトのためのルールは、それら3つのプロジェクトに配置すべきです。
AGENTS.md は、一貫性の欠如が致命的となるルール専用にする。 これはセッションの長さに対する保証がドキュメント化されているキャリアであり、短く保たれるからこそ有用であり続けます。
重要度ではなく、頻度を整理の基準にする。 「重要だが時々しか発生しないもの」はスキルに分類すべきです。重要だからという理由で knowledge に入れると、フィールドがすぐに埋まってしまいます。
短いセッションではなく、長いセッションの後にテストする。 ドキュメントに記載された警告は、長い会話に特有のものです。簡単な確認では何も検証できません。
フィールドに収まらない「理由」を別の場所に記述する。 記録された理由のないルールは、誰かが疑問を呈するまで従われ、その後削除されてしまいます。これにより、チームは依然として必要だった制約を失うことになります。これは、プロジェクトが書き残されなかった知識を失うのと同じ失敗です。
スキーマ変更後に再確認する。 スキーマを記述した project knowledge は静かに古くなります。古い事実は、存在しない事実よりも悪質です(自信満々に間違えるため)。ドメイン知識自体を耐久性がありレビュー可能な状態に保つことで、更新作業を小さなタスクに抑えることができます。
結論
Lovable のドキュメントには、2つの knowledge レイヤー、それぞれの文字数制限、単一のワークスペース階層、曖昧に表現された競合時の優先順位、および非常に長い会話では指示が一貫して従われない可能性があるという警告が記載されています。同時に、同じページには、セッションの長さに関係なく常に読み込まれるリポジトリファイルについても記載されています。
これらの事実を総合すると、これは制限ではなく、整理システム(ファイリングシステム)であることがわかります。ルールの適用頻度に応じて整理しましょう。「すべての場所のすべてのメッセージ」は workspace knowledge に、「ここのすべてのメッセージ」は project knowledge に、「時々」はスキルに配置します。そして、一貫性の欠如が致命的となる少数のルールを抽出し、ルートレベルの AGENTS.md に移動します。
重複を排除し、境界線をテストし、十分に長いセッションの後に再テストを行ってください。各ルールの背後にある理由は、ツールの変更に耐えられる場所に保管してください。指示は単なる設定(コンフィギュレーション)ですが、決定事項こそが資産だからです。これは、Lovable プロジェクトを別の場所に移行した際、ルールは簡単にコピーできても、その理由はコピーできないことに気づいたチームが発見する事実でもあります。