
Codex Subagentsとは何か
OpenAIのドキュメントでは3つの用語が使われています。「Subagentワークフロー」は、Codexが並列エージェントを実行し結果を組み合わせるフローのことです。「Subagent」は、特定のタスクを処理するためにCodexが開始する委任されたエージェントです。「エージェントスレッド」は、Subagentが作業を行う場所であり、サポートされているクライアントで開くことができます。
どこで動作するか
Subagentsは、ChatGPTデスクトップアプリ、Codex CLI、IDE拡張機能、およびChatGPT Workで動作します。OpenAIは「現在のCodexリリースでは、デフォルトでSubagentワークフローが有効になっている」と述べています。ChatGPT Workでは、エージェントはChatGPTのホスト環境で動作し、チャットにはそのアクティビティと結果が表示されます。
これらは無料ではありません。OpenAIは「各Subagentが独自のモデルとツール作業を行うため、Subagentワークフローは同等のシングルエージェント実行よりも多くのトークンを消費する」と指摘しています。
どのように開始するか
ローカルのCodexでは、ユーザーが依頼したとき、または指示によってCodexに委任が求められたときにSubagentsが開始されます。OpenAIによると、現在のローカルリリースでは「直接依頼された場合、または適用可能な AGENTS.md やスキルの指示で要求された場合」に委任が行われます。実際には、「2つのエージェントを生成して」「この作業を並列で委任して」「1ポイントにつき1つのエージェントを使って」といったプロンプトが該当します。
ChatGPT Workでは、ほとんどのインテリジェンスレベルで依頼可能です。Ultraでは、ChatGPTは別途依頼がなくても適切な作業を委任できます。
なぜ存在するのか
OpenAIが挙げている理由は、速度ではなくコンテキストに関するものです。メインチャットを調査メモ、テストログ、スタックトレース、コマンド出力で埋め尽くすと、「時間の経過とともにセッションの信頼性が低下する可能性がある」ためです。OpenAIは2つの影響を挙げています。有用な情報が埋もれてしまう「コンテキスト汚染(context pollution)」と、関連性の低い詳細でチャットが埋まることでパフォーマンスが低下する「コンテキストの腐敗(context rot)」です。
Subagentsは、そのノイズをメインスレッドから切り離します。OpenAIのガイダンスでは、メインエージェントを「要件、決定事項、最終出力に集中」させ、Subagentsからは生の途中経過ではなく要約を返すように推奨しています。
各Subagentが保持する情報
ここが、Subagentと自分で開く2つ目のチャットとの最大の違いです。Subagentはセッションから一部の情報を自動的に取得しますが、それ以外は与えられた場合にのみ取得します。
タスク、そしておそらく会話内容
すべてのSubagentにはタスクが与えられます。会話内容も渡されるかどうかは、開始時の選択によります。Codexのオープンソースコードでは、Subagentを開始するツールにこのオプションがあり、「Trueの場合は現在のスレッド履歴を新しいエージェントにフォークし、Falseまたは省略された場合は初期プロンプトのみで開始する」と説明されています。
したがって、Subagentはそのタスクの内容しか知らずに開始する可能性があります。メインチャットで、どのライブラリを選んだか、どのファイルが立ち入り禁止かといった決定事項がある場合、Subagentがそれを知っていると仮定しないでください。依頼に含めるか、委任時にそれを含めるようCodexに指示してください。OpenAI自身のアドバイスも同様です。「優れたSubagentプロンプトは、作業の分割方法、Codexが続行前にすべてのエージェントを待つべきかどうか、そしてどのような要約や出力を返すべきかを説明する必要がある」。
会話の完全なコピーを別の方向で探索したい場合は、別の機能になります。Codexチャットのフォークに関するガイドで解説しています。Claude CodeのSubagentsも、各ヘルパーが何を知っているかという同様の疑問を提起しており、Claude CodeのSubagentsがメモリを共有しない理由に関するガイドでその側面をカバーしています。
モデル設定
何も設定しない場合、OpenAIは「Subagentは親エージェントのモデルと推論の取り組み(reasoning effort)を継承する」としています。これはプロンプトで変更したり、config.toml の [agents] セクションでデフォルトを設定したり、カスタムエージェントファイルで設定したりできます。OpenAIは、限定的で反復可能な作業には高速なモデルを、計画や検証が必要なエージェントにはより強力なモデルを推奨しています。
サンドボックスと承認
Subagentsは現在のサンドボックスポリシーを継承します。デスクトップアプリやIDE拡張機能では、コンポーザーの下で選択されている権限モードを継承するため、Codexに委任を依頼する前に選択してください。CLIでは、OpenAIは「Subagentsは、/permissions や --yolo で行われた変更を含め、親ターンの現在のサンドボックスと承認設定を継承する」と述べています。
カスタムエージェントでこれを緩めることはできません。OpenAIは明示的に「カスタムエージェントの指示でエージェントに編集を避けるよう求めることはできるが、独立した読み取り専用のサンドボックスを作成するわけではない」としています。
スキル、MCPサーバー、およびメモリ
カスタムエージェントは「親の権限、プロバイダー、およびMCPサーバーを継承します。カスタムエージェントファイルでこれらの設定を上書きすることはできません」。スキルも親から継承され、カスタムエージェントは skills.config で個別のスキルをオフにできます。
メモリは、カスタムエージェントがオフにできる機能の1つです。OpenAIは、エージェントができることを制限するために false に設定できる機能キーの中に features.memories を挙げています。Codexのローカルメモリを有効にしている場合、Codexのローカルメモリに関するガイドで、保持される内容と制御方法を説明しています。
メインチャットに戻ってくるもの
メインスレッドには作業の全容ではなく、結果が届きます。複数のエージェントが実行される場合、OpenAIは「Codexは要求されたすべての結果が利用可能になるまで待ち、その後、統合されたレスポンスを返す」と述べています。
作業自体は各エージェントスレッドに残ります。デスクトップアプリでは、OpenAIは「各Subagentスレッドを表示するため、その作業内容とメインチャットに返された要約を確認できる」としています。CLIでは、/subagents を使用して実行中にエージェントスレッドを切り替えることができます。ChatGPT Workでは、Subagentsパネルに読み取り専用の「Active(実行中)」と「Done(完了)」のリストが表示され、完了したSubagentを開いて詳細と結果を確認できます。
この設計により、メインチャットはクリーンに保たれます。一方で、Subagentがどのファイルを読み取ったか、どのアプローチを除外したかといった発見の背後にある推論は、スレッドを開かないと見えない場所に存在することを意味します。後で重要になる場合は、そのスレッド以外の場所に書き留めておく必要があります。
組み込みエージェントとカスタムエージェント
Codexには3つの組み込みエージェントが付属しています。
default: 汎用的なフォールバックエージェントworker: 実装と修正用explorer: 読み取り中心のコードベース探索用
独自のものをTOMLファイルとして定義できます。個人用エージェントは ~/.codex/agents/ に、プロジェクト限定のエージェントは .codex/agents/ に、1エージェントにつき1ファイル作成します。各ファイルには name、description、developer_instructions を定義する必要があります。OpenAIのドキュメントには、例として .codex/agents/reviewer.toml として保存された以下のレビュアーが含まれています。
name = "reviewer"
description = "正確性、セキュリティ、不足しているテストに焦点を当てたPRレビュアー。"
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
developer_instructions = """
オーナーのようにコードをレビューしてください。
ファイルを編集しないでください。
正確性、セキュリティ、動作の退行、および不足しているテストカバレッジを優先してください。
具体的な発見事項を先に述べ、可能な場合は再現手順を含め、実際のバグを隠していない限りスタイルのみのコメントは避けてください。
"""
カスタムエージェントに対するOpenAIのアドバイスは、役割を限定することです。「最高のカスタムエージェントは、限定的で意見がはっきりしているものである」。カスタムエージェントの名前が explorer などの組み込みエージェントと一致する場合、作成したものが優先されます。
グローバル設定
すべてのSubagentsに適用される設定は、構成ファイルの [agents] の下にあります。agents.enabled はデフォルトで true です。マルチエージェントツールをオフにするには false に設定します。agents.max_concurrent_threads_per_session は、メインスレッドを除いて同時に開ける生成エージェントスレッドの数を制限します。agents.max_threads もレガシーなエイリアスとして機能します。agents.default_subagent_model と agents.default_subagent_reasoning_effort は、明示的な要求がない場合のデフォルトを設定します。
実行中のSubagentsの操作
待つ必要はありません。デスクトップアプリ、CLI、IDE拡張機能では、実行中のSubagentを操作したり、停止させたり、完了したスレッドを閉じたりするようCodexに依頼できます。CLIでは、見ていないエージェントスレッドから承認要求が来ることがあります。オーバーレイにはどのスレッドが要求しているかが表示され、回答する前に o を押してそのスレッドを開くことができます。
OpenAIはまた、ある種の作業について警告しています。並列エージェントは、探索、テスト、トリアージ、要約などの読み取り中心のタスクに適しています。「並列での書き込み中心のワークフローにはより注意が必要である。複数のエージェントが一度にコードを編集すると、競合が発生し、調整のオーバーヘッドが増える可能性がある」としています。
よくある間違い
Subagentが会話全体を知っていると思い込むこと。 タスクのみで開始される場合があります。重要な決定事項は依頼に含めてください。
カスタムエージェントファイルを使ってエージェントを読み取り専用にしようとすること。 指示で編集しないよう求めることはできますが、サンドボックスは依然として親セッションから継承されます。
カスタムエージェントファイルでMCPサーバーを設定すること。 親の設定を上書きしません。MCPサーバーは親セッションで設定してください。
同じコードを編集する複数のエージェントを実行すること。 OpenAIは並列書き込みには注意を推奨しています。並列エージェントは主に読み取りとチェックに使用してください。
実行後に発見事項を失うこと。 メインチャットには要約が届きます。詳細が重要な場合は、次に進む前に保存してください。
解決策:各Subagentにブリーフィングを行い、メインチャットを決定事項のために残し、学んだことを書き留める
ステップ1:タスクだけでなくブリーフを書く
Codexに委任を依頼するときは、作業の分割方法、各エージェントが何を返すべきか、そして全員を待つべきかどうかを伝えてください。制約事項、触れてはいけないファイル、すでに除外されたアプローチなど、各エージェントが必要とする決定事項を含めます。永続的なルールは AGENTS.md に記述すれば、Codexは毎回それに従うことができます。CodexがAGENTS.mdのルールをスキップする問題に関するガイドでは、Codexがこれらのファイルをどのように見つけるかを解説しています。
ステップ2:委任する前に権限とエージェントを設定する
Subagentsは親ターンの権限モードを継承するため、まず親ターンの権限モードを選択してください。繰り返す作業については、限定的な指示とジョブに適したモデルを持つカスタムエージェントを作成し、不要な機能をオフにします。
ステップ3:Subagentsが見つけたものを保存する
統合された回答が届いたら、重要なエージェントスレッドを開き、保持する価値のある発見事項(リスク、決定事項、行き止まりなど)を取り出します。それらを次のセッションで見える場所に書き留めてください。明確な終わりのある長いタスクについては、Codex Goal modeに関するガイドで、メインチャットを成果に向け続ける方法を説明しています。
MemoryLakeでの設定方法
Subagentsは発見事項を生み出しますが、それを保持するかどうかはあなた次第です。各発見事項はエージェントスレッドの中にあり、誰かが書き留めない限り、次のタスク、チャット、またはツールはそれなしで開始されます。
MemoryLakeは、それらの発見事項を1つのリストとして維持し、Codexや、接続しているChatGPT、Claude Codeなどの他のアシスタントが利用できるようにするためのメモリレイヤーです。
エントリーはあなた自身の言葉で作成します。Subagentスレッド、AGENTS.md ファイル、Codexのメモリ、またはベンダーのストアから何かが読み取られたり、書き込まれたり、削除されたりすることはありません。SubagentsはOpenAIが説明している通りの動作を続けます。
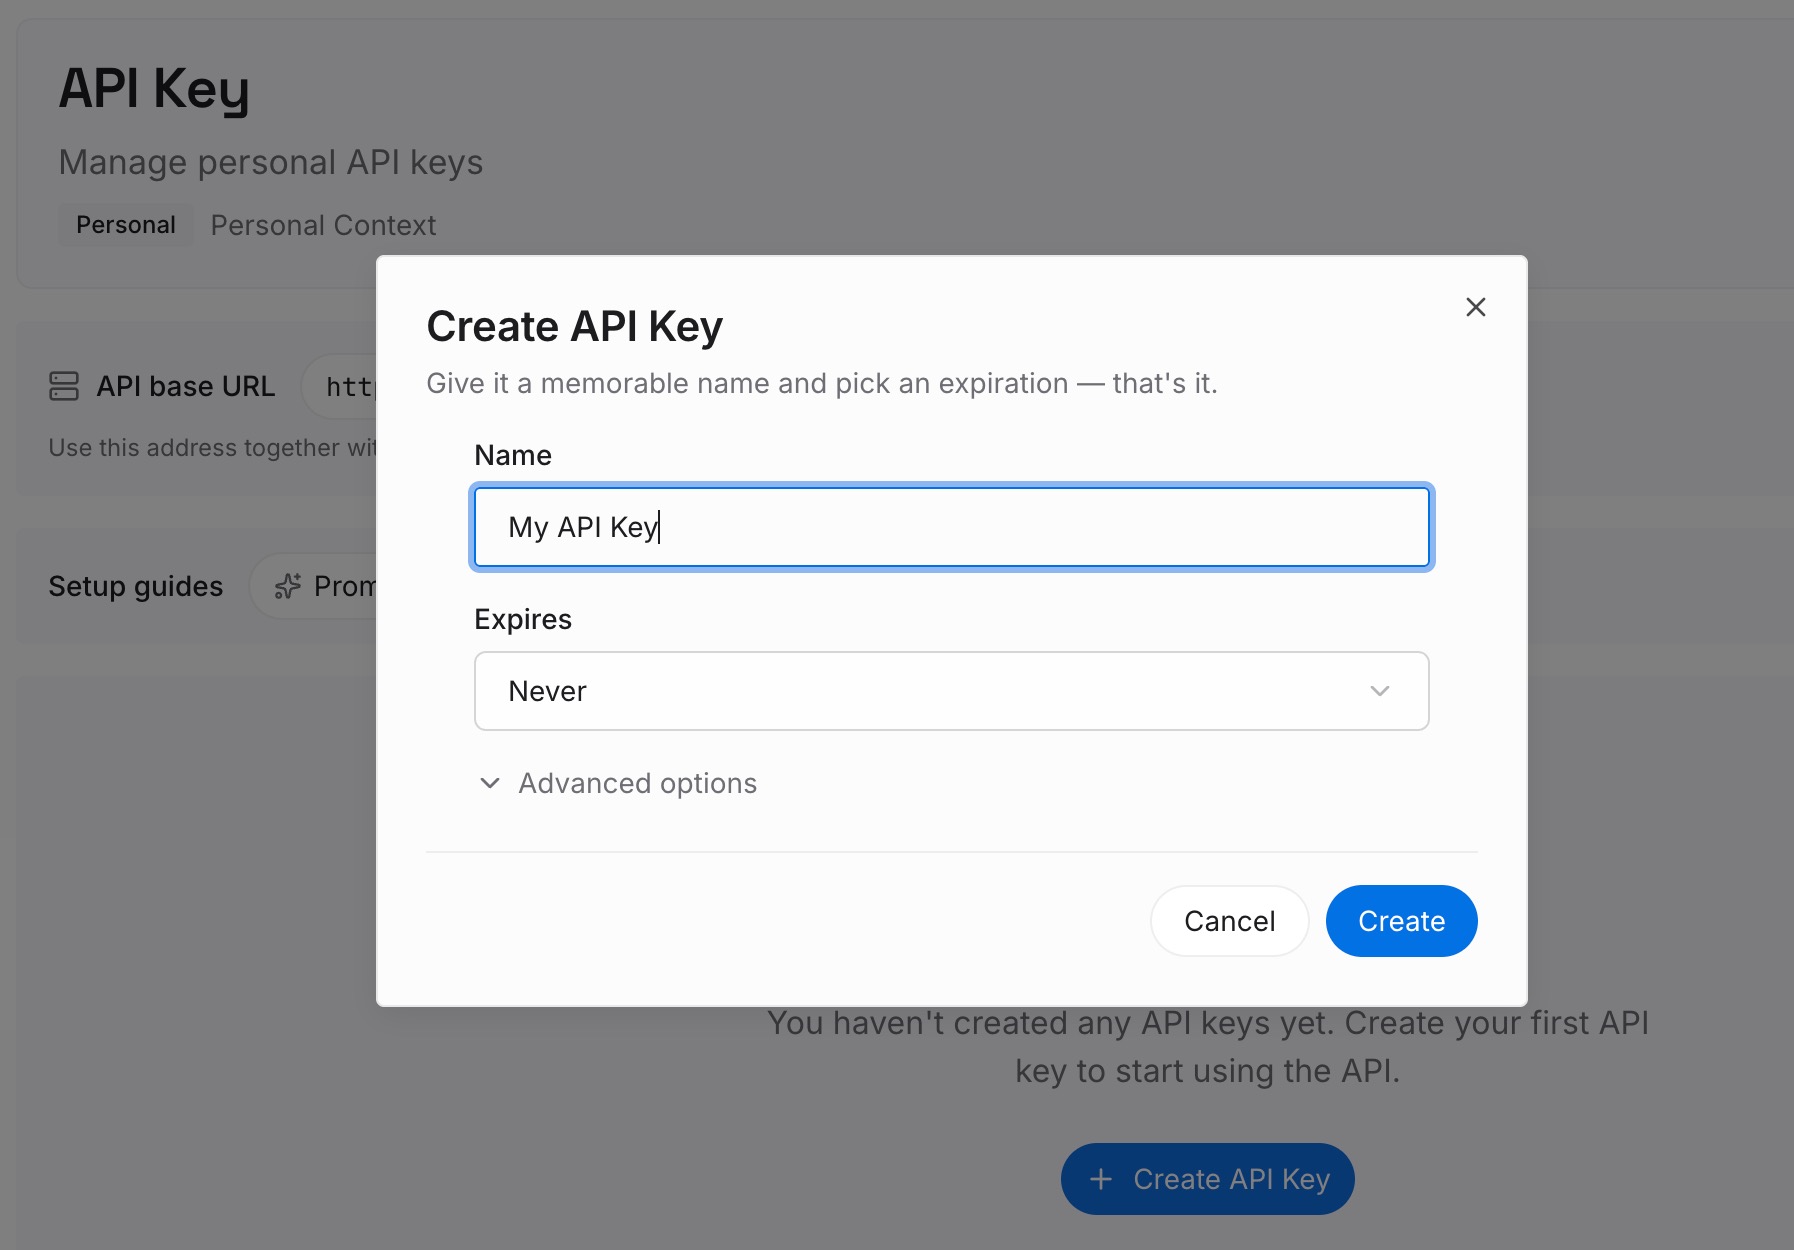
ステップ1:APIキーを作成する
サインインしてダッシュボードからキーを生成します。このキーはMemoryLakeワークスペースに属し、ChatGPTアカウントやCodexの設定とは別個のものです。
ステップ2:最初のメモリをアップロードする
解決策のステップ3で取り出したものから始めましょう。前回のSubagent実行からの発見事項、決定事項、除外されたアプローチなどです。1エントリーにつき1ポイント、日付を入れ、リポジトリのラベルを付けます。
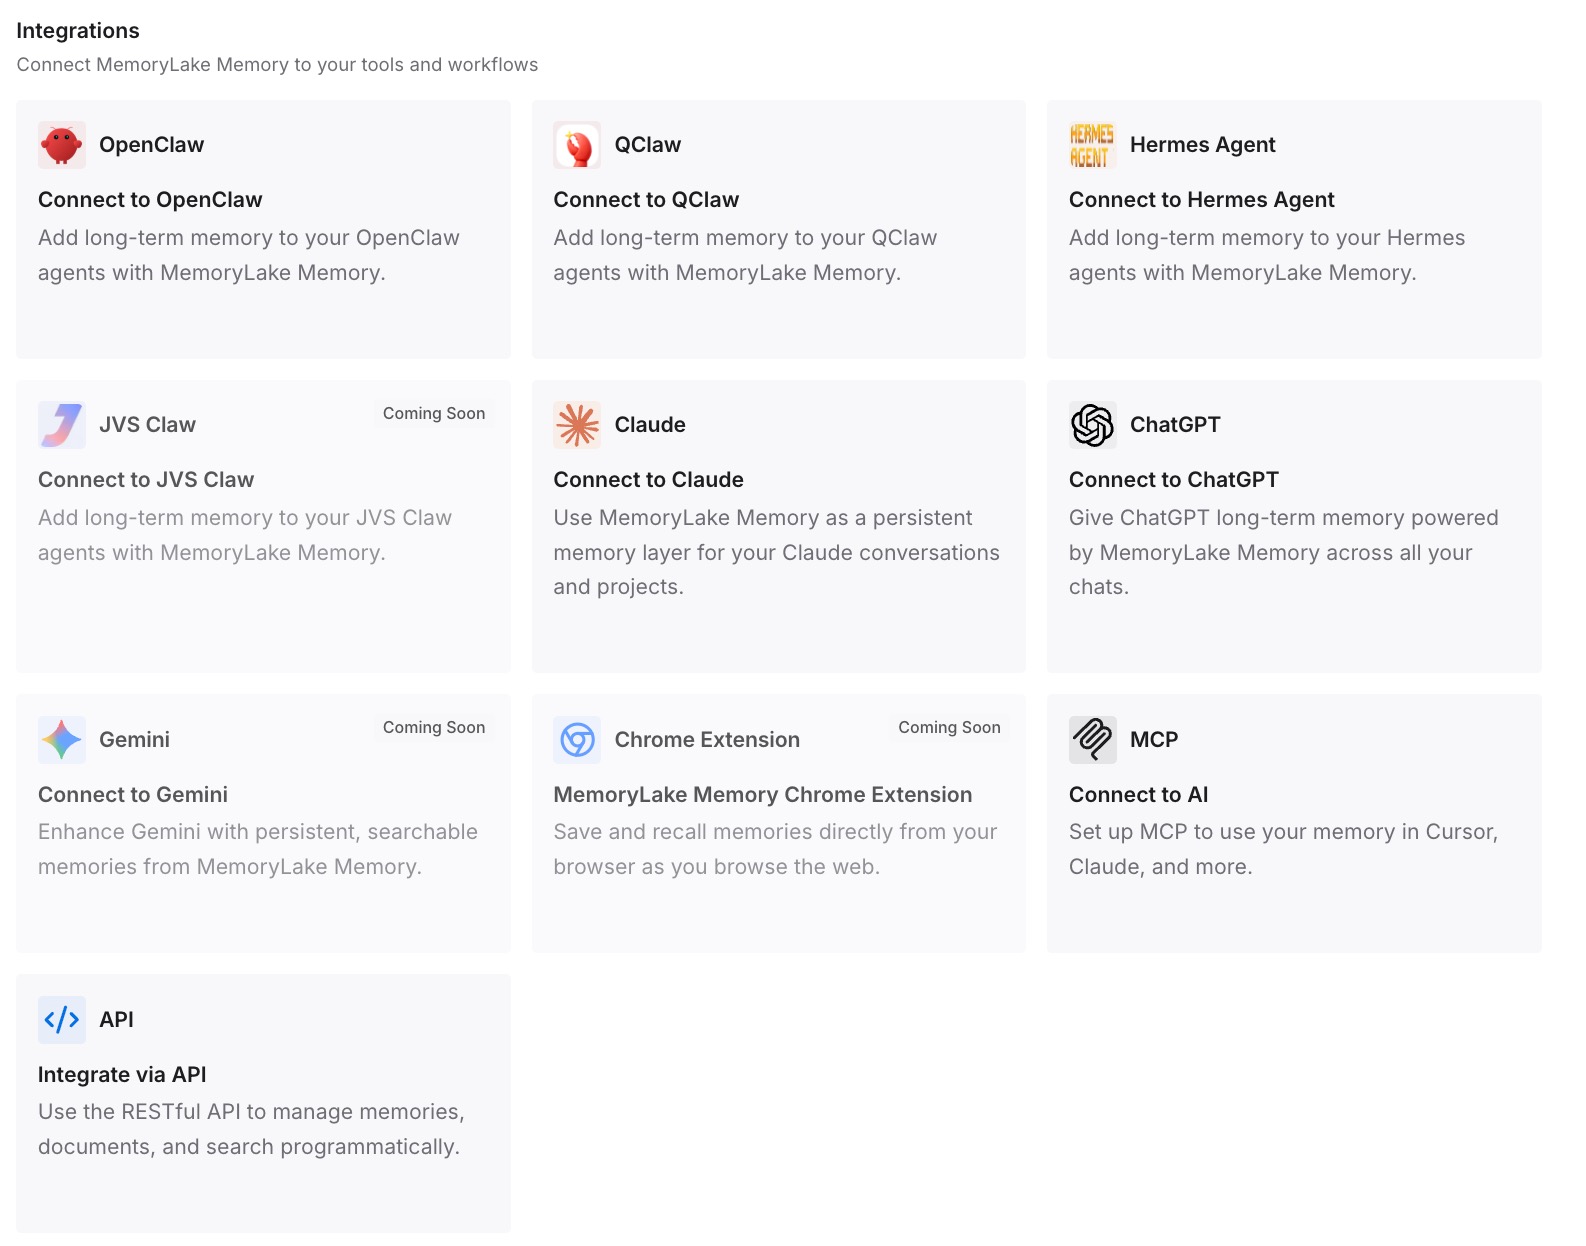
ステップ3:AIとエージェントを接続する
Codexや使用している他のアシスタントを接続します。次のブリーフは、前回の実行で決まった内容から開始できます。
実践で何が変わるか
第一の違いは、Subagentsが情報を得た状態で開始されることです。ブリーフには、継承されていることを期待するのではなく、彼らが必要とする決定事項が含まれます。
第二に、メインチャットが集中した状態に保たれることです。ノイズの多い作業はエージェントスレッドで行われ、メインスレッドには要件、決定事項、および結果が保持されます。
第三に、発見事項が実行後も生き続けることです。Subagentが学んだことは書き留められ、二度と開かないスレッドの中に放置されることはありません。長いセッションが懸念される場合は、CodexにおけるGPT-6.1 Solのデフォルト500kコンテキストに関するガイドで、コンパクション(圧縮)がいつ機能するかを解説しています。
Codex Subagentsのベストプラクティス
明示的に依頼する。 作業の分割方法と何を返すべきかを伝えます。
ブリーフに決定事項を含める。 Subagentはタスクのみで開始される場合があります。
委任する前に権限を設定する。 Subagentsは親ターンから権限を継承します。
並列書き込みよりも並列読み取りを優先する。 探索、テスト、トリアージ、レビューにSubagentsを使用します。
カスタムエージェントを限定的に保つ。 1つのジョブ、明確な指示、適切なモデル。
親でMCPサーバーを設定する。 カスタムエージェントファイルはそれらを上書きできません。
発見事項を保存する。 重要なスレッドを開き、学んだことを書き留めます。
結論
Codex Subagentsは、それぞれが独自のスレッドで並列に動作し、その結果を1つの統合されたレスポンスとしてメインチャットに返す委任されたエージェントです。現在のCodexリリースおよびChatGPT Workではデフォルトで有効になっています。各エージェントは、モデル設定、サンドボックスと承認、MCPサーバー、およびスキルを継承し、会話がフォークされない限り、タスクのみで開始される場合があります。
各Subagentに適切なブリーフを与え、最初に権限を設定し、並列作業は主に読み取り専用に保ち、スレッドが視界から消える前にSubagentsが見つけたものを書き留めておきましょう。