
TokenEconomizer란 무엇인가
Microsoft의 설명: "TokenEconomizer는 에이전트나 기본 모델을 수정하지 않고도 저장소에서의 과거 세션으로부터 학습하여 미래 세션의 낭비를 줄이는 오픈 소스 플러그인입니다."
이것은 플러그인이지 Claude Code나 Codex의 기능이 아닙니다. Anthropic이나 OpenAI가 직접 제공하는 것이 아닙니다. 이미 사용 중인 에이전트에 추가하는 것이며, 에이전트 자체는 그대로 유지됩니다. 프로젝트의 README에 따르면 Claude Code, Codex, GitHub Copilot CLI, Pi를 위한 플러그인이며, 여러 다른 에이전트에 대한 실험적 지원도 포함하고 있습니다.
저장소별로 학습합니다. 학습의 단위는 당신이 계속해서 돌아오는 코드베이스입니다. 블로그는 자체 측정 결과를 토대로 그 이유를 설명합니다. 한 저장소 내에서의 반복된 작업이 다른 저장소의 이력과 일치하는 경우보다 훨씬 더 흔했습니다. 한 프로젝트에서의 경험은 주로 그 프로젝트에만 도움이 됩니다.
따라서 제목의 질문에 대한 정직한 답변은 제한적입니다. Claude Code와 Codex는 스스로 재학습하지 않습니다. 이와 같은 플러그인이 세션에서 일어나는 일을 관찰하고 다음 세션이 시작되는 방식을 바꿀 수 있을 뿐입니다.
학습 내용: 세 가지 종류의 교훈
블로그는 세 가지 메커니즘을 설명합니다. 각각은 과거 세션을 서로 다른 종류의 교훈으로 바꿉니다.
마이크로 스킬(Micro-skills): 저장소 작동 방식에 대한 사실. README는 이를 "세션이 계속해서 재발견하는 것들"로 설명합니다. 예를 들어 "먼저 실행해야 하는 빌드 단계, 여기서 작동하는 명령어의 철자", 명령어에 필요한 환경 변수, 또는 생성된 파일이 위치하는 곳 등입니다. 블로그는 이를 한 줄짜리 메모 형태의 저장소 특정 지식이라고 부릅니다.
도구 가지치기(Tool pruning): 이 저장소에 필요 없는 도구. 로드된 모든 도구의 설명은 모든 요청과 함께 전송됩니다. 이력상 도구가 사용되지 않는 것으로 나타나면, 플러그인은 에이전트 자체 설정을 통해 이후 세션에서 해당 도구를 제외합니다. 명령 실행 및 파일 편집을 위한 핵심 도구는 항상 유지됩니다.
실패 루프 개입(Failure-loop intervention): 턴이 막혔을 때. 에이전트가 동일한 실패를 반복할 때, 판별 모델이 실제로 막혔는지 결정합니다. 그렇다면 에이전트는 다른 접근 방식을 제안하는 짧은 메모를 받게 됩니다.
이 중 첫 번째만이 일상적인 의미의 메모리(memory), 즉 한 세션에서 다음 세션으로 전달되는 사실입니다. 나머지 두 개는 행동에 대한 교훈입니다. 세 가지 모두 동일한 소스에서 나옵니다. 블로그의 표현대로라면, "TokenEconomizer는 세션 로그를 읽고 저장소에 대해 알고 있는 내용을 업데이트합니다."
사실이 신뢰받는 시점을 결정하는 규칙
이 부분은 플러그인 설치 여부와 상관없이 차용할 가치가 가장 높은 설계 요소입니다.
사실은 처음 나타났을 때 바로 추가되지 않습니다. README는 그 임계값을 명시합니다. "사실은 세 번의 세션에서 확인된 후에야 각 세션의 시작 부분에 언급되며, 이후 세션에서 모순될 때 삭제됩니다."
README에 따르면 사실은 두 곳에서 옵니다. "세션 전반에 걸쳐 반복되는 실패"와, 몇 세션마다 최근 세션을 검토하고 사실을 제안하는 모델입니다. 제안 그 자체로는 충분하지 않습니다. 에이전트의 시작 컨텍스트(context)에 도달하기 전에 반복된 증거에 의해 확인되어야 합니다. 그때까지는 아직 형성 중인 사실 목록에 머뭅니다.
블로그는 이 게이트를 다음과 같이 설명합니다. 메모는 "여러 세션이 패턴을 확인한 후에만 에이전트의 시작 컨텍스트에 추가되며, 이후의 증거가 모순되면 해당 메모를 폐기합니다."
이것이 왜 중요할까요? 스스로 개선되는 에이전트를 만드는 뻔한 방법은 세션이 끝날 때 결론 내린 모든 것을 기록하게 하는 것이기 때문입니다. 그 방식에는 알려진 약점이 있습니다. 한 번의 운 좋은 추측이나 잘못된 결론이 모든 미래 세션을 위한 고정 지침이 되어버린다는 점입니다. 반복된 확인이라는 임계값은 이에 대한 직접적인 해답입니다. 한 세션이 스스로 사실을 만들어낼 수는 없습니다.
README는 이를 설계 원칙으로 나열합니다. "사실은 반복된 증거로부터만 형성되고, 도구는 사용되지 않은 후에만 제거되며, 루프 가드는 여전히 진행 중인 턴은 건드리지 않습니다."
사실이 삭제되는 시점
규칙의 나머지 절반도 똑같이 중요합니다. 학습된 사실은 영구적이지 않습니다.
이후 세션이 사실과 모순되면 해당 사실은 삭제됩니다. 팀이 테스트 러너를 변경하면 이전 명령어는 더 이상 확인되지 않고 실패하기 시작하며, 플러그인은 해당 메모를 폐기합니다. README의 어떤 내용도 한때 사실이었다고 해서 영원히 남아있음을 시사하지 않습니다.
동일한 가역성이 다른 메커니즘에도 적용됩니다. README의 원칙은 "모든 작업을 가역적으로 유지하라"이며, 그 의미를 구체적으로 설명합니다. "이후 세션이 모순되는 사실은 삭제되고, 제거된 도구는 다시 되돌릴 수 있으며, 루프 가드는 방향만 재지정하고 알려줄 뿐입니다. 턴을 멈추는 것은 사용자의 몫입니다."
가지치기 된 도구에 대해 README의 설명은 짧습니다. "명령어 하나로 되돌릴 수 있습니다."
막힌 턴에 대해 플러그인의 제한은 명시적입니다. 방향 재지정 후에도 턴이 여전히 막혀 있다면, README는 TokenEconomizer가 중단 방법을 알려줄 뿐 "스스로 턴을 중단하지는 않는다"고 말합니다.
따라서 학습 루프는 양 끝에 브레이크가 있습니다. 사실이 들어오려면 반복된 확인이 필요하고, 나가려면 모순이 필요합니다. 도구 목록은 복구될 수 있습니다. 막힌 턴은 여전히 당신의 결정으로 남습니다.
학습 내용을 보관하는 장소
README는 이에 대해 직접 답변합니다. "학습한 내용은 당신의 컴퓨터의 ~/.tokeneconomizer에 보관됩니다."
블로그도 이 점을 반복합니다. 플러그인은 "학습한 내용을 개발자의 컴퓨터에 보관합니다." 또한 플러그인 자체에는 별도의 API 키가 필요하지 않음을 언급합니다.
이는 몇 가지 실질적인 결과를 가져옵니다.
- 기기별로 적용됩니다. 자신의 노트북에서 동일한 저장소 작업을 하는 팀원은 자신의 세션에서 구축된 자체 사본으로 시작합니다.
- 저장소별로 적용됩니다. 한 코드베이스에서 학습한 내용은 해당 코드베이스를 위해 보관됩니다.
- 에이전트가 이미 읽는 방식을 통해 작동합니다. README에 따르면, "사실은 세션 시작 시 컨텍스트에 진입하고, 도구는 에이전트 자체 설정을 통해 제거되므로 에이전트가 새로운 도구를 배우는 것에 의존하지 않습니다."
사실 제안자나 판별자와 같이 플러그인이 호출하는 모델 또한 당신의 에이전트를 통해 실행됩니다. README는 이들이 "동일한 플랜이나 로그인"에서 실행되며, 그 비용은 플러그인의 보고서에 포함된다고 설명합니다.
학습된 내용을 직접 확인할 수 있습니다. 플러그인의 명령어에는 저장소에서 무엇을 배우고 수행했는지 보여주는 status, 그리고 "주입된 사실과 아직 형성 중인 사실"을 나열하는 microskills가 포함됩니다. Claude Code에서는 /tokeneconomizer: 접두사를 붙여 명령어를 입력하며, Codex에서는 $tokeneconomizer:를 사용합니다.
기본적으로 켜져 있는 것과 그렇지 않은 것
메모리 부분이 즉시 작동하기를 기대한다면 이 점이 중요합니다.
도구 가지치기와 루프 가드는 기본적으로 켜져 있습니다. 사실을 학습하는 부분인 마이크로 스킬은 그렇지 않습니다. README는 그 이유를 설명합니다. "마이크로 스킬은 기본적으로 꺼져 있습니다. 제안자가 모델 호출을 추가하며, 절약되는 양은 저장소와 그곳에서 수행하는 작업에 따라 다르기 때문입니다."
플러그인의 config 명령어를 사용하여 저장소별로 또는 모든 저장소에 대해 이를 켤 수 있습니다. 모델 호출 없이 반복된 실패로부터만 사실을 배우는 더 가벼운 모드도 있습니다.
Claude Code에는 옵션이 하나 더 있습니다. README에 따르면: "Claude Code에서 플러그인은 저장소의 이전 세션으로부터도 학습할 수 있으며, Claude Code의 자체 로그를 오래된 순서대로 모델 호출 없이 읽습니다. 이는 기본적으로 꺼져 있습니다." 플러그인이 저장소의 어떤 세션으로부터도 학습하기 전에만 해당 이력을 읽으므로, 설치 직후에 켜도록 설계되었습니다.
배우지 않는 것
README를 자세히 읽어보면 경계가 명확합니다.
이유를 배우지 않습니다. 마이크로 스킬은 한 줄짜리 사실입니다(이 단계를 먼저 실행하라, 이 명령어 철자를 사용하라). 설계 선택 뒤에 숨겨진 추론, 어떤 접근 방식을 취할지에 대한 대화, 또는 지난달에 팀이 내린 결정 등은 이 메커니즘이 포착하도록 설계된 종류의 것이 아닙니다.
한 번의 세션에서 배우지 않습니다. 확인 임계값은 오늘 어렵게 배운 교훈이 이 플러그인을 통해 내일의 세션에 도달하지 않음을 의미합니다. 반복이 필요합니다.
도구 간에 자동으로 공유되지 않습니다. 명령어와 저장소는 기기별로 관리됩니다. 동일한 저장소에서 Claude Code를 한 작업에 사용하고 Codex를 다른 작업에 사용할 때, 두 호스트가 학습된 내용을 어떻게 공유하는지는 README에 자세히 설명되어 있지 않으므로 동일한 사실을 본다고 가정하지 않는 것이 안전합니다.
지침 파일을 대체하지 않습니다. 사실은 CLAUDE.md나 AGENTS.md와 같이 에이전트가 이미 로드하는 내용과 함께 세션 시작 시 언급됩니다. 해당 파일들은 팀이 합의한 컨벤션이 있어야 할 자리에 그대로 유지됩니다.
Claude Code는 또한 에이전트가 스스로 작성하는 자체 내장 메모리 기능을 가지고 있습니다. 우리는 Claude Code 자동 메모리란 무엇인가 가이드에서 그 작동 방식을 다루었습니다.
테스트된 버전
README는 각 에이전트에 대해 테스트된 버전 범위를 나열합니다: Claude Code 2.1.300 ~ 2.1.310, Codex 0.153.1 ~ 0.164.0. 또한 "최신 버전은 아직 테스트되지 않았다"고 덧붙입니다.
두 에이전트 모두 해당 범위를 벗어난 릴리스를 출시했습니다. 이것이 플러그인이 해당 버전에서 실패한다는 의미는 아니며, 단지 저자들이 테스트 완료 목록에 넣지 않았음을 의미합니다. 최신 릴리스에서 시도해 본다면, 몇 세션 후에 status를 확인하여 예상대로 기록되고 있는지 확인하십시오.
특히 Codex의 경우, 플러그인 후크(hook)가 실행되기 전에 신뢰 설정이 필요하며, README는 후크가 다음 Codex 세션부터 적용된다고 명시합니다.
시간에 따른 학습에 관한 연구 결과
블로그는 테스트된 모든 저장소에서 작업 성공률이 대체로 안정적으로 유지되는 동안 비용이 감소했다고 보고합니다. 이 가이드에서 더 흥미로운 발견은 곡선의 모양입니다. "경험이 쌓일수록 절약 효과가 커집니다."
저장소에서의 초기 세션은 플러그인이 학습하는 동안 비용이 더 많이 들 수 있습니다. 블로그의 Claude Code 결과에서 모든 저장소는 여섯 번째 작업쯤에 기본값보다 저렴해졌습니다. 이는 반복된 증거를 기다리는 설계에서 예상할 수 있는 결과입니다. 즉, 잘못된 교훈을 줄이기 위해 느린 시작을 선택한 것입니다.
연구원들은 또한 고정된 전략이 모든 곳에서 작동하지 않는다는 것을 발견했습니다. 그들이 테스트한 다른 세 개의 오픈 소스 플러그인은 각각 고정된 비용 절감 접근 방식을 중심으로 구축되었는데, 일부 저장소에서는 도움이 되었지만 다른 곳에서는 그렇지 않았습니다. 그들의 결론은 비용 제어가 저장소에 적응해야 한다는 것이었으며, 이것이 모든 것이 코드베이스별로 학습되는 이유입니다.
Anthropic도 반대편 입장에서 동일한 긴장 관계에 대해 쓴 적이 있습니다. 상시 가동형(always-on) 에이전트에 대한 지침에 따르면, 메모리는 에이전트가 다시 쉽게 찾아볼 수 없는 내용만 보유해야 한다고 합니다. 이는 상시 가동형 에이전트란 무엇인가 가이드에서 다루었습니다.
사람들이 흔히 하는 실수
에이전트가 스스로 학습하기를 기대함. Claude Code와 Codex는 당신의 세션을 통해 재학습하지 않습니다. 세션 간의 학습은 메모리 기능과 이와 같은 플러그인에서 나옵니다.
모든 것을 켜고 사실이 나타나길 기다림. 마이크로 스킬은 기본적으로 꺼져 있습니다. 아무것도 학습되지 않았다고 결론 내리기 전에 config를 확인하십시오.
매 세션 후 모든 결론을 기록함. 이는 확인 임계값이 피하도록 설계된 방식입니다.
학습된 사실이 영구적이라고 가정함. 모순되는 사실은 삭제되며, 가지치기 된 도구는 복구될 수 있습니다.
플러그인이 결정을 보유하기를 기대함. 플러그인은 선택 뒤의 추론이 아니라 저장소 작동 방식에 대한 한 줄짜리 사실을 보유합니다.
해결책: 교훈이 스스로 자격을 증명하게 하세요
1단계: 유지하고 싶은 교훈의 종류를 결정하세요
저장소에 대한 사실(명령어, 설정 단계)과 결정(왜 그 접근 방식을 선택했는지)을 분리하세요. 이들은 서로 다른 보관 장소가 필요합니다.
2단계: 교훈이 지침이 되기 전에 반복된 증거를 요구하세요
플러그인이 쓰든 사람이 쓰든, 모든 세션이 로드하는 내용에 추가하기 전에 교훈이 한 번 이상 유효했는지 확인될 때까지 기다리세요.
3단계: 모든 교훈에 퇴로를 마련하세요
사실이 더 이상 참이 아니게 되면 제거하세요. 학습된 사실과 지침 파일을 정기적으로 검토하세요.
4단계: 결정 사항은 직접 기록하세요
선택 뒤의 추론은 반복된 실패로 나타나지 않습니다. 미래의 세션이 사용할 수 있는 언어로 의도적으로 기록하세요.
MemoryLake에서 설정하기
TokenEconomizer는 저장소가 어떻게 행동하는지 배웁니다. 어떤 접근 방식을 선택했는지, 어떤 것을 배제했는지, 그리고 그 이유와 같은 작업 뒤의 결정은 이를 알고 있는 누군가에 의해 기록되어야 합니다.
MemoryLake는 결정, 컨벤션, 검증된 교훈과 같은 프로젝트 컨텍스트를 위한 메모리 레이어입니다. 사용자가 관리하는 한 곳에 보관되며 ChatGPT, Claude Code, Codex 등 연결된 어시스턴트가 사용할 수 있습니다.
항목은 자신의 언어로 직접 작성합니다. ~/.tokeneconomizer, 세션 로그, 에이전트 설정, CLAUDE.md 또는 AGENTS.md 파일, 혹은 어떤 벤더의 저장소에서도 내용을 읽거나 쓰거나 삭제하지 않습니다. TokenEconomizer와 각 에이전트의 자체 메모리는 해당 저자들이 설명한 방식대로 작동합니다.
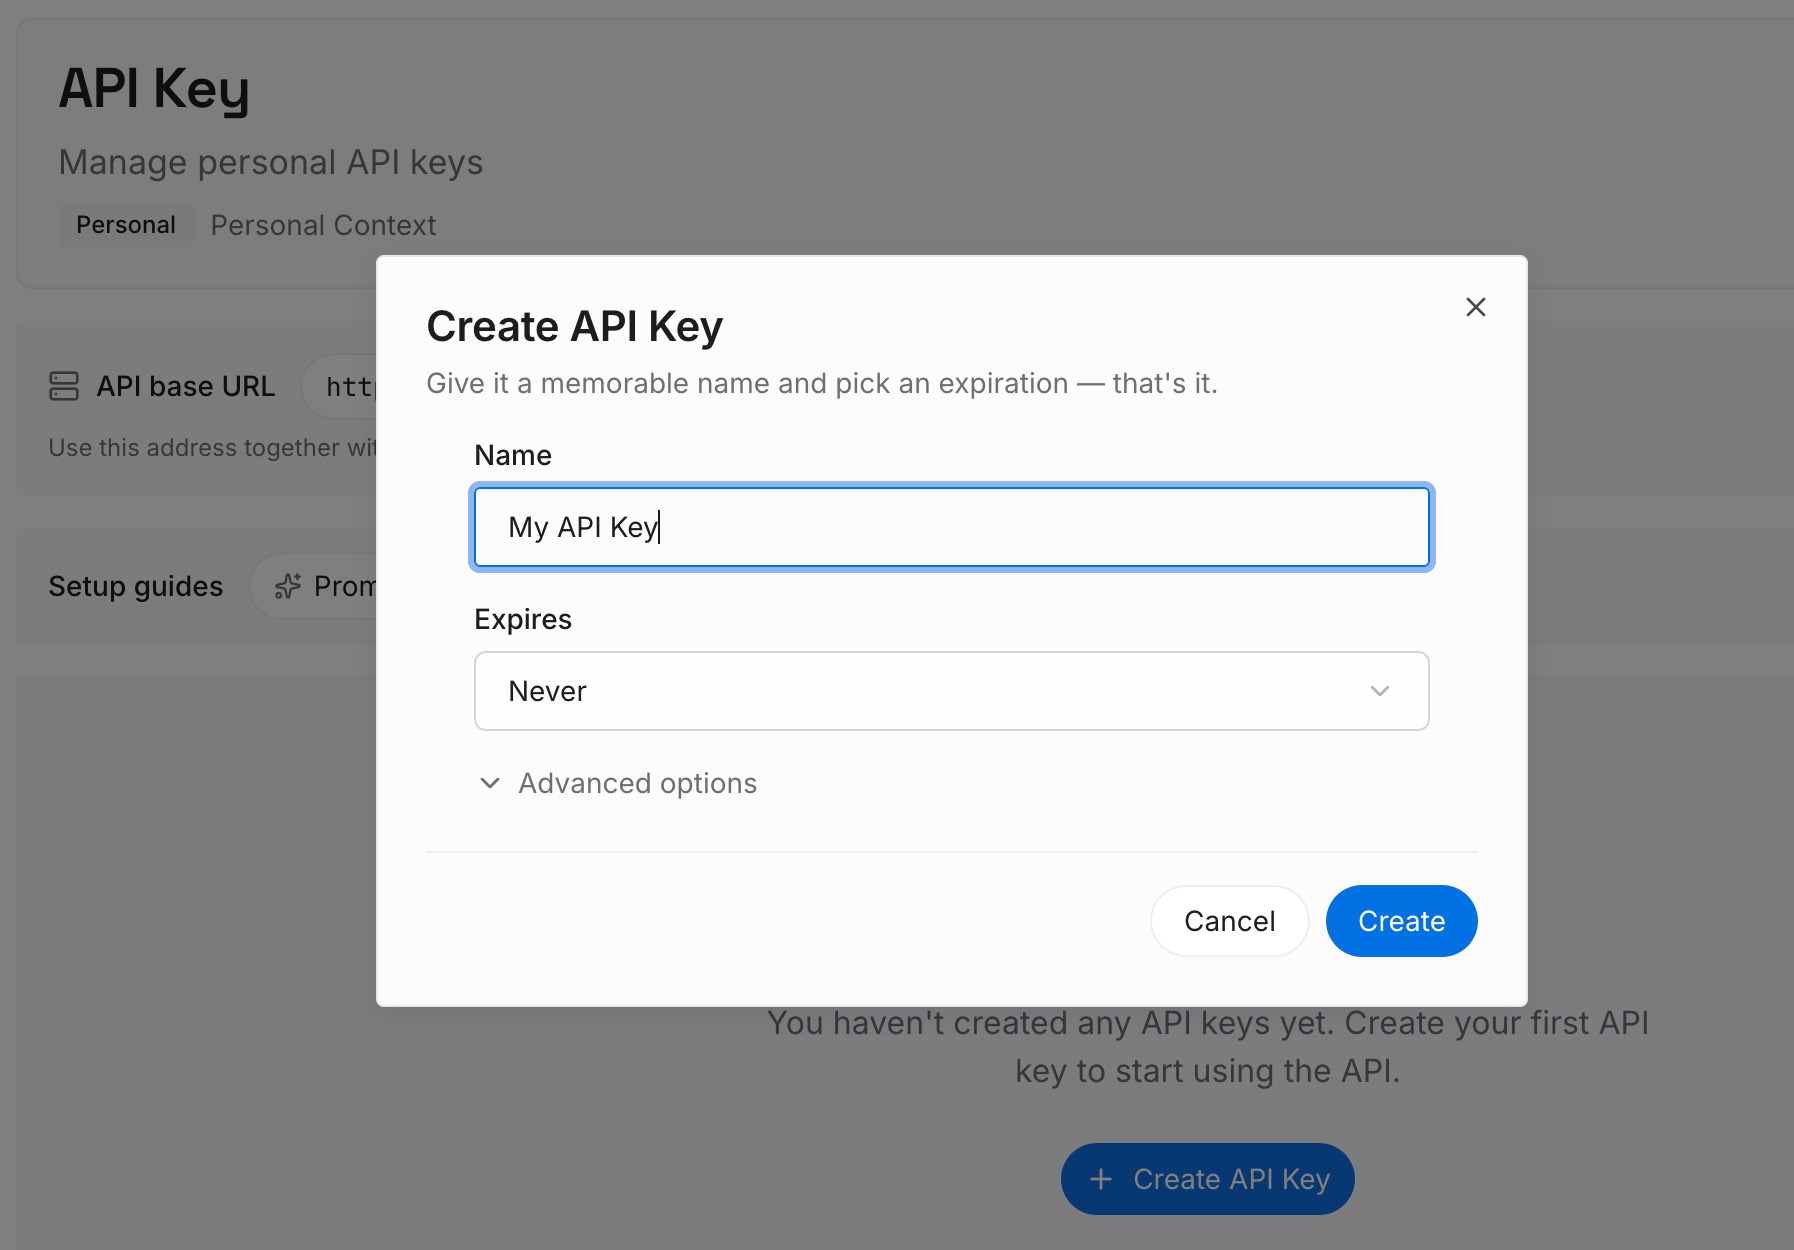
1단계: API 키 생성
로그인 후 대시보드에서 키를 생성합니다. 다른 자격 증명과 마찬가지로 저장소 외부에 보관하세요.
2단계: 첫 번째 메모리 업로드
해결책의 4단계에서 작성한 내용부터 시작하세요: 최근 세션의 결정 사항과 그 이유입니다. 항목당 하나의 결정을 날짜와 함께 기록하세요.
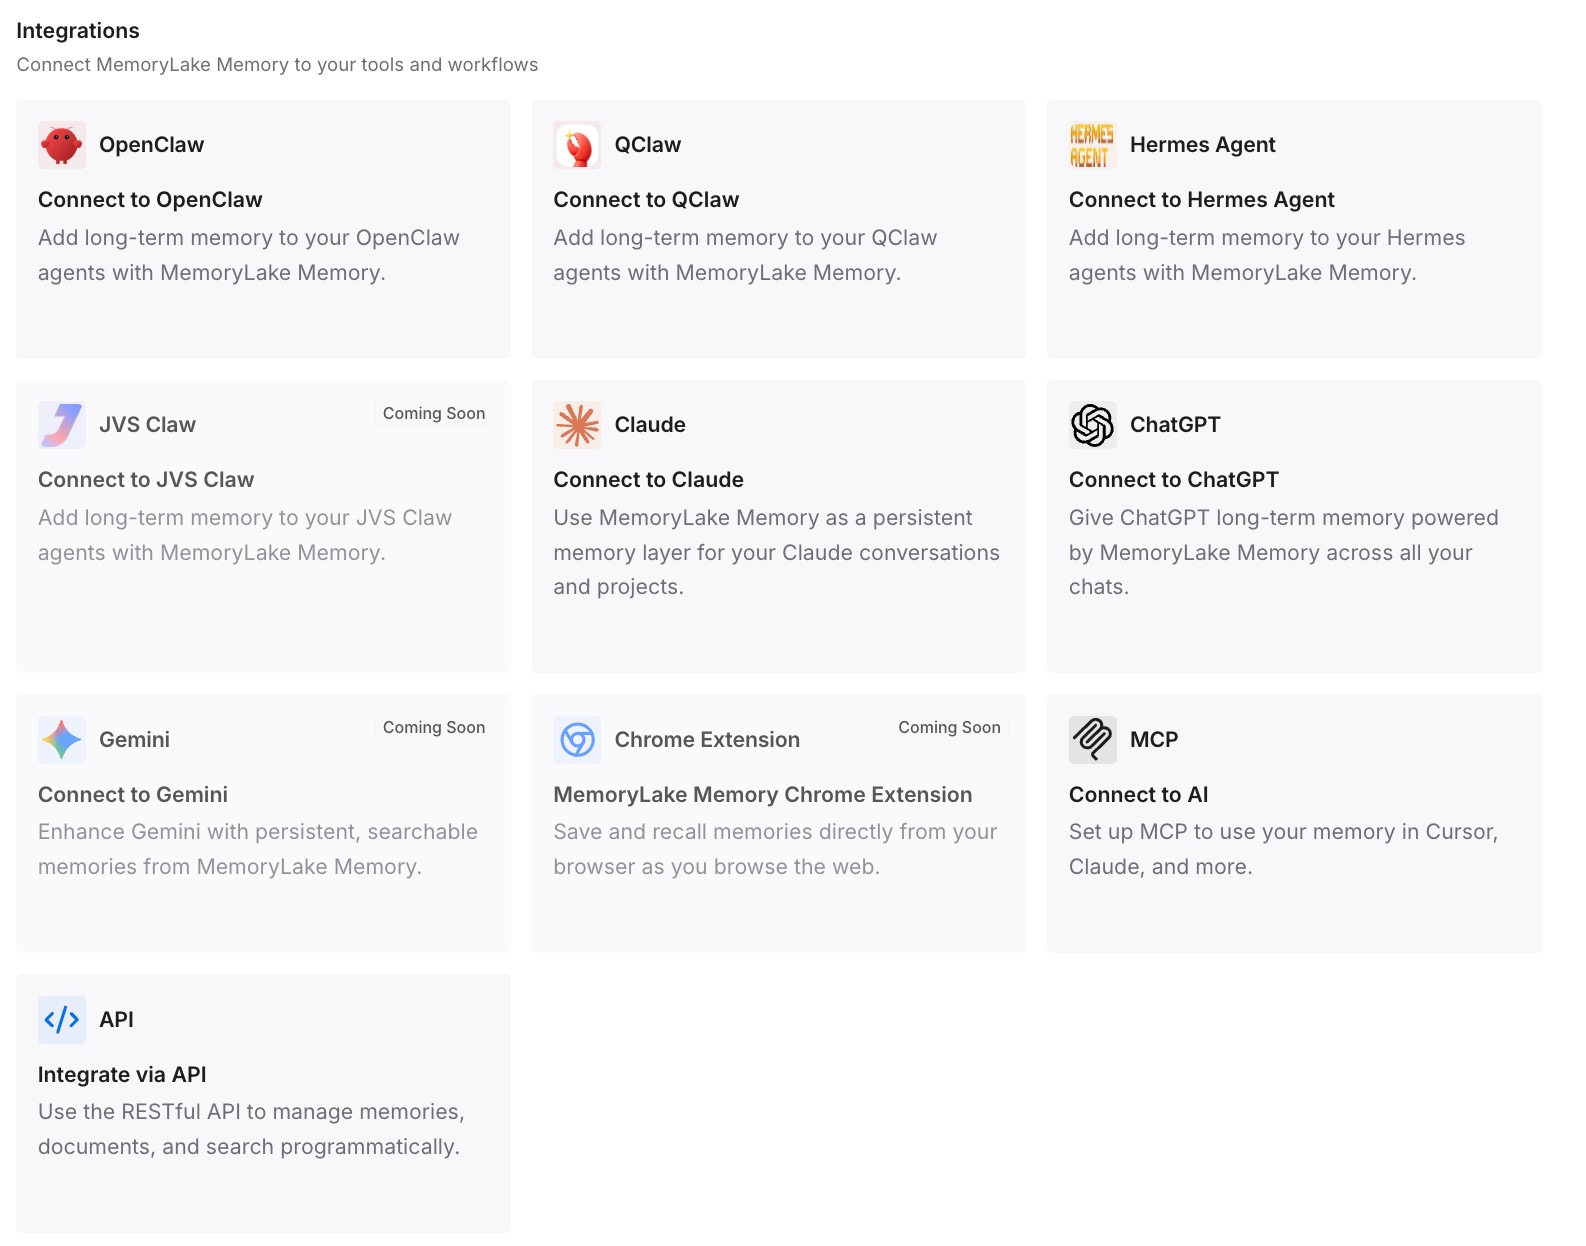
3단계: AI 및 에이전트 연결
Claude Code, Codex 및 사용하는 다른 어시스턴트를 연결하세요. 각각 동일한 결정 사항을 활용할 수 있습니다.
실제로 바뀌는 것
첫 번째 차이점은 더 깔끔한 분리입니다. 저장소에 대한 반복된 사실은 자동으로 학습될 수 있고, 결정 사항은 사람이 작성합니다.
두 번째는 잘못된 교훈이 줄어든다는 점입니다. 당신이 기록한 결정은 단일 세션에서 유추된 것이 아니라 당신이 확인한 것입니다.
세 번째는 도구와 기기 간의 연속성입니다. 작업 뒤의 이유는 한 노트북의 플러그인 데이터에 묶이지 않습니다.
스스로 개선되는 코딩 에이전트를 위한 모범 사례
저장소별로 학습하세요. 연구에 따르면 경험은 주로 동일한 코드베이스 내에서 도움이 되었습니다.
신뢰하기 전에 확인하세요. 교훈은 모든 세션이 로드하기 전에 여러 세션에 걸쳐 검증되어야 합니다.
가역성을 유지하세요. 학습된 모든 사실은 삭제될 방법이 필요합니다.
설정을 확인하세요. TokenEconomizer에서 마이크로 스킬은 기본적으로 꺼져 있습니다.
학습된 내용을 살펴보세요. 플러그인의 microskills 명령어를 사용하여 주입된 사실과 형성 중인 사실을 확인하세요.
컨벤션은 지침 파일에 보관하세요. CLAUDE.md와 AGENTS.md는 합의된 규칙을 위한 장소로 남겨두세요.
결정 사항을 의도적으로 기록하세요. 그것들은 반복된 실패로 나타나지 않을 것입니다.
결론
Claude Code와 Codex는 스스로 재학습하지 않지만, 플러그인은 다음 세션이 시작되는 내용을 바꿀 수 있습니다. Microsoft의 TokenEconomizer는 과거 세션 로그로부터 저장소별로 학습합니다: 한 줄짜리 사실, 사용되지 않는 도구, 막힌 턴 등입니다. 사실은 세 번의 세션이 확인한 후에야 시작 컨텍스트에 도달하며, 이후 세션에서 모순되면 삭제됩니다. 모든 것은 당신의 컴퓨터 ~/.tokeneconomizer에 보관되며, 사실 학습 부분은 기본적으로 꺼져 있습니다.
이 설계는 스스로 개선되는 모든 설정에 유용한 모델입니다. 반복된 증거를 요구하고, 모든 교훈에 퇴로를 마련하며, 결정 뒤의 추론은 직접 관리하는 곳에 보관하세요.