
xAI가 실제로 발표한 내용
이 메커니즘은 세 부분으로 설명되며, 각 부분에는 명확한 경계가 설정되어 있습니다.
Capture(캡처). "턴이 완료되면 Grok은 백그라운드에서 이를 검토하고 컨벤션, 결정 사항, 프로젝트 사실 등 지속성 있는 정보를 기록합니다. 캡처는 완료된 모든 턴에서 실행되며 세션을 방해하지 않습니다." 즉, 기록은 턴이 완료된 후 사후에 자동으로 이루어집니다. 턴 중간에는 아무것도 기록되지 않으며, 사용자에게 묻지도 않습니다.
Storage(저장). "노트는 주제별로 하나의 토픽을 다루는 마크다운 파일입니다. 각 프로젝트는 고유한 워크스페이스 범위를 가지며, 글로벌 범위는 모든 곳에 적용되는 기본 설정을 보관합니다." 디스크 상의 일반 파일로 존재하는 두 가지 범위입니다. /memory라는 명령은 "범위별로 그룹화된 모든 memory 파일의 읽기 전용 브라우저를 열고 선택한 파일의 미리보기를 제공"하며, 두 번째 명령인 /dream은 "새로운 관찰 결과를 해당 토픽에 병합"하고 "백그라운드에서 주기적으로 자동 실행"됩니다.
Recall(회상). "관련 작업을 시작하기 전에 Grok은 해당 영역을 다루는 토픽을 읽고 적용하며, 이는 해당 주제가 전혀 언급되지 않은 세션에서도 마찬가지입니다." 그리고 우선순위 규칙이 한 줄로 명시되어 있습니다. "현재 대화의 지침은 노트의 그 어떤 내용보다 우선합니다."
이어서 범위에 대한 전체 설명입니다. "Memory는 이후 세션에서 가장 중요할 가능성이 높은 세부 정보들을 보관합니다. 팀이 코드를 작성하고 검토하는 방식, 결정 사항과 그 배경이 되는 논리, 하위 시스템의 위치부터 테스트 스위트를 실행하는 명령에 이르기까지 프로젝트에 대한 지속성 있는 사실들이 이에 해당합니다. 작업 상태, 잠정적 결론, 비밀 정보, 그리고 저장소나 관련 문서가 이미 다루고 있는 모든 것은 제외됩니다."
발표 자료의 제품 스크린샷에서 쉽게 지나치기 쉬운 세부 정보가 하나 더 있습니다. 생성된 인덱스 파일에는 "Generated by Grok. Do not edit this file directly.(Grok이 생성한 파일입니다. 이 파일을 직접 수정하지 마십시오.)"라는 줄이 포함되어 있습니다.
출시 여부는 모호함 없이 명확하게 밝히고 있습니다. "Memory 기능은 지금 Grok Build에서 바로 사용할 수 있습니다. 새로운 세션에 적용됩니다. /new를 실행하거나 새로운 grok을 시작하면 첫 번째 턴이 완료된 후 노트 기록이 시작됩니다."
이 기능이 바꾸는 것과 바꾸지 못하는 것
이 기능은 단일 프로젝트 내에서 연속성을 유지하는 비용을 변화시킵니다. 만약 팀이 언어 자체의 테스트 명령 대신 래퍼(wrapper)를 통해 테스트 스위트를 실행한다면, 이는 정확히 이 기능이 보관하도록 설계된 지속성 있는 프로젝트 사실에 해당하며, 발표 자료에 나온 예시가 바로 이것입니다. 매 세션마다 이를 반복해서 설명하는 것은 순전한 오버헤드였으나, 이제는 그렇지 않습니다.
진행 중이던 작업의 상태는 달라지지 않습니다. 제외 목록의 첫 번째 항목은 바로 "작업 상태(Task state)"입니다. 마이그레이션 도중에 터미널을 닫으면, 노트에는 팀이 마이그레이션을 작성하는 방식은 기록되겠지만, 7단계 중 4단계를 진행 중이었고 아직 변환해야 할 파일이 2개 남아 있다는 사실은 기록되지 않습니다. 이는 의도된 설계이자 충분히 납득할 만한 결정입니다. 반쯤 끝난 상태는 프로젝트의 그 어떤 것보다 빠르게 쓸모없어지기 때문입니다. 하지만 이는 사람들이 기대하는 "에이전트가 우리가 어디까지 했는지 기억한다"는 느낌과는 정반대입니다.
아직 최종 결정에 도달하지 못한 결론의 운명도 바꾸지 못합니다. 두 번째 항목은 "잠정적 결론(Tentative conclusions)"입니다. 화요일에 에지(edge)에서 캐싱할지 서비스에서 캐싱할지 혼자 고민하다가 "아마도 서비스 쪽이겠지, 일단 두고 보자"로 끝난 논의가 있다면, 이는 다음 주에 가장 필요할 만한 논리이면서도 동시에 아직 지속성이 없다는 이유로 필터링되어 제외될 가능성이 가장 높은 논리입니다.
저장소를 복제하지도 않습니다. "저장소나 관련 문서가 이미 다루고 있는 모든 것은 제외된다"는 합리적인 규칙은 문제를 조용히 다른 곳으로 옮겨놓습니다. 즉, 문서가 다루는 모든 영역에 대해 memory의 완성도는 오직 문서의 완성도만큼만 보장된다는 뜻입니다. README 파일이 잘못되어 있다면, 노트의 그 어떤 내용도 이를 바로잡아 주지 않습니다.
또한 비밀 정보를 보관하지 않는데, 이는 당연한 일이며 이견의 여지가 없습니다.
이 중 그 어떤 것도 결함이 아닙니다. xAI는 사과해야 할 한계를 설명하는 것이 아니라, 출시 페이지에서 기록 정책(write policy)을 미리 명시하고 있는 것입니다. 이는 대부분의 memory 기능이 알려주는 것보다 훨씬 더 많은 정보입니다. 이에 대한 유용한 반응은 기능에 대해 회의적인 태도를 취하는 것이 아니라, 이제 어떤 네 가지 카테고리가 다른 곳에 보관되어야 하는지 인지하고, 3주 후에나 그 공백을 발견하는 대신 미리 의도적으로 그 보관처를 마련하는 것입니다.
사람들이 오해하기 쉬운 사실들
"에이전트가 내가 멈춘 지점부터 이어서 작업할 것이다." 에이전트는 당신의 컨벤션과 결정 사항을 이어받을 뿐입니다. 당신이 멈춘 지점은 '작업 상태'에 해당하며, 작업 상태는 명시적으로 제외 대상입니다.
"이제 기록하는 일을 그만두어도 된다." 단일 저장소 내의 컨벤션과 프로젝트 사실에 대해서는 대체로 그렇습니다. 하지만 제외 목록에 있는 모든 항목과 다른 도구 또는 다른 기기에서 읽을 수 있어야 하는 모든 것에 대해서는 아닙니다. 노트는 프로젝트별, 설치 환경별로 관리됩니다.
"내가 말하는 모든 것이 기억될 것이다." 캡처는 "완료된 모든 턴에서 실행"되지만, 기록하는 것은 "지속성 있는 정보"에 한합니다. '지속성' 여부는 모델이 사용자의 턴에 대해 내리는 판단입니다. 발표 자료는 특정 발언이 반드시 보관된다고 보장하지 않으며, 인덱스 파일의 헤더 자체도 이 파일이 직접 작성된 것이 아니라 자동 생성된 것임을 명시하고 있습니다.
"노트의 내용이 프롬프트와의 우선순위 싸움에서 이길 것이다." 그렇지 않으며, 이것이 올바른 설계입니다. "현재 대화의 지침은 노트의 그 어떤 내용보다 우선합니다." 만약 노트가 잘못되었다면, 지금 입력하는 내용이 해당 세션 동안 노트를 덮어씁니다. 하지만 파일을 직접 수정하기 전까지는 내일도 여전히 잘못된 노트가 적용될 것입니다.
"Skills 기능과 동일하다." 메커니즘도 다르고 트리거도 다릅니다. 저희는 what Grok Skills mean for reusable AI memory에서 그 경계를 그렸으며, 보다 일반적인 차이점은 why agent skills are not memory에서 다루었습니다. Skills는 사용자가 호출하는 기능(capabilities)인 반면, 이 노트들은 사용자에 대해 기록된 관찰 결과(observations)입니다.
해결책: 제외된 네 가지 카테고리의 보관처 마련하기
제외 목록은 일종의 사양(specification)입니다. 사양으로 취급하십시오.
1단계: 잠정적 결론은 직접 기록하기
잃어버렸을 때 가장 큰 비용이 드는 카테고리는 당시에는 가장 중요하지 않아 보이는 것, 즉 도달했으나 아직 확정하지 않은 결론입니다. "이 부분은 샤딩하지 않을 것 같다." "재시도 로직은 괜찮고, 타임아웃이 문제다." 이러한 내용들은 커밋 메시지에 절대 들어가지 않고 문서화하기에는 너무 임시적이며, 설계상 캡처 대상에서 제외됩니다.
날짜와 이유를 포함하여 서술형 문장으로 기록해 두십시오. 각각 한 줄이면 충분합니다. 결론보다 이유가 더 중요합니다. 왜냐하면 그 이유를 알아야 다음 달에 그 결론이 여전히 유효한지 판단할 수 있기 때문입니다.
2단계: 작업 상태를 위한 인수인계 한 줄 남기기
작업 중간에 세션을 닫기 전에, 작업 상태 제외로 인해 그 누구도 대신 적어주지 않을 그 한 줄을 직접 작성하십시오. 무엇을 하고 있었는지, 무엇이 완료되었는지, 다음 단계는 무엇인지 적는 것입니다. 15초밖에 걸리지 않지만, 나중에 diff를 보며 상황을 복구하는 데 소요될 10분을 아껴줍니다.
이것은 기능에 대한 비판이 아닙니다. 수개월 동안 유지되는 저장소에서 작업 상태를 제외하는 것은 올바른 결정입니다. 다만 인수인계 사항은 사용자가 직접 작성해야 함을 의미하며, 나중에 찾지 못할 임시 파일에 적는 것보다 지속성 있는 곳에 기록해 두는 것이 훨씬 낫습니다.
3단계: 도구를 벗어나서도 유지되어야 할 사실 결정하기
노트는 단일 기기, 단일 제품 내에서 프로젝트 및 글로벌 범위로 관리되는 마크다운 파일입니다. 모든 작업이 그 안에서만 이루어진다면 그것으로 충분합니다. 하지만 이러한 환경을 벗어나서도 유지되어야 하는 사실들은 다음 분기에 다른 기기에서 다른 어시스턴트에게 다시 설명해야 할 것들입니다. 아키텍처 결정, 소유권, 어색한 설계의 이유가 되는 제약 조건 등이 이에 해당합니다.
이는 세션 연속성과는 다른 요구사항이며, 어떤 사실이 어디에 해당하는지 명확히 구분하는 것이 좋습니다. 저희는 how much memory you should actually give an agent에서 적정 크기에 대한 문제를 다룬 바 있습니다.
MemoryLake에서 설정하기
이 세 단계는 모두 동일한 대상을 설명합니다. 즉, 대화 기록에서 유추된 것이 아니라 사용자가 의도적으로 보관하기로 결정한 사실입니다. MemoryLake는 사용자가 이러한 사실들을 직접 기록하는 저장소로, 어떤 도구에서 생성된 사실인지와 무관하게 연결된 모든 어시스턴트에서 읽을 수 있습니다. 사용자가 자신의 언어로 직접 항목을 작성합니다. xAI의 시스템이나 다른 벤더의 저장소에서 데이터를 읽거나, 쓰거나, 삭제하지 않으므로 Grok Build 노트는 전적으로 Grok Build 자체의 제어 하에 유지됩니다.
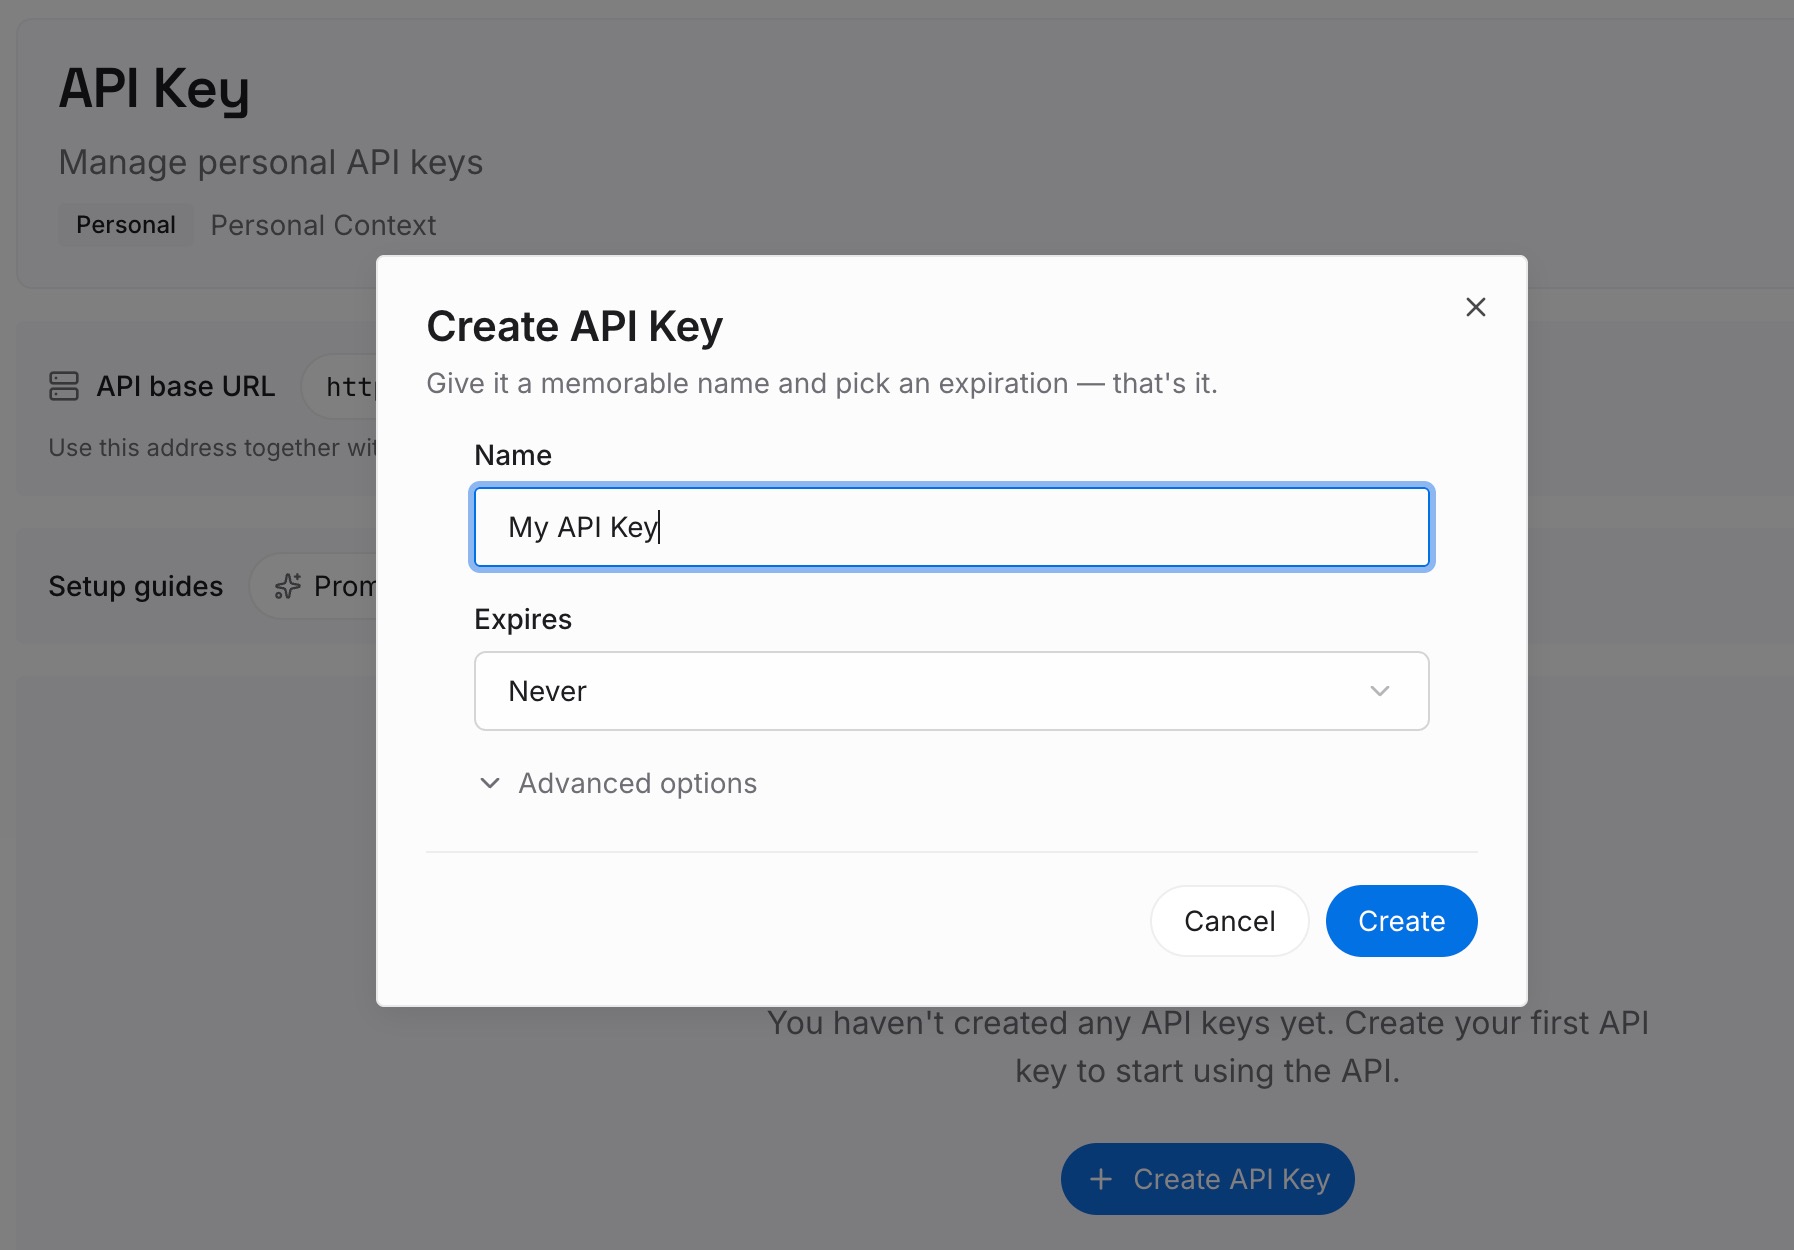
1단계: API 키 생성하기
대시보드에서 키를 생성합니다. 이 키를 통해 코딩 에이전트, 채팅 어시스턴트, 그리고 다음 분기에 사용할 그 어떤 도구라도 동일한 사실 집합에 접근할 수 있게 됩니다.
2단계: 첫 번째 memory 업로드하기
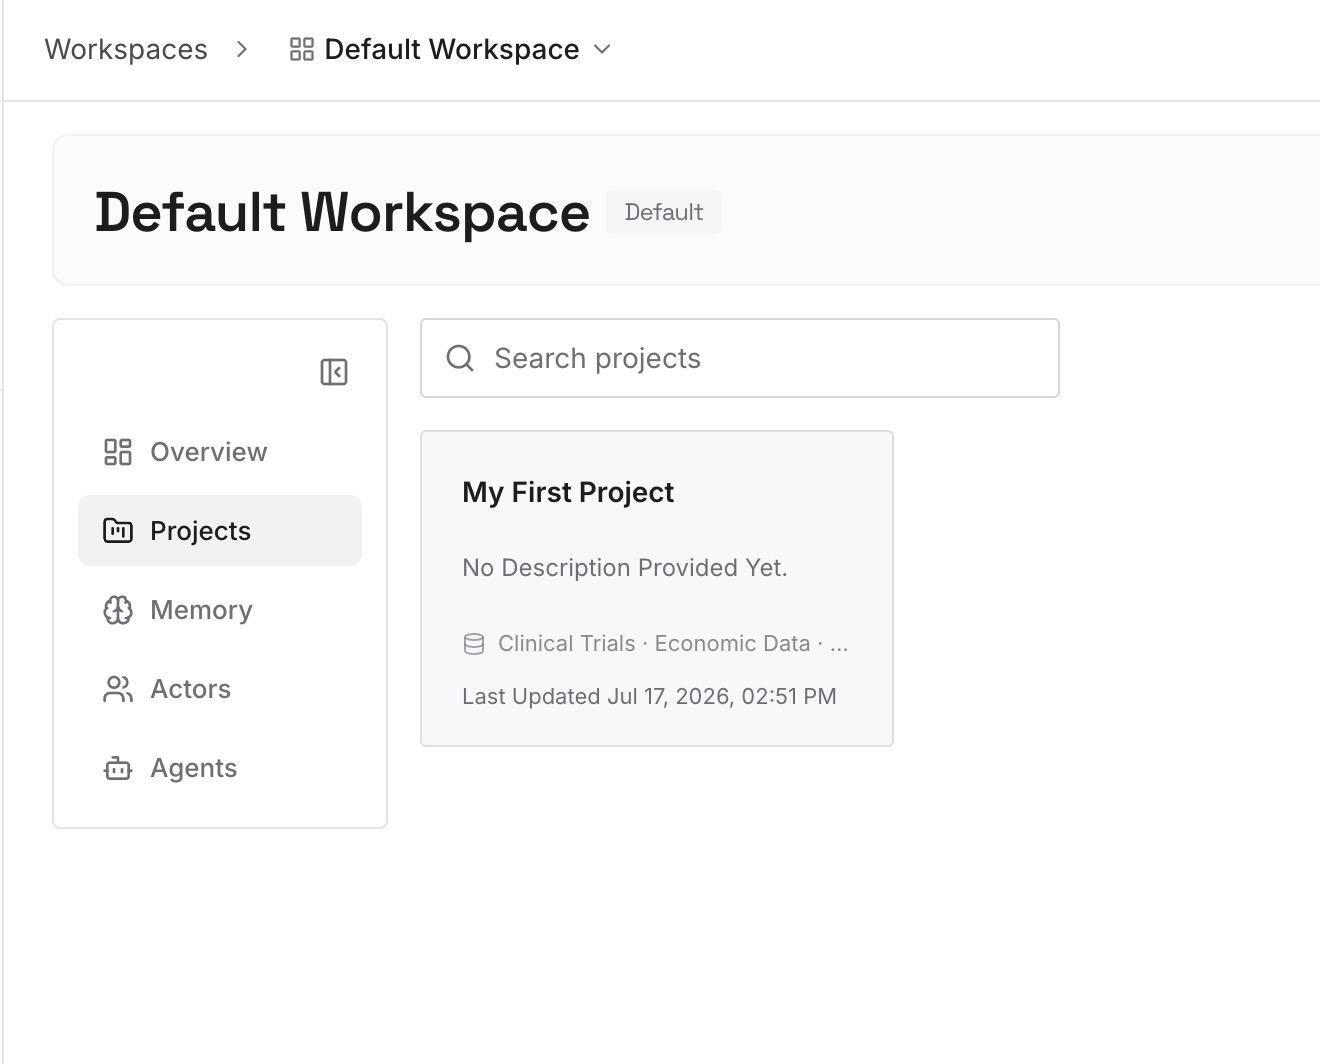
제외된 네 가지 항목부터 시작하십시오. 임시 결론, 인수인계 사항, 다시 추론하고 싶지 않은 결정 사항의 배경 논리 등이 이에 해당합니다. 보통 프로젝트당 10여 개의 짧은 항목이면 충분합니다. 각 항목은 이야기 형식이 아닌 날짜가 포함된 서술형 문장으로 작성하십시오.
3단계: AI 및 에이전트 연결하기
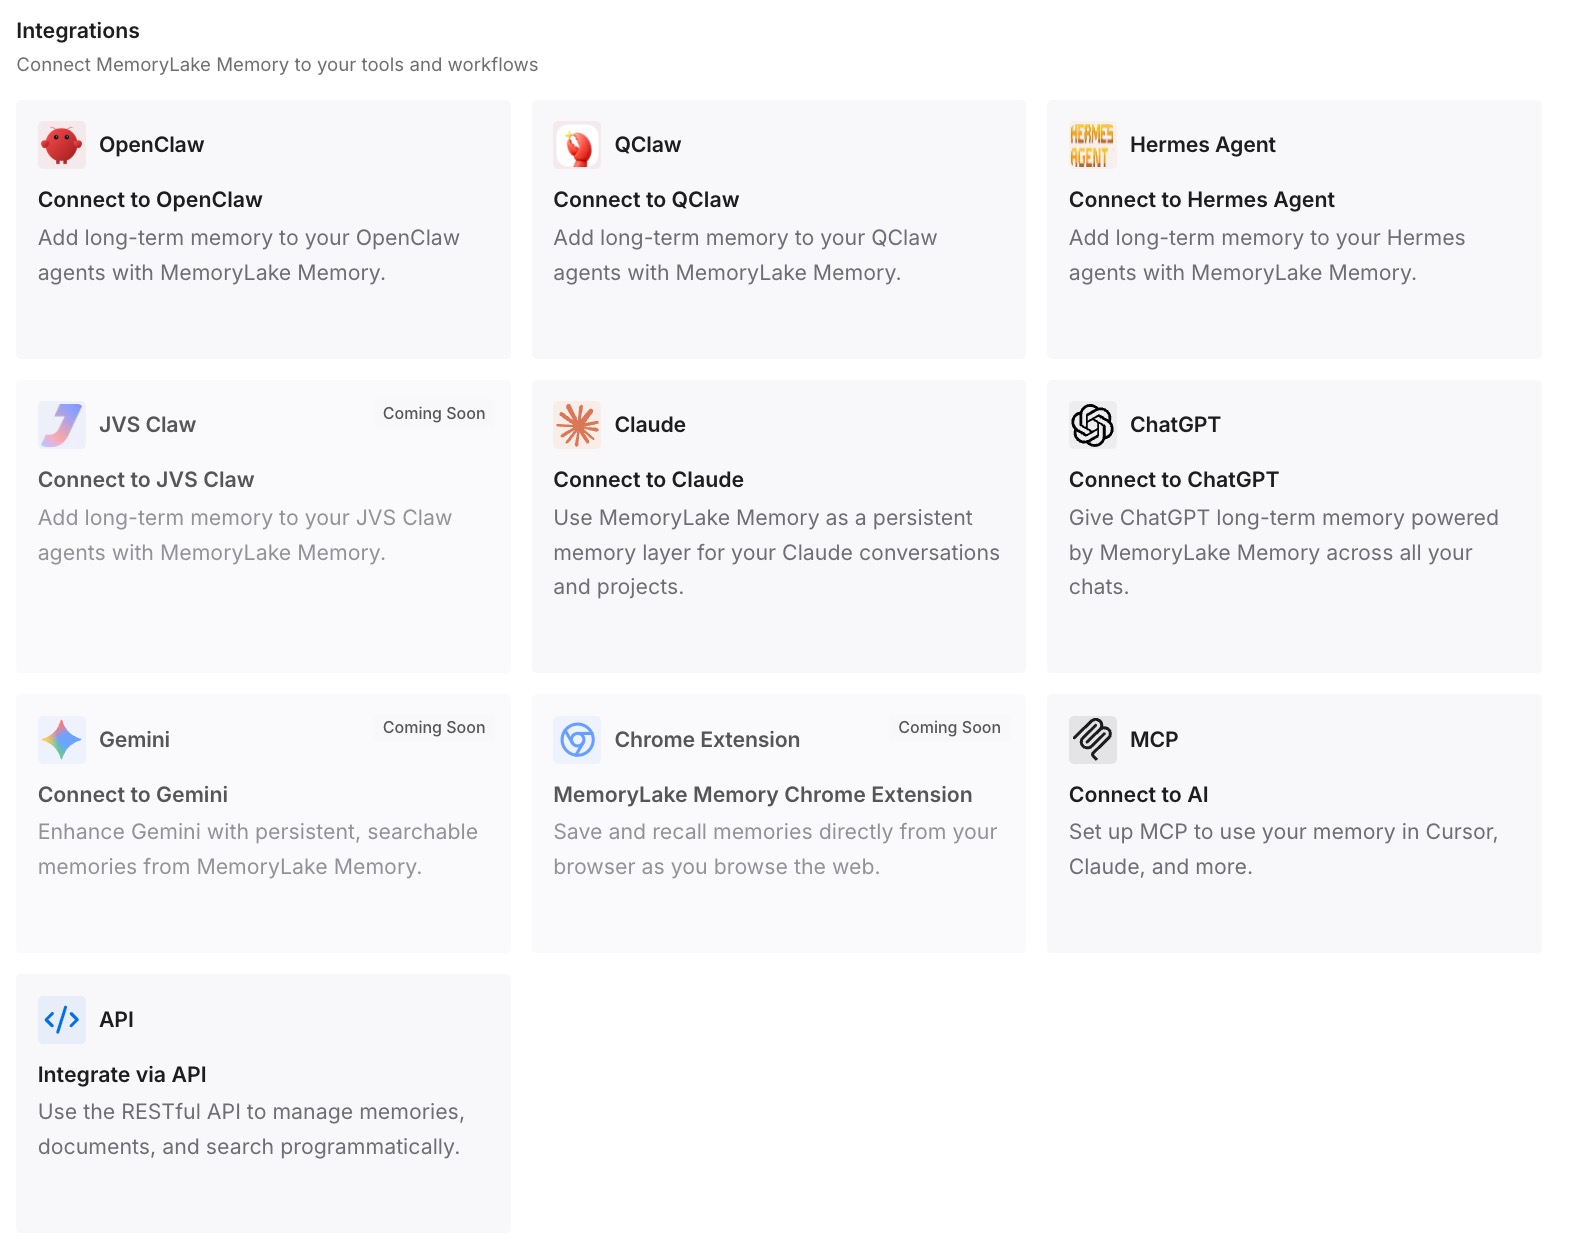
세션 시작 시 사실들을 매번 재구성하는 대신 바로 로드할 수 있도록 도구가 이 레이어를 가리키도록 설정하십시오. 그런 다음 확실한 방법으로 테스트해 보십시오. 다른 도구에서 새 세션을 열고 해당 사실 중 하나를 물어보는 것입니다. 답변을 얻는다면, 그 사실은 더 이상 특정 제품의 기록 정책에 의존하지 않게 된 것입니다.
실질적으로 달라지는 점
첫 번째 변화는 발표 내용이 막연한 기대가 아닌 검증 가능한 대상이 된다는 점입니다. "기억한다"는 주장은 검증하기 어렵습니다. 하지만 작업 상태, 잠정적 결론, 비밀 정보, 그리고 문서가 이미 다루고 있는 내용을 제외한 컨벤션, 결정 사항, 프로젝트 사실을 기억한다는 주장은 자신의 일주일간의 작업과 대조하여 어디에 공백이 생기는지 직접 확인해 볼 수 있습니다.
두 번째는 문서가 새로운 방식으로 조용히 중요한 역할을 맡게 된다는 점입니다. 노트는 "저장소나 관련 문서가 이미 다루고 있는 모든 것"을 건너뛰기 때문에, 오래된 문서는 이제 memory가 의도적으로 판단을 미루는 대상이 됩니다. README를 검토하는 일은 단순한 정리 정돈을 넘어 memory 유지 관리가 됩니다.
세 번째는 Grok Build를 전혀 사용하지 않더라도 주제별 파일 설계(file-per-topic)는 모방할 가치가 있다는 점입니다. 주기적으로 병합되는 주제별 하나의 토픽과 그 결과물에 대한 읽기 전용 브라우저를 제공하는 방식은 계속해서 늘어나는 단일 파일보다 훨씬 더 나은 형태이며, 직접 관리하는 저장소에도 동일하게 적용할 수 있습니다. 누적되는 로그의 실패 사례는 why searchable session logs keep disappointing people who wanted memory에서 다루었습니다.
네 번째는 Grok의 채팅 영역에 memory를 추가하는 것은 여전히 별개의 메커니즘을 가진 별개의 작업이라는 점입니다. 저희는 the practical ways to give Grok persistent memory에서 대안들을 다룬 바 있습니다. Grok Build의 노트 범위는 Grok Build로 제한됩니다.
스스로 기록하는 Memory를 활용하는 모범 사례
노트를 신뢰하기 전에 먼저 읽어보십시오. 이를 위해 /memory가 존재합니다. 파일에 대한 읽기 전용 브라우저는 잘못 기록된 노트를 가장 빠르게 찾아내는 방법입니다.
대화가 아닌 파일에서 직접 노트를 수정하십시오. 대화 중의 지침은 현재 세션에서만 우선할 뿐 디스크의 내용은 변경하지 못합니다. 컨벤션이 변경되었다면 토픽 파일을 직접 편집하십시오.
지속성 필터가 자체적인 판단 기준을 가질 것임을 예상하십시오. 캡처는 "지속성 있는 정보"를 기록합니다. 사용자는 지속성이 있다고 생각하지만 모델은 그렇지 않다고 판단한 내용은 오류 메시지 없이 그냥 누락될 것입니다.
비밀 정보는 근처에도 두지 마십시오. 또한 제외 정책을 보안 경계로 신뢰하지 마십시오. 제외 정책은 기록 정책일 뿐 보안 경계가 아닙니다.
결정 사항당 하나의 서면 답변을 도구 외부에 보관하십시오. 만약 어떤 사실을 다른 어시스턴트에게 다시 설명해야 한다면, 그 사실은 단일 제품의 노트에만 머물러서는 안 됩니다.
저장소 문서를 분기별로 다시 읽어보십시오. 설계상 memory는 문서에 판단을 미루므로, 문서가 오래되었다는 것은 곧 memory도 오래되었음을 의미합니다.
결론
Grok Build의 memory는 이례적일 정도로 솔직하게 묘사된, 진정으로 유용한 기능입니다. 완료된 모든 턴 이후에 캡처하고, 마크다운 토픽 파일을 프로젝트 범위와 글로벌 범위에 저장하며, 관련 작업 전에 이를 읽어 들이고, 현재 대화가 노트의 내용을 덮어쓸 수 있도록 허용합니다.
기억해 둘 만한 가치가 있는 부분은 이 기능이 멈추는 지점을 알려주는 문장입니다. "작업 상태, 잠정적 결론, 비밀 정보, 그리고 저장소나 관련 문서가 이미 다루고 있는 모든 것은 제외됩니다."
xAI는 memory 문제를 해결했다고 발표한 것이 아니며, 본문의 그 어떤 내용도 그렇게 암시하지 않습니다. 그들은 기록 정책을 출시하고 이를 공개했을 뿐입니다. 공개된 기록 정책에 대처하는 합리적인 방법은 이를 읽고 대부분에 동의한 뒤, 제외된 카테고리들을 어디에 보관할지 결정하는 것입니다. 왜냐하면 이 카테고리들이야말로 가장 먼저 아쉬워질 항목들이며, 정의상 그 누구도 당신을 위해 대신 기록해 주지 않을 것이기 때문입니다.