
OpenAI 在 10 月 9 日做出的改变
ChatGPT 官方账号在当天总结了这一变化:“您的 dot 现在可以在 Codex 中启动工作并跟进现有线程,利用您的 ChatGPT 对话、Codex 线程和自动化。”
Dots 本身的使用权限仍然受限。OpenAI 的 dots 概述中列出了 Pro 100、Pro 200 和 Pro 500 “适用于欧洲经济区、英国和瑞士以外的 18 岁以上用户”,Business Premium “正在全球推广”,而 Enterprise 的 dots “默认关闭”,直到工作区管理员启用它们。
值得将每周更新说明与现有的常设文档对照阅读,因为两者对 dot 的访问范围描述有所不同。截至 10 月 10 日,常设的“任务与记忆”页面仍然写着:“连接电脑并不能授予访问每个现有 ChatGPT 或 Codex 对话的权限。”而 dots 概述则写着:“连接您的电脑可以让您的 dot 处理其任务和文件。它不会让您的 dot 访问每个应用中的每个对话。”
这两者并不一定冲突。常设页面介绍的是连接电脑所授予的权限。而每周更新说明描述的是一种能力:搜索您的 ChatGPT 对话并利用 Codex 线程和自动化。安全的理解是,您的 dot 现在可以跨更多的工作内容查找信息,而连接电脑本身仍然不是授予该权限的直接原因。在常设页面重新措辞之前,请将每周更新说明视为更新的描述,并假设您的 dot 可能会利用与工作相关的任何 ChatGPT 对话或 Codex 线程进行规划。
上下文如何从您的 dot 移动到 Codex 线程
三种任务,三个工作运行位置
“任务与记忆”页面在一个小表格中列出了 dot 的编码工作可以在哪里运行:
- 新的本地 Work 或 Codex 任务:“在连接到您的 dot 的电脑上创建任务。保持该电脑在线并打开 ChatGPT 应用。”
- 现有的本地 Codex 任务:“在连接的电脑上继续任务。识别任务以及您想要更改的内容。”
- 新的云端编码任务:“在您已经设置好的 Codex 云环境中创建任务。您的电脑可以处于离线状态。”
云端工作取决于您首先进行的设置:“对于云端编码工作,请先在 Codex 中创建环境,包括其代码仓库和设置配置。”如果您还没有构建过,我们的 Codex 云环境指南介绍了环境会为每个任务携带哪些内容。
如果您在多台机器上工作,有一个细节非常重要:“更改您的 dot 选择的电脑不会将现有任务移动到该电脑上。”任务会留在它启动的地方。
线程接收到的是简报
文档准确地说明了新任务从您的 dot 获得了什么:“新任务会从您的 dot 接收该工作的指令和上下文。它有自己的对话;它不会自动接收您与 dot 进行过的每一次对话。”
因此,交接就像是一份简报。您的 dot 决定 Codex 线程需要什么,将其写入任务中,然后线程根据这些内容以及其自身环境提供的内容开展工作。它是从简报开始,而不是从您的 dot 的完整历史记录开始。
这是一个合理的设计。包含您完整 dot 历史记录的编码线程会非常杂乱,而且其中一些历史记录是私密的。代价是,简报中遗漏的任何内容都会在线程中缺失,除非线程可以从其他地方找到它。
双方各自使用哪种记忆
这是这三个产品交汇的地方,每个产品都记录了自己的记忆。
根据概述,您的 dot “利用对话、相关的 ChatGPT 记忆,以及它自己保存的关于您的偏好、决定和正在进行的工作的笔记。”
您电脑上的 Codex 使用不同的存储。OpenAI 的“记忆”页面指出:“ChatGPT 网页端使用 ChatGPT 记忆,而本地 Codex 客户端使用独立的本地记忆库和控制。”该本地存储“默认关闭”,位于您的 Codex 主目录下,并被描述为生成状态。我们的开启 Codex 本地记忆指南详细介绍了这些控制。
ChatGPT Work 位于 ChatGPT 这一侧:“它使用适用于您的账户和工作区的记忆设置;它不使用本地 Codex 记忆库或本地记忆控制。”
综上所述,当您的 dot 启动本地 Codex 任务时,有三种记忆在起作用。您的 dot 根据 ChatGPT 记忆和它自己的笔记工作。简报承载了 dot 选择传递的内容。如果您开启了该机器的 Codex 记忆库,本地 Codex 任务就可以利用它。云端编码任务则根据其环境和代码仓库工作。文档对每个存储进行了单独描述;在交接时跨越它们的是简报。
OpenAI 自身关于 Codex 记忆的建议在这里尤为适用:“将必需的团队指南保留在 AGENTS.md 或已签入的文档中。将记忆视为一个有用的辅助召回层,而不是必须始终适用的规则的唯一来源。”仅存在于您的 dot 笔记中的规则取决于 dot 是否将其包含在简报中。而 AGENTS.md 中的规则会随代码仓库一起移动,因此任何在其中工作的线程都可以使用它。如果您的规则似乎仍然丢失,我们的 Codex 忽略 AGENTS.md 规则指南介绍了常见原因。
流回:您的 dot 现在从 Codex 中读取什么
现有线程和自动化
10 月 9 日的变化也反向起作用。您的 dot 可以“跟进现有线程”并“使用您现有的 Codex 线程和自动化的上下文”。它还可以继续现有的本地 Codex 任务,这在常设文档中本就已被允许。
自动化是跨越产品线最明显的部分。ChatGPT 的定时任务可以在现有聊天中运行,OpenAI 解释了为什么要这样做:“定时任务使用聊天现有的上下文,而不是每次都从新的提示词开始。”您的 dot 现在可以“读取和编辑 ChatGPT Work 自动化”,这意味着它可以查看该循环工作并对其进行更改。我们的每次运行都重新开始的定时任务指南解释了定时任务的上下文最初是如何设置的。
它读取的内容最终会流向何处
OpenAI 的 dots 隐私常见问题解答双向描述了您的 dot 与 ChatGPT 记忆之间的链接:“您的 dot 可以从 ChatGPT 接收记忆和最近的对话上下文,与您的 dot 的对话可以为 ChatGPT 中的记忆做出贡献。”
结合 10 月 9 日的变化来阅读这段话。您的 dot 从 Codex 线程中提取的细节可能会在与您的 dot 的对话中出现,而与您的 dot 的对话可以为 ChatGPT 记忆做出贡献。常见问题解答还指出,关闭 ChatGPT 中的“记忆”功能会“停止该共享”,并且“不会删除您的 dot 已经接收到的信息”。
您的 dot 自己的笔记还有进一步的限制,同一个常见问题解答中明确指出:“您目前无法查看、删除或直接修改单个 dot 记忆,包括从插件进入 dot 上下文的具体细节。”删除 dot 是文档中记载的清除其上下文的方法,而它创建的内容在此之后依然存在:“您的 dot 创建的文件、Codex 线程和 ChatGPT 对话是分开存储的。删除您的 dot 不会删除它们。”
权限仍然是独立的
延伸到 Codex 并不等同于访问您的机器。“电脑”页面指出:“您的 dot 的本地电脑权限与将电脑连接到 Codex 或启用 Work Sync 是分开的。仅靠其中任何一个连接都无法让您的 dot 获得访问权限。”您需要从您的 dot 个人资料中进行授权,一次只能授权一台个人电脑。
使用额度也是分开的:“与您的 dot 的对话不计入您的 ChatGPT 使用限制。您的 dot 在 Work 或 Codex 中启动或管理的任务照常计入这些产品的使用限制。”
人们尝试的其他做法
假设 Codex 线程了解整个对话。 它接收的是该工作的简报,而不是您的 dot 历史记录。
假设本地 Codex 记忆已开启。 它们默认是关闭的,并且属于单台机器。
将团队规则保留在记忆中。 OpenAI 建议对于必须始终适用的规则,使用 AGENTS.md 或已签入的文档。
通过切换您的 dot 选择的电脑来移动任务。 文档指出这不会移动现有任务。
通过关闭 ChatGPT 记忆来清除 dot 所知道的内容。 这只会停止未来的共享,并保留 dot 已经接收到的内容。
将连接的电脑视为完全访问权限。 dot 的本地权限、Codex 连接和 Work Sync 是分开授予的。
解决方案:决定哪些内容跨越界线,将其写入双方都能读取的地方,然后检查交接情况
步骤 1:将每个线程都需要的规则放在 Codex 读取的地方
在让您的 dot 开始编码工作之前,将任何必须始终适用的内容移入代码仓库:用于约定和命令的 AGENTS.md,用于架构决策的已签入文档。对于云端任务,确保 Codex 环境拥有该工作所需的代码仓库、设置脚本和机密信息。
这消除了最重要的事情对简报的依赖。您的 dot 仍然可以传递特定于任务的上下文,但常设规则会随代码仓库一起送达,无论哪个线程打开它。
步骤 2:在工作开始前让您的 dot 展示简报
当您将编码工作交给您的 dot 时,让它告诉您它计划使用哪个线程、是继续现有线程还是启动新线程,以及它将传递哪些上下文。每周更新说明指出,dot 现在更擅长做出这一决定;检查它只需花费一条消息。
如果工作属于现有线程,请指明该线程的名称。如果需要全新开始,请说明。如果简报遗漏了您关心的决策,请在线程开始前添加。对于本地工作,还要确认任务将在哪台机器上运行,因为稍后更改您的 dot 选择的电脑不会移动任务。
步骤 3:审查双方返回的内容
当 Codex 线程结束时,从您的 dot 的“活动”视图中打开它,并亲自阅读结果。OpenAI 的指导意见是:“运行完成本身并不能证实已达到或交付了所请求的结果。”
然后检查另一个方向。如果您的 dot 编辑了 ChatGPT Work 自动化,请在“已计划”(Scheduled)中查看新版本。定期审查 ChatGPT 记忆,以清除通过 dot 对话传入且不再属于那里的细节。如果您在 Mac 上使用“电脑历史记录”(Computer History),我们的电脑历史记录如何转化为记忆指南非常值得一读,因为它是同一台机器上喂给记忆的又一个来源。
在 MemoryLake 中进行设置
您的 dot、ChatGPT 记忆和 Codex 的本地存储各自保存了您所做决定的一部分,并且每个界面都读取自己的内容。如果您希望编码工作背后的决策保存在一个由您维护的统一地方,而不管哪个界面启动任务,MemoryLake 就是一个由您自己编写并连接到所用工具的记忆层。
您用自己的语言亲自编写条目。不会从您的 dot、ChatGPT 记忆、Codex 的记忆库或任何供应商的存储中读取、写入或删除任何内容。
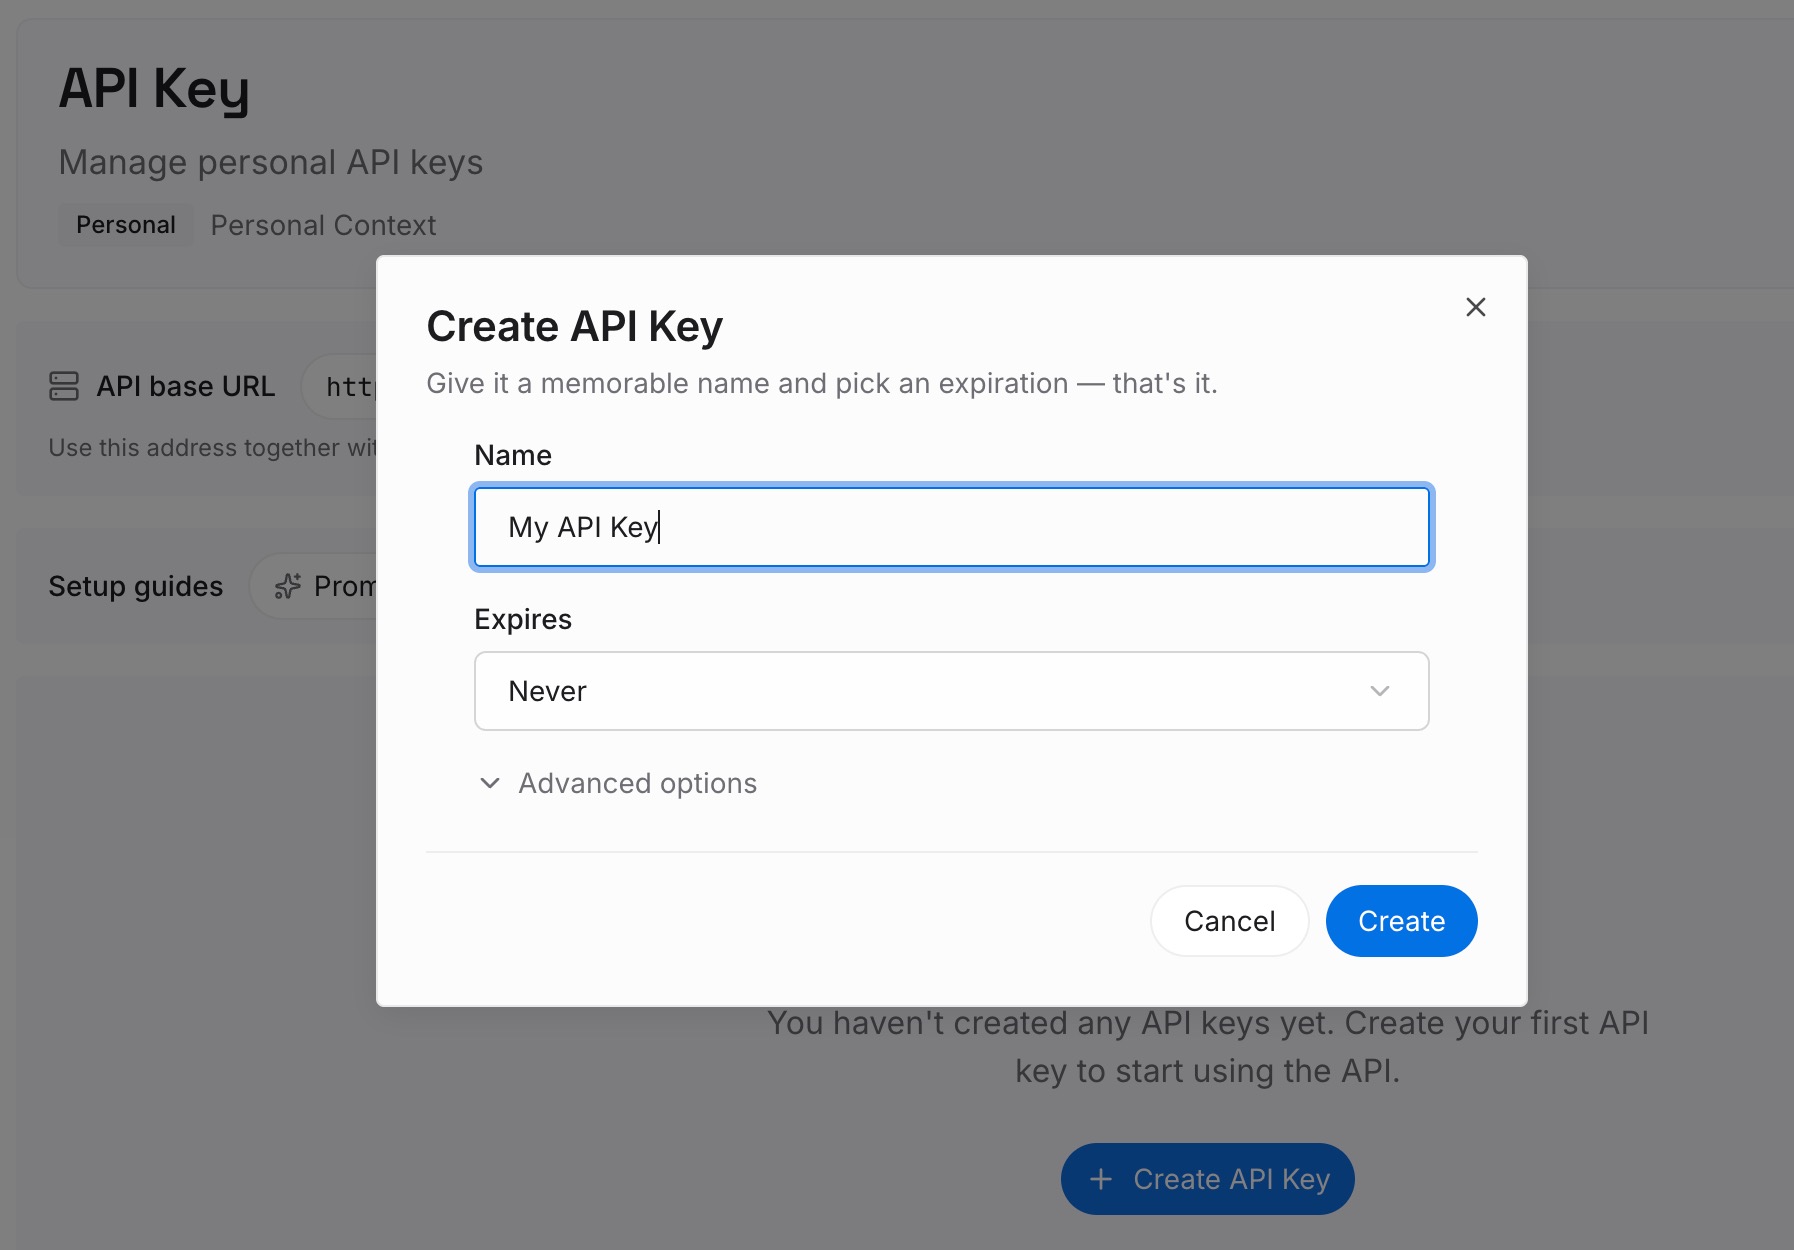
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 OpenAI 账户是分开的。
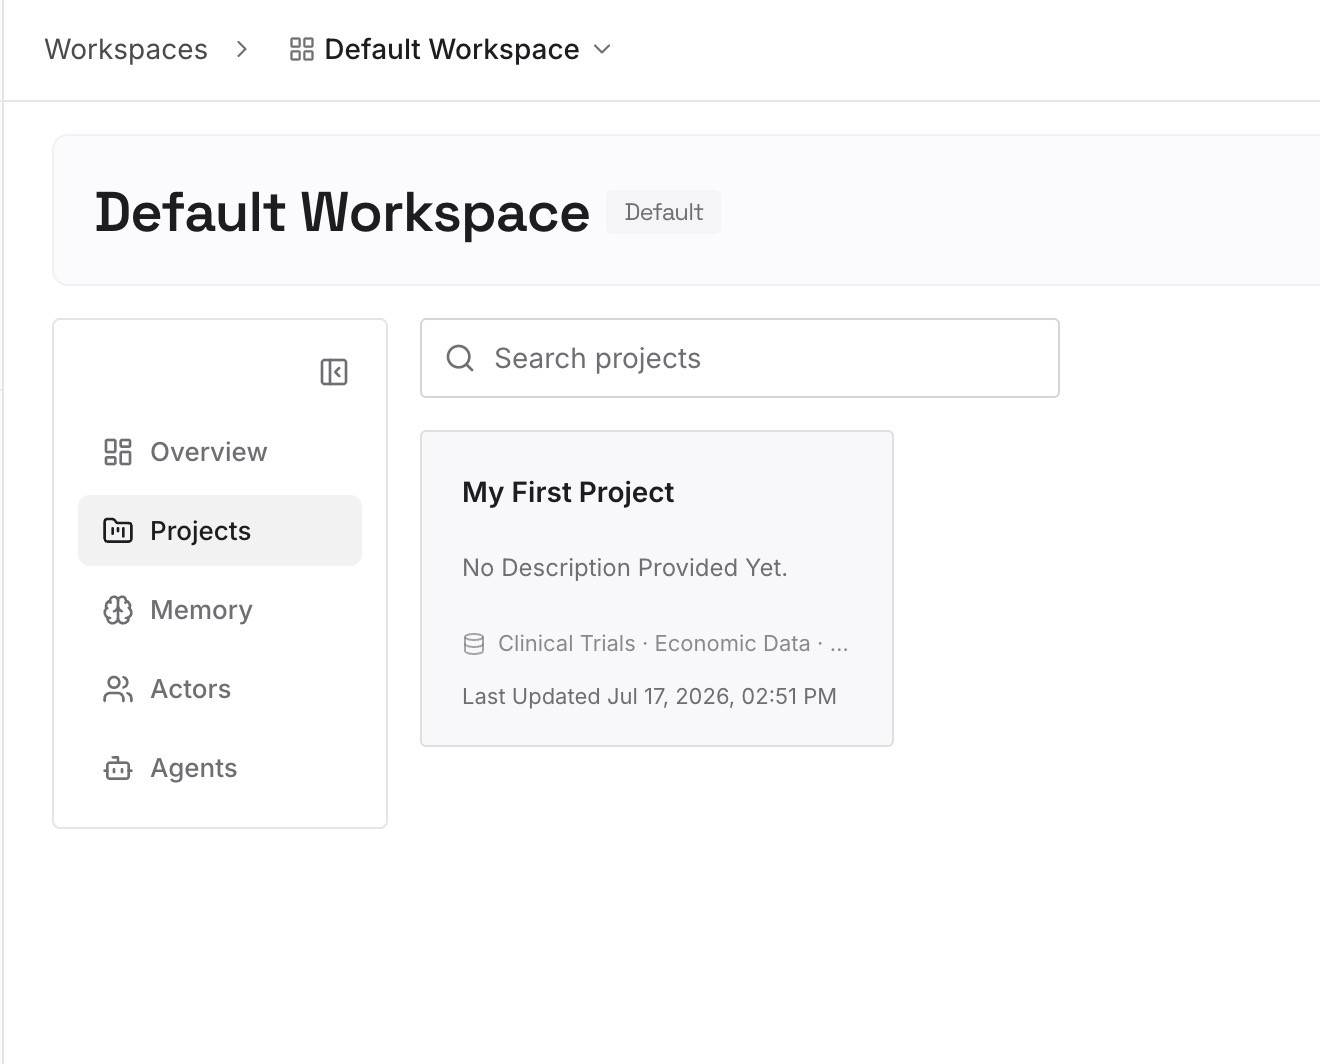
步骤 2:上传您的第一批记忆
从您的编码线程一直需要的决策开始:架构选择、命名规则、以往事件的限制。每个条目一个决策,并注明日期,这样较新的条目就能明显替代较旧的条目。
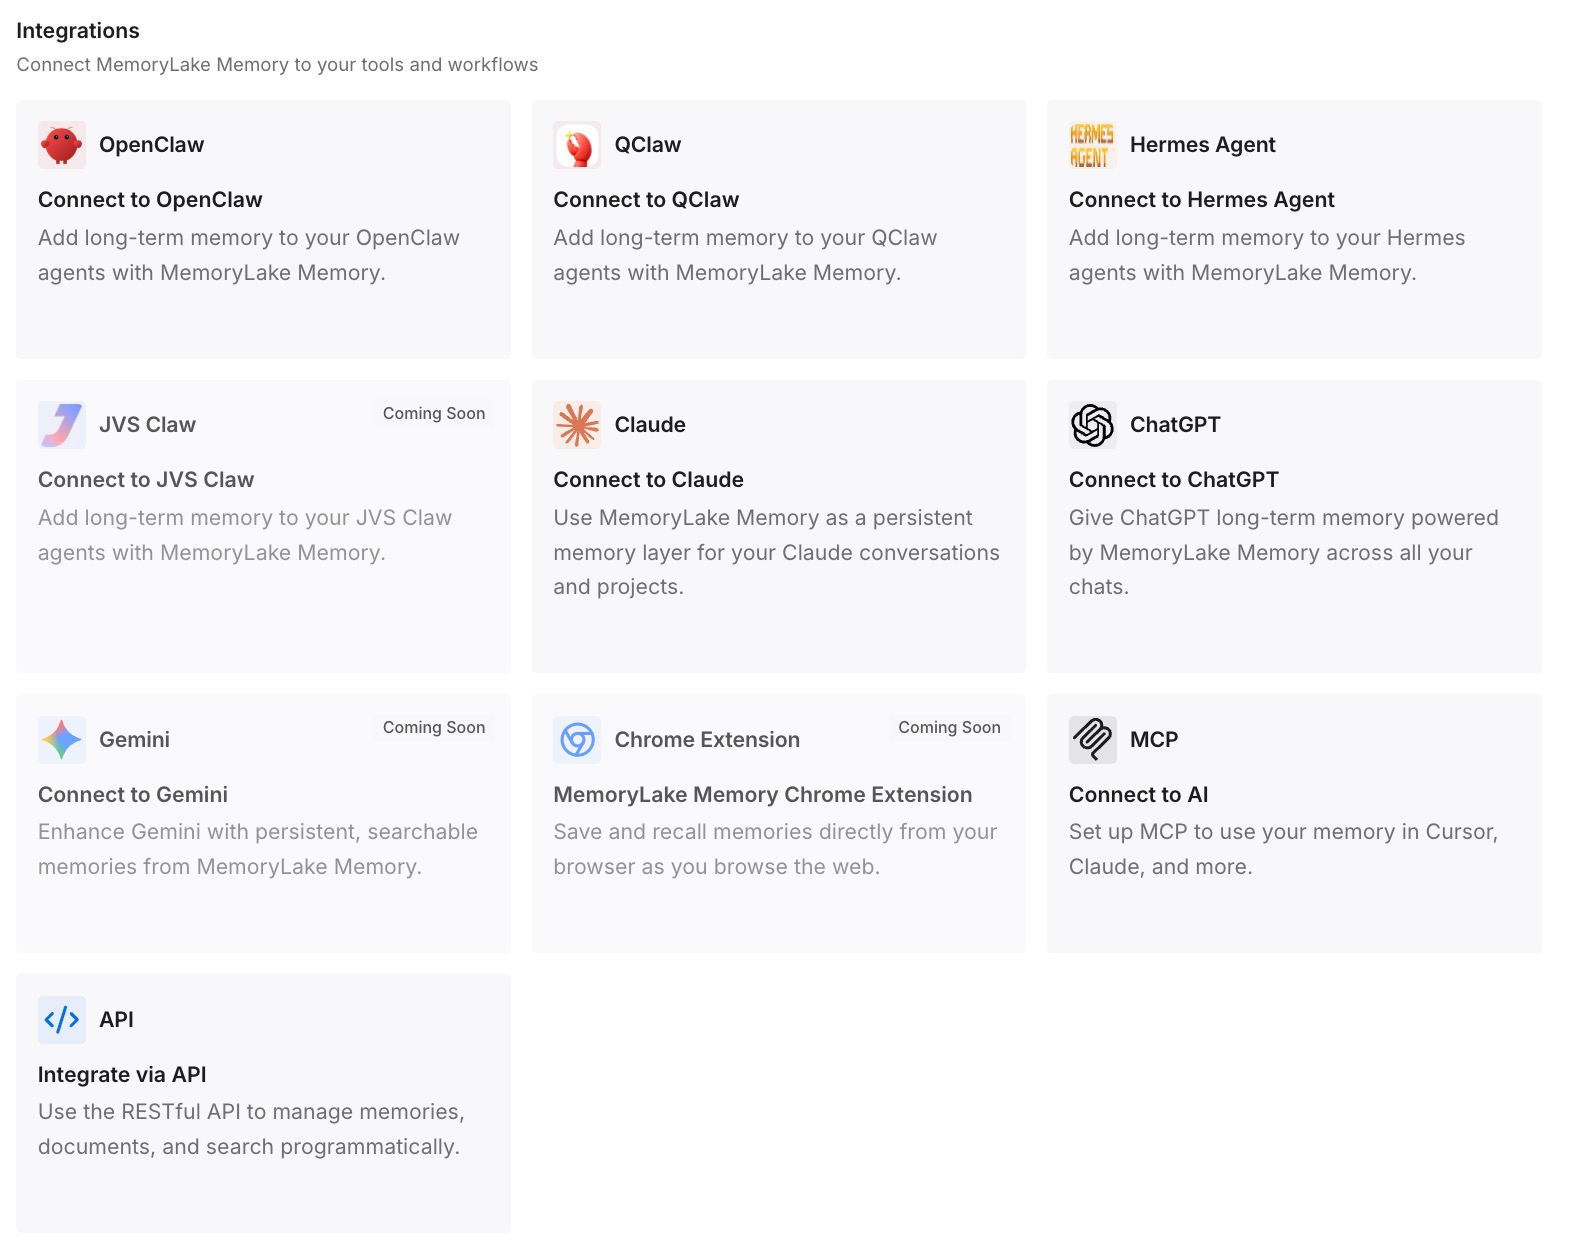
步骤 3:连接您的 AI 和智能体
连接 Codex 和您使用的其他助手。这样,无论任务是从您的 dot 启动、从您自己打开的 Codex 线程启动,还是从其他工具启动,都可以使用相同的决策。
这在实践中带来了什么改变
第一个区别是减少了无声的遗漏。当常设规则存在于 AGENTS.md 和环境中时,即使简报很短,由您的 dot 启动的线程也能获取它们。
第二个是线程保持井然有序。为线程命名,或者询问您的 dot 它将使用哪一个,可以将相关工作保持在一起,而不是分散在新的线程中。
第三个是对细节流向有了更清晰的认识。您知道 Codex 线程中的细节可能会在 dot 对话中出现,而 dot 对话可以为 ChatGPT 记忆做出贡献,因此您在审查记忆时会考虑到这一路径。如果您还在 ChatGPT Work 中的云端和本地工作之间切换,我们的在 Work 云端和本地之间保持上下文的指南涵盖了这一边界。
第四个是循环工作中的意外更少。知道您的 dot 可以编辑自动化后,您在要求它更改计划后会检查“已计划”(Scheduled)。
在 Codex 中与您的 dot 协同工作的最佳实践
将规则提交到 AGENTS.md。 每一个打开代码仓库的线程都会读取它们。
在委派云端工作之前设置好 Codex 环境。 dot 会使用您已经创建的环境。
索要简报和目标线程。 在工作开始前确认是继续还是新建。
提前选好机器。 更改 dot 选择的电脑不会移动现有任务。
亲自阅读结果。 运行完成并不代表结果已成功交付。
在自动化更改后检查“已计划”(Scheduled)。 您的 dot 现在可以编辑 ChatGPT Work 自动化。
定期审查 ChatGPT 记忆。 dot 对话可以为其做出贡献。
结论
2026 年 10 月 9 日,OpenAI 将 dots 扩展到了 Codex。您的 dot 可以启动 Codex 工作、跟进现有线程、利用您的 ChatGPT 对话、Codex 线程和自动化,并编辑 ChatGPT Work 自动化。
上下文以特定的形式流动。向外流动时,Codex 任务从您的 dot 接收简报,并根据该简报以及其自身的环境、代码仓库开展工作,如果您在电脑上启用了 Codex 的本地记忆库,还会结合该记忆库。向内流回时,您的 dot 可以读取 Codex 线程和自动化,而在 dot 对话中出现的内容可以为 ChatGPT 记忆做出贡献。
将必须始终适用的规则放在 Codex 读取的地方,在工作开始前检查简报,并审查双方返回的内容。这样,这条新路径就会对您有所帮助,而不是悄悄地重塑每个界面所记住的内容。