
简要回答
两个智能体都从您在聊天中建立的记忆开始,并且都将任务保存在与您的聊天相同的账户中。
Anthropic 用明确的词汇描述了一种双向流动:在 Cowork 的云端会话中,“Claude 从它已经从您的聊天中记住的内容开始,而 Cowork 任务中出现的内容会带回到聊天中。”
OpenAI 将 Work 描述为 ChatGPT 本身的一部分:“ChatGPT 包括 Chat 和 Work。” Work “使用您的账户和工作区可用的记忆设置”,并且 Chat 和 Work 的聊天记录位于同一个历史列表中。
区别在于边缘情况:当工作在本地运行时会发生什么,项目如何界定记忆范围,以及定时或共享任务会携带什么内容。
概览
| ChatGPT Work | Claude Cowork | |
|---|---|---|
| 从您的聊天记忆开始 | 是,遵循您的账户和工作区记忆设置 | 是,在云端会话中 |
| 任务为记忆增加了什么 | 遵循 ChatGPT 的记忆设置 | 带回到聊天中 |
| 历史记录 | 在“最近”中与 Chat 共享 | Cowork 中的任务列表,同一个 Claude 账户 |
| 项目 | 与 Chat 共享;默认或仅限项目的记忆 | 与 Claude 共享;每个项目有自己的记忆 |
| 本地工作 | 桌面应用,使用您授权的文件 | 桌面应用为云端会话连接您的计算机 |
| 定时任务 | 计划、触发或监控 | 在云端按节奏运行 |
各自如何处理记忆
ChatGPT Work
Work 是 ChatGPT 的一种模式,而不是独立产品。OpenAI 的记忆文档指出:“ChatGPT Work 使用您的账户和工作区可用的记忆设置;它不使用本地 Codex 记忆存储或本地记忆控制。” 已保存的记忆以及(如果您的设置包含)对过去聊天的引用,其工作方式与 Chat 中相同。
记忆常见问题解答解释了这两部分的关系:“保存的记忆与聊天历史记录分开存储。” 如果您的设置包含“引用聊天历史记录”,开启它“可以让 ChatGPT 使用过去对话中的相关信息来个性化未来的回复”。
历史记录也是共享的。“Chat 和 Work 的聊天内容共同出现在‘最近’中,您可以在那里进行排序、过滤和置顶。” Work 在收集任务上下文时,还可以引入“项目、记忆、ChatGPT Library 和已安装的插件”。
优点: 一个账户、一个历史记录、一套跨 Chat 和 Work 的记忆设置,因此无需管理第二个记忆库。
Claude Cowork
Cowork 与聊天共享 Claude 的记忆。Anthropic 的公告明确表示:“从今天开始,您在聊天中使用的记忆与在 Claude Cowork 中使用的记忆相同。” 帮助中心描述了双向流动:“Claude 从您的聊天中记住的内容在您于云端 Cowork 中交付任务时可用,而 Cowork 任务中出现的内容会带回到聊天中。”
Claude 的记忆在您工作时会更新。Anthropic 表示:“Claude 现在会在您聊天时将主题添加到记忆中,而不是在对话结束后进行总结。” 并且它是可见的:“Claude 记住的所有内容都在记忆设置中‘主题’下的文件列表中,您可以在那里阅读、编辑或删除每一条。”
您可以在发送第一条消息之前,在任务菜单中关闭记忆,从而在没有记忆的情况下运行单个任务。Anthropic 指出:“您的记忆设置在任务开始时设定,之后无法更改。”
优点: 聊天和任务之间有明确的双向流动,记忆按主题组织,您可以逐个文件阅读和编辑。
区别最大的地方
当工作在您的计算机上运行时
两个智能体都可以通过其桌面应用连接您的计算机,并且都在云端存储任务上下文。
对于 Work,OpenAI 指出:“即使工作在本地运行,消息和任务上下文也可能存储在云端。” 在桌面上,Work 可以使用您授权的文件和应用。我们关于在 ChatGPT Work 云端和本地之间保持上下文的指南 详细介绍了这种划分。
对于 Cowork,记忆链接与云端绑定。帮助中心表示:“跨 Cowork 和聊天的记忆仅在 Cowork 在云端运行时有效。在您计算机上本地运行的 Cowork 会话中不可用。” Cowork 现在在云端运行任务,并在任务需要本地文件或浏览器时通过桌面应用连接您的计算机。入门文章指出,Pro 和 Max 计划中的本地会话是 10 月 6 日之前在您的计算机上启动的任务。
项目如何界定记忆范围
两款产品都有项目功能,且都允许项目保持其记忆独立。
ChatGPT 项目提供两种设置。“项目可以使用默认记忆或仅限项目的记忆。” 对于仅限项目的记忆,OpenAI 表示“该项目的信息将从项目外部使用的记忆中移除”。共享项目“自动设置为仅限项目的记忆,且无法切换到默认记忆”。我们关于 ChatGPT 项目记忆模式的指南 介绍了每种设置允许的操作。
Claude 项目“在 Cowork 和 Claude 中的工作方式相同”,每个项目都有自己的记忆。“Claude 在一个项目中学到的内容不会延续到其他项目。” 除非您在项目页面上关闭账户记忆设置,否则项目会与项目外的聊天共享记忆。
这些方法最终殊途同归:项目既可以利用更广泛的记忆,也可以保持独立。
定时任务从什么开始
两个智能体都运行循环工作。
OpenAI 表示:“Work 还可以通过定时任务运行一次、按计划或触发器重复运行,或监控更改。” 事件触发器包括符合条件的计划中的新 Gmail 邮件、Slack 频道消息和 GitHub 拉取请求活动。
Anthropic 表示 Cowork 的“定时任务在云端运行,无需设备在线”。因为它们在云端运行,所以它们处于 Cowork 与聊天共享记忆的一侧。我们关于 Cowork 定时任务和记忆的指南 介绍了如何按任务控制这一点。
共享会携带什么
当您共享一个定时 Work 任务时,OpenAI 明确表示:共享“不会传输您的聊天历史记录、本地文件、文件夹、设备访问权限、连接的应用凭据、保存的记忆、自定义指令或工作区权限”。接收者使用自己的访问权限调度一个单独的副本。
在 Claude 方面,Team 和 Enterprise 计划中的项目共享允许成员以您选择的权限级别访问项目的知识和指令。
人们最初的误区
假设任务是从零开始的。 在这两款产品中,任务都可以从您在聊天中建立的记忆开始,具体取决于您的设置。
假设任务学到的一切都会被保存。 在 Claude 中,云端 Cowork 任务中出现的内容会带回到聊天中;在 ChatGPT 中,保存遵循您的记忆设置。记忆在任何一款产品中都不是完整的记录;任务自身的聊天记录保存了细节。
期望本地 Cowork 会话共享记忆。 Anthropic 表示,跨 Cowork 和聊天的记忆在云端有效。
将项目记忆视为账户记忆。 两款产品都可以将记忆范围限定在项目内。
仅通过基准测试进行比较。 对于持续性的工作,您的上下文存在于何处与运行任务的模型同样重要。
解决方案:检查智能体知道什么,有目的地界定范围,并将核心要素保留在您控制的地方
第 1 步:在执行重大任务前询问智能体它知道什么
在任何一款产品开始任务时,要求智能体列出它正在利用的内容:关于您的记忆、项目的文件和指令,以及它认为相关的过去聊天中的任何内容。在它开始之前纠正错误。在 Claude 中,您还可以打开记忆设置并直接编辑主题文件;在 ChatGPT 中,通过“设置 > 个性化”管理记忆。
第 2 步:决定哪些任务应该使用记忆
对于敏感或一次性的工作,在不使用记忆的情况下运行任务。在 Cowork 中,在发送第一条消息之前在任务菜单中关闭记忆。在 ChatGPT 中,使用具有“仅限项目记忆”的项目或调整您的记忆设置。对于持续性的工作,将任务放入项目中,以便其上下文保持在一起。
第 3 步:将您依赖的决策保存在一个地方
两个智能体都将上下文保留在各自的产品内部。如果您同时使用两者,或者在两者之间迁移,您所依赖的决策和惯例必须在每一侧重新构建。在您控制的地方保留一份简短的清单,并用它来告知您正在使用的任何智能体。
在 MemoryLake 中设置
ChatGPT Work 和 Claude Cowork 各自将任务连接到您在该公司的聊天产品中建立的记忆,并且各自利用其所属公司的记忆。
MemoryLake 是一个记忆层,用于将您依赖的上下文保存在一个由您维护的列表中,供 ChatGPT 以及您连接的其他助手(如 Claude Code 和 Codex)使用。
您可以用自己的语言亲自编写条目。不会从 ChatGPT、Claude、Cowork、您的项目、您的保存记忆或任何供应商的存储中读取、写入或删除任何内容。对于工作内容,请遵循您组织关于在工具之外保留内容的政策。
第 1 步:创建 API 密钥
登录并从控制面板生成密钥。该密钥属于您的 MemoryLake 工作区,与您的 ChatGPT 和 Claude 账户分开。
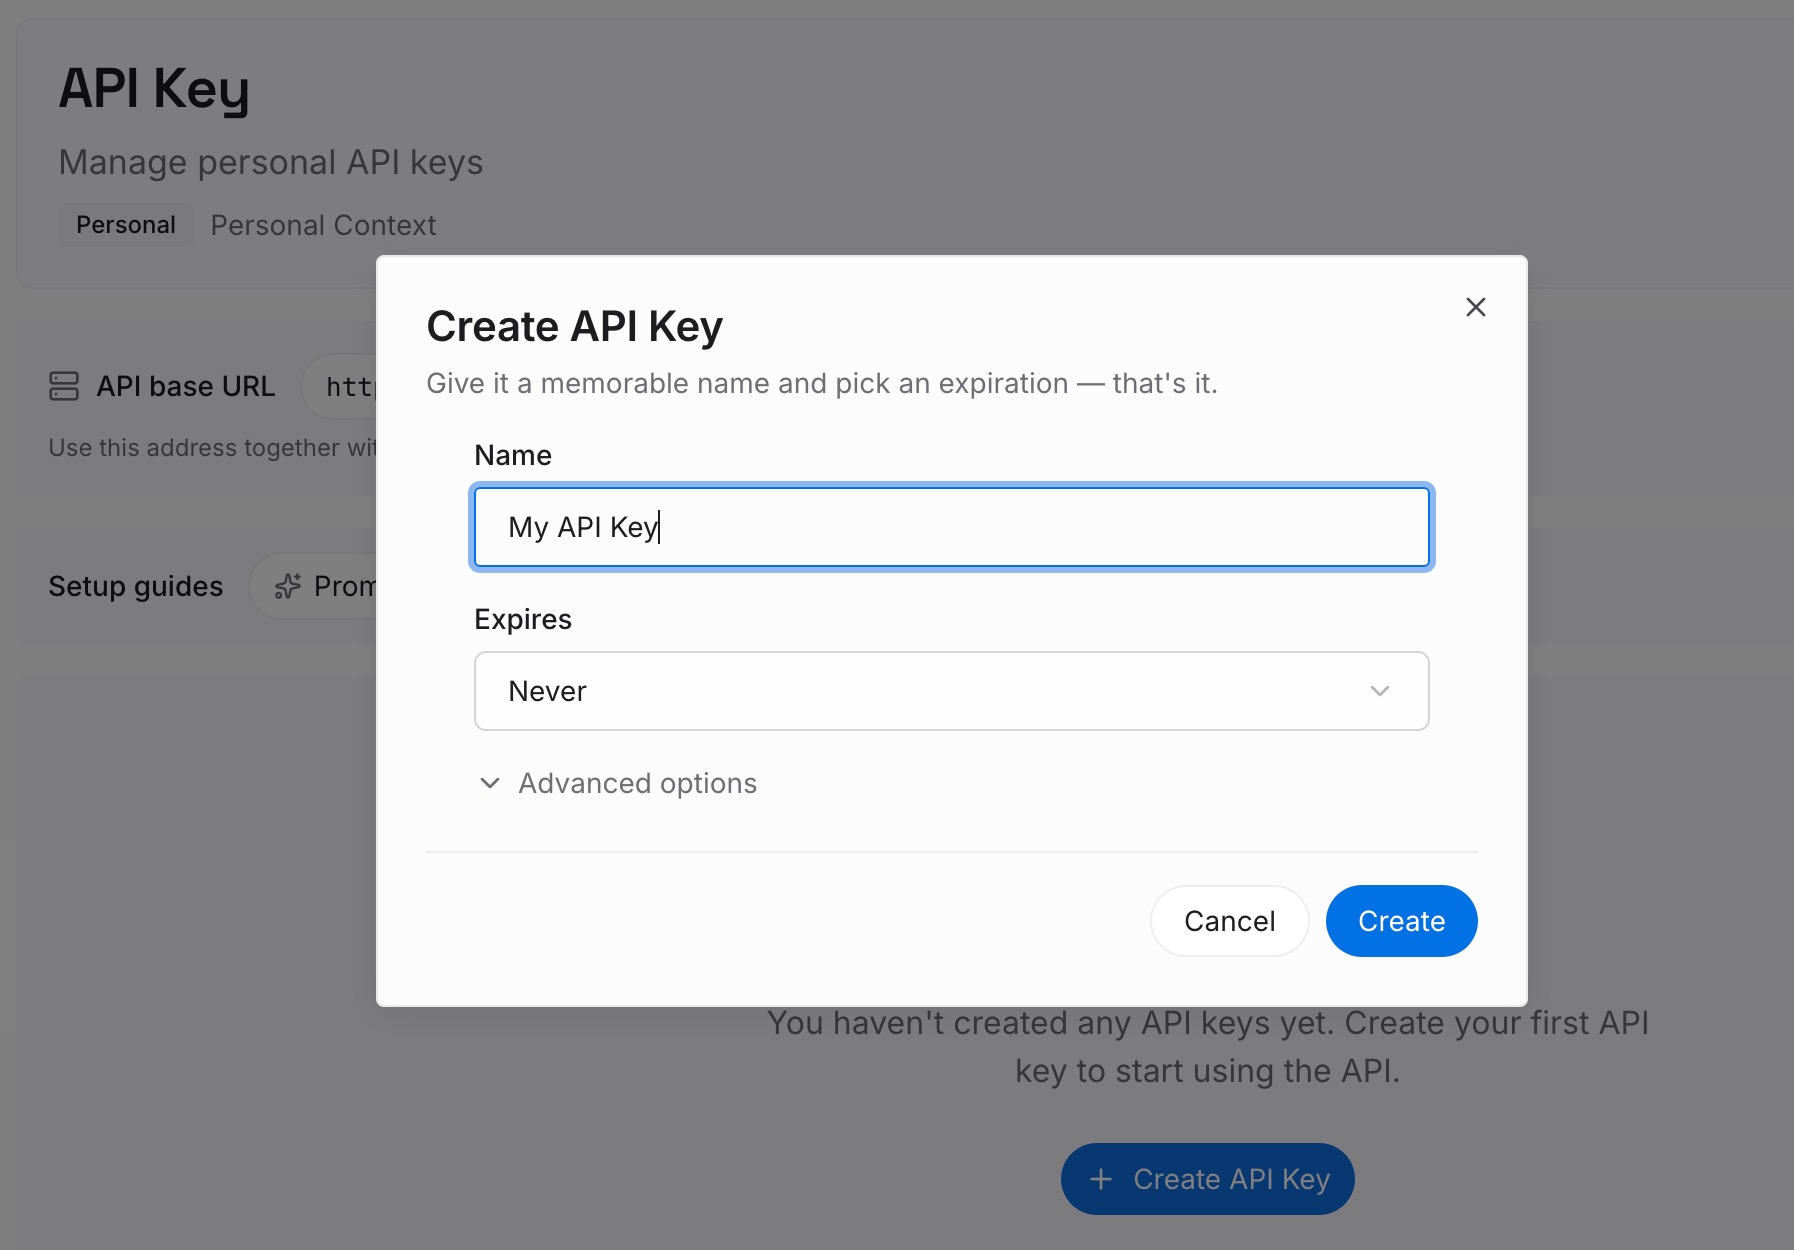
第 2 步:上传您的第一批记忆
从您在解决方案第 1 步中纠正的内容开始:每个智能体应该开始的事实和偏好。每个条目一个要点,注明日期,并贴上所属项目的标签。
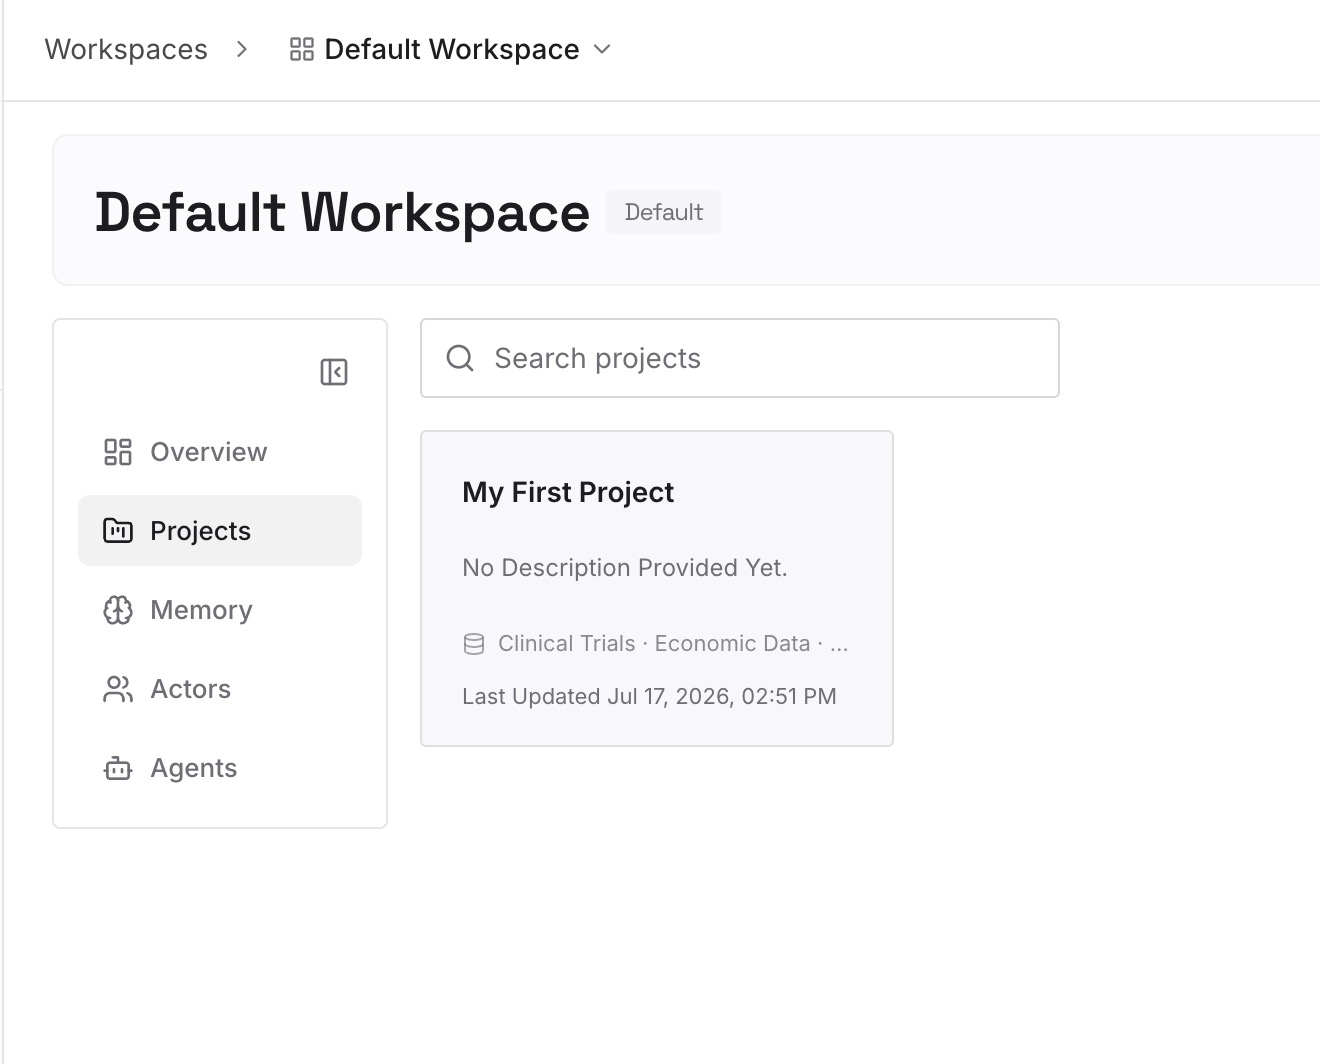
第 3 步:连接您的 AI 和智能体
连接 ChatGPT 和您使用的其他助手。无论下一个任务在哪里运行,您的核心上下文都是相同的。
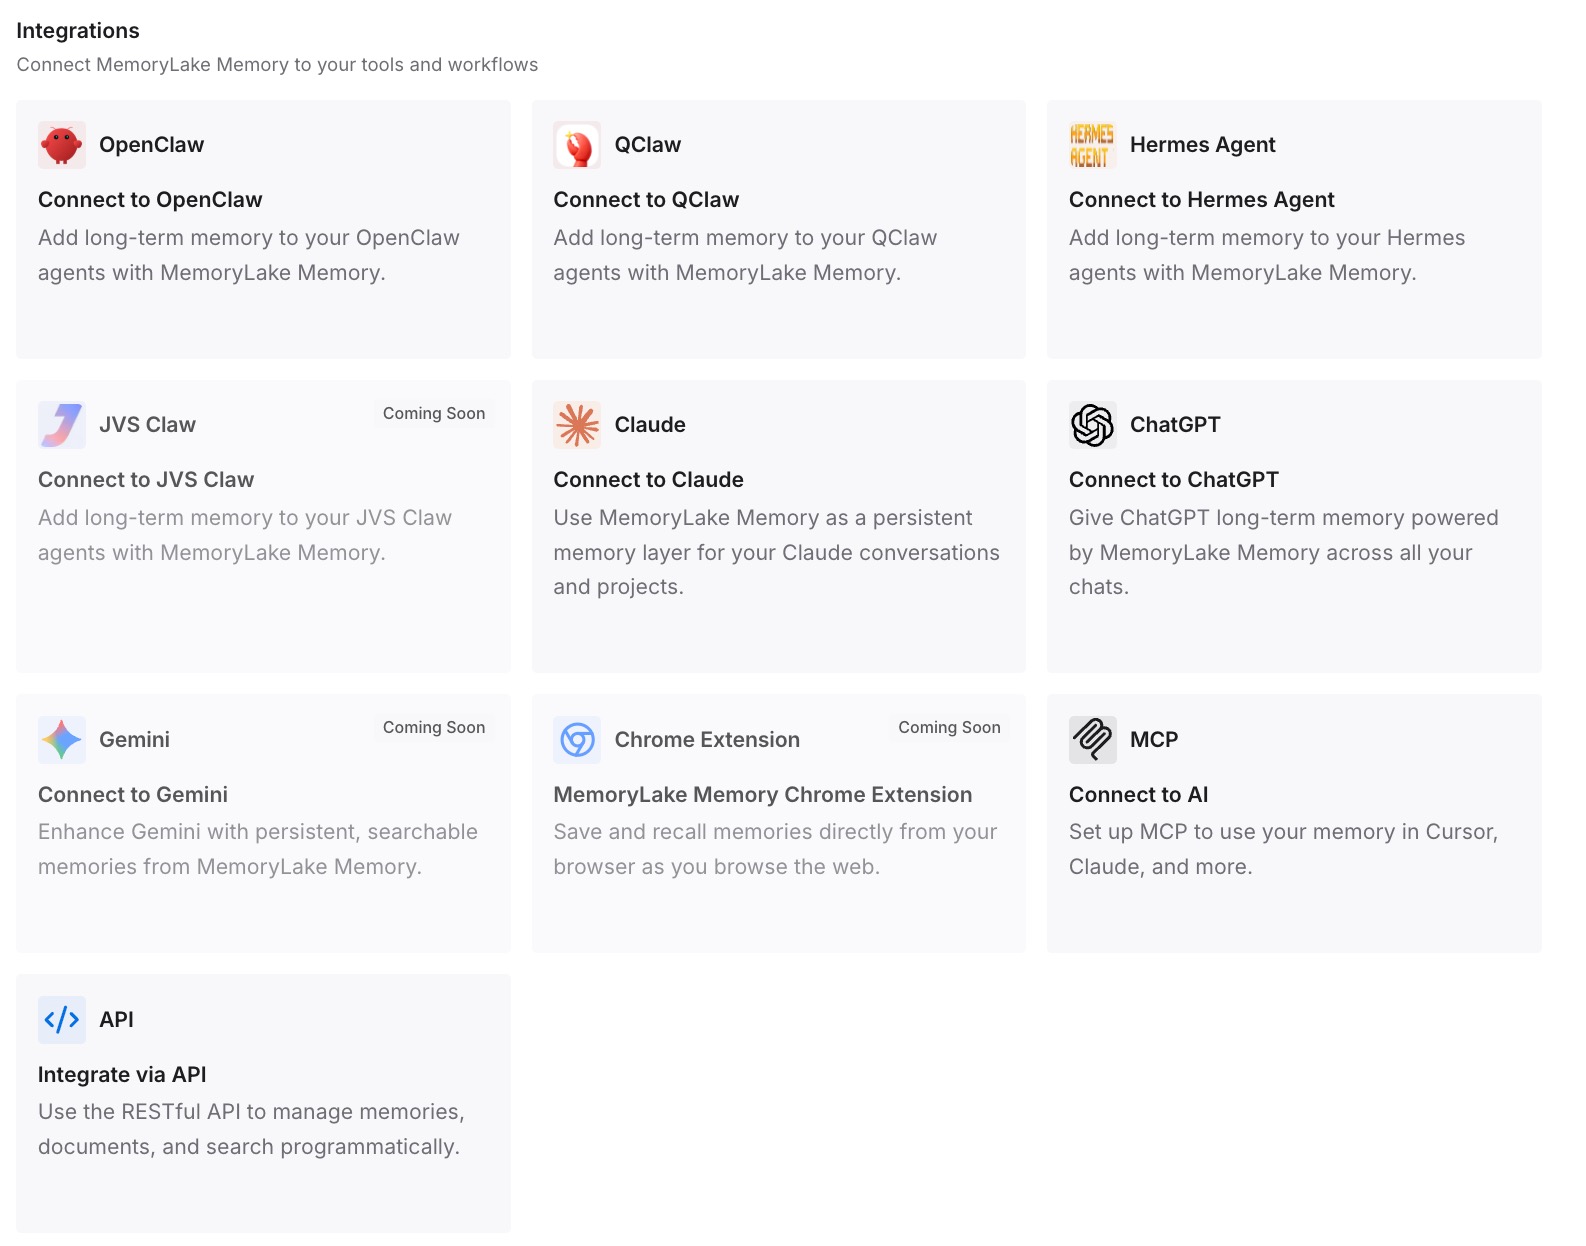
这在实践中改变了什么
第一个区别是您通过正确的问题进行选择。两个智能体都能很好地完成多步骤工作;不同之处在于每个智能体如何将任务与您的聊天联系起来。
第二个区别是任务从您的意图开始。您在工作开始前检查、纠正并界定记忆范围。
第三个区别是切换成本更低,因为您依赖的上下文已经记录在任何一款产品之外。对于 Cowork 的浏览器,我们关于 Cowork 内置浏览器保留登录信息的指南 涵盖了另一种存储状态。
ChatGPT Work 和 Claude Cowork 记忆的最佳实践
当工作持续进行时,从项目启动任务。 两款产品都会将项目上下文保持在一起。
在执行长任务前询问智能体知道什么。 在它以此为基础构建之前纠正它。
对于一次性敏感任务,关闭记忆。 两款产品都支持在无记忆的情况下运行。
如果您希望记忆与聊天共享,请在云端运行 Cowork。 Anthropic 表示本地会话不共享记忆。
在发送前检查共享的 Work 任务。 指令随链接发送,但您的记忆不会。
将核心要素保留在任何一款产品之外。 这样,对智能体的选择就始终是一个选择。
结论
ChatGPT Work 和 Claude Cowork 都将任务连接到您在聊天中建立的记忆。OpenAI 将 Work 作为 ChatGPT 的一种模式,使用您账户的记忆设置并与 Chat 共享历史记录。Anthropic 将 Cowork 的云端会话描述为与聊天双向共享一个记忆,记忆被组织成您可以编辑的主题文件。两者都允许项目界定记忆范围,都运行定时任务,并且都将任务上下文保留在云端。
选择适合您聊天所在位置的那一个,在重大任务前检查它知道什么,并将您依赖的决策保存在您控制的列表中。