长度限制与使用限制不同
Anthropic 明确区分了这两者:“在使用 Claude 时,你可能会遇到两种运作方式截然不同的限制:使用限制和长度限制。”
使用限制是指你在一段时间内使用 Claude 的频率。付费计划有“每五小时重置一次的会话限制,以及每周重置一次的每周限制”。当你达到其中之一时,你需要等待或使用使用额度。
长度限制则是针对单个对话的。“长度限制与 Claude 的上下文窗口有关——即 Claude 在单个对话中可以处理的信息量。”Anthropic 官方总结道:“使用限制控制你在所有对话中可以使用 Claude 的总量,而长度限制则控制任何单个对话可以变得多长。”
这就是为什么等待重置对过长的对话没有帮助。限制在于对话的大小,到了明天它依然是一样的。
Claude 对话可以有多大
大小取决于模型。Anthropic 关于限制的文章指出:“在付费计划中,最新的模型支持高达 1M token 的上下文窗口,而其他模型支持 500K 或 200K token。”其关于上下文窗口的文章列出了每个模型:对于对话,像 Claude Opus 5.5 和 Sonnet 5.5 这样的模型拥有 1M token,而一些较早的模型(包括 Opus 4.8 和 Sonnet 4.6)则拥有 500K。
还有一个细节:“上下文窗口的一部分总是为 Claude 的回复保留,因此最长可能的对话会略小于完整的窗口。”
所以,同一个对话在某个模型上可能没问题,但在另一个模型上就会显得太长。如果你在长对话进行到一半时切换到窗口较小的模型,你可能会更快达到限制。
为什么 Claude 对话会变得太长
对话中的一切都会被计算在内
上下文窗口容纳了整个对话:你的消息、Claude 的回复、你附加的文件,以及 Claude 使用的任何工具的结果。Anthropic 关于使用额度的文章列出了影响你消耗 Claude 速度的相同因素:“消息长度”、“附件大小”、“当前对话长度”和“工具使用(例如:Research、网页搜索)”。
一个粘贴了几个长文档、运行了几次网页搜索并修改了十个草稿的对话,其填满速度要比只有简短提问的对话快得多。
工具和连接器占用大量空间
Anthropic 直接指出了这一点:“工具和连接器是 token 密集型的,因此管理它们既有助于最大化你可用的上下文窗口,也有助于优化你的使用限制。”每个连接的应用都会增加 Claude 承载的内容,每次搜索或连接器调用都会将其结果添加到对话中。
自动上下文管理未开启
这是最值得检查的原因。“对于启用了代码执行的用户,Claude 现在会自动管理长对话。当你的对话接近上下文窗口限制时,Claude 会总结先前的消息,以无缝继续对话。”
条件在下方的注释中:“必须启用代码执行才能进行自动上下文管理。”如果你的账户关闭了代码执行,或者你组织的管理员关闭了它,Anthropic 描述的自动总结功能就不适用,长对话就会遇到长度限制。
第一条消息非常庞大
即使开启了自动上下文管理,Anthropic 也表示:“罕见的边缘情况(例如非常庞大的第一条消息)仍可能遇到上下文限制。”如果你通过粘贴整个代码库或非常长的文档来开始对话,那么几乎没有先前的对话可以用来总结。
自动上下文管理的作用
开启后,当对话接近限制时,Claude 会总结对话的前半部分,以便你可以继续。Anthropic 表示:“你的完整对话历史记录会被保留,因此即使在总结之后,Claude 仍可以引用它。”在长对话期间,你可能会看到一条提示,显示 Claude 正在整理思路,这就是该功能在起作用。
Anthropic 的两篇文章对适用范围的描述略有不同。限制文章称其“适用于启用了代码执行的用户”。上下文窗口文章则称其“适用于启用了代码执行的付费计划用户”,并补充道“这使得在大多数情况下对话可以无限期地继续”。如果你使用的是免费计划,而长对话仍然会中断,那么这个区别值得注意。
它是有代价的。“触发自动上下文管理的较长对话会消耗更多你的使用限制。”Anthropic 对此的建议是:“如果你在较长的对话中接近使用限制,请尝试开始新的对话。”
而且,总结终究只是总结。上下文窗口文章将其描述为 Claude 总结“先前的消息以腾出空间容纳新内容”。虽然完整的历史记录仍在,Claude 可以引用,但在对话本身中,现在由摘要代替了早期的消息,因此你关心的细节值得重新陈述。
人们首先会尝试的方法
等待限制重置。 这是针对使用限制的。长度限制是这单个对话的大小。
升级计划以获得更大的对话空间。 Anthropic 表示“你无法增加你计划中固定的上下文窗口大小”,尽管你可以更好地利用它。
将整个对话粘贴到新对话中。 这会带来相同的长度问题。
空手开始一个新对话。 这可行,但 Claude 开始时将没有你之前积累的背景信息。
解决方法:检查设置,精简对话承载的内容,然后用摘要重新开始
步骤 1:开启代码执行,或请求你的管理员开启
在免费、Pro 和 Max 计划中,Anthropic 关于文件创建的文章指出,代码执行“默认启用”,并给出了如果关闭时将其开启的路径:打开“设置”(Settings),然后选择“功能”(Capabilities),并开启“代码执行和文件创建”(Code execution and file creation)。在移动端,相同的开关位于“设置”中的“功能”下。
在 Team 和 Enterprise 计划中,这是一个组织设置。文章指出,对于 Team 组织和新的 Enterprise 组织,它默认启用,并且“组织所有者可以在组织设置中禁用它”。如果你的组织关闭了此功能,则不满足 Anthropic 提出的自动上下文管理条件,只有你的所有者才能更改它。
步骤 2:精简对话承载的内容
Anthropic 关于限制的文章列出了更好地利用窗口的方法。对长对话帮助最大的是:
- “关闭不需要的工具:在对话不需要时,关闭你连接的应用,并在不需要最新信息时,要求 Claude 不要搜索网页。”
- “关闭深度思考(extended thinking):当特定任务不需要 Claude 的增强推理时,关闭此功能。”
- “降低努力程度(effort level):对于不需要 Claude 最详尽回复的常规任务,选择较低的努力程度。较高的努力程度会消耗更多 token。”
对于你经常引用的文档,请将它们移至项目中。“项目使用检索增强生成(RAG),通过仅将相关内容加载到上下文窗口中,使 Claude 能够更高效地处理大量信息。”我们关于在 RAG 模式下使用 Claude 项目的指南 介绍了这如何改变 Claude 读取的内容。
步骤 3:使用交接摘要开始新对话
当对话完成了它的使命或无法继续时,Anthropic 的指导非常明确:“如果你达到了长度限制,你可以开始新对话,或使用项目等功能来更高效地处理大量信息。”
诀窍在于用重要的内容开始新对话。在离开旧对话之前,让 Claude 总结已做出的决定、当前的工作状态、未解决的问题以及下一步行动。保存它。将其粘贴到新对话的第一条消息中,并且只附加下一阶段工作所需的文件。
如果你使用的是付费计划,新对话还可以查找旧对话中的内容。Anthropic 表示:“使用付费计划(Pro、Max、Team 和 Enterprise)的用户可以提示 Claude 搜索以前的对话,并在新对话中引用相关信息。”我们关于让 Claude 记住以前对话的指南 介绍了对话搜索和记忆是如何协同工作的。
在 MemoryLake 中进行设置
一个漫长的 Claude 对话最终承载的不仅仅是当前的任务。它还包含决策、原因以及你下周还会需要的背景信息。当对话变得太长时,交接摘要就是这些上下文得以保留的地方,也是你希望在下一个项目、下一个对话或其他助手里能够使用的内容。
MemoryLake 是一个记忆层,用于将这些上下文保存在你维护的一个列表中,供 ChatGPT 以及你连接的其他助手(如 Claude Code 和 Codex)使用。
你用自己的话亲自编写这些条目。不会从你的 Claude 对话、你的 Claude 记忆、你的项目或任何供应商的存储中读取、写入或删除任何内容。对于工作内容,请遵守你组织关于在工具之外保留内容的政策。
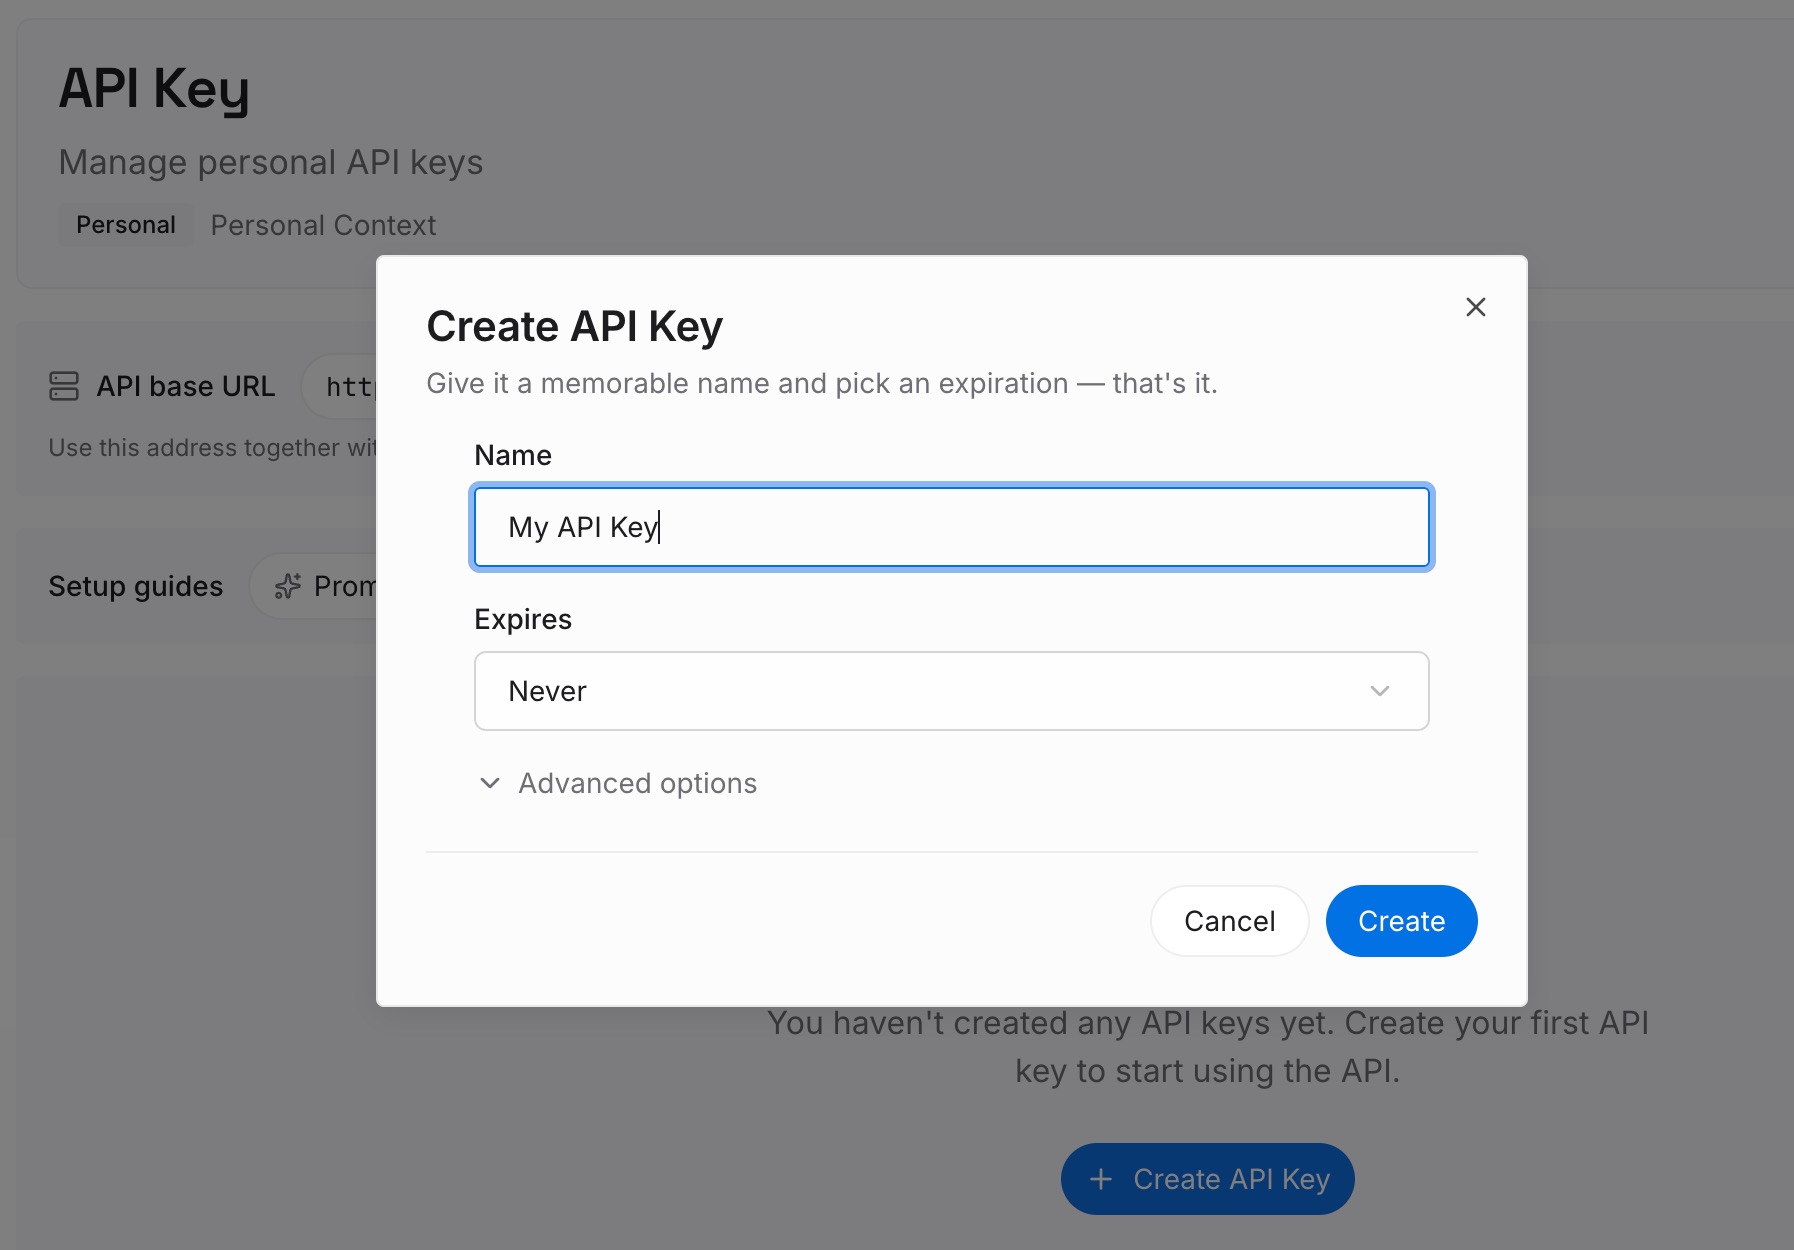
步骤 1:创建 API 密钥
登录并在控制面板中生成一个密钥。该密钥属于你的 MemoryLake 工作区,与你的 Claude 账户是分开的。
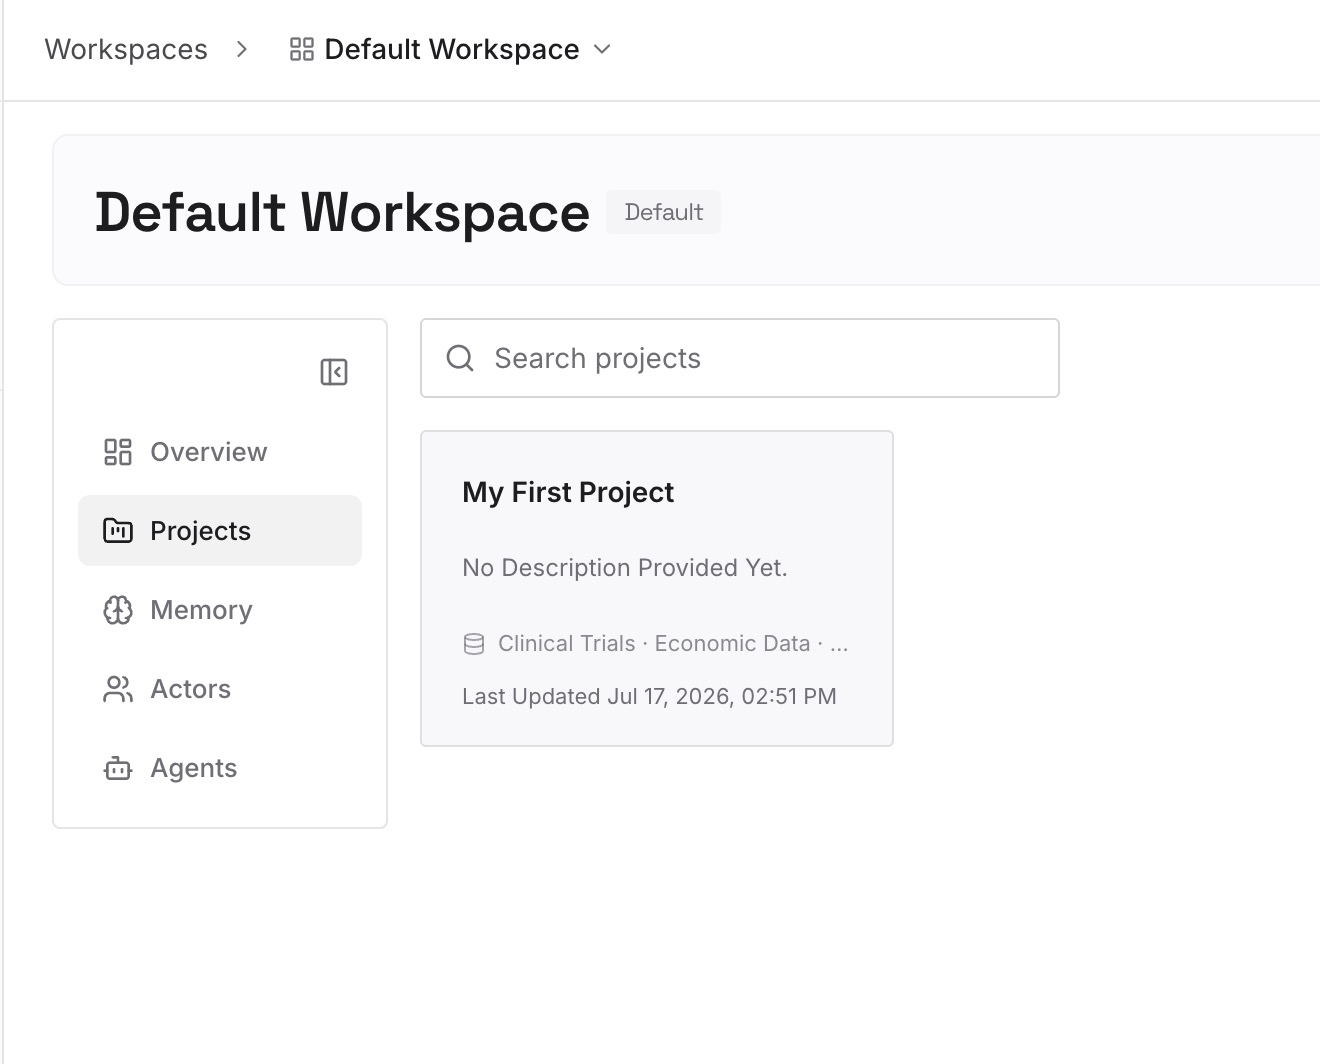
步骤 2:上传你的第一批记忆
从解决方法中步骤 3 的交接摘要开始:决策、当前状态和未解决的问题。每个条目一个要点,注明日期,并贴上其所属项目的标签。
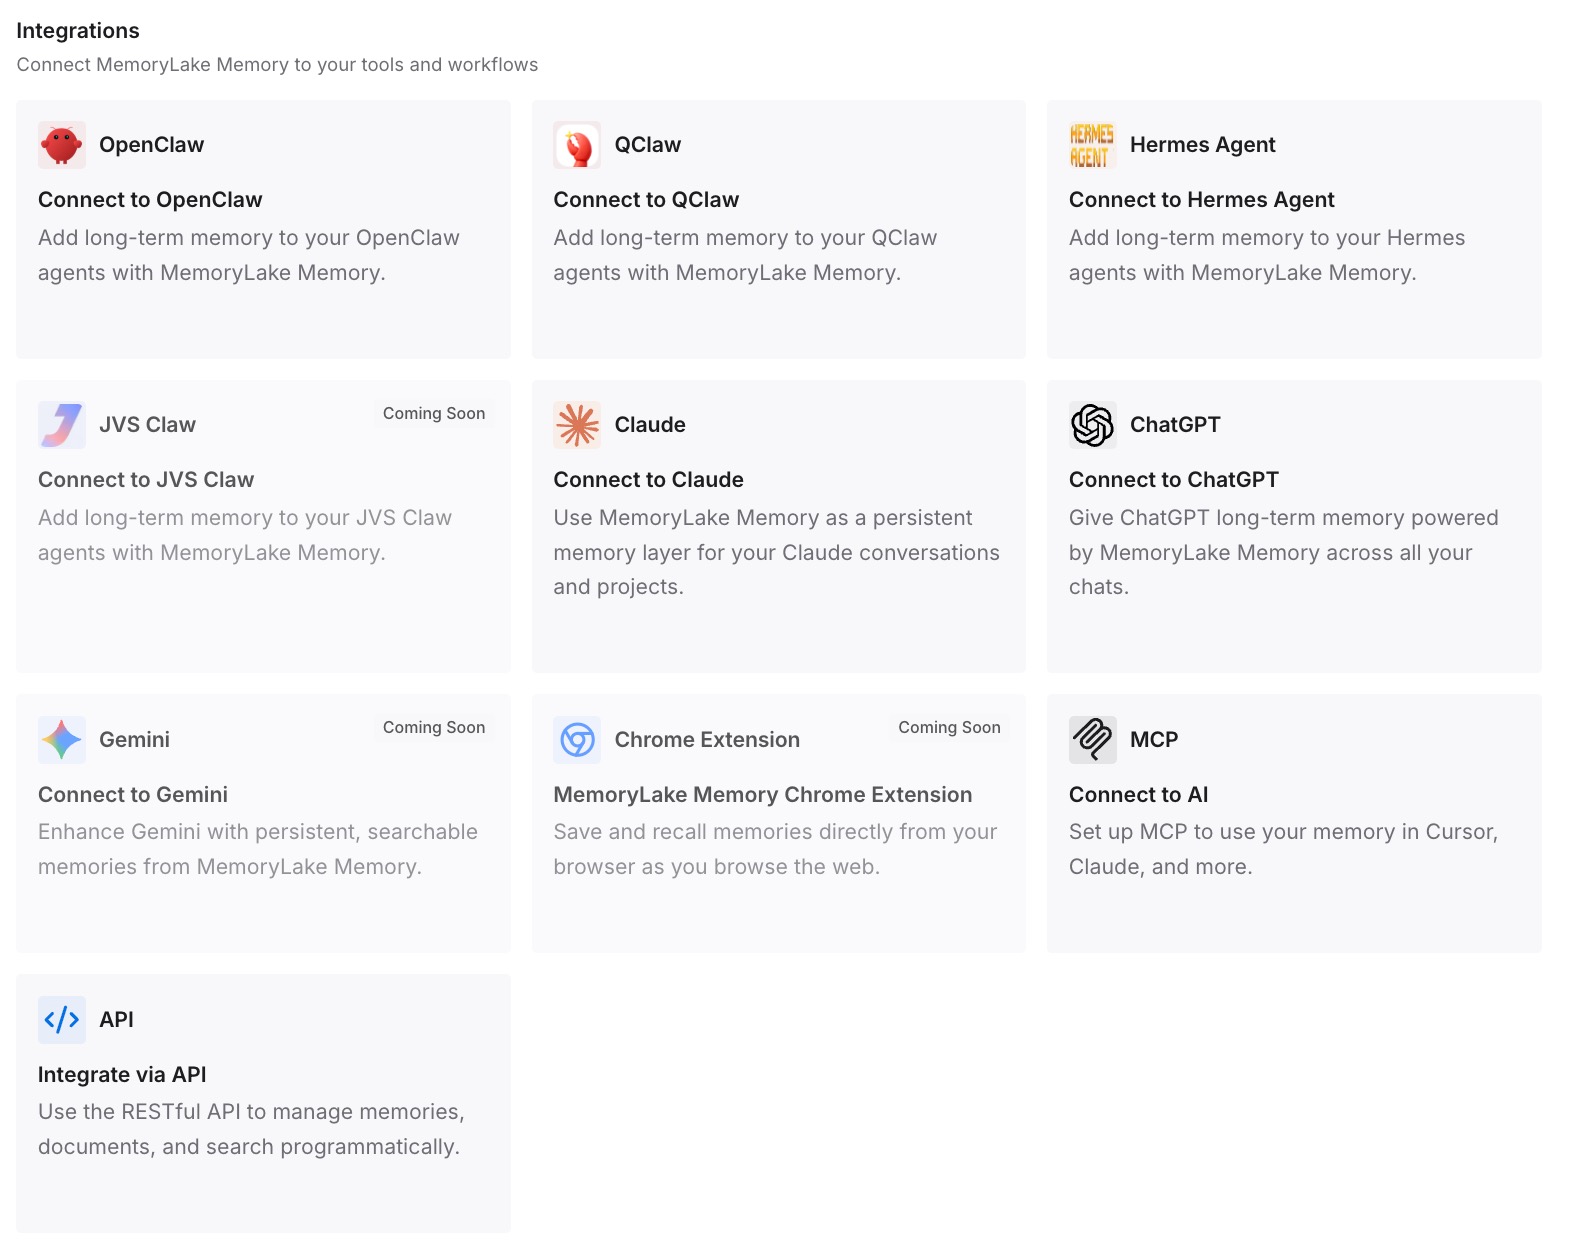
步骤 3:连接你的 AI 和智能体
连接 ChatGPT 和你使用的其他助手。下一个对话将从长对话积累的上下文开始,而不会继承其长度。
这在实践中带来了什么改变
第一个区别是,你清楚自己达到了哪种限制。长度限制是针对单个对话的,等待重置不会改变它。
第二个区别是,长对话可以维持得更久。开启代码执行、连接更少的工具,并将参考文件放入项目中,对话填满的速度就会变慢,自动上下文管理就能发挥作用。
第三个区别是,结束一个对话不再意味着丢失你的工作成果。摘要会随你进入下一个对话。如果你需要保留旧对话的完整记录,我们关于读取 Claude 数据导出的指南 涵盖了导出所包含的内容。
长 Claude 对话的最佳实践
首先检查代码执行。 自动上下文管理需要它。
了解你模型的窗口。 在对话中途切换模型会改变你拥有的空间大小。
关闭不使用的工具。 Anthropic 称工具和连接器是 token 密集型的。
将长参考文档放入项目中。 RAG 仅加载相关部分。
为不相关的工作开始新对话。 Anthropic 的 Cowork 提示也提到了这一点:“为不相关的工作开始新对话,这样 Claude 就不会携带额外的上下文。”
在离开长对话之前写一份交接摘要。 决策、状态、未解决的问题、下一步行动。
注意长对话中的使用量。 自动上下文管理会消耗更多你的限制额度。
如果 Claude 似乎遗忘了它在不同对话之间应该记住的事情,我们关于为什么 Claude 记忆不起作用的指南 涵盖了记忆设置。
结论
当对话填满模型的上下文窗口时,Claude 对话就会变得太长:消息、文件、工具结果和思考过程都会计算在内。在启用代码执行的情况下,Claude 会总结先前的消息并继续进行,代价是消耗更多使用额度。如果没有启用,或者第一条消息非常庞大,对话就会在达到长度限制时停止。
检查设置,精简对话携带的工具和文件,并将参考资料移至项目中。当一个对话结束时,用一个简短的决策摘要开始一个新对话,这样下一个对话就能从这一个结束的地方开始。