
为什么 Anthropic 给一个智能体配备两个记忆库
该指南从一个常见的问题开始。Anthropic 写道,自动化“可能会在无人注意的情况下失去对源的访问权限,或者无法遵循我们的偏好设置。”这句话的前后两半其实都是伪装的记忆问题。
之所以需要记忆,是因为“每次运行都在一个全新的沙箱中启动,没有上一次运行的记忆。”指南直接指出了后果:“没有记忆,反馈就无法留存。”但它同样直接指出了相反的风险:“陈旧的记忆会混淆智能体。”在它的例子中,一个带有过时记录的智能体在问题解决后仍报告该项正在等待处理,或者因为认为自己已经报告过而漏掉了一个未解决的项。
参考实现通过在 /mnt/memory/ 下挂载两个记忆库来解决这个问题。
第一个是偏好设置(preferences),被描述为“您的,对智能体只读”。它保存了“要读取哪些频道和仓库、要排除什么、长度限制、目的地以及何时停止”。
第二个是状态(state),被描述为“智能体的,可读写”。它保存了“书签、它报告内容的账本、每次运行的一条记录、它对您的偏好设置提出的修改建议,以及关于每个源行为方式的记录”。
并排阅读这两个列表,逻辑非常清晰。第一个记忆库中的所有内容都是您做出的决定。第二个记忆库中的所有内容都是智能体观察到或做过的事情。智能体被允许对您的偏好设置提出修改建议,但这些建议会进入它自己的记忆库。您的规则只有在您修改时才会改变。
为什么只读界限至关重要
Anthropic 的记忆文档解释了这种拆分所防范的风险。“默认情况下,记忆库以 read_write 权限挂载。”然后,它详细说明了该默认设置对于读取他人文本的智能体意味着什么:“如果智能体处理不可信的输入(用户提供的提示词、获取的网页内容或第三方工具输出),成功的提示词注入可能会将恶意内容写入记忆库。随后的会话就会将该内容作为可信记忆进行读取。”
随后给出了建议:“对于参考资料、共享查询以及智能体不需要修改的任何记忆库,请使用 read_only。”而且这并不是要求模型遵守的协定。“access 是在文件系统级别强制执行的:read_only 挂载会拒绝写入。”
自动化指南正是这样应用的。它的智能体读取其他人编写的 Slack 消息和 GitHub issue,指南承认“这些文本可能会被解释为指令”。因此,“GitHub 令牌和偏好设置记忆库是只读的,并且环境只能访问其白名单上的主机。”指南坦实地说明了这能保护什么,不能保护什么:“植入的指令仍然可以改变摘要的内容,包括通过智能体在运行之间保留的记录。但它无法写入 GitHub 或编辑您的规则。”
最后一句话是整个论点的缩影。智能体自己的记录暴露在它所读取的内容中,因此它们可能会出错。而您的规则保存在智能体无法写入的记忆库中,因此它们始终属于您。
为什么偏好设置的副本不如指针
指南指出了第二个更隐蔽的失败。“一个常见的问题是,偏好设置的副本被固化在提示词中,这会导致智能体继续应用您已经更改的规则。”解决方法是每次都读取源文件:“让智能体在每次运行时重新读取文件。如果无法读取文件,它应该停止并说明原因,而不是使用默认设置运行。”
这是关于记忆的普适教训,而不仅仅适用于 Managed Agents。偏好设置的任何副本,无论是在系统提示词、粘贴的简报还是缓存的摘要中,在创建的那一刻起就开始老化。指南给出的答案是:在每次运行开始时,读取一个权威位置。
人们尝试的其他替代方案
认为单个记忆库更简单。 设置起来确实更简单。但它也允许智能体重写它应该遵守的规则,并让它读取的任何内容泄露到这些规则中。Anthropic 的文档建议“当记忆的不同部分具有不同的所有者或访问规则时”挂载多个记忆库。
将偏好设置固化到系统提示词中。 这很方便,但指南将其列为常见问题:提示词会继续应用您后来已经更改的规则。
让智能体维护自己的规则。 智能体擅长发现模式,参考实现也利用了这一点。但它会将建议的更改路由到智能体自己的记忆库中供您审核,而不是让智能体直接应用它们。
相信“没有新内容”的报告。 指南展示了为什么这是不安全的。“如果一个 MCP 服务器宕机或其令牌已过期,运行仍会启动,只是没有该服务器的工具。”然后:“会话会记录错误,但智能体看不到来自该源的任何内容。”如果没有明确的规则,损坏的源看起来就像是平安无事的一天。
读取固定的时间窗口。 指南警告不要让智能体读取固定的时间窗口(例如过去一天)。“运行延迟会留下空白,而运行提前则会重复内容。”它的解决方案是:“相反,给智能体为每个源提供一个书签。”
解决方案:决定谁来写入每部分记忆,然后强制执行
步骤 1:按写入者对智能体应该记住的所有内容进行分类
列出您的智能体在运行之间需要携带的内容,然后将每项内容放入两个栏目之一。
第一栏是决策。要读取哪些源、什么算作重要内容、要排除什么、结果去向、长度限制以及何时停止。这些是属于您的。它们在您改变主意时改变,而不是在智能体观察到某些情况时改变。
第二栏是观察与进度。智能体在每个源中从哪里开始、它已经报告了什么、每次运行发生了什么,以及它了解到的关于每个源的特点。这些属于智能体,智能体应该在每次运行时更新它们。
任何无法清晰归类的内容通常是智能体想要施加影响的决策。在它自己的栏目中给它一个提出建议的地方,并按照您的日程安排审核这些建议。这与参考实现在状态记忆库中存储“它对您的偏好设置提出的修改建议”的方式相呼应。
步骤 2:将您的栏目放入智能体只能读取的记忆库中,并在每次运行时读取它
为您的偏好设置创建一个记忆库,并以 read_only 权限挂载它。自己编写偏好设置文件。在参考实现中,部署智能体“会创建偏好设置记忆库,但不会创建其中的文件”,而种子脚本会在首次运行前写入该文件。
然后添加指南推荐的指令:在每次运行开始时重新读取偏好设置,如果无法读取文件,则停止运行并给出明确的提示信息。不要同时将偏好设置粘贴到系统提示词中。两个副本会产生偏差。
如果多个智能体共享相同的参考资料(例如团队规范或术语表),同样的原则也适用。文档中描述了“一个只读记忆库挂载到多个会话(标准、规范、领域知识),与每个会话自己的读写记忆库保持分离”。
步骤 3:给智能体自己的记忆库配备账本、书签和诚实的失败提示
在读写记忆库中,给智能体提供三个结构。
每个源一个书签,在每次运行结束时写入,以便下一次运行准确地从上一次停止的地方开始读取。
一个账本。“智能体保留一个账本 ledger.md,记录它报告过的每一项内容,这样摘要就不会重复。”每一行都带有一个稳定的 ID 和该项的最新已知状态,这使得智能体能够报告变化而不是重复内容。
一个失败规则。当无法读取某个源时,指南中的智能体会“将该源的书签保持在原位,根据其他源编写摘要,并在摘要末尾用一行字说明无法读取的内容”。它的总结规则值得逐字复制:“将读取失败报告为不可读,绝不要报告为平安无事的一天。”
因为对读写记忆库的每次写入都会生成一个版本,所以您可以查看智能体记录了什么以及何时记录的。“对记忆的每次更改都会创建一个不可变的记忆版本。”当摘要看起来不对劲时,利用该历史记录;它可以显示智能体当时依赖的是哪条记录。关于为什么这种追踪很重要,请参阅 memory provenance explained。
在 MemoryLake 中进行设置
Anthropic 指南中的拆分在任何单一平台之外都有其自然的对应物。您的决策和偏好设置是您编写并希望每个智能体都遵守的部分。智能体无论在哪里运行,都会保留自己的工作记录。MemoryLake 是保存第一部分(即您编写的层)的地方,以便在您使用的各个智能体和助手之间保持一致。
您可以用自己的语言亲自编写这些条目。不会从 Anthropic 的记忆库、您智能体的工作记录或任何供应商的存储中读取、写入或删除任何内容。Anthropic 的记忆库保持原样,通过 Anthropic 自己的 API 进行管理。
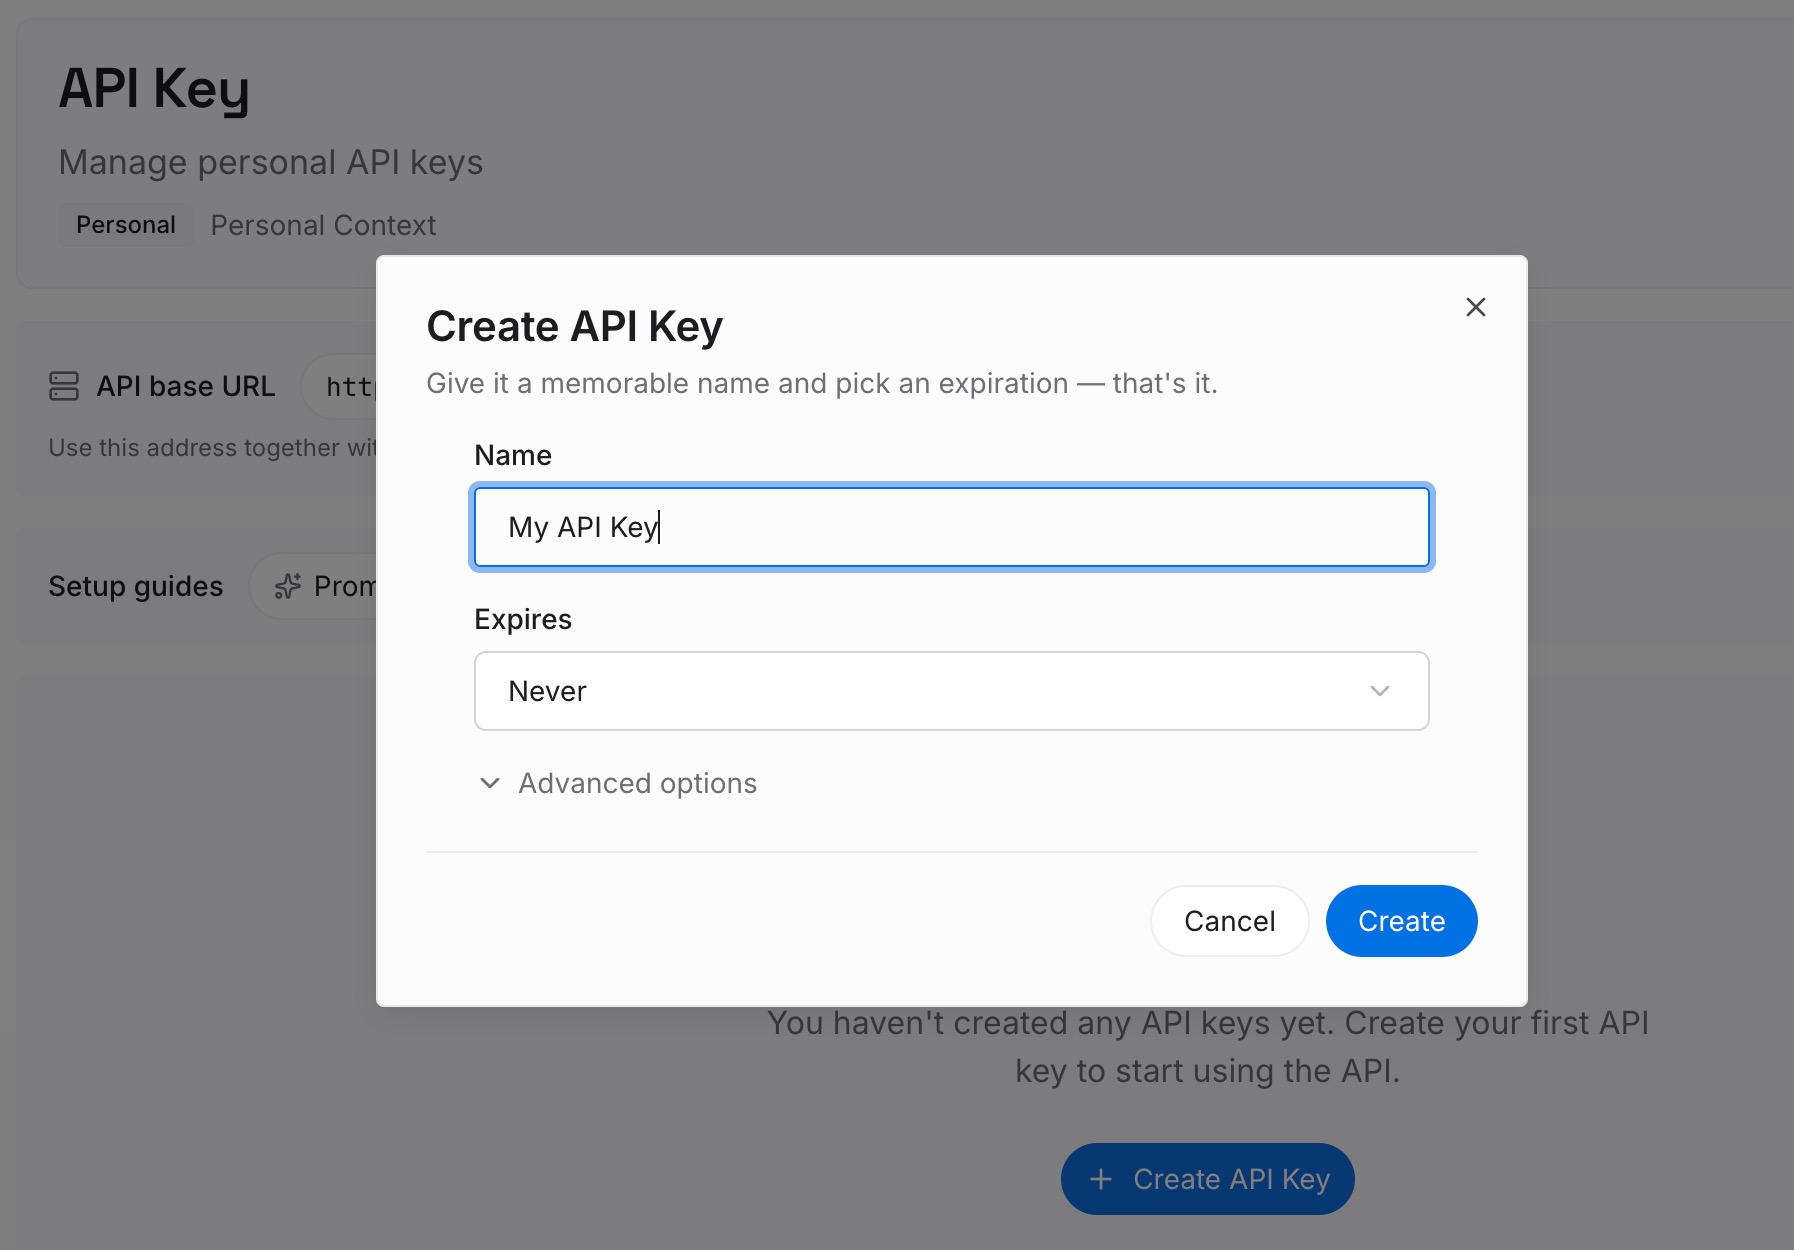
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥属于您的 MemoryLake 工作区,与您的 Claude Console 组织相互独立。
步骤 2:上传您的第一批记忆
从步骤 1 中的决策栏开始:对您而言重要的事情、要排除的内容以及您希望如何交付结果。每个条目对应一个偏好设置,并注明日期,以便更改清晰可见。
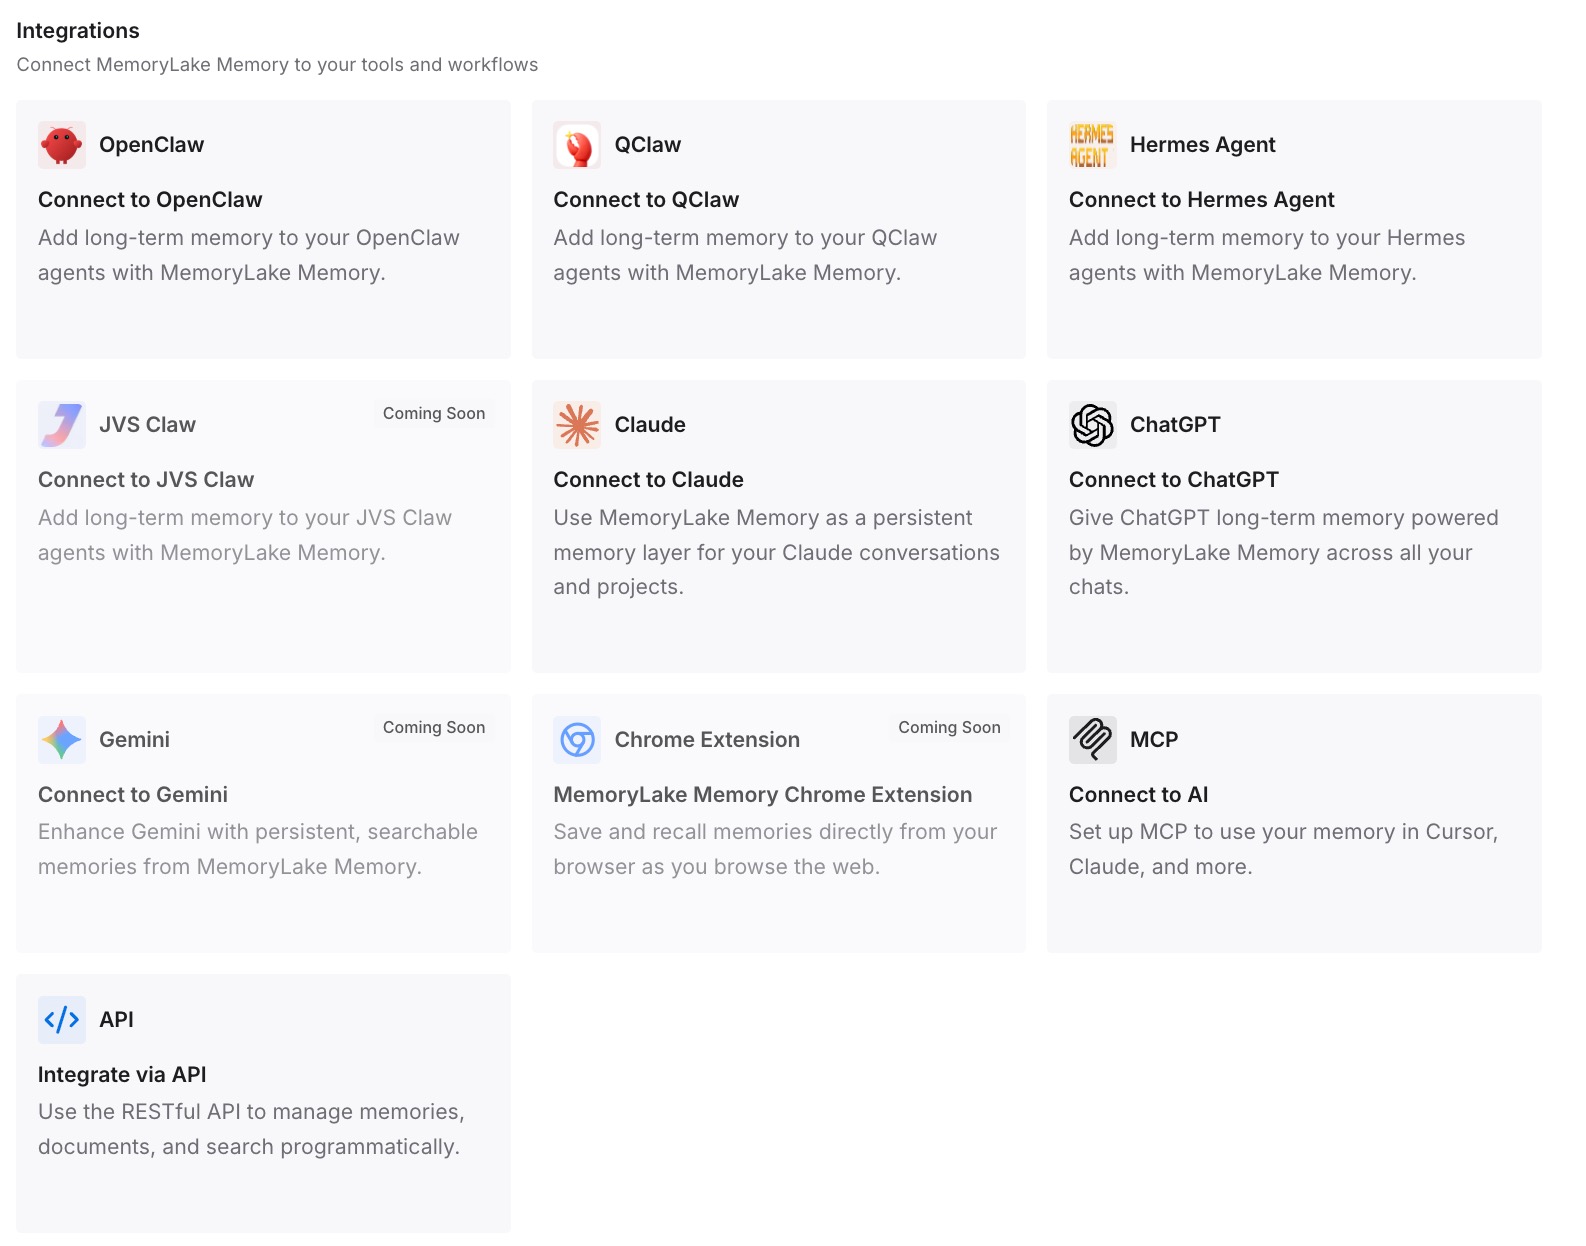
步骤 3:连接您的 AI 和智能体
连接您使用的助手和智能体。然后,您的偏好设置就可以作为一个统一的编写源使用,而不是固化在每个智能体提示词中的副本。
这在实践中改变了什么
第一个区别是规则不再发生偏差。由于偏好设置是从智能体无法编辑的记忆库中重新读取的,您所做的更改将在下一次运行时生效,智能体无法悄悄地重新解释它。
第二个区别是爆炸半径更小。正如 Anthropic 坦言,智能体读取的文本仍然会影响它在自己记录中写入的内容。但它无法重写约束它的规则。
第三个区别是诚实的输出。账本和书签意味着智能体报告的是变化而不是重复,而失败提示行意味着损坏的源会显示为损坏。同样的问题也出现在消费级工具中;stopping ChatGPT's scheduled tasks from starting over every run 涵盖了大多数人最先遇到的版本。
第四个区别是可审核的学习。建议的偏好设置更改会保留在智能体的记忆库中,直到您接受它们。这比智能体自我更新是一个更干净的闭环,这一主题在 self-improving agents without retraining 中有深入探讨。
定时运行智能体记忆的最佳实践
将决策与观察分离。 决策放入您编写的记忆库中;观察放入智能体的记忆库中。
将您的记忆库设为只读。 Anthropic 在文件系统级别强制执行此操作,因此请加以利用。
每次运行都重新读取偏好设置。 绝不要在提示词中保留第二个副本。
当无法读取偏好设置时停止运行。 使用默认设置运行比清晰的失败提示信息更糟糕。
使用书签,而不是时间窗口。 每次运行都准确地从上一次停止的地方开始。
明确报告不可读的源。 平安无事的一天和损坏的令牌必须看起来不同。
审核智能体写入的内容。 记忆版本会显示发生了什么变化。关于 Cowork 中的相关模式,请参阅 controlling whether a Cowork scheduled task uses your memory;关于 Anthropic 的后台整合,请参阅 how Claude's Dreams rebuild an agent's memory store。关于记忆存在何处以及谁可以访问它们的更广泛问题,在 the security problem nobody discusses 中有详细讨论。
结论
Anthropic 针对定时运行智能体的参考实现为单个智能体配备了两个记忆库。一个保存您的偏好设置,对智能体是只读的。另一个保存智能体的书签、账本、运行记录、建议的更改和记录,是可读写的。其原因正如 Anthropic 自己所说:陈旧的记忆会混淆智能体,偏好设置的副本会继续应用旧规则,而暴露在不可信输入下的读写记忆库可能会将注入的指令带入随后的运行中。
这种设计很容易复制。决定谁来写入每部分记忆,通过访问模式强制执行,每次运行都重新读取您的规则,并让智能体在无法查看某些内容时告知您。
指南以适用于整个方法的一条建议结束:“以此为起点,并根据您的源、目的地或记忆偏好设置来定制智能体。”