Fork 一个 Codex 对话的方法
使用 /fork fork 你当前所在的对话
在 Codex CLI 中,输入 /fork 并按回车。斜杠命令文档列出了以下步骤:“如果 Codex 提供了检出选择,请选择当前目录或一个新的 worktree。” 用文档的话来说,结果是:“Codex 将当前对话克隆到一个具有全新 ID 的新对话中,保持原始记录完好无损,以便你可以并行探索替代方法。”
全新的 ID 在以后会很重要。原始对话和 fork 对话现在是两个独立的已保存对话,从此时起各自拥有自己的历史记录。
从终端使用 codex fork fork 已保存的对话
要 fork 一个你当前不在其中的对话,请从终端运行 codex fork。命令行参考中写道:“默认情况下,codex fork 会打开会话选择器;添加 --last 可以改为 fork 你最近的会话。” 你也可以传递一个会话 ID。
如果你所在的目录与保存对话的目录不同,Codex 会询问在哪里工作。参考中写道:“当当前会话目录与保存的会话目录不同时,codex fork 会使用与 codex resume 相同的当前工作目录提示和 tui.resume_cwd 设置。”
从更早的消息进行 fork
有时分支点并不是现在。而是在三条消息之前,在 Codex 走向你想避免的路径之前。CLI 参考描述了一个快捷键:“在输入框为空时按两次 Escape,即可编辑上一个用户消息并从该点 fork 对话。”
Codex 的“新功能”页面记录了该应用在 2 月份加入了 fork 功能(“该应用还添加了对话 fork 功能”),并在 3 月份的一条记录中写道:“你可以从更早的消息 fork 对话,从而更容易地尝试新方法,而不会丢失原始路径。”
使用 /side 提一个旁支问题
并非每一次绕道都需要完整的 fork。斜杠命令文档将 /side 描述为一种“从当前对话启动临时 fork 而无需切换出主对话”的方式。旁支对话的记录“与父对话是分开的”,当你处于其中时,TUI 会继续显示父对话的状态。
可以用它来快速提问关于方案的问题、检查风险,或者获取你不希望干扰主对话的解释。文档指出:“/side 在另一个旁支对话中以及在评审模式下不可用。”
在不启动交互式会话的情况下进行 fork
对于脚本,codex exec fork 会将已保存的会话复制到一个新会话中。参考中写道:“在没有提示词的情况下,Codex 会创建 fork 而不启动轮次。” 添加提示词,fork 就会立即开始处理它。
Fork 携带了什么,以及留下了什么
对话内容会随之带走
Fork 会从截至 fork 点的完整记录开始。你不需要重新解释任务、涉及的文件或已经做出的决定。这就是选择 fork 而不是开始新对话的主要原因。
你的文件取决于你选择的检出方式
这是需要提前规划的部分。Fork 复制的是对话,而不是工作目录。如果你 fork 到当前目录中,原始对话和 fork 对话将处理相同的文件。无论 fork 修改了什么,原始对话都会在磁盘上看到,反之亦然。
对于需要修改代码的实验,请 fork 到一个 worktree 中。在 CLI 中,codex fork <SESSION_ID> --worktree 可以实现这一点,参考指出它“需要显式的会话 ID 和本地执行;它不支持 --last 或会话选择器”。在 /fork 中,当 Codex 提供检出选择时,选择一个新的 worktree。
worktrees 文档解释了你将获得什么:“每个 worktree 都有你仓库中每个文件的独立副本,但它们都共享关于提交、分支等的相同元数据(.git 文件夹)。” 对于桌面应用管理的 worktree,“起始提交是你在开始对话时所选分支的 HEAD 提交”,并且“如果你选择了一个包含本地更改的分支,Codex 也会将未提交的更改应用到该 worktree 中”。
Git 忽略的文件情况有所不同。文档指出:“Codex 仅复制与 .worktreeinclude 匹配的被忽略文件;它不会复制 Git 未跟踪的其他本地文件。” 如果你的项目需要 .env 文件才能运行,请将其列在 .worktreeinclude 中,否则实验可能无法像原始对话那样启动。有一个例外已为你处理:“Codex 会自动将一个被忽略的 AGENTS.override.md 复制到本地托管的 worktree 中”。文档补充说,这种行为“适用于本地 ChatGPT 桌面应用托管的 worktree,而不适用于远程 worktree 或你自己在命令行中创建的 Git worktree”。
指令来自仓库,而不是对话
AGENTS.md 不是对话的一部分。它是你仓库中的一个文件,因此 fork 会读取与原始对话相同的受跟踪 AGENTS.md。如果你 fork 到一个 worktree 中并在那里编辑 AGENTS.md,原始对话在切换到其自身的检出之前是看不到该更改的。我们关于为什么 Codex 会跳过 AGENTS.md 规则的指南介绍了 Codex 如何查找和合并这些文件。
记忆是单机独立的,并带有单对话开关
Codex 的本地记忆保存在你的 Codex 主目录下,默认位于 ~/.codex/memories/。它们由该机器上的每个对话共享,因此 fork 会使用与原始对话相同的存储。你可以针对每个对话设置的是该对话是否使用记忆并对其做出贡献。记忆文档指出:“使用 /memories 来控制当前对话的记忆行为”,以及“对话级别的选择不会改变你的全局记忆设置”。
文档没有说明 fork 是否会保留原始对话的 /memories 选择,因此如果这很重要,请在 fork 中进行检查。如果你是为了故意尝试一个糟糕的想法而进行 fork,你可能不希望该对话影响未来的记忆。我们关于 Codex 本地记忆的指南介绍了它们是如何生成和重置的。
Fork 的发现会留在 fork 中
Fork 文档描述了将一个对话复制到新对话中。它并没有描述如何将 fork 的对话合并回原始对话。无论 fork 发现了什么,都会留在 fork 的记录中。如果实验成功了,除非你告诉它,否则原始对话是不会知道的。
共享的快照无法被 fork
如果有人给你发送了一个共享的 Codex 对话,你可以阅读它,但你无法从他们中断的地方继续。文档指出:“你无法从共享快照中 fork 原始线程。你可以将快照作为附件导入,并在新线程中引用它。” 共享快照还遗漏了很多内容。它们“不包括原始线程的工具调用、Shell 命令或工具输入或输出”。
导致 fork 出错的假设
假设 fork 拥有自己的文件。 它拥有自己的对话。它的文件取决于你选择的检出方式。在当前目录中,两个对话编辑的是相同的代码。
假设原始对话会了解 fork 的发现。 从 fork 点开始,这两个记录就是相互独立的。
假设 worktree 拥有你项目所需的一切。 受跟踪的文件确实有。但被忽略的文件只有在与 .worktreeinclude 匹配时才会有。
在只想提问时进行 fork。 为了进行一次性检查而进行完整的 fork 会给你留下一个需要管理的额外已保存对话。/side 就是为此而设计的。
在工作实际上并未分支时进行 fork。 Codex 的最佳实践非常直接:“每个连贯的工作单元保持一个对话。如果工作仍然是同一个问题的一部分,留在同一个对话中通常更好,因为这样可以保留推理轨迹。只有在工作真正产生分支时才进行 fork。”
解决方法:确定工作是否分支,fork 到正确的检出中,然后将结果带回
步骤 1:决定你是需要 fork、旁支对话,还是都不需要
问问自己接下来要做什么。如果是关于当前工作的快速提问,请使用 /side。如果这是一种会产生不同代码的截然不同的方法,请进行 fork。如果是同一个问题的下一步,请留在原地。
如果分支点在你之前,请在 CLI 中使用 Escape 快捷键,这样 fork 就会在你想要撤销的轮次之前开始。
步骤 2:当两个对话都会修改文件时,fork 到一个 worktree 中
如果实验会编辑代码,并且你希望保留原始对话的文件,请 fork 到一个 worktree 中。在你依赖它之前,检查该 worktree 是否拥有项目运行所需的内容:将忽略的配置文件一次性添加到 .worktreeinclude 中,这样每个托管的 worktree 都会获取它们。
如果你是为了在不编辑任何内容的情况下比较方案而进行 fork,那么 fork 到当前目录就可以了。
然后为这两个对话命名,以便区分它们。根据文档,/rename 命令“更新已保存的对话名称,而不改变其记录”。根据原始对话所采用的方法为其命名,并根据替代方案为 fork 命名。在桌面应用中,置顶你要继续的那个对话。
步骤 3:写下 fork 的决定,并将其带回
当实验结束时,决定继续哪个对话。如果 fork 的方法胜出,要么在 fork 中继续,要么自己将结果带入原始对话中:包括更改、它为什么起作用以及你排除了什么。
如果该决定也应该适用于未来的对话,请将其放入 AGENTS.md 或你的项目文档中。Codex 的记忆文档给出了原因:“将所需的团队指南保留在 AGENTS.md 或已签入的文档中。将记忆视为一个有帮助的召回层,而不是必须始终适用的规则的唯一来源。”
如果你想与他人分享结果,请记住共享快照可以被阅读和附加,但不能被 fork。将结论与链接一起告诉他们。
在 MemoryLake 中进行设置
Fork 会使对话成倍增加。经过几次实验后,决策背后的推理可能会分散在原始对话、两个 fork 和一个旁支对话中,而它们彼此之间都互不知晓。
MemoryLake 是一个记忆层,用于将结论保存在你维护的一个列表中,供 Codex 以及你连接的其他助手(如 ChatGPT 和 Claude Code)使用,无论这些结论来自哪个对话。
你自己用自己的话编写这些条目。不会从你的 Codex 对话、你的 worktree、你的 ~/.codex 目录或其记忆、你的 AGENTS.md 文件或任何供应商的存储中读取、写入或删除任何内容。请排除机密和凭据,并遵守你组织关于项目细节的政策。
步骤 1:创建 API 密钥
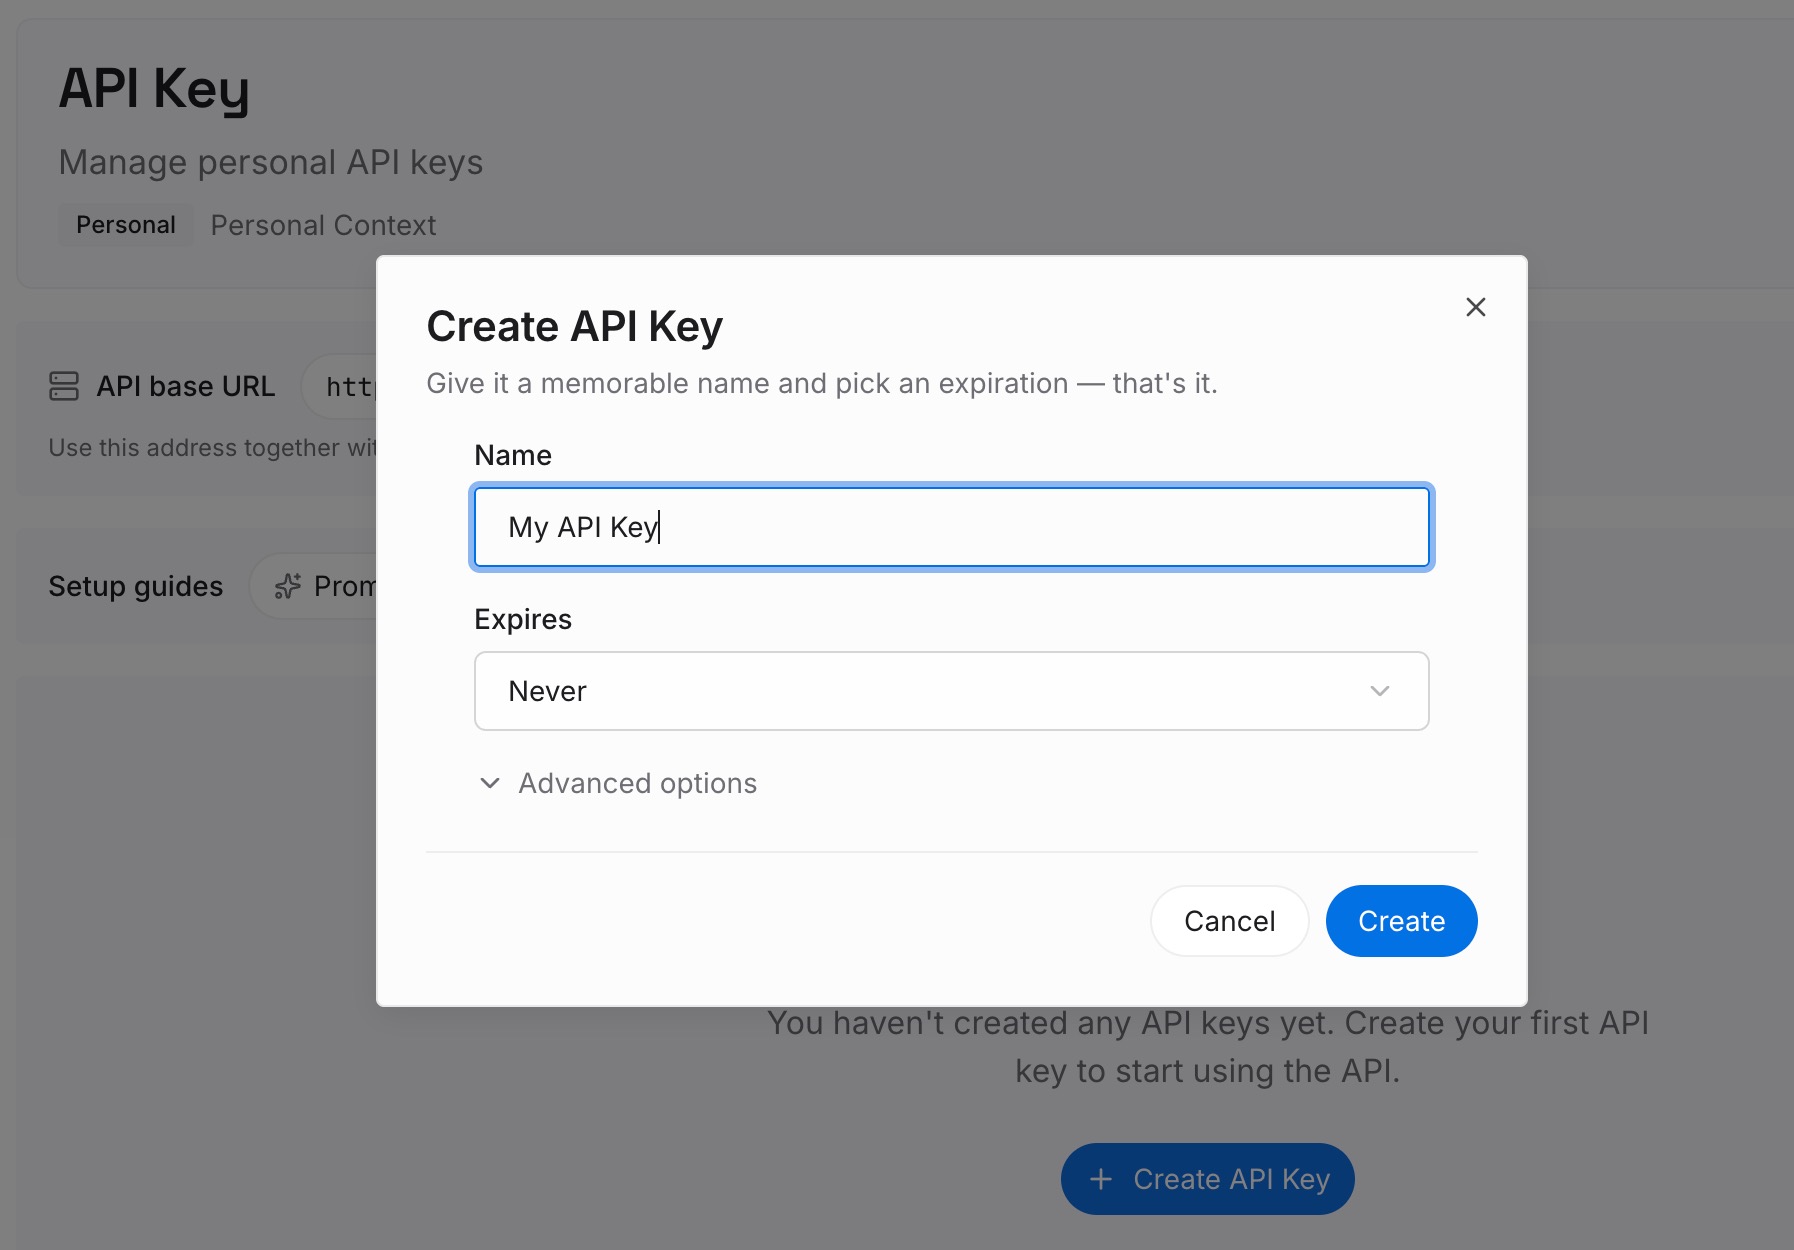
登录并从控制面板生成一个密钥。该密钥属于你的 MemoryLake 工作区,与你的 ChatGPT 账号是分开的。
步骤 2:上传你的第一批记忆
从你最近的几次 fork 开始。对于每一次,写下哪种方法胜出、原因以及失败的方法给你带来了什么启示。每个条目记录一个决策,注明日期,并写明其适用的仓库。
步骤 3:连接你的 AI 和智能体
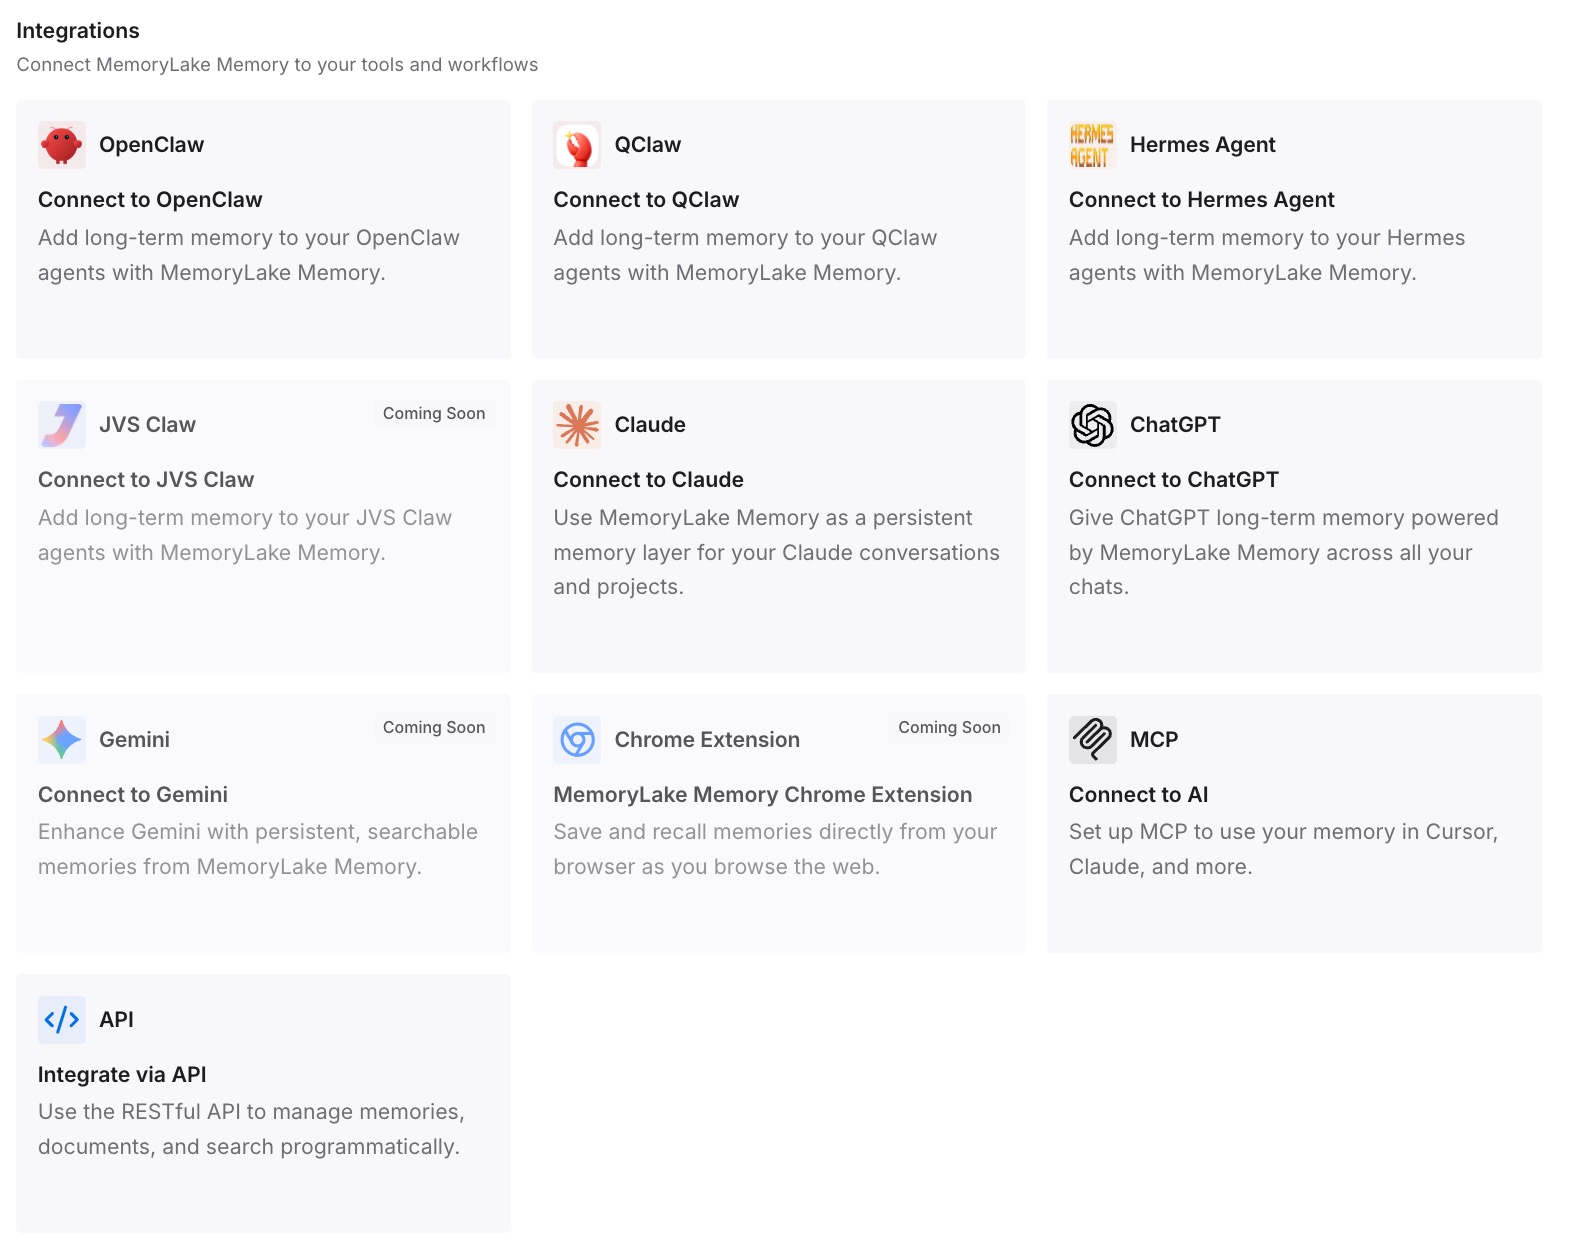
连接 Codex 和你使用的其他助手。下一个对话,无论是 fork 的还是全新的,都可以从你已经决定的内容开始。
这在实践中改变了什么
第一个区别是实验不再让原始对话面临风险。通过使用 worktree,fork 拥有自己的文件,而原始对话的代码保持原样。
第二个区别是你可以区分你的对话。命名的对话,以及关于何时 fork 和何时使用 /side 的明确规则,使会话列表保持清晰易读。
第三个区别是结果不会孤立在 fork 中。将结论写入原始对话、AGENTS.md 或你维护的列表中,意味着下一个对话会知道你发现了什么。如果你以后需要查找较旧的对话或 fork,我们关于查找丢失的 Codex 对话历史记录的指南介绍了 Codex 将它们保存在哪里。关于为什么新对话可能不记得项目,请参阅我们关于为什么 Codex 会遗忘项目上下文的指南。
Fork Codex 对话的最佳实践
仅在工作产生分支时进行 fork。 对于同一个问题的下一步,留在同一个对话中。
使用 /side 提问。 这样可以避免旁支问题干扰主记录,而无需创建完整的 fork。
针对代码更改,fork 到一个 worktree 中。 否则两个对话都会编辑相同的文件。
一次性设置好 .worktreeinclude。 否则,项目所需的被忽略文件(如 .env)将不会出现在新的 worktree 中。
为两个对话命名。 使用 /rename,以便选择器显示哪种方法对应哪个对话。
在 fork 中检查 /memories。 决定实验是否应该影响未来的记忆。
将结果带回。 将决策写入你继续的对话中,或者如果它应该长期有效,则写入 AGENTS.md 中。
结论
Fork 一个 Codex 对话会将对话复制到一个具有全新 ID 的新对话中,并保持原始对话完好无损。你可以使用 /fork fork 你当前所在的对话,使用 codex fork fork 已保存的对话,使用 Escape 快捷键从更早的时间点进行 fork,或者使用 /side 提一个旁支问题。Fork 无法做到的是为自己提供独立的文件(除非你选择 worktree)、将发现合并回去,或者从共享快照中进行操作。
确定工作是否真的产生了分支,在两个对话都会修改文件时 fork 到一个 worktree 中,为两个对话命名,并在完成后将结果带回。这样,实验就能对原始对话有所帮助,而不是取代它。