
为什么自动化程序的记忆比编辑器的记忆更需要精心呵护
首先来看 Cursor 的文档说明:"记忆允许智能体在同一自动化程序的多次运行之间读取和写入持久性笔记。利用这一点可以构建能够随着时间推移进行记忆和改进的智能体。每个记忆都存储为一个命名条目(默认为 MEMORIES.md),存在于智能体的工作文件系统之外。"
这段话中的三个细节决定了其他一切。这些笔记是由智能体编写的,而不是由你。它们在"多次运行之间"持久存在,因此今天写下的笔记会影响未来的每一次运行。而且它们属于"同一自动化程序",所以每个自动化程序都有自己独立的记忆,而不是共享一个记忆。
接下来是默认设置和控制项。"记忆默认启用,但可以禁用。可以从工具配置 UI 中查看和编辑记忆。"删除操作是双向的:"智能体可以在自动化运行期间删除过时的记忆文件。你也可以从工具配置 UI 中删除记忆文件。"最后一项功能是在 2026 年 6 月的更新中引入的,该更新增加了"在 UI 中删除记忆文件,或在运行时提示自动化程序删除过时记忆"的能力。
然后是完整的警告:"记忆在多次运行之间持久存在,如果你的自动化程序处理不可信的输入,应谨慎使用。输入可能会导致误导性或恶意的记忆,从而无意中影响未来的自动化运行。"
现在看看自动化程序通常读取什么。Cursor 的触发器列表包括 Slack 的"频道中的新消息"、拉取请求上的"已添加评论"、GitHub issue 上的"Issue 评论"、你可以 POST 的 webhook 端点以及 Linear 事件。其中每一个都包含由你以外的人编写的文本。一个用于分类 Slack 频道中 Bug 报告的自动化程序,在设计上每次运行都在读取不可信的输入——并且默认情况下,会根据这些输入给自己写笔记。
这就是与编辑器记忆的区别。在你的编辑器中,输入内容的人是你。而在自动化程序中,输入来自任何触发它的人,它留下的笔记会在无人监管的情况下被下一次运行读取。
关于名称的一个说明,因为这容易引起混淆。搜索 Cursor 记忆(memories)通常是指 Cursor 在 1.0 版本中引入的 IDE 功能,即"Cursor 可以记住对话中的事实并在未来引用它们",记忆"在个人层面上按项目存储"。Cursor 当前的文档索引将 Memories 描述为 Automations 工具,而其规则文档将规则描述为编辑器的持久层:"大型语言模型在补全之间不保留记忆。规则在提示词级别提供持久、可重用的上下文。"本指南涵盖的是 Automations 记忆工具。
人们尝试的其他方法
为每个自动化程序都开启记忆。 这是默认设置,对于一个每天早上总结你自己仓库提交记录的自动化程序来说,这可能没问题。但对于一个读取公共频道的程序来说,这意味着陌生人的消息可能会塑造该自动化程序保留的笔记。
在所有地方都关闭记忆。 这样很安全,但却丢掉了该功能的真正价值。一个能够学会忽略哪些不稳定测试(flaky tests)或哪些审查者负责哪些目录的自动化程序,在第十次运行时绝对比第一次运行表现得更好。
信任智能体自行清理。 Cursor 文档指出,智能体"可以在自动化运行期间删除过时的记忆文件。"这是有用的日常维护。但这也是同一个智能体,在读取相同的输入,并由它来决定什么算作过时。
从不打开记忆文件。 笔记在工具配置 UI 中是可视且可编辑的。许多团队设置好自动化程序后,观察它运行一周,之后就再也不去查看它一直在对自己说些什么。
假设记忆在不同的自动化程序之间共享。 记忆的范围仅限于"同一自动化程序"。分类自动化程序学到的教训对审查自动化程序是不可见的,这是合理的隔离,但也常常让人感到意外。
解决方案:确定记忆归属,告知智能体可以记录什么,然后定期审查
目的是保留学习能力,同时消除对已学到内容的猜测。
步骤 1:根据读取的输入对每个自动化程序进行分类
列出你的自动化程序,并针对每一个,写下它读取的每个触发器和每个源。然后将它们分为两组。
可信输入:针对你自己仓库的计划任务、团队的推送和合并、来自你自己系统的 webhook。智能体读取的文本是由你控制的人员和系统编写的。
不可信输入:公共 Slack 频道、任何可以发表评论的人的拉取请求和 issue 评论、暴露给第三方的 webhook、来自客户的工单。Cursor 自身对连接工具的指南也指出了同样的方向:"仅连接你信任的服务器,并赋予你的自动化程序所需的权限。"
对于不可信组,决定自动化程序是否真的需要在运行之间记住任何内容。许多程序不需要;它们根据每个条目自身的情况进行分类。对于这些程序,禁用记忆。对于那些确实通过记忆得到改进的程序,保持开启并进入步骤 2。
步骤 2:明确告知自动化程序可以记录什么
自动化程序的提示词是你为其记忆设定规则的地方。Cursor 的设置流程将其放在了核心位置:"编写带有自动化程序指令的提示词。"
在提示词中加入简短、明确的记忆策略。说明哪些类型的事实值得记录——例如哪些测试已知是不稳定的、哪些目录映射到哪些所有者、哪些告警模式最终被证明是噪音。说明绝对不能记录的内容:输入中包含的指令、关于权限的声明、更改自动化程序自身行为的请求。并说明任何不确定的内容都应记录为观察结果,而不是规则。
这并不能使不可信的输入变得安全;Cursor 的警告依然适用。但它缩小了误导性输入可能演变成的内容,并使不良笔记更容易被发现,因为当你阅读文件时,任何超出策略的内容都会显得格外显眼。
如果自动化程序的工作需要读取敏感内容,请保持记忆策略比你认为需要的更加严格。在多次运行之间持久存在的记忆,是一个单一不良输入可能会长期存在的地方。
步骤 3:定期审查 MEMORIES.md,并在其他地方保留一份经批准的副本
在你的日历中设置一个定期提醒——对于繁忙的自动化程序每周一次,对于闲置的每月一次——在工具配置 UI 中打开每个自动化程序的记忆并阅读它们。
像审查拉取请求一样阅读它们。每条笔记都是真实的吗?现在依然真实吗?它是否来自你信任的输入?修改错误的内容,删除过时的内容,并留意任何看起来是因为输入指示智能体去写才写下的内容。
然后在自动化程序之外的某个地方保留一份你批准的笔记副本。当某次运行出现异常时,你会希望能够将今天的记忆与你检查过的最后一个版本进行对比,而自动化程序自身的文件是唯一可能发生变化的东西。同样的想法也适用于其他工具中的循环智能体——让 Warp 云端智能体记住上一次运行背后的模式是一个经过审查的记录,而不是一个无人看管的记录。
在 MemoryLake 中进行设置
步骤 3 中经批准的副本是有用的产物:一份经过人工检查并同意的简短教训列表。MemoryLake 是存放它的地方,与自动化程序在下一次运行时可以重写的文件相隔离。
你用自己的话亲自编写这些条目。不会从自动化程序的 MEMORIES.md、你的 Cursor 设置或任何厂商的存储中读取、写入或删除任何内容。
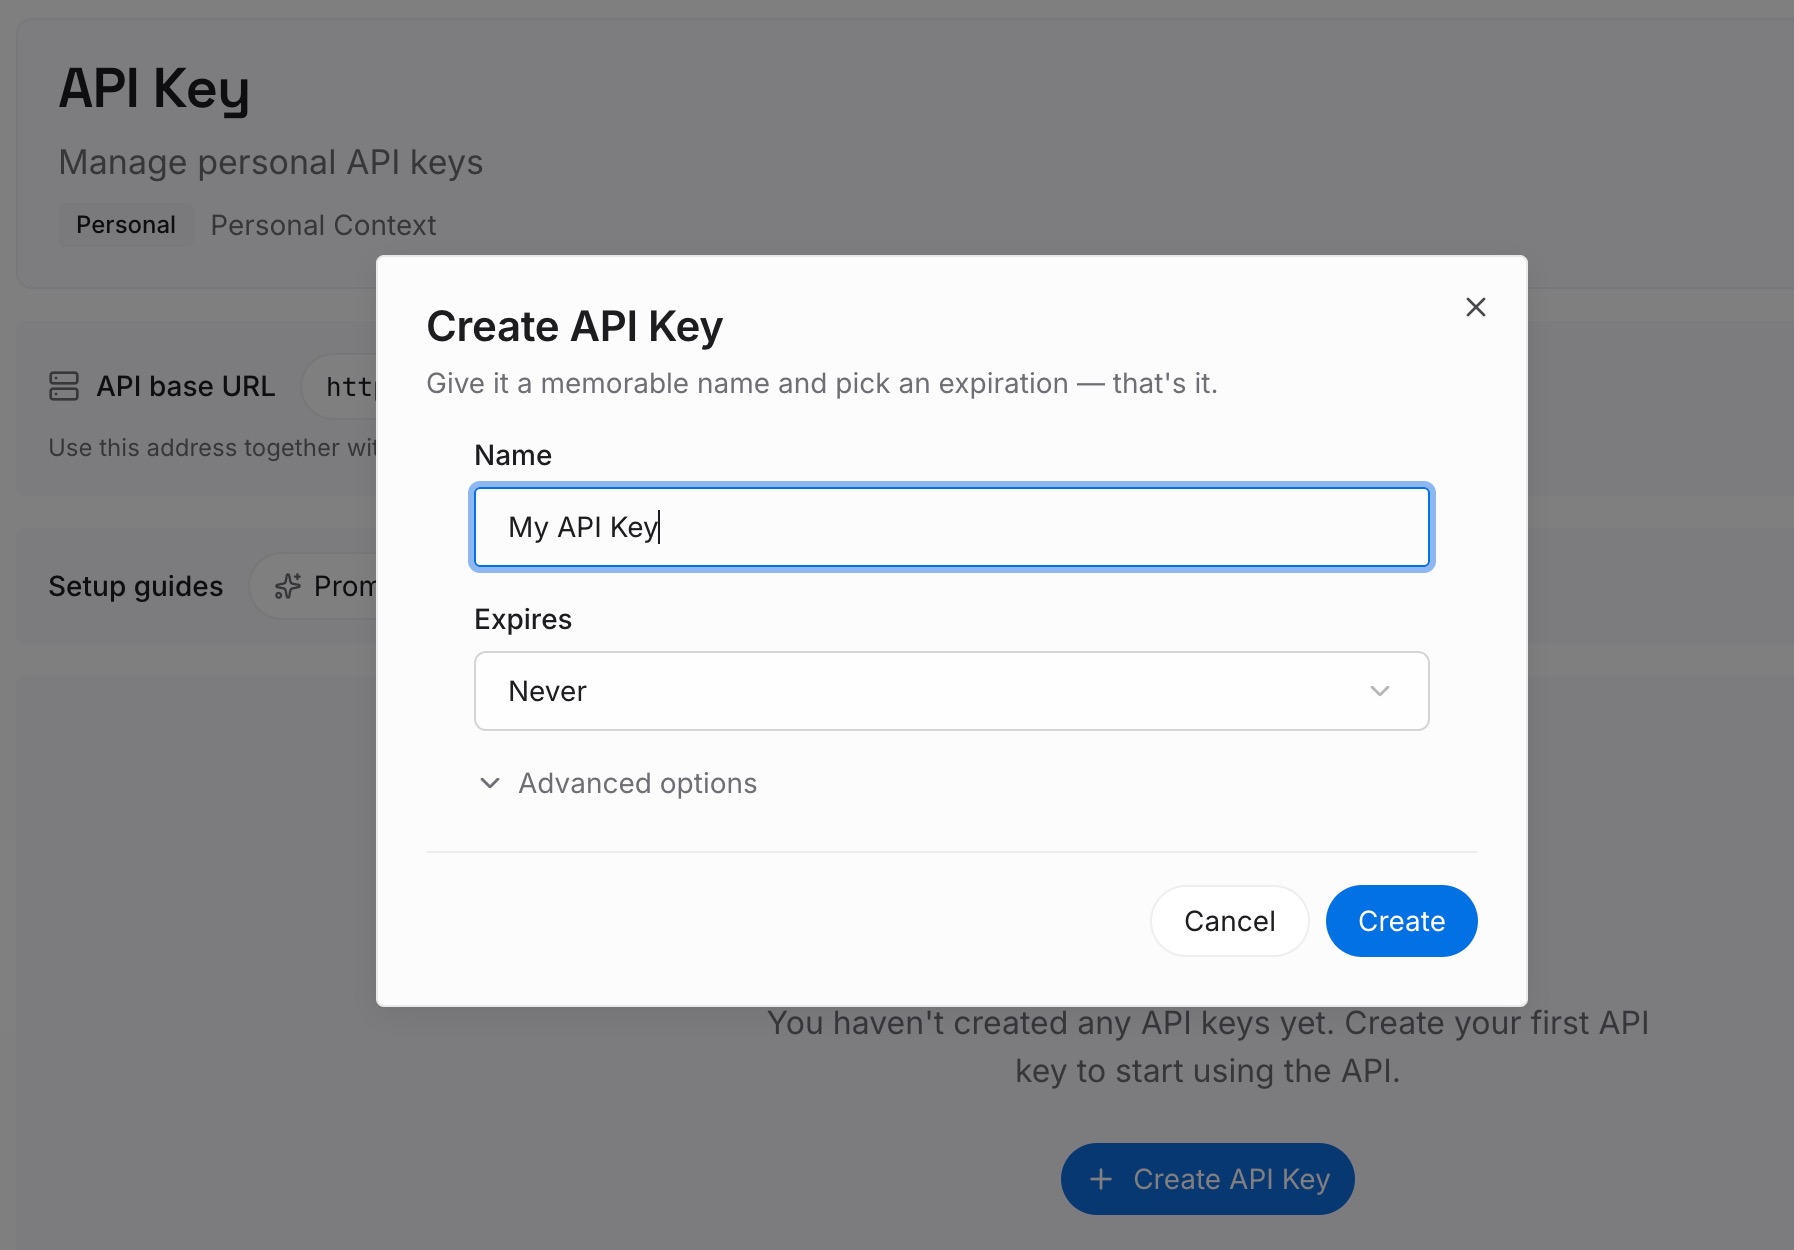
步骤 1:创建 API 密钥
登录并从控制面板生成一个密钥。该密钥允许智能体读取你编写的条目,无论它是自动化程序、编辑器会话还是完全不同的工具。
步骤 2:上传你的第一批记忆
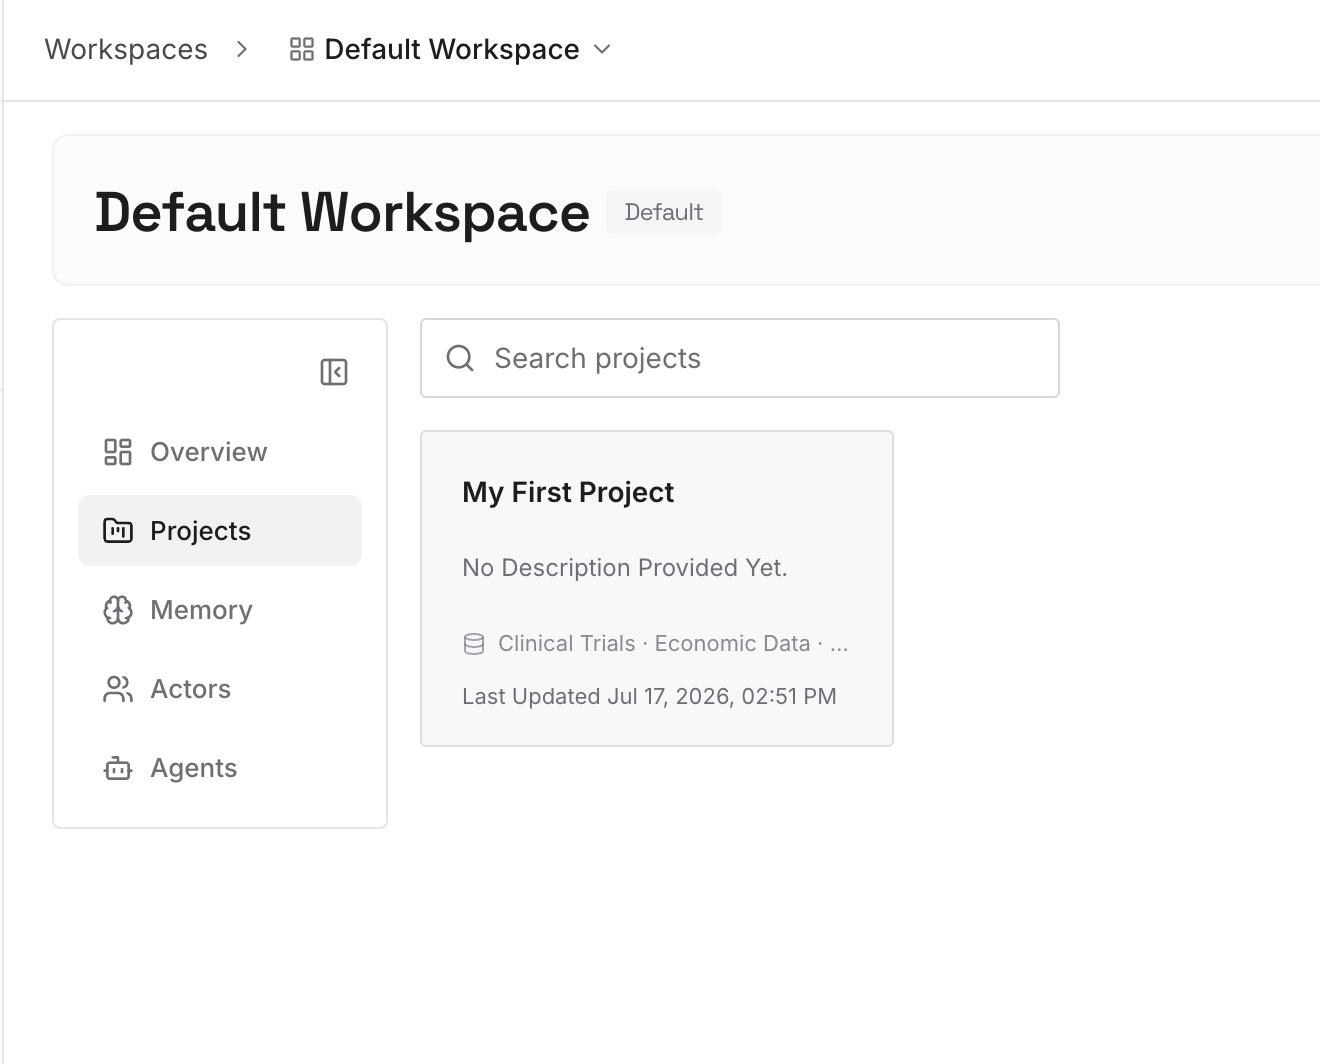
添加你在步骤 3 中批准的教训,每个条目一条,并附带你检查它的原因和日期。日期很重要:关于不稳定测试的教训只有在有人修复该测试之前才是真实的。
步骤 3:连接你的 AI 和智能体
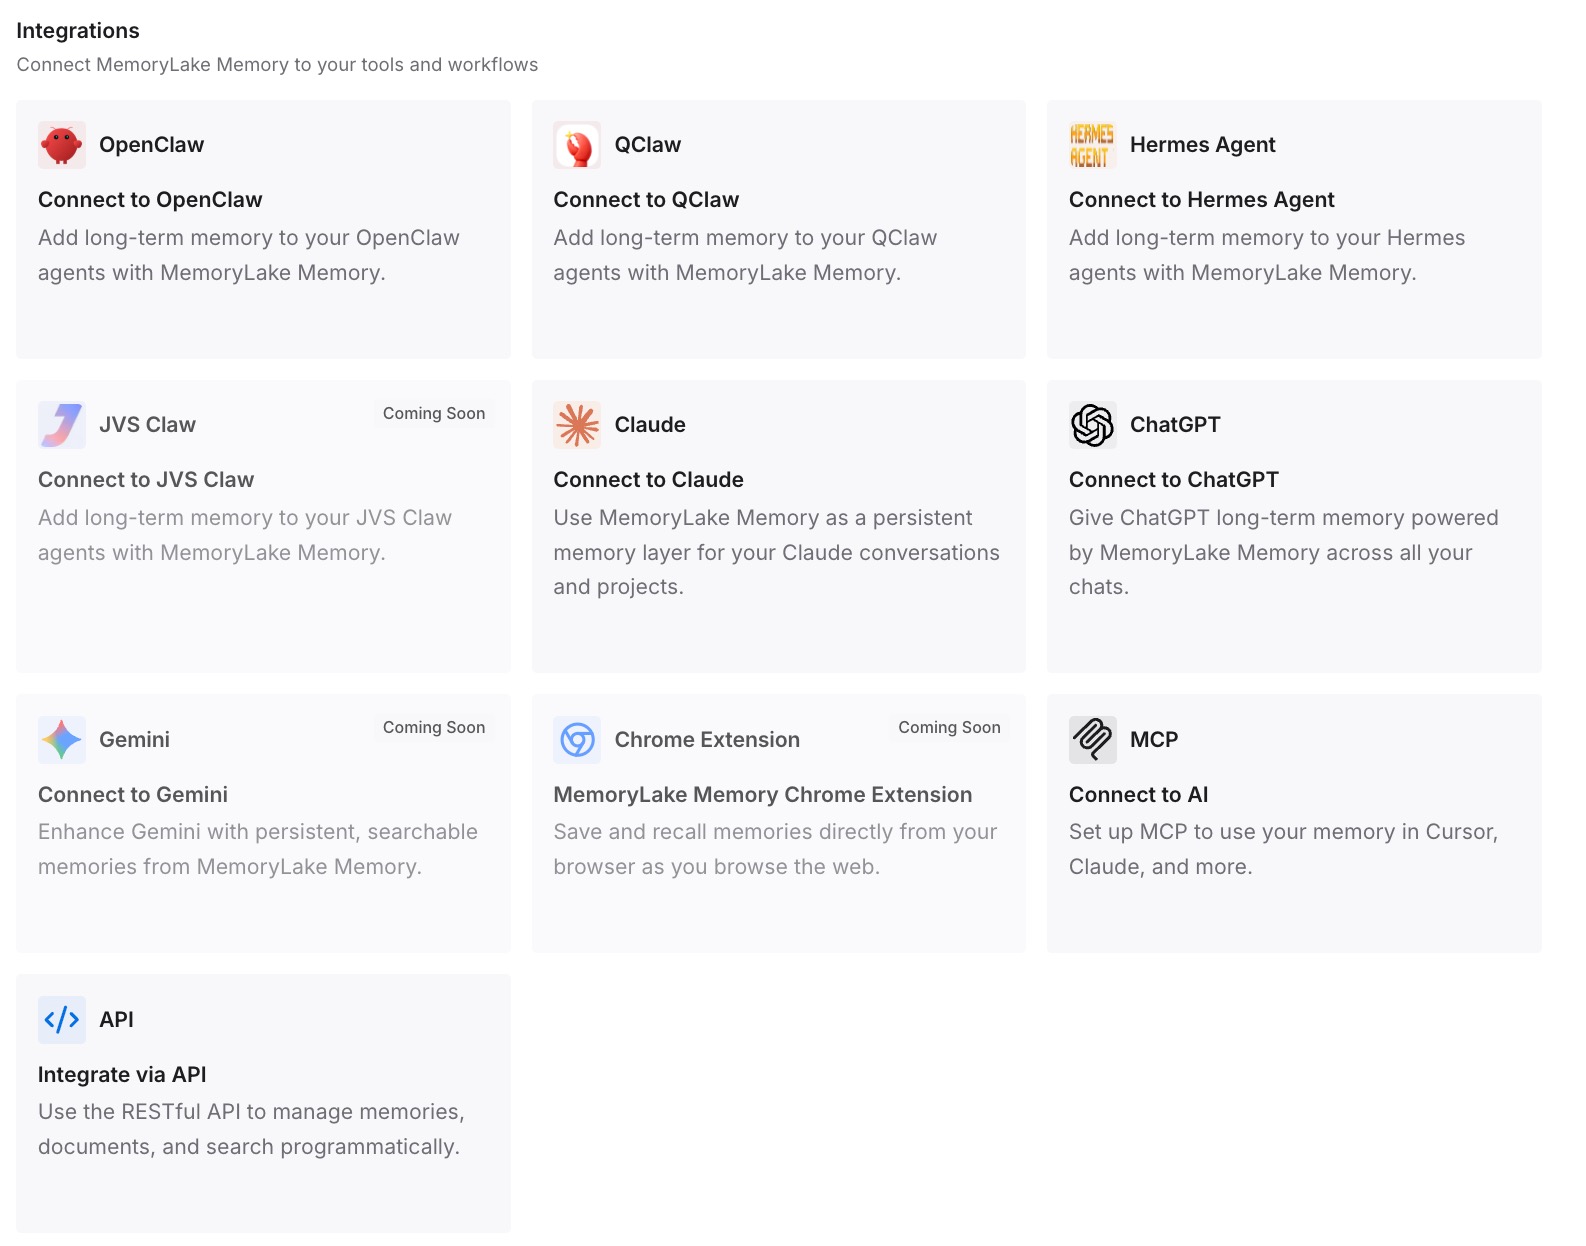
将你的智能体指向该工作区。这样,经过审查的教训就可以供每个需要它的自动化程序和会话使用,而不是只存在于某一个自动化程序的文件中。
这在实践中带来了什么改变
第一个区别是,记忆变成了针对每个自动化程序的决策,而不是默认设置。仅读取你自己系统的自动化程序会继续学习。读取陌生人文本的自动化程序要么停止记忆,要么在书面策略的约束下进行记忆。
第二个区别是偏差变得可见。一个无人阅读的记忆文件可能会累积数周的错误认知。而一个有人定期审查的文件,在这些错误认知影响多次运行之前就会得到纠正。
第三个区别是教训不再被困在单个自动化程序中。因为记忆的范围是按自动化程序划分的,所以一个程序学到的有用事实对其他程序是不可见的。将批准的教训保存在共享位置就是解决方案,这与为什么 Cursor 云端智能体遗忘上下文以及Cursor 项目如何共享上下文文件中描述的缺陷相同。
第四个区别是循环智能体开始表现得像一个你可以推理的系统。其他工具中的计划任务也有相同的形式——参见ChatGPT 计划任务每次都重新开始和Cowork 计划任务与记忆。共同点是,后台智能体的记忆质量完全取决于上一次有人检查它的时间。
自动化程序记忆的最佳实践
在启用记忆之前对触发器进行分类。 公共频道、公开评论区和第三方 webhook 都是不可信的输入。
在任务不需要记忆的地方禁用记忆。 许多分类任务都是逐项处理的,从记忆中获益极少。
在提示词中写入记忆策略。 说明要记录什么、绝对不要记录什么,以及如何记录不确定性。
定期审查记忆文件。 Cursor 使其可视且可编辑;其价值来自于实际去阅读它。
在自动化程序之外保留一份经批准的副本。 当行为发生变化时,将当前文件与你信任的最后一个版本进行对比。
记住每个自动化程序都是独立记忆的。 记忆是按自动化程序划分的。共享的教训需要一个共享的归宿,这也是解决更广泛问题的方案,例如 Cursor 遗忘之前的会话 以及 循环智能体遗忘之前的运行。
结论
Cursor 构建 Automations 记忆工具是为了解决一个真实存在的问题:后台智能体在每次运行时都从零开始。开启记忆后,自动化程序可以“随着时间的推移进行记忆和改进”,这也是该功能默认开启的原因。
Cursor 也清楚地写明了风险。如果你的自动化程序处理不可信的输入,记忆“应谨慎使用”,因为输入“可能会导致误导性或恶意的记忆,从而无意中影响未来的自动化运行”。对于读取 Slack 频道、拉取请求评论或外部 webhook 的自动化程序来说,这是常态,而不是极端情况。
根据读取的内容对每个自动化程序进行分类,在不需要的地方关闭记忆,为可以记录的内容制定策略,并定期审查文件。将你批准的教训保存在自动化程序无法重写的地方,它的记忆就会变成你可以信任的东西,而不是你只能寄希望于它是正确的东西。