
Qué entiende Anthropic por memoria de agentes
El post define la memoria de agentes de forma acotada. Es el "conocimiento que Claude adquiere a través de la experiencia —incluyendo interacciones con usuarios y tareas asignadas— y que retiene entre sesiones, guardado como contexto que puede leer más tarde".
También enumera lo que queda fuera: cambios en los pesos del modelo, aprendizaje en contexto (in-context learning) dentro de una sola conversación y la compactación, que describe como resúmenes que reemplazan turnos antiguos para que Claude pueda seguir trabajando.
La evidencia proviene de varias evaluaciones: Continual Learning Bench, Claude jugando a Pokémon Red, un corpus de documentos internos y un benchmark legal basado en una fusión.
La memoria es una predicción sobre lo que necesitarás
La primera idea del post es que escribir una nota es una apuesta. En palabras de Anthropic: "La memoria es, ocasionalmente, una predicción". Continúa: "Al escribir una regla, un agente predice que el patrón que está describiendo volverá a ser relevante".
En la tarea de Continual Learning Bench, Claude respondía preguntas sobre bases de datos, se le indicaba la respuesta correcta y podía escribir una memoria antes de la siguiente pregunta. Cada pregunta comenzaba en una sesión nueva, con una excepción: el directorio de memoria se mantenía.
Un modelo más antiguo dejaba archivos dispersos con conjeturas no probadas. El post afirma que "Claude Opus 5 fue el primero de estos modelos en cerrar el ciclo", con entradas que contenían una regla, cómo sabía que la regla era cierta y advertencias sobre posibles errores.
Una regla, su evidencia y el error que evita es un formato que puedes verificar más tarde.
Qué elige conservar Claude
La comparación con Pokémon es el ejemplo más claro del post. Tras unos 10,000 pasos en el juego, un modelo antiguo había escrito 413 archivos de memoria en 225 carpetas y ganado una medalla. Un modelo más nuevo había escrito nueve archivos en dos carpetas, más un archivo de nivel superior llamado global.md, y ganado cuatro medallas.
La diferencia radicaba en lo que cada modelo consideraba digno de guardar. El modelo antiguo registraba cada batalla, objeto y personaje, y el post explica por qué eso era perjudicial: "El registro detallado de Sonnet 3.7 se quedaba continuamente desactualizado".
El modelo más nuevo guardaba lo que el juego no mostraba. El post plantea la distinción así: "los archivos de memoria sobre estrategia, planes y reglas probadas existen solo si Claude los deduce, y desaparecen a menos que Claude los escriba". Cosas como el dinero del jugador o la posición en el mapa pueden leerse en la pantalla en cada turno, por lo que guardarlos es redundante.
La documentación de Claude Code traza una línea similar para la memoria automática. La describe como el lugar para tus preferencias, correcciones y "contexto del proyecto que Claude no puede derivar del código". Los hechos que viven en el código, el README o los archivos de construcción pueden leerse directamente cuando se necesitan. Una nota que los copia puede desincronizarse de la fuente.
Decirle a Claude para qué sirve la memoria, no cómo usarla
La guía del post sobre el direccionamiento es breve: "Hemos descubierto que ayuda decirle a Claude para qué sirve la memoria, pero no cómo usarla".
Anthropic probó reglas específicas sobre qué escribir. Cuando la regla indicaba a los modelos registrar solo los fallos, los modelos más potentes perdían gran parte de la mejora que la memoria les había proporcionado. La conclusión: "Para los modelos más potentes, darles libertad para juzgar la relevancia fue más efectivo que establecer reglas fijas de antemano, y esas reglas podrían terminar debilitando el rendimiento".
Los modelos más antiguos eran diferentes: pedirle a uno que leyera su memoria primero y probara sus teorías elevó su puntuación. Para los modelos de vanguardia, Anthropic describe su configuración predeterminada como una guía simple para crear notas cuando una persona lo solicita o cuando algo es claramente digno de recordar.
Este hallazgo trata sobre las reglas de lo que un agente escribe en la memoria. No evalúa las instrucciones de proyecto que le das a Claude para tareas de programación. Si has añadido una línea a tu CLAUDE.md indicándole a Claude que guarde solo ciertos tipos de notas, la investigación es una razón para probar si esa línea ayuda, no una prueba de que perjudique en tu configuración específica.
Por qué se confía en una nota de memoria errónea más tarde
Lee este hallazgo con atención. El post expone el riesgo directamente: "Dado que Claude escribe en la memoria basándose en lo que juzga relevante en la sesión, una nota que es incorrecta desde el principio o que se desvía a medida que el entorno cambia puede ser leída, y aceptada como válida, por Claude en una sesión posterior".
En la partida de Pokémon, Claude anotó el lado equivocado de una montaña para un punto de referencia, marcó la montaña como completada y saltó por un desnivel de un solo sentido volviendo a la ruta de la que venía, más de una vez.
La solución que Anthropic probó fue el dreaming: un proceso que verifica las notas contra las transcripciones originales de la sesión. Claude comparó la nota errónea con la transcripción, encontró el error y reescribió la nota. Con la nota corregida, volvió a la cueva y llegó a la siguiente ciudad. El post explica por qué funcionó: "La transcripción le dio a Claude una fuente de verdad para validar su memoria".
Qué significa esto para la memoria automática de Claude Code
La memoria automática de Claude Code son archivos planos en tu máquina. La documentación dice que puedes ejecutar /memory para explorarlos, y que "Todo es markdown plano que puedes leer, editar o eliminar".
Hay un detalle en la documentación que conecta directamente con la investigación. Claude Code elimina las transcripciones de sesiones antiguas después del periodo de retención cleanupPeriodDays, pero "excluye los archivos de memoria en el directorio de memoria de esa limpieza de retención". Los archivos de memoria permanecen hasta que tú o Claude los editéis o eliminéis.
Pon esos dos hechos juntos. Una nota puede durar más que la transcripción de la sesión de la que provino. Si la nota era errónea, el registro que podría demostrar que era errónea puede haber desaparecido ya. El proceso de dreaming de Anthropic dependía de ese registro. Para la memoria automática local, la verificación recae en ti, contrastando con el código y el estado actual del proyecto. Nuestra guía sobre why Claude Code forgets your corrections cubre el fallo opuesto, donde una corrección nunca llega a convertirse en nota.
Por qué solo parte de la memoria se carga en cada sesión
El post describe una jerarquía. Las notas pueden ser promovidas a la capa superior, que el entorno del agente carga en el contexto al inicio de cada sesión, para que Claude no necesite buscarlas. El post establece límites para esa capa: "Las memorias inyectadas consumen tokens valiosos, y una nota incorrecta puede arrastrarse a cada sesión".
Añade que cargar una nota no garantiza que Claude actúe en consecuencia, citando la propia documentación de Claude Code que indica que los archivos de instrucciones más largos reducen el cumplimiento. Su conclusión: "Por lo tanto, la capa superior de la jerarquía de memoria debe mantenerse relativamente pequeña".
El post menciona la memoria automática de Claude Code como ejemplo de este diseño. La documentación detalla las cifras: "Las primeras 200 líneas de MEMORY.md, o los primeros 25KB, lo que ocurra primero, se cargan al inicio de cada conversación". Continúa: "El contenido más allá de ese umbral no se carga al inicio de la sesión".
El resto vive en archivos temáticos, que Claude lee bajo demanda. MEMORY.md funciona como un índice que apunta a ellos.
Claude Code también impone el límite cuando Claude escribe. Si MEMORY.md está cerca del límite, Claude Code le recuerda a Claude que lo acorte. Si se excede, la escritura tiene éxito, pero Claude Code devuelve un error indicándole a Claude que reescriba el índice, "porque todo lo que pase el límite se descarta en la siguiente carga".
Así que la pregunta práctica para cualquier nota es dónde se ubica. Una línea en las primeras 200 líneas de MEMORY.md está ahí cuando comienza la sesión. Una línea más abajo, o un detalle en un archivo temático, solo está ahí si Claude va a buscarlo. Nuestra guía sobre Claude Code auto memory explica dónde viven esos archivos y cómo desactivar la función.
Lo mismo se aplica a los archivos de instrucciones que escribes: la documentación sugiere menos de 200 líneas por archivo CLAUDE.md, porque "Los archivos más largos consumen más contexto y reducen el cumplimiento". Los archivos de subdirectorios tienen su propio límite, cubierto en nuestra guía sobre el subdirectory CLAUDE.md limit.
Cuando varios escritores comparten una página
Uno de los experimentos finales es fácil de pasar por alto y relevante para cualquiera que comparta memoria entre agentes o personas. Claude construyó una wiki a partir de un conjunto de contratos. Varios agentes escribieron en una tabla compartida de términos contractuales al mismo tiempo. Cuando Anthropic evaluó un informe construido a partir de esa wiki, 41 de 57 hechos evaluados habían sobrevivido. El post encontró el porqué: la tabla compartida resumía mal los términos y faltaban algunos, "porque los agentes habían sobrescrito el trabajo de los demás".
Las instrucciones mejoradas dieron a cada contrato su propia página, escrita por un solo agente, "que citaba los términos palabra por palabra en lugar de resumirlos en una tabla compartida". Con ese cambio, los 57 hechos llegaron al informe.
Un escritor por página evita sobrescrituras, y citar la fuente mantiene detalles que un resumen puede omitir.
La documentación de Claude Code señala que "Todos los worktrees y subdirectorios dentro del mismo repositorio git comparten un único directorio de memoria automática". Si ejecutas sesiones paralelas en varios worktrees de un repositorio, comparten ese directorio. La documentación de la memoria no describe cómo se gestionan las escrituras simultáneas en el mismo archivo, por lo que vale la pena revisar MEMORY.md después de un día de trabajo paralelo. La guía de Managed Agents de Anthropic adopta una división similar entre escritores, cubierta en nuestro artículo sobre the two memory stores in Claude Managed Agents.
Cuándo ayuda una wiki y cuándo no
El post no presenta las wikis como una solución universal. En preguntas que requerían hechos de varios documentos, Claude lo hizo mejor con la wiki que solo con la búsqueda. En una tarea legal donde la mayoría de los criterios podían cumplirse con un solo documento, la wiki no mostró una mejora clara. En otra tarea, la wiki creció más que los documentos a partir de los cuales se construyó. El veredicto del post en ese caso: "Claude había hecho una wiki extremadamente detallada que efectivamente no abstraía nada". El post también enumera preguntas abiertas, incluyendo cómo mantener la precisión de la memoria cuando verificar cada nota cuesta cómputo.
Lo que la gente intenta primero
Guardar todo, por si acaso. Una memoria grande que se queda obsoleta cuesta tiempo de búsqueda y puede inducir a error.
Escribir reglas estrictas sobre qué guardar. Para modelos más potentes, Anthropic descubrió que las reglas fijas podían debilitar el rendimiento.
Confiar en una nota porque está en la memoria. Una nota puede ser errónea desde el principio, y Claude puede leerla y confiar en ella más tarde.
Dejar que MEMORY.md crezca. Cualquier cosa que pase de las primeras 200 líneas o 25KB no se carga al inicio de la sesión.
La solución: Mantener la capa cargada pequeña y verificable
Paso 1: Lee lo que guardó la memoria automática
Ejecuta /memory, abre la carpeta de memoria automática y lee MEMORY.md y los archivos temáticos. Verifica cada entrada contra el código o el estado actual del proyecto, y corrige o elimina lo que ya no sea cierto. No cuentes con encontrar la sesión original, ya que las transcripciones se limpian periódicamente.
Paso 2: Mantén MEMORY.md como un índice bajo el límite
Mantén una línea por entrada en MEMORY.md y mueve los detalles a archivos temáticos. Coloca las entradas que Claude necesita al inicio de cada sesión cerca de la parte superior. Elimina cualquier cosa que copie lo que Claude puede leer del código.
Paso 3: Asigna a cada página un escritor y cita las decisiones
Si varias sesiones o compañeros de equipo añaden a las mismas notas, da a cada tema su propia página. Cuando un hecho provenga de un documento, un ticket o un registro de decisión, copia la redacción exacta en lugar de un resumen.
Configurando esto en MemoryLake
El post de Anthropic trata sobre la memoria que el agente escribe para sí mismo, basándose en lo que parece importante en el momento. Hay otro tipo de memoria con una propiedad diferente: las decisiones y convenciones que tú mismo has confirmado. Sabes que una entrada es correcta cuando la escribes, y es posible que la quieras en más de una herramienta y en más de una máquina. La documentación de Claude Code dice que la memoria automática es local de la máquina.
MemoryLake es una capa de memoria para mantener esas entradas confirmadas en un solo lugar que tú mantienes, disponible para los asistentes que conectes, como ChatGPT, Claude Code y Codex.
Tú escribes las entradas tú mismo, con tus propias palabras. No se lee, escribe ni elimina nada de tu MEMORY.md, tus archivos temáticos de memoria automática, tus archivos CLAUDE.md, tus chats de Claude o el almacén de cualquier proveedor. La memoria automática de Claude Code sigue funcionando de la manera que describe Anthropic.
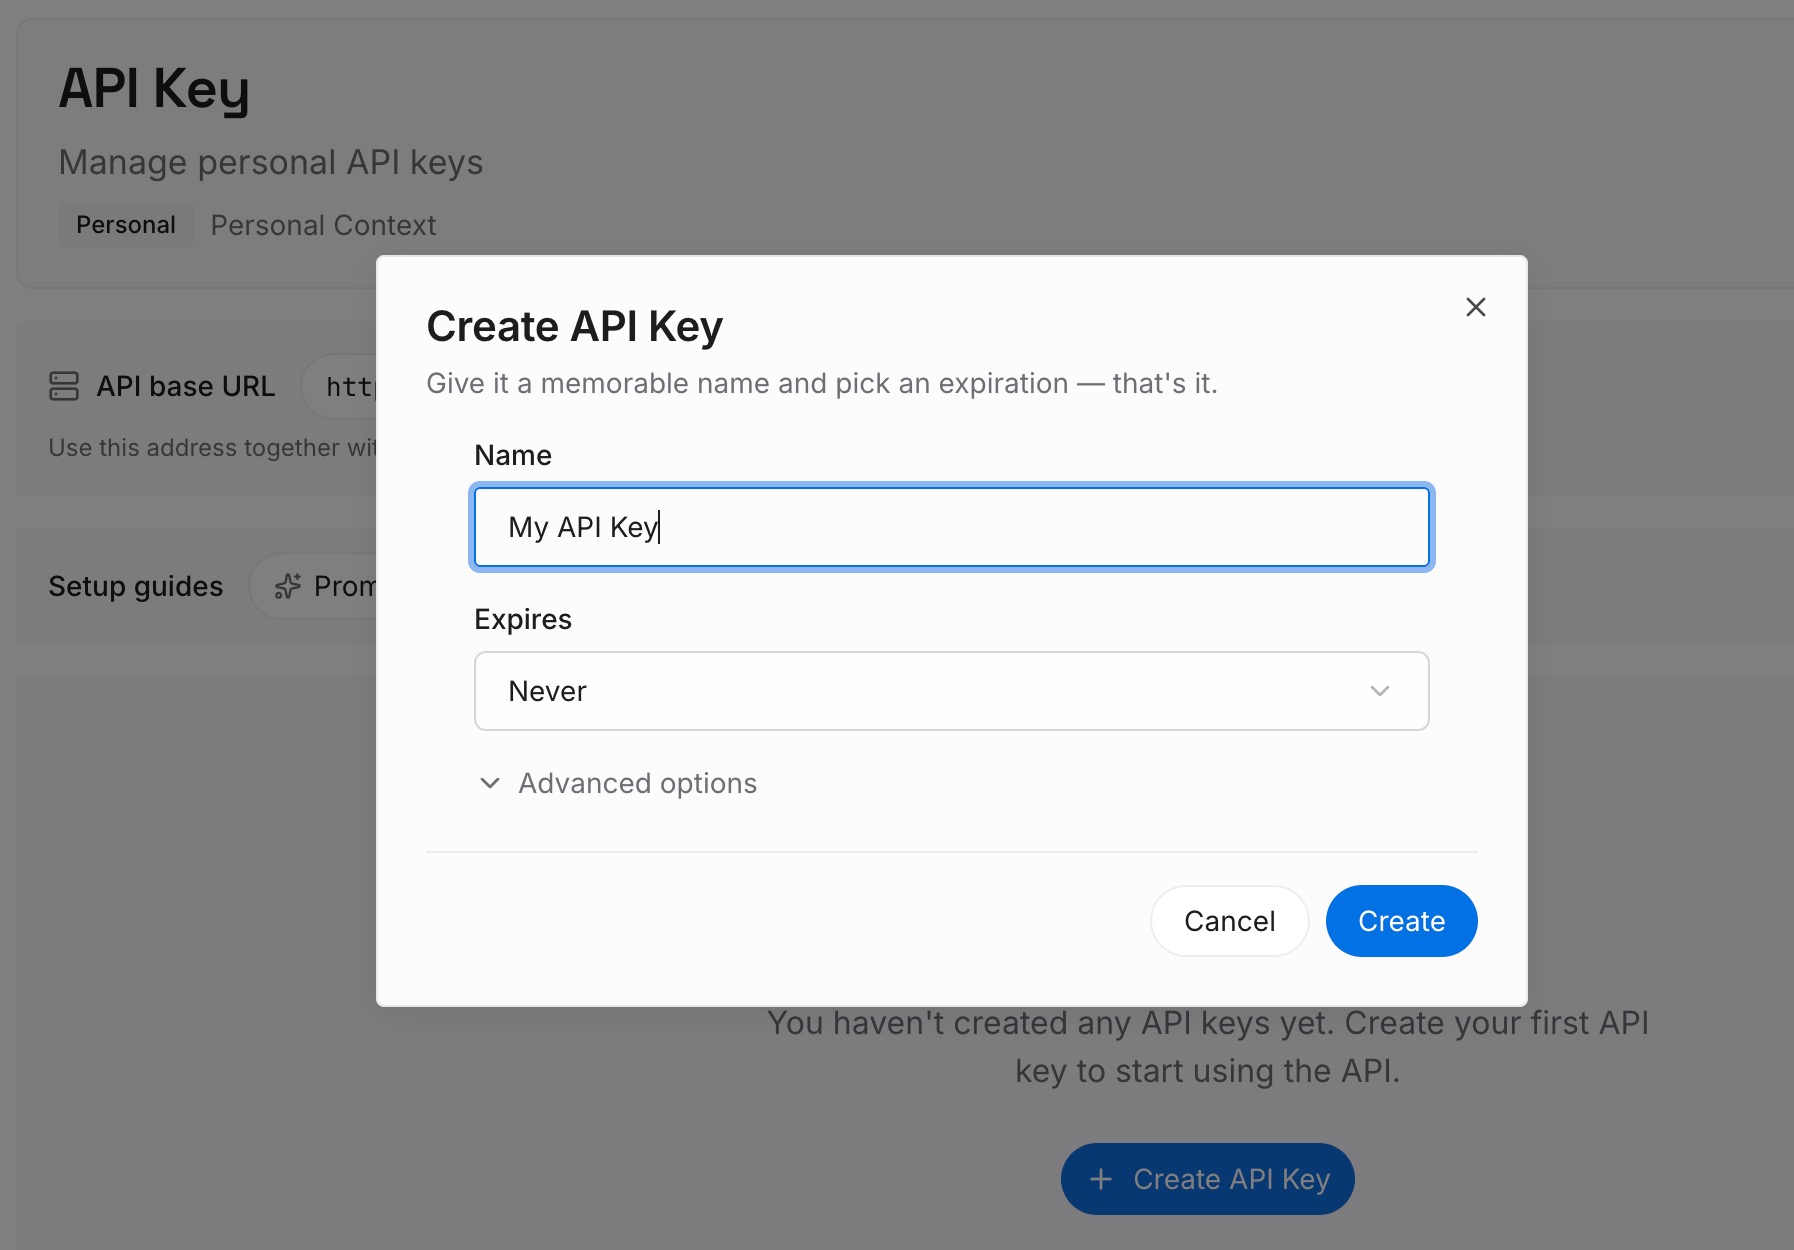
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. La clave pertenece a tu espacio de trabajo de MemoryLake y es independiente de tu cuenta de Anthropic.
Paso 2: Sube tus primeras memorias
Comienza con las entradas que revisaste en el Paso 1 anterior y confirmaste que siguen siendo ciertas. Una decisión por entrada, con la fuente citada palabra por palabra y la fecha en que la confirmaste.
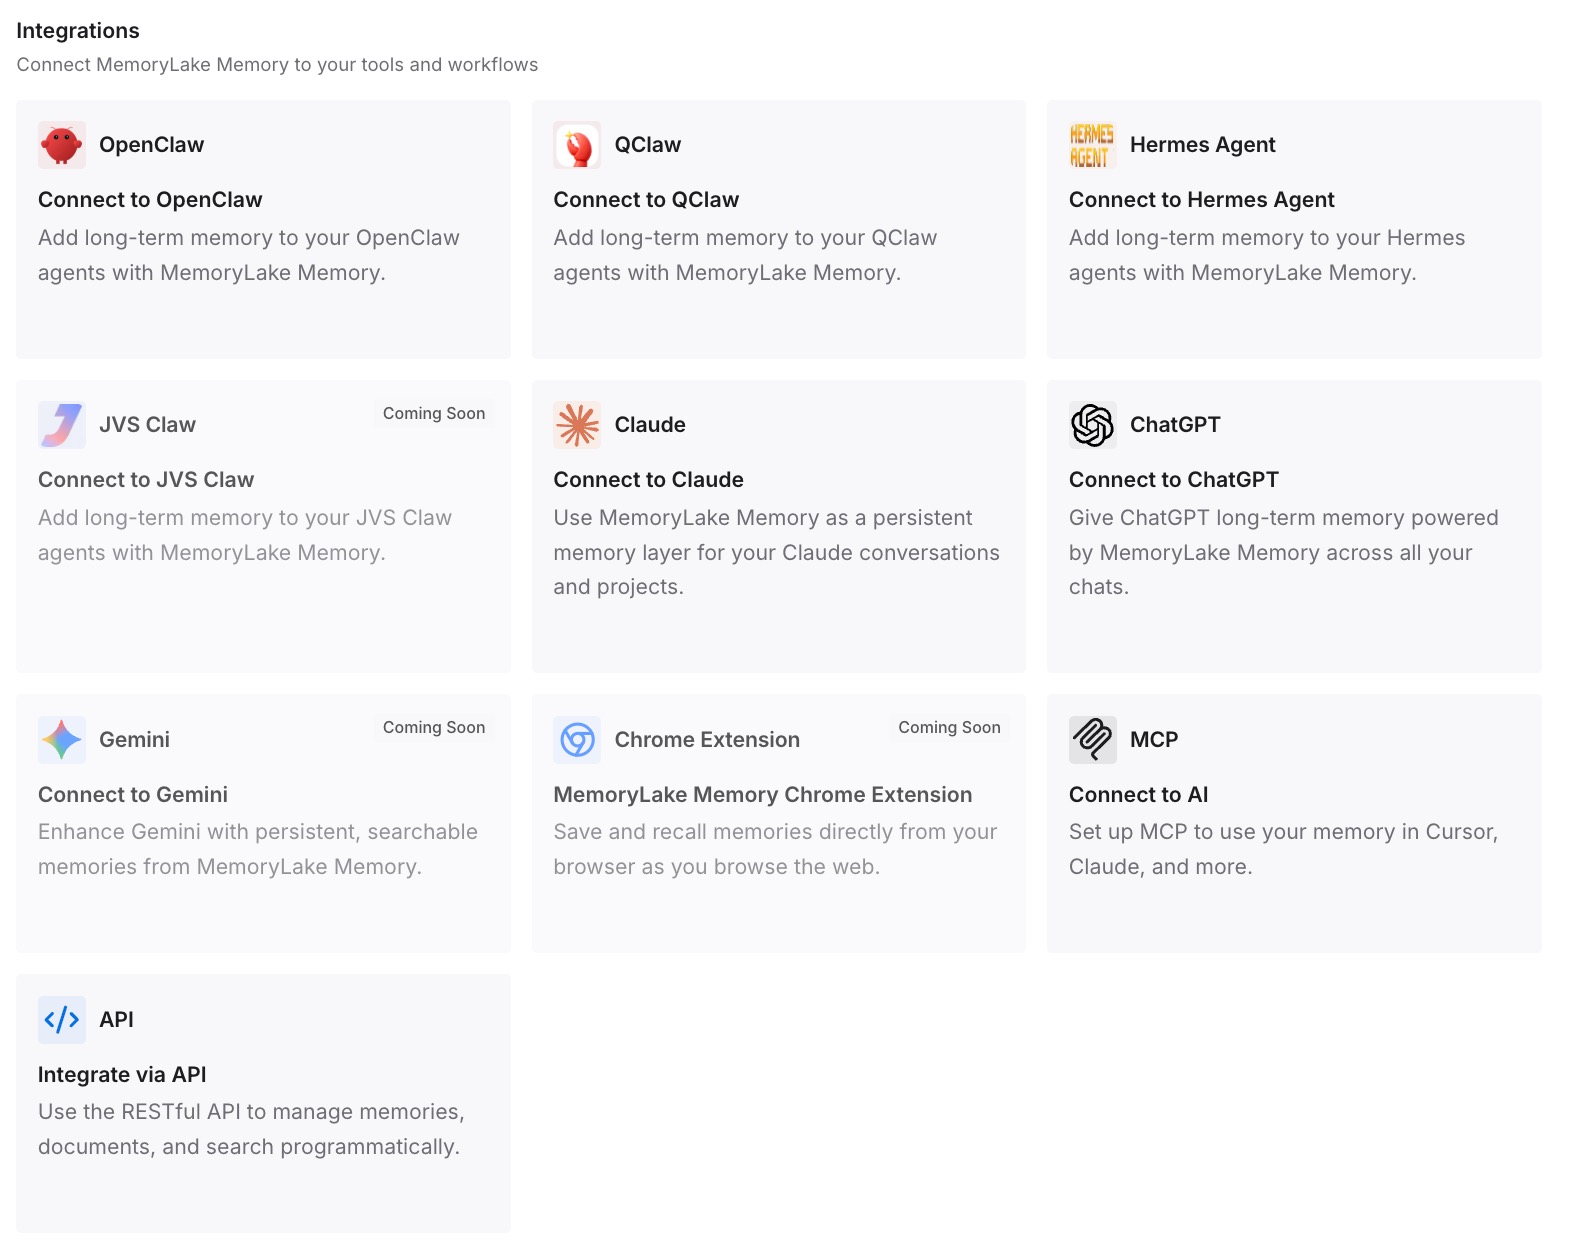
Paso 3: Conecta tu IA y agentes
Conecta Claude Code y cualquier otro asistente que utilices. Las mismas entradas confirmadas estarán disponibles en cada máquina y en cada herramienta.
Qué cambia esto en la práctica
La primera diferencia es un índice más corto. MEMORY.md puede contener punteros y las pocas cosas que cada sesión necesita, mientras que las decisiones confirmadas viven donde puedes consultarlas.
La segunda es una fuente de verdad más clara. Cuando una nota de memoria automática y una entrada confirmada no coinciden, sabes cuál escribiste tú tras verificarla.
La tercera es un único escritor para lo que importa: las decisiones que has confirmado tienen un único autor.
Mejores prácticas para archivos de memoria de Claude
Guarda lo que Claude no puede leer en otro lugar. La estrategia, las decisiones y las reglas probadas pertenecen a la memoria. Los hechos en el código, no.
Escribe reglas con su evidencia. Una regla, cómo sabes que es cierta y el error que evita es fácil de verificar más tarde.
Verifica las notas contra la fuente. Se puede confiar en una nota errónea en una sesión posterior.
Mantén la capa superior pequeña. Solo las primeras 200 líneas o 25KB de MEMORY.md se cargan al inicio de la sesión.
Prefiere un escritor por página. Las páginas compartidas con varios escritores pueden perder hechos.
Cita, no resumas, los términos importantes. La redacción exacta mantiene los detalles intactos.
Conclusión
El post de Anthropic explica, con sus propias evaluaciones, cómo decide Claude qué recordar. Las notas son predicciones. Los modelos más potentes funcionan mejor cuando se les dice para qué sirve la memoria en lugar de darles reglas fijas. Una nota que es incorrecta desde el principio puede ser leída y aceptada en una sesión posterior, razón por la cual Anthropic probó el dreaming contra las transcripciones originales. Y la capa que se carga en cada sesión se mantiene pequeña a propósito, lo que en Claude Code significa las primeras 200 líneas o 25KB de MEMORY.md.
Para tu propia configuración, esto se reduce a tres hábitos: verificar lo que la memoria automática guardó contra la fuente, mantener MEMORY.md como un índice corto con las entradas importantes al principio, y dar a los hechos importantes un único escritor y su redacción exacta.