
¿Qué es Pinecone?
- Una base de datos vectorial nativa de la nube: Pinecone es una plataforma serverless totalmente gestionada, diseñada específicamente para almacenar y consultar embeddings de vectores densos a escala, eliminando la necesidad de gestionar infraestructura.
- Optimizada para la búsqueda de similitud: Destaca en la búsqueda de puntos de datos matemáticamente similares en espacios de alta dimensión, lo que constituye la columna vertebral de las aplicaciones estándar de Generación Aumentada por Recuperación (RAG).
- Almacenamiento externo sin estado: Pinecone actúa como una unidad de conocimiento externa para su IA. Recupera documentos basándose en consultas vectoriales, pero no realiza un seguimiento nativo del estado de la conversación, la progresión del usuario o la evolución de los hechos a lo largo del tiempo.
- Integración amigable para desarrolladores: Ofrece una API muy optimizada para que los desarrolladores ingieran vectores generados por modelos de lenguaje grande (LLMs) y realicen búsquedas rápidas de vecinos más cercanos en conjuntos de datos masivos.
¿Por qué buscar alternativas a Pinecone para la memoria de agentes de IA?
- Más allá de la búsqueda vectorial básica: Los agentes de IA modernos requieren más que simplemente recuperar fragmentos de texto similares. Necesitan un contexto estructurado y persistente, razonamiento temporal y un mapeo complejo de relaciones entre entidades para comportarse de manera inteligente.
- Escalado de costos ineficiente para el estado: Actualizar, consolidar y sobrescribir continuamente la memoria conversacional con estado en una base de datos vectorial pura puede generar costos de API prohibitivos y un uso de cómputo altamente ineficiente.
- Falta de resolución de conflictos nativa: Los almacenes de vectores estándar no resuelven automáticamente los hechos contradictorios. Si la preferencia de un usuario cambia, la base de datos podría devolver ciegamente tanto los hechos antiguos como los nuevos, a menos que el desarrollador cree una lógica personalizada.
- Necesidad de abstracciones de mayor nivel: Los desarrolladores prefieren cada vez más motores de memoria inteligentes que gestionen automáticamente el resumen, la extracción de datos y la gestión del estado cognitivo, en lugar de orquestar manualmente embeddings de vectores sin procesar.
¿Qué buscar en una alternativa a Pinecone?
- Gestión de contexto persistente: La alternativa ideal debe almacenar, organizar y recuperar de manera inteligente los hechos relevantes a lo largo de sesiones continuas sin perder el hilo lógico de la interacción.
- Capacidades cognitivas y multimodales: Busque sistemas que puedan procesar sin problemas varios formatos de datos (incluidos documentos, texto sin formato y tablas), traduciéndolos en un grafo de conocimiento unificado o estado cognitivo.
- Consolidación de memoria automatizada: La plataforma debe comprimir de forma inteligente los historiales conversacionales más antiguos y resolver activamente la información conflictiva para mantener bajo el uso de tokens, conservando al mismo tiempo una precisión milimétrica.
- Ecosistema de integración sin fricciones: Asegúrese de que la alternativa ofrezca SDK fáciles de usar, APIs REST completas o integraciones con Model Context Protocol (MCP) para conectarse instantáneamente a sus flujos de trabajo de IA existentes.
Las 10 mejores alternativas a Pinecone para la memoria de agentes de IA en 2026
Antes de profundizar en el análisis detallado de cada plataforma, aquí tiene una descripción comparativa de las 10 mejores alternativas adaptadas para la memoria de agentes de IA.
| Producto | Ideal para | Tecnología principal | Modelo de precios |
|---|---|---|---|
| 1. MemoryLake | Memoria integral para agentes de IA | Contexto multimodal persistente | $19/mes |
| 2. Weaviate | Búsqueda vectorial escalable | BD vectorial de código abierto | $45/mes |
| 3. Redis | Aplicaciones de IA en tiempo real | Almacén de datos en memoria | Personalizado |
| 4. LanceDB | Cargas de trabajo vectoriales integradas | BD vectorial columnar | Pago por uso |
| 5. Neo4j | Razonamiento de grafos multisalto | Base de datos de grafos | $65/mes |
| 6. LlamaIndex | Orquestación de datos | Framework de datos | $50/mes |
| 7. Mem0 | Interacciones de IA personalizadas | Capa de memoria híbrida | $19/mes |
| 8. Zep | Chatbots conversacionales | API de memoria a largo plazo | $125/mes |
| 9. Supermemory | Segundo cerebro de IA | Motor de memoria universal | $19/mes |
| 10. Mnemoverse | Contexto entre herramientas | API de memoria basada en MCP | $29/mes |
1. MemoryLake
MemoryLake es una infraestructura de memoria persistente diseñada para ayudar a los agentes y aplicaciones de IA a mantener el contexto a través de conversaciones, tareas y sesiones. En lugar de tratar cada interacción como un nuevo comienzo, permite a los sistemas de IA almacenar, organizar, recuperar y reutilizar información relevante a lo largo del tiempo. Esto puede incluir preferencias de usuario, interacciones históricas, hechos importantes, contexto de tareas y otros conocimientos a largo plazo. MemoryLake es adecuado para una amplia gama de aplicaciones de IA, desde asistentes personales y agentes de atención al cliente hasta flujos de trabajo impulsados por IA, sistemas multiagente y personajes virtuales interactivos. Su enfoque en la memoria estructurada y persistente facilita a los desarrolladores la creación de experiencias de IA que se sientan más consistentes.
Características clave
- Resolución inteligente de conflictos: Detecta automáticamente cuando los nuevos hechos contradicen a los antiguos, actualizando la comprensión de la IA sin duplicar datos.
- Procesamiento multimodal: Comprende y extrae de forma nativa el contexto de documentos complejos, PDFs, hojas de Excel y texto no estructurado.
- Trazabilidad completa de la memoria: Funciona con una procedencia similar al control de versiones, lo que significa que cada hecho recuperado puede rastrearse hasta su fuente original exacta.
Pros
- Elimina la pérdida de contexto en todas las plataformas y sesiones de IA.
- Reduce significativamente los costos de tokens de LLM al comprimir y estructurar los datos recuperados.
- La arquitectura zero-trust garantiza la privacidad de los datos con un cifrado de primer nivel.
Contras
- Puede ser demasiado exhaustivo para proyectos que solo necesitan un pipeline RAG simple y sin estado.
- Requiere un cambio de mentalidad de la gestión tradicional de bases de datos vectoriales a la gestión de memoria cognitiva.
Precios
Freemium; el plan Pro comienza en $19/mes.
2. Weaviate
Weaviate es una base de datos vectorial robusta y de código abierto diseñada para almacenar tanto objetos de datos como sus correspondientes embeddings vectoriales. Permite a los desarrolladores crear aplicaciones de IA escalables al ofrecer soporte listo para usar para la búsqueda vectorial avanzada, lo que la convierte en una opción popular para arquitecturas RAG empresariales que requieren alta confiabilidad.
Características clave
- Búsqueda híbrida: Combina a la perfección la búsqueda semántica densa con algoritmos BM25 basados en palabras clave para una precisión de recuperación óptima.
- Arquitectura modular: Admite varios modelos de vectorización e integraciones de proveedores de LLM directamente dentro del motor de la base de datos.
- Soporte multiinquilino (Multi-Tenancy): Aísla eficientemente los datos de diferentes usuarios o agentes dentro del mismo clúster de base de datos.
Pros
- Altamente escalable para conjuntos de datos masivos a nivel empresarial.
- Opciones de despliegue extremadamente flexibles (nube, local, integrado).
- Comunidad de código abierto vibrante y excelente documentación.
Contras
- Requiere una gestión de infraestructura significativa si decide autoalojarlo.
- Carece de lógica nativa de alto nivel para la "memoria de agentes"; los desarrolladores deben construir la gestión de estado por sí mismos.
Precios
$45/mes.
3. Redis
Conocido originalmente en todo el mundo como un almacén de clave-valor en memoria ultrarrápido, Redis ha evolucionado continuamente. Con la introducción de Redis Stack, ahora incluye potentes capacidades de búsqueda vectorial. Esta transformación convierte a Redis en una base de datos en tiempo real muy viable para aplicaciones de IA que exigen una recuperación de datos inmediata y una latencia mínima.
Características clave
- Velocidad en memoria: Ofrece una latencia inferior al milisegundo para consultas vectoriales en tiempo real y actualizaciones de memoria conversacional.
- Estructuras de datos versátiles: Permite a los desarrolladores almacenar hashes, documentos JSON e índices vectoriales en un solo lugar.
- Filtrado avanzado: Admite prefiltrado y postfiltrado complejos de búsquedas vectoriales basados en metadatos.
Pros
- Velocidad operativa inigualable y baja latencia para las interacciones de los agentes.
- Extremadamente extendido y probado en entornos empresariales de alto rendimiento.
- Sintaxis familiar y fácil adopción para los usuarios actuales de Redis.
Contras
- La alta dependencia de la RAM lo convierte en una opción costosa para almacenar conjuntos de datos de archivo muy grandes.
- Es una base de datos de propósito general, no un motor de memoria cognitiva de IA diseñado específicamente para ello.
Precios
Precios personalizados.
4. LanceDB
LanceDB es una base de datos columnar de código abierto y amigable para desarrolladores, diseñada específicamente para la búsqueda vectorial. Construida sobre el formato Arrow, se ejecuta de manera única integrada (embedded) directamente en su aplicación o como una instancia en la nube serverless. Prioriza la simplicidad, la velocidad y la integración perfecta con los flujos de trabajo modernos de ciencia de datos.
Características clave
- Diseño integrado (Embedded): Se ejecuta directamente dentro del proceso de la aplicación, eliminando la necesidad de gestionar un servidor de base de datos independiente.
- Capacidades multimodales: Maneja de forma nativa y sin problemas tipos de datos complejos como texto, imágenes y audio.
- Búsqueda de copia cero (Zero-Copy): Aprovecha los formatos de datos columnares para ejecutar consultas analíticas ultrarrápidas sin mover datos.
Pros
- El despliegue sin configuración para la versión integrada reduce drásticamente la fricción.
- Altamente eficiente tanto para consultas analíticas como para cargas de trabajo vectoriales.
- Se integra perfectamente con el ecosistema de datos de Python (Pandas, PyArrow).
Contras
- Comunidad y ecosistema más pequeños en comparación con bases de datos consolidadas desde hace tiempo.
- Las características de abstracción de memoria de agentes de nivel superior aún están evolucionando.
Precios
Pago por uso.
5. Neo4j
Neo4j es la base de datos de grafos líder en el mundo, y ha adoptado con éxito la revolución de la IA a través del concepto de GraphRAG. Al almacenar datos como nodos y relaciones interconectados en lugar de vectores planos, proporciona a los agentes de IA la capacidad de realizar tareas complejas de razonamiento multisalto con las que los almacenes de vectores estándar suelen tener dificultades.
Características clave
- Modelado de grafos: Mapea explícitamente relaciones lógicas complejas entre puntos de datos, entidades y hechos históricos.
- Lenguaje de consulta Cypher: Proporciona un mecanismo de consulta potente y expresivo para datos interconectados.
- Integración de búsqueda vectorial: Combina el recorrido de grafos nativo con la búsqueda vectorial integrada para ofrecer lo mejor de ambos mundos.
Pros
- Arquitectura superior para razonamiento multisalto y flujos de trabajo lógicos de IA.
- La representación de datos altamente visual facilita la depuración del conocimiento del agente.
- Excelente para descubrir conexiones ocultas dentro de la memoria del agente.
Contras
- Presenta una curva de aprendizaje pronunciada para desarrolladores no familiarizados con el modelado de grafos.
- Puede ser excesivo y consumir muchos recursos para agentes conversacionales simples.
Precios
$65/mes.
6. LlamaIndex
LlamaIndex es un potente framework de orquestación de datos en lugar de una base de datos independiente tradicional. Actúa como el puente definitivo entre sus fuentes de datos personalizadas y los LLMs, encargándose de las complejas tareas de indexación, enrutamiento y recuperación de información para garantizar que sus agentes de IA tengan el contexto exacto que necesitan.
Características clave
- Amplios conectores de datos: Ingiere fácilmente datos de cientos de fuentes diferentes, incluyendo APIs, PDFs y bases de datos SQL.
- Estructuras de indexación avanzadas: Ofrece diversas opciones de indexación, como índices de árbol, lista, palabras clave y vectores, según la tarea.
- Módulos de memoria: Incluye buffers de memoria de chat integrados y lógica de resumen para agentes conversacionales.
Pros
- Excelente para construir rápidamente pipelines RAG sofisticados y variados.
- Respaldado por un ecosistema masivo y una comunidad de código abierto increíblemente activa.
- Altamente flexible, lo que permite a los desarrolladores cambiar fácilmente las bases de datos vectoriales subyacentes.
Contras
- Actúa principalmente como una capa de orquestación, lo que significa que aún necesita proporcionar una base de datos subyacente.
- La gran variedad de características puede introducir una complejidad innecesaria para casos de uso simples.
Precios
$50/mes.
7. Mem0
Mem0 es una capa de memoria inteligente y especializada, diseñada específicamente para dotar a los asistentes de IA de una memoria personalizada a largo plazo. Evolucionando a partir de herramientas de orquestación anteriores, gestiona activamente las interacciones de los usuarios para garantizar que los agentes de IA se vuelvan más inteligentes, adaptables y personalizados con el tiempo sin intervención manual.
Características clave
- Perfilado automático de usuarios: Extrae y recuerda de forma inteligente las preferencias individuales de los usuarios a lo largo de infinitas sesiones.
- Arquitectura de almacenamiento de datos híbrida: Utiliza una combinación de tecnologías de almacenamiento de grafos y vectores para proporcionar ricas relaciones contextuales.
- Integración directa (Drop-in): Permite a los desarrolladores agregar memoria persistente a sus aplicaciones con solo unas pocas líneas de código.
Pros
- Extremadamente fácil de integrar en aplicaciones de LLM existentes.
- Mejora enormemente la personalización y la retención de usuarios para las aplicaciones de IA.
- Su naturaleza de código abierto permite un control total de los datos.
Contras
- Sigue siendo un actor relativamente nuevo en comparación con los gigantes de infraestructura establecidos.
- La personalización profunda podría estar ligeramente restringida para casos de uso empresariales muy inusuales.
Precios
$19/mes.
8. Zep
Zep es un almacén de memoria a largo plazo diseñado explícitamente para asistentes de IA. Funciona silenciosamente en el fondo de su IA conversacional, extrayendo hechos automáticamente, resumiendo diálogos antiguos y manteniendo un historial conversacional limpio para que su agente nunca pierda el hilo de la discusión.
Características clave
- Resumen automático: Comprime automáticamente los historiales de chat más antiguos para preservar el contexto y ahorrar en costos de tokens.
- Extracción de entidades y hechos: Identifica, extrae y almacena entidades clave y hechos inmutables a partir del diálogo en vivo.
- Búsqueda vectorial incluida: Maneja la búsqueda semántica básica junto con sus robustas herramientas de gestión de memoria.
Pros
- Reduce drásticamente el uso de tokens al inyectar solo resúmenes condensados y relevantes.
- Proporciona contexto inmediato y listo para usar para aplicaciones de chatbot.
- Reduce la latencia al gestionar el resumen de forma asíncrona.
Contras
- Muy orientado a chatbots conversacionales en lugar de flujos de trabajo complejos impulsados por tareas.
- Las funciones de análisis y visualización de la memoria almacenada son algo básicas.
Precios
$125/mes.
9. Supermemory
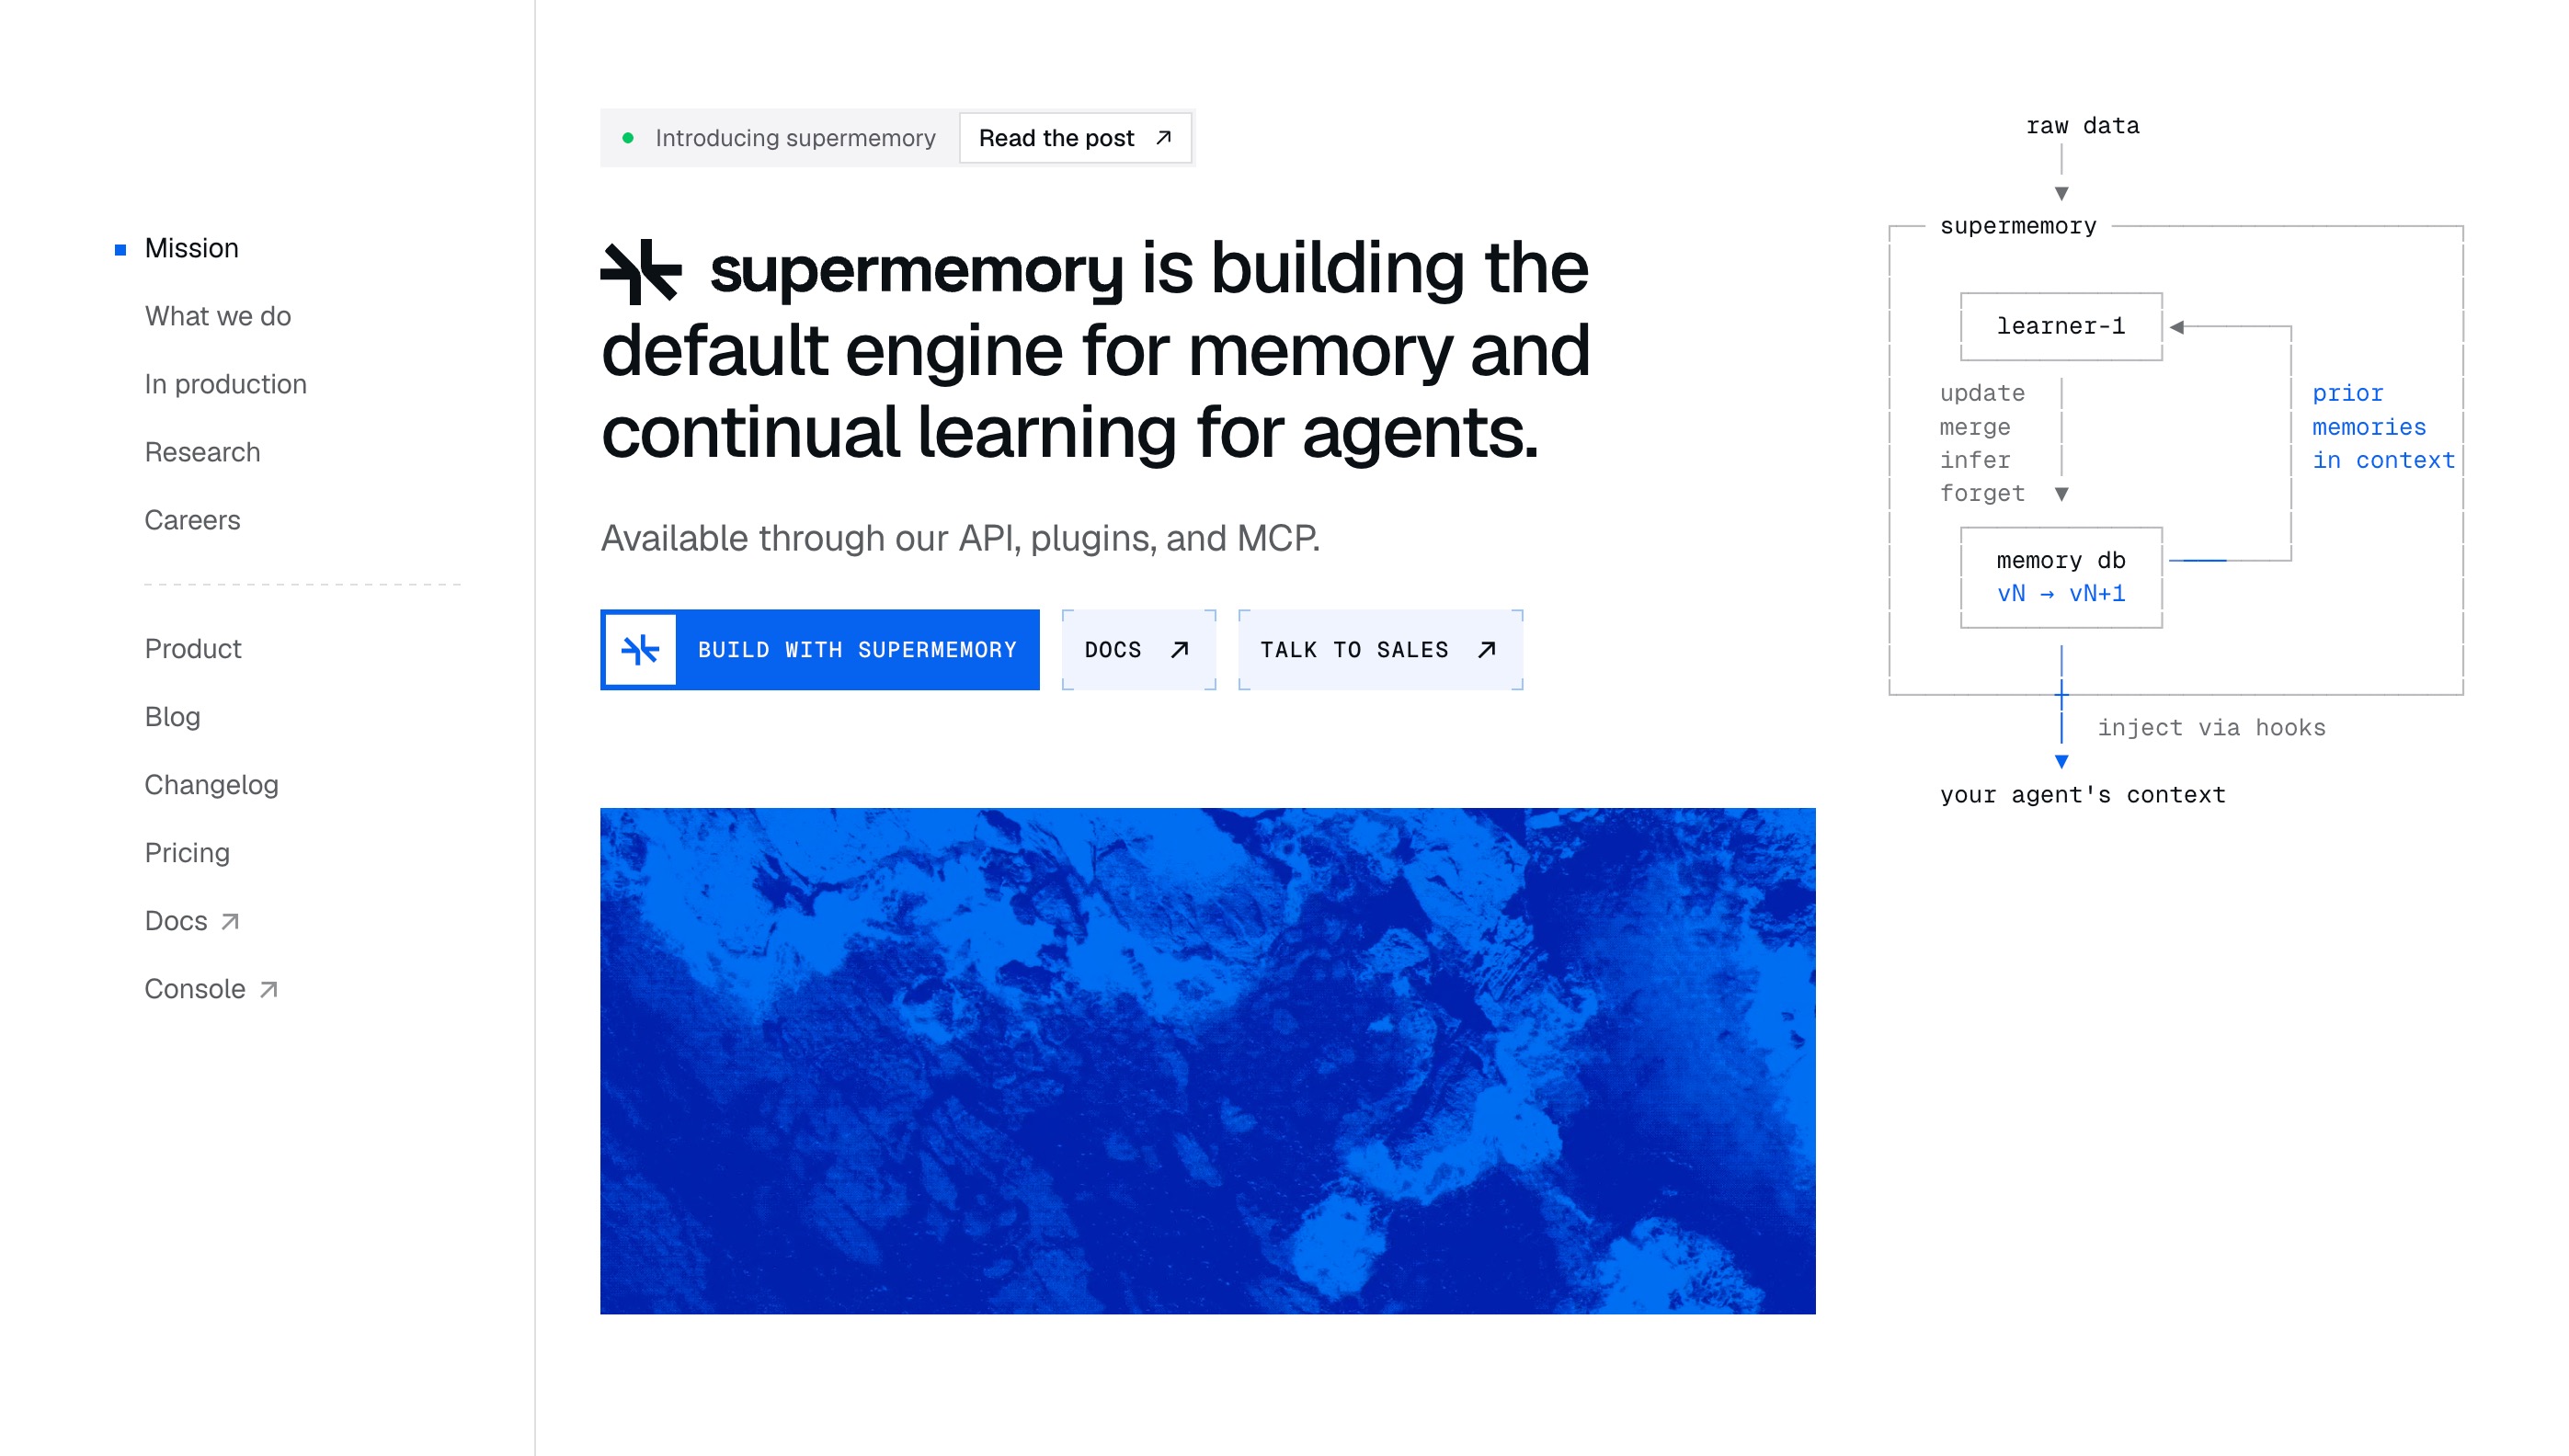
Supermemory funciona como un "segundo cerebro" de IA de código abierto y una API de memoria universal. Permite a los agentes de IA organizar de manera inteligente y recuperar instantáneamente el conocimiento guardado de diversos contextos, convirtiendo archivos, chats y enlaces desorganizados en un motor cognitivo portátil y altamente consultable.
Características clave
- API de memoria universal: Conecta múltiples aplicaciones y extensiones de IA diferentes a una única fuente de memoria unificada.
- Comprensión contextual: Evalúa activamente las relaciones temporales y causales entre las memorias guardadas para mejorar la recuperación.
- Extensiones multiplataforma: Viene con extensiones de navegador y herramientas para guardar datos directamente en el cerebro de la IA.
Pros
- Altamente versátil para construir tanto herramientas de IA personales como bases de conocimiento profesionales.
- La arquitectura de código abierto fomenta los plugins impulsados por la comunidad y las mejoras continuas.
- Excelente para construir aplicaciones al estilo de un "segundo cerebro".
Contras
- Requiere un poco de conocimiento técnico para configurar y mantener las versiones autoalojadas.
- La documentación sigue creciendo a medida que el proyecto escala.
Precios
$19/mes.
10. Mnemoverse
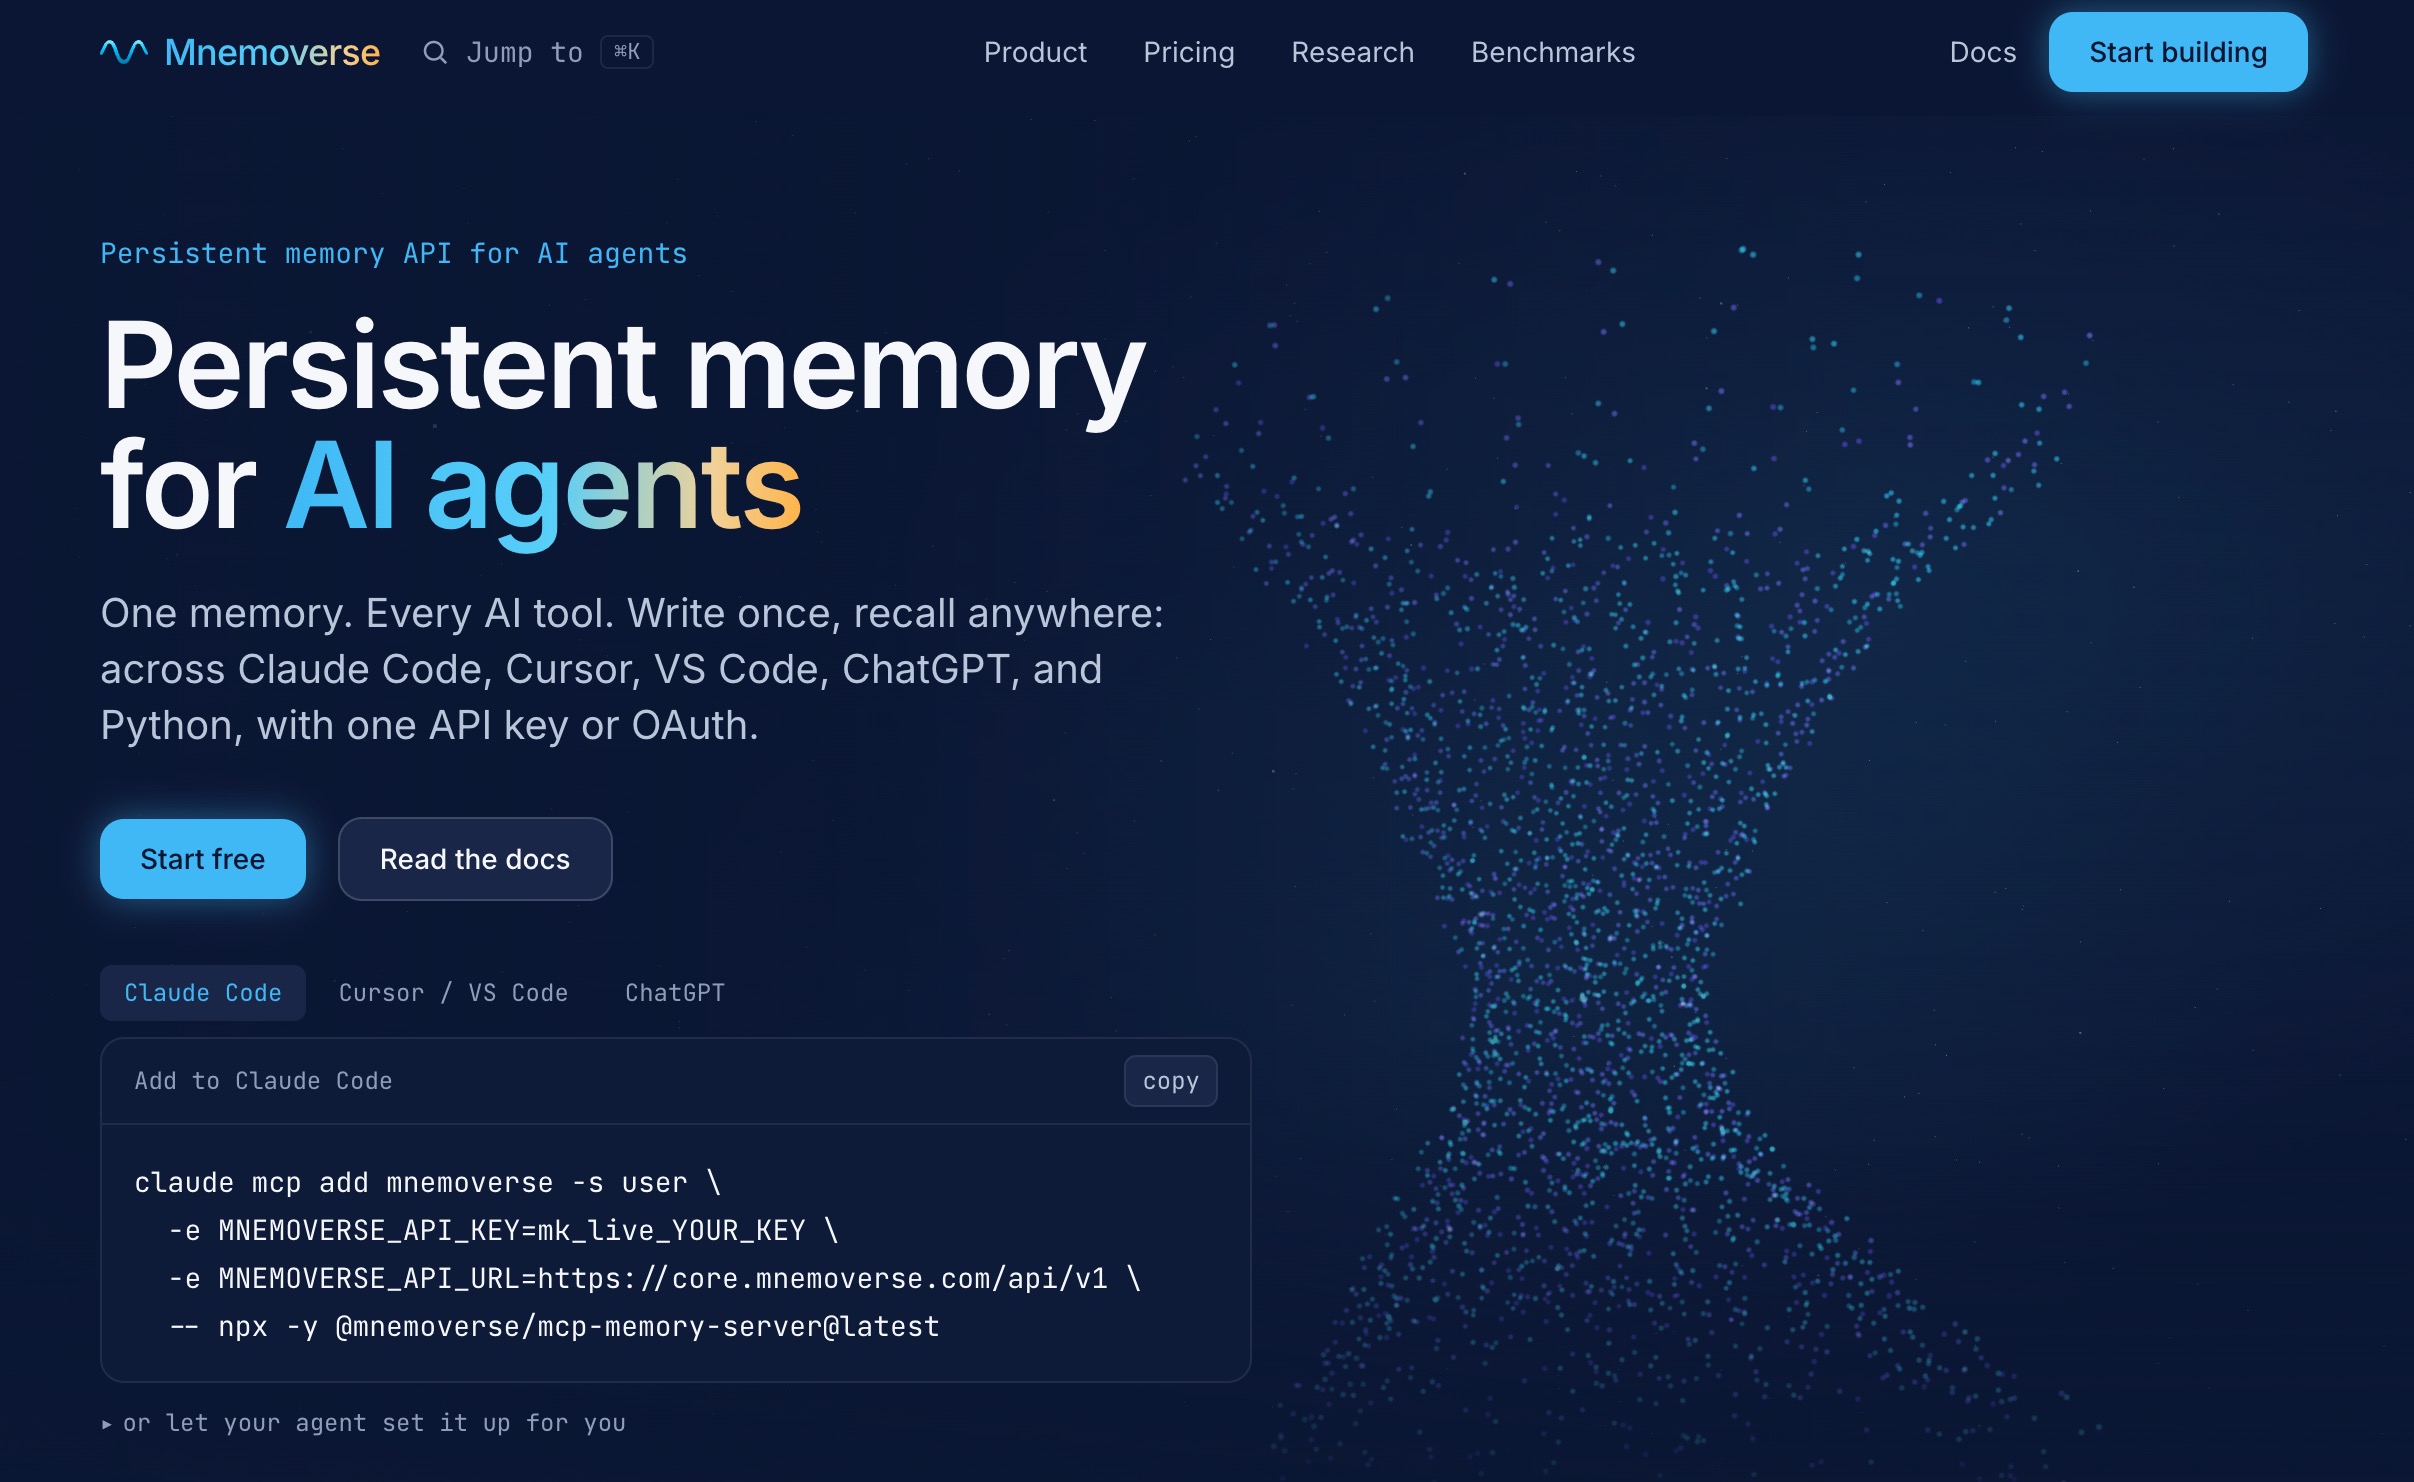
Mnemoverse ofrece una infraestructura de memoria persistente y entre herramientas adaptada para los agentes de IA modernos. Al utilizar el Model Context Protocol (MCP), actúa como una capa de memoria universal que garantiza que sus flujos de trabajo de IA (ya sea en editores de código o interfaces de chat) compartan exactamente la misma comprensión contextual.
Características clave
- Contexto entre herramientas: Funciona a la perfección en las principales plataformas de IA como Claude, ChatGPT y Cursor a través de una única clave de API.
- Puntuación de importancia dinámica: Clasifica y ajusta automáticamente la relevancia de los recuerdos en función de los comentarios implícitos y explícitamente del usuario.
- Integración de MCP en vivo: Ofrece una configuración sin fricciones a través de los registros oficiales de MCP, lo que la hace disponible instantáneamente para los clientes de IA modernos.
Pros
- Ofrece una verdadera experiencia de "pasaporte de memoria", rompiendo los silos de datos entre diferentes aplicaciones de IA.
- Configuración increíblemente fluida para desarrolladores que ya utilizan el ecosistema MCP.
- Se centra en gran medida en el aprendizaje adaptativo en lugar de solo en el almacenamiento estático.
Contras
- Su utilidad depende en cierta medida de la adopción más amplia del estándar MCP por parte de la industria.
- Las funciones de aprendizaje avanzado requieren depender de su infraestructura en la nube gestionada.
Precios
$29/mes.
Cómo elegir la alternativa a Pinecone adecuada
Al seleccionar un backend de memoria para su agente de IA, la decisión se reduce a sus necesidades arquitectónicas específicas. Si su único objetivo es almacenar embeddings de documentos básicos para un pipeline RAG estándar, bases de datos robustas como Weaviate y LanceDB ofrecen excelentes rutas de código abierto altamente escalables. Cuando se trata de relaciones complejas entre entidades y deducciones lógicas multisalto, Neo4j es prácticamente imbatible. Para los desarrolladores que desean una memoria conversacional directa para chatbots sin reinventar la rueda, los wrappers diseñados específicamente como Zep y Mem0 son increíblemente convenientes.
Sin embargo, si desea una infraestructura de memoria inteligente y completa que maneje de forma nativa contextos multimodales, resuelva activamente conflictos fácticos y garantice una continuidad perfecta entre sesiones, MemoryLake se destaca como la opción definitiva. Cierra la brecha entre el almacenamiento de datos sin procesar y la verdadera comprensión cognitiva de la IA, liberando a los desarrolladores del trabajo pesado de la gestión de estados y reduciendo drásticamente los costos de inferencia de los LLM.
Veredicto final
Aunque las bases de datos vectoriales estándar han llevado a la IA hasta aquí, el futuro de los agentes autónomos exige una capa cognitiva sofisticada. Herramientas como Neo4j, Weaviate y Mem0 ofrecen capacidades fantásticas para diferentes nichos. Sin embargo, para los equipos que buscan construir aplicaciones de IA altamente avanzadas y conscientes del contexto que recuerden y evolucionen de forma natural, MemoryLake es el ganador definitivo. Al tratar la memoria no solo como almacenamiento, sino como una infraestructura inteligente que resuelve conflictos, MemoryLake permite a los desarrolladores crear experiencias de IA que son verdaderamente persistentes, confiables y rentables.