
Qué es TokenEconomizer
Descripción de Microsoft: "TokenEconomizer es un plugin de código abierto que aprende de las sesiones pasadas de un agente en un repositorio para reducir el desperdicio en sesiones futuras, sin modificar al agente ni su modelo subyacente".
Es un plugin, no una función nativa de Claude Code o Codex. Ni Anthropic ni OpenAI lo incluyen de fábrica. Lo añades al agente que ya usas, y el agente en sí permanece igual. El README del proyecto indica que es un plugin para Claude Code, Codex, la CLI de GitHub Copilot y Pi, con soporte experimental para varios otros agentes.
Aprende por repositorio. La unidad de aprendizaje es la base de código a la que regresas constantemente. El blog explica el razonamiento con sus propias mediciones: las acciones repetidas dentro de un mismo repositorio eran mucho más comunes que las coincidencias con el historial de otro repositorio. La experiencia de un proyecto ayuda principalmente a ese proyecto.
Por tanto, la respuesta honesta a la pregunta del titular es limitada. Claude Code y Codex no se reentrenan a sí mismos. Un plugin como este puede observar lo que sucede en tus sesiones y cambiar con qué comienza la siguiente sesión.
Lo que aprende: tres tipos de lecciones
El blog describe tres mecanismos. Cada uno convierte las sesiones pasadas en un tipo diferente de lección.
Micro-skills: hechos sobre cómo funciona el repositorio. El README los describe como cosas que "las sesiones siguen redescubriendo", como "un paso de construcción que debe ejecutarse primero, la ortografía de un comando que funciona aquí", una variable de entorno que necesita un comando o dónde residen los archivos generados. El blog los llama conocimientos específicos del repositorio en notas de una sola línea.
Poda de herramientas (Tool pruning): qué herramientas nunca necesita este repositorio. La descripción de cada herramienta cargada se envía con cada solicitud. Si el historial muestra que una herramienta no se utiliza, el plugin la excluye de sesiones posteriores a través de la propia configuración del agente. Las herramientas principales para ejecutar comandos y editar archivos siempre se mantienen.
Intervención en bucles de fallo: cuando un turno se bloquea. Cuando el agente sigue chocando con el mismo fallo, un modelo juez decide si realmente está atascado. Si es así, el agente recibe una nota corta sugiriendo un enfoque diferente.
Solo la primera de estas es memoria en el sentido cotidiano, un hecho que se traslada de una sesión a la siguiente. Las otras dos son lecciones sobre el comportamiento. Las tres provienen de la misma fuente: después de cada sesión, como dice el blog, "TokenEconomizer lee el registro de la sesión y actualiza lo que sabe sobre el repositorio".
La regla que decide cuándo se confía en un hecho
Esta es la parte del diseño que más vale la pena adoptar, instales o no algo.
Un hecho no se añade la primera vez que aparece. El README establece el umbral: "Un hecho se indica al inicio de cada sesión una vez que tres sesiones lo han confirmado, y se descarta cuando sesiones posteriores lo contradicen".
Los hechos provienen de dos lugares, según el README: "fallos que se repiten a través de las sesiones" y un modelo que revisa las sesiones recientes cada pocas sesiones y propone hechos. Una propuesta por sí sola no es suficiente. Tiene que ser confirmada por evidencia repetida antes de llegar al contexto inicial del agente. Hasta entonces, permanece en una lista de hechos que aún se están formando.
El blog describe el mismo filtro con sus propias palabras: las notas "se añaden al contexto inicial del agente solo después de que varias sesiones hayan confirmado el patrón, y se retira la nota si la evidencia posterior la contradice".
¿Por qué importa esto? Porque la forma obvia de construir un agente que mejore por sí mismo es dejar que anote cualquier conclusión al final de una sesión. Ese enfoque tiene una debilidad conocida: una suposición afortunada, o una conclusión errónea, se convierte en una instrucción permanente para cada sesión futura. Un umbral de confirmación repetida es una respuesta directa a eso. Una sola sesión no puede crear un hecho por sí misma.
El README enumera esto como un principio de diseño: "Los hechos se forman solo a partir de evidencia repetida, las herramientas se eliminan solo después de no ser utilizadas, y el protector de bucle no interviene en un turno que aún está progresando".
Cuándo se descarta un hecho
La otra mitad de la regla es igual de importante. Un hecho aprendido no es permanente.
Si sesiones posteriores contradicen un hecho, este se descarta. Si tu equipo cambia de un ejecutor de pruebas a otro, el comando antiguo deja de ser confirmado y comienza a fallar, y el plugin retira la nota. Nada en el README sugiere que el hecho permanezca allí para siempre solo porque una vez fue cierto.
La misma reversibilidad se aplica a los otros mecanismos. El principio del README es "Mantener cada acción reversible", y detalla lo que eso significa: "Un hecho que las sesiones posteriores contradicen se descarta, las herramientas eliminadas pueden devolverse, y el protector de bucle solo redirige y te avisa: detener un turno es tu decisión".
Para las herramientas podadas, la descripción del README es corta: "Un comando la trae de vuelta".
Para los turnos atascados, el límite del plugin es explícito. Después de una redirección, si el turno sigue atascado, el README dice que TokenEconomizer te indica cómo detenerlo, y "nunca detiene un turno por sí mismo".
Así que el bucle de aprendizaje tiene un freno en cada extremo. Los hechos necesitan confirmación repetida para entrar y contradicción para salir. La lista de herramientas se puede restaurar. Un turno atascado sigue siendo tu decisión.
Dónde guarda lo que aprende
El README responde a esto directamente: "Lo que aprende se queda en tu máquina, en ~/.tokeneconomizer".
El blog repite el punto: el plugin "guarda lo que aprende en la máquina del desarrollador". También señala que el plugin no requiere una clave API propia.
Eso tiene algunas consecuencias prácticas:
- Es por máquina. Un compañero de equipo que trabaje en el mismo repositorio en su propio portátil comienza con su propia copia, construida a partir de sus propias sesiones.
- Es por repositorio. Lo que aprende en una base de código se guarda para esa base de código.
- Funciona a través de lo que el agente ya lee. Según el README, "Los hechos entran en el contexto al inicio de la sesión, y las herramientas se eliminan a través de la propia configuración del agente, por lo que nada depende de que el agente aprenda una nueva herramienta".
Las llamadas al modelo que realiza el plugin, como el proponente de hechos y el juez, también se ejecutan a través de tu propio agente. El README dice que se ejecutan "en el mismo plan o inicio de sesión", y su coste se incluye en los informes del plugin.
Puedes ver lo que ha aprendido. Los comandos del plugin incluyen status, que muestra lo que aprendió e hizo en el repositorio, y microskills, que enumera "los hechos que inyecta y los que aún se están formando". En Claude Code, los comandos se escriben con el prefijo /tokeneconomizer:, y en Codex con $tokeneconomizer:.
Qué está activado por defecto y qué no
Esto es importante si esperas que la parte de la memoria empiece a funcionar de inmediato.
La poda de herramientas y el protector de bucle están activados por defecto. Las Micro-skills, la parte que aprende hechos, no lo están. El README explica por qué: "Micro-skills está desactivado por defecto, porque su proponente añade llamadas al modelo y cuánto ahorra depende del repositorio y del trabajo que realices allí".
Lo activas por repositorio, o para todos los repositorios, con el comando config del plugin. También hay un modo más ligero que aprende hechos solo de fallos repetidos, sin llamadas al modelo.
En Claude Code hay una opción más. El README dice: "En Claude Code, el plugin también puede aprender de las sesiones anteriores de un repositorio, leyendo los propios registros de Claude Code desde el más antiguo primero y sin ninguna llamada al modelo. Esto está desactivado por defecto". Solo lee ese historial antes de que el plugin haya aprendido de cualquier sesión en el repositorio, por lo que está pensado para activarse justo después de la instalación.
Lo que no aprende
Leyendo el README detenidamente, los límites son claros.
No aprende el porqué. Una micro-skill es un hecho de una sola línea: ejecuta este paso primero, usa esta ortografía de comando. El razonamiento detrás de una elección de diseño, una conversación sobre qué enfoque tomar o una decisión que tu equipo tomó el mes pasado no es el tipo de cosa que el mecanismo está diseñado para capturar.
No aprende de una sola sesión. El umbral de confirmación significa que una lección que aprendiste por las malas hoy no llegará a la sesión de mañana mediante este plugin. Necesita repetirse.
No comparte entre herramientas por sí solo. Los comandos y el almacenamiento son por máquina. Si usas Claude Code para una tarea y Codex para otra en el mismo repositorio, la forma en que los dos hosts comparten lo aprendido no es algo que el README describa en detalle, por lo que es más seguro no asumir que ven los mismos hechos.
No reemplaza tus archivos de instrucciones. Los hechos se indican al inicio de la sesión junto con lo que el agente ya carga, como CLAUDE.md o AGENTS.md. Esos archivos siguen siendo el lugar donde pertenecen las convenciones acordadas por tu equipo.
Claude Code también tiene su propia memoria integrada que el agente escribe por sí mismo. Cubrimos cómo funciona eso en nuestra guía sobre qué es la auto-memoria de Claude Code.
En qué versiones se probó
El README enumera los rangos de versiones probadas para cada agente: Claude Code 2.1.300 a 2.1.310, y Codex 0.153.1 a 0.164.0. Añade que "las versiones más nuevas aún no han sido probadas".
Ambos agentes han lanzado versiones posteriores a esos rangos. Eso no significa que el plugin falle en ellas, solo que sus autores no las han listado como probadas. Si lo pruebas en una versión más reciente, verifica el status después de unas pocas sesiones para confirmar que está registrando lo que esperas.
Específicamente para Codex, los ganchos (hooks) del plugin deben ser de confianza antes de ejecutarse, y el README dice que los ganchos surten efecto a partir de tu próxima sesión de Codex.
Lo que la investigación encontró sobre el aprendizaje a lo largo del tiempo
El blog informa que el coste disminuyó en cada repositorio probado mientras que el éxito de las tareas se mantuvo ampliamente estable. El hallazgo más interesante para esta guía es la forma de la curva: "Los ahorros crecen a medida que se acumula la experiencia".
Las primeras sesiones en un repositorio pueden costar más mientras el plugin aprende. En los resultados de Claude Code del blog, cada repositorio se volvió más barato que el predeterminado para la sexta tarea. Eso es lo que se esperaría de un diseño que espera evidencia repetida: sacrifica un comienzo lento a cambio de menos lecciones erróneas.
Los investigadores también encontraron que una estrategia fija no funcionaba en todas partes. Otros tres plugins de código abierto que probaron, cada uno construido en torno a un enfoque fijo de ahorro de costes, ayudaron en algunos repositorios y no en otros. Su conclusión fue que el control de costes tiene que adaptarse al repositorio, razón por la cual todo se aprende por base de código.
Anthropic ha escrito sobre la misma tensión desde el otro lado. Su guía para agentes siempre activos (always-on) dice que la memoria debe contener solo lo que un agente no puede volver a buscar fácilmente, lo cual cubrimos en nuestra guía sobre qué son los agentes siempre activos.
Lo que la gente intenta primero
Esperar que el agente aprenda por sí mismo. Claude Code y Codex no se reentrenan con tus sesiones. El aprendizaje entre sesiones proviene de funciones de memoria y plugins como este.
Activar todo y esperar hechos. Micro-skills está desactivado por defecto. Revisa la config antes de concluir que no se aprendió nada.
Anotar cada conclusión después de cada sesión. Ese es el enfoque que el umbral de confirmación está diseñado para evitar.
Asumir que un hecho aprendido es permanente. Los hechos contradichos se descartan y las herramientas podadas pueden restaurarse.
Esperar que el plugin guarde decisiones. Guarda hechos de una sola línea sobre cómo funciona el repositorio, no el razonamiento detrás de las elecciones.
La solución: Deja que las lecciones se ganen su lugar
Paso 1: Decide qué tipo de lección quieres conservar
Separa los hechos sobre el repositorio (comandos, pasos de configuración) de las decisiones (por qué se eligió un enfoque). Necesitan hogares diferentes.
Paso 2: Requiere evidencia repetida antes de que una lección se convierta en instrucción
Ya sea que la escriba un plugin o una persona, espera hasta que una lección se haya mantenido más de una vez antes de añadirla a lo que carga cada sesión.
Paso 3: Dale a cada lección una salida
Cuando un hecho deje de ser cierto, elimínalo. Revisa los hechos aprendidos y los archivos de instrucciones de forma programada.
Paso 4: Escribe las decisiones tú mismo
El razonamiento detrás de una elección no aparecerá como un fallo repetido. Regístralo a propósito, en palabras que una sesión futura pueda usar.
Configurando esto en MemoryLake
TokenEconomizer aprende cómo se comporta un repositorio. Las decisiones detrás de tu trabajo, como qué enfoque elegiste, cuál descartaste y por qué, tienen que ser escritas por alguien que las conozca.
MemoryLake es una capa de memoria para ese tipo de contexto de proyecto, como decisiones, convenciones y lecciones que se han mantenido, guardadas en un lugar que tú mantienes y disponibles para los asistentes que conectes, como ChatGPT, Claude Code y Codex.
Tú escribes las entradas tú mismo, con tus propias palabras. No se lee nada de, ni se escribe en, ni se borra de ~/.tokeneconomizer, tus registros de sesión, la configuración de tu agente, tus archivos CLAUDE.md o AGENTS.md, ni el almacenamiento de ningún proveedor. TokenEconomizer y la propia memoria de cada agente funcionan de la manera que sus autores describen.
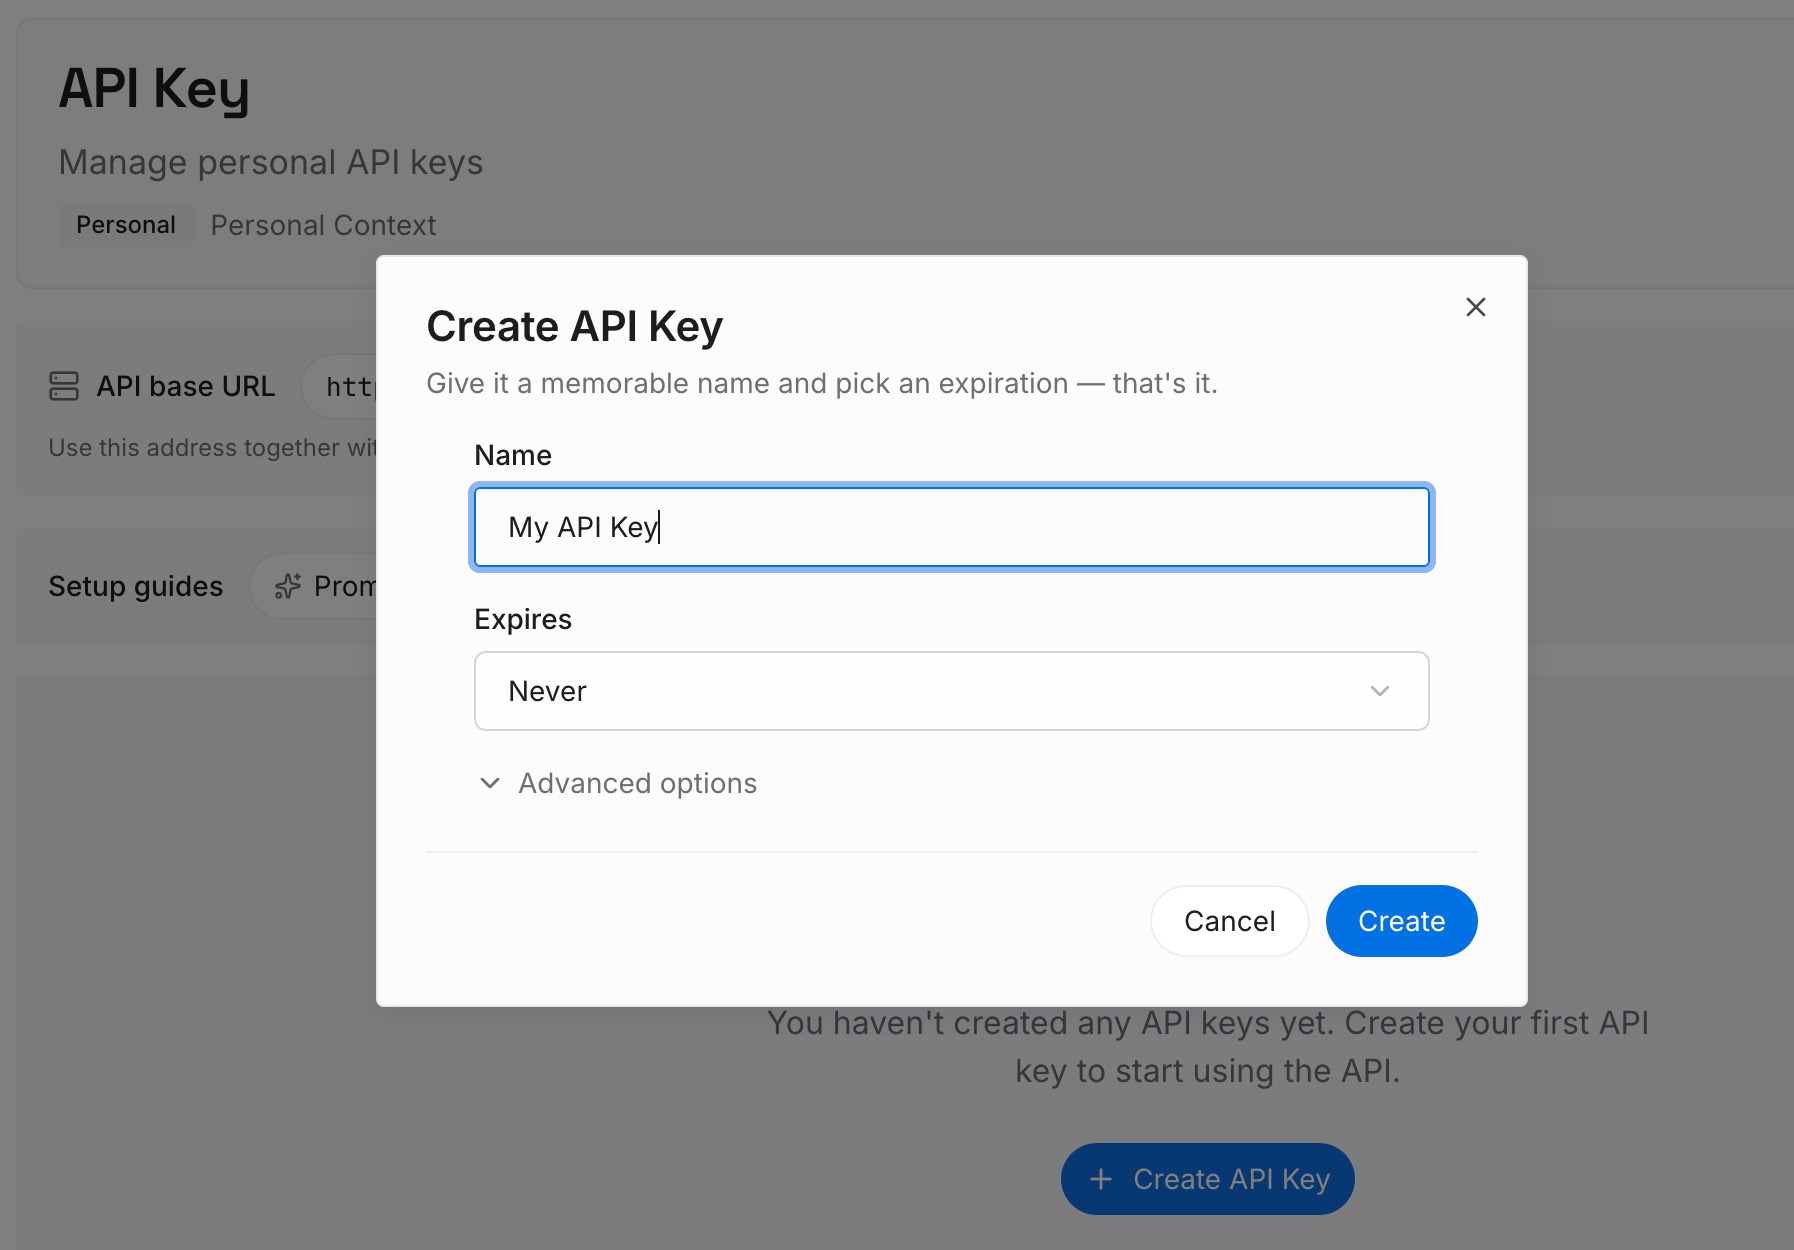
Paso 1: Crea una clave API
Inicia sesión y genera una clave desde el panel de control. Guárdala fuera de tus repositorios, como cualquier otra credencial.
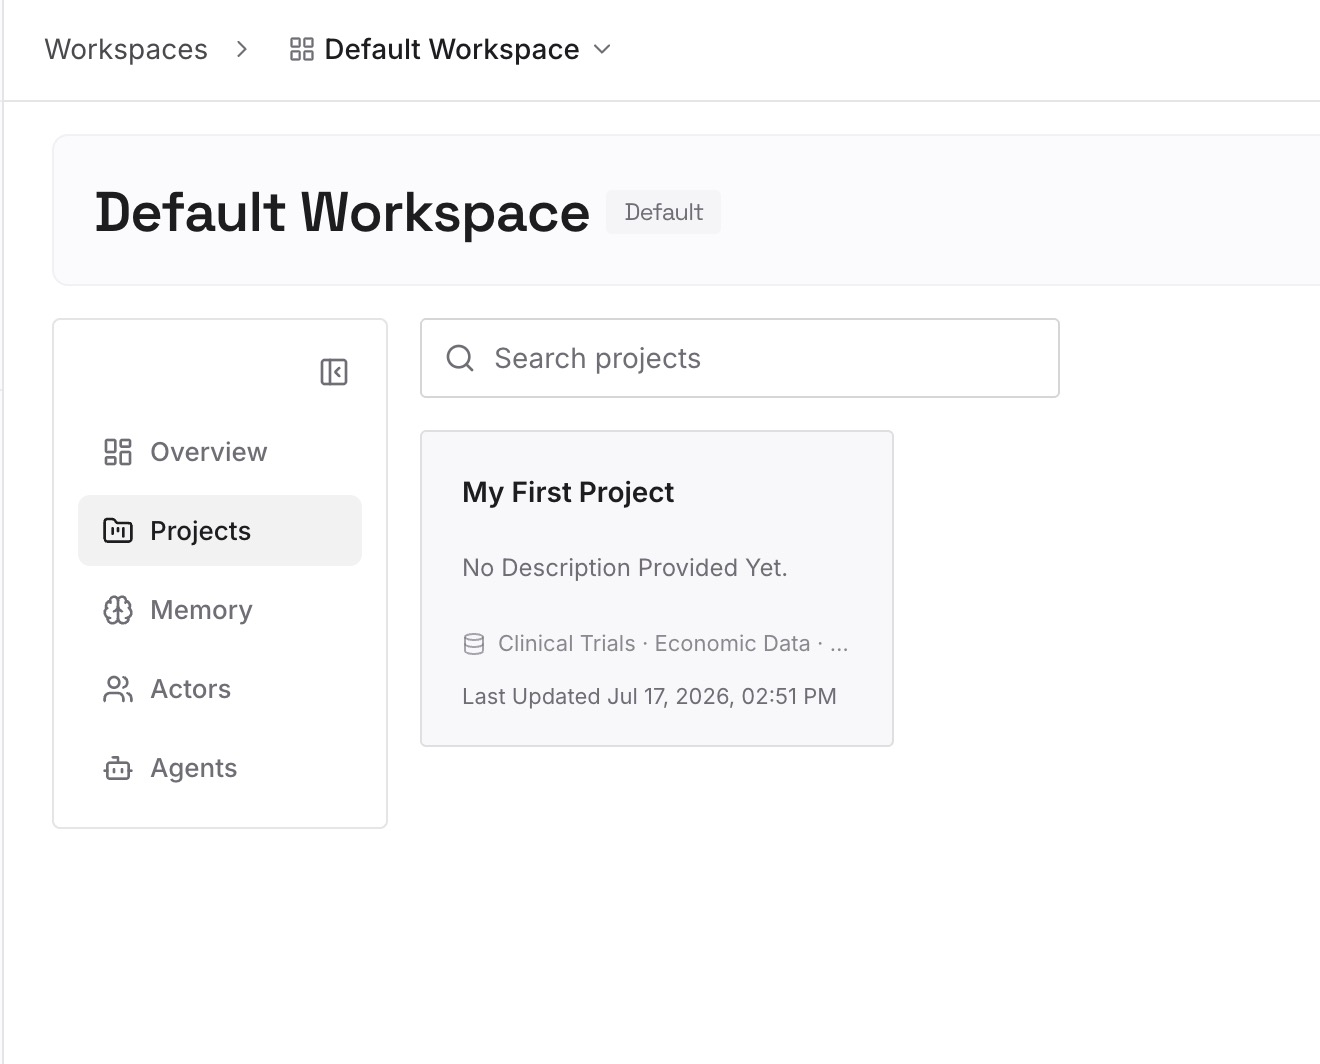
Paso 2: Sube tus primeras memorias
Comienza con lo que escribiste en el Paso 4 de la solución: decisiones de sesiones recientes y las razones detrás de ellas. Una decisión por entrada, con su fecha.
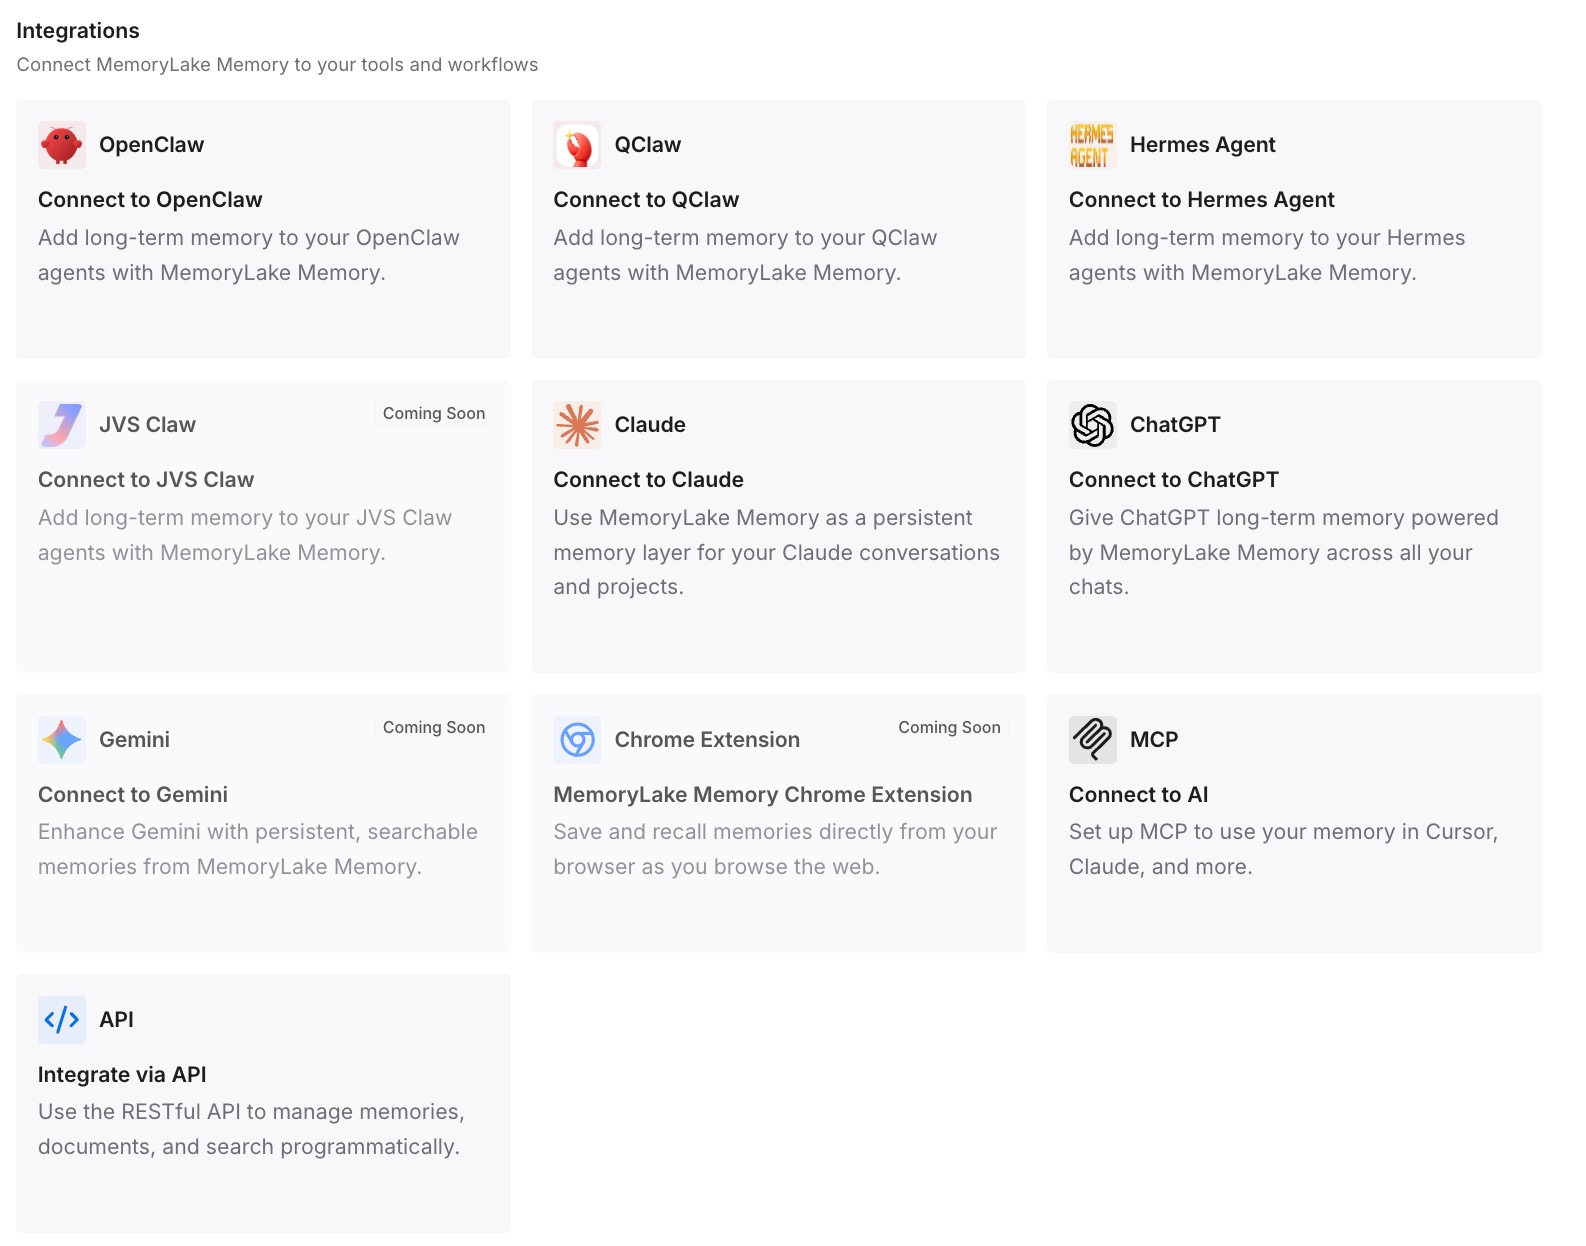
Paso 3: Conecta tu AI y agentes
Conecta Claude Code, Codex y los otros asistentes que uses. Cada uno puede recurrir a las mismas decisiones.
Qué cambia esto en la práctica
La primera diferencia es una división más limpia. Los hechos repetidos sobre el repositorio se pueden aprender automáticamente, y las decisiones las escriben las personas.
La segunda es menos lecciones erróneas. Una decisión que registras es una que has verificado, no una inferida de una sola sesión.
La tercera es la continuidad entre herramientas y máquinas. Las razones detrás de tu trabajo no están ligadas a los datos del plugin de un solo portátil.
Mejores prácticas para agentes de programación que mejoran por sí mismos
Aprende por repositorio. La investigación encontró que la experiencia ayudaba principalmente dentro de la misma base de código.
Confirma antes de confiar. Una lección debe mantenerse a través de las sesiones antes de que cada sesión la cargue.
Mantenlo reversible. Cada hecho aprendido necesita una forma de ser descartado.
Revisa qué está activado. Micro-skills está desactivado por defecto en TokenEconomizer.
Mira lo que se aprendió. Usa el comando microskills del plugin para ver los hechos inyectados y en formación.
Mantén las convenciones en archivos de instrucciones. CLAUDE.md y AGENTS.md siguen siendo el lugar para las reglas acordadas.
Registra las decisiones a propósito. No aparecerán como fallos repetidos.
Conclusión
Claude Code y Codex no se reentrenan a sí mismos, pero un plugin puede cambiar con qué comienza su próxima sesión. TokenEconomizer de Microsoft aprende por repositorio a partir de los registros de sesiones pasadas: hechos de una sola línea, herramientas no utilizadas y turnos atascados. Un hecho llega al contexto inicial solo después de que tres sesiones lo confirmen, y se descarta cuando sesiones posteriores lo contradicen. Todo se guarda en tu máquina en ~/.tokeneconomizer, y la parte de aprendizaje de hechos está desactivada por defecto.
El diseño es un modelo útil para cualquier configuración de mejora personal: requiere evidencia repetida, dale a cada lección una salida y mantén el razonamiento detrás de tus decisiones en algún lugar que mantengas tú mismo.