
El lugar donde inicias Claude decide qué se carga
La primera decisión es la más simple y la que tiene mayor efecto. La documentación dice: "El lugar donde lanzas claude determina qué archivos puede leer y editar Claude sin una concesión de permiso adicional, qué archivos CLAUDE.md se cargan en el contexto al inicio y qué configuraciones de proyecto se aplican".
Compara las dos opciones:
- Iniciar desde la raíz del repositorio. Claude puede acceder a todos los archivos. Al iniciar, carga solo el CLAUDE.md de la raíz, y los archivos de los subdirectorios se cargan bajo demanda.
- Iniciar desde un subdirectorio. Claude puede acceder a ese subárbol hasta que le concedas más permisos. Al iniciar, carga el CLAUDE.md de ese directorio más el de todos sus ancestros.
La documentación sugiere iniciar desde la raíz cuando las tareas abarcan múltiples paquetes, y desde un subdirectorio cuando el trabajo se limita a un solo paquete.
Un detalle fácil de pasar por alto: "Las configuraciones de proyecto en .claude/settings.json no se heredan de los directorios padres de la misma manera que los archivos CLAUDE.md". Las instrucciones caen en cascada desde los directorios padres. Las configuraciones no.
Estratificar archivos CLAUDE.md por directorio
La documentación describe por qué un único archivo en la raíz deja de funcionar: "tiende a crecer para cubrir las convenciones de cada subsistema, consumiendo contexto en instrucciones no relacionadas con la tarea actual, o se mantiene demasiado genérico para ser útil".
Su recomendación es usar dos niveles:
- Un CLAUDE.md en la raíz para instrucciones que se aplican en todas partes, como estándares de codificación y convenciones de commit.
- Un CLAUDE.md por paquete o subsistema para convenciones específicas del stack de esa área.
El ejemplo de la documentación muestra el efecto. Cuando inicias Claude desde el paquete de API, carga el CLAUDE.md de ese paquete y el de la raíz, "sin instrucciones de packages/web/ en el contexto".
Para verificar qué archivos se cargaron realmente, ejecuta /context all y revisa la lista bajo Memory files.
La documentación también ofrece tres formas de mantener estos archivos actualizados:
- Revisar las ediciones de CLAUDE.md en las pull requests, como cualquier otra documentación.
- Revisarlos tras lanzamientos importantes de modelos. Las instrucciones que servían para mitigar limitaciones de un modelo antiguo pueden convertirse en una carga innecesaria cuando un modelo más nuevo maneja el caso.
- Añadir un hook de Stop que proponga actualizaciones. Un hook de Stop recibe la ruta al transcrito de la sesión, por lo que un script puede proponer cambios en CLAUDE.md mientras la brecha está fresca.
Los archivos de subdirectorios que se cargan bajo demanda tienen su propio comportamiento de tamaño, que difiere del archivo raíz. Lo cubrimos en nuestra guía sobre el límite de CLAUDE.md en subdirectorios en Claude Code.
CLAUDE.md por directorio o reglas con alcance de ruta
Claude Code tiene una segunda forma de dirigir instrucciones a una parte del árbol: archivos de reglas bajo .claude/rules/ con un glob de paths:. La documentación compara ambos.
Un CLAUDE.md por directorio vive dentro del directorio con su código. Se carga al inicio cuando empiezas desde ese directorio, o bajo demanda. Es ideal para equipos donde los dueños de los directorios mantienen sus propias convenciones.
Una regla con alcance de ruta vive en la carpeta central .claude/ en la raíz del repositorio. Se carga cuando Claude trabaja con un archivo que coincide con su glob. Es ideal para equipos que quieren todas las convenciones en un solo lugar, o para una regla que se aplica a muchas rutas dispersas.
Cubrimos cómo funcionan los archivos de reglas en nuestra guía sobre qué son las reglas de Claude Code.
Mantener fuera las instrucciones de otros paquetes
Cuando inicias desde la raíz, el CLAUDE.md de cada subdirectorio puede cargarse bajo demanda a medida que Claude toca archivos allí. La configuración claudeMdExcludes omite archivos específicos por ruta o glob "para que nunca se carguen".
La documentación lo sugiere para directorios en los que nunca trabajas, como paquetes de otros equipos, código legado o subárboles de terceros (vendored). Algunos detalles deciden si funciona como esperas:
- Es estático. "La lista de exclusión es estática, no un interruptor por tarea". Para enfocarte en un paquete diferente cada día, inicia Claude desde ese paquete en lugar de editar las exclusiones.
- Los patrones coinciden con rutas absolutas. Comienza los patrones de estilo relativo con
**/para que coincidan en cualquier parte del árbol. - También cubre las reglas. Excluir la carpeta de un paquete omite cada CLAUDE.md y archivo de reglas debajo de ella, mientras que el CLAUDE.md raíz y los paquetes en los que trabajas se cargan normalmente.
- Los alcances se fusionan. Puedes configurarlo a nivel de usuario, proyecto, local o gestionado, y los arrays se fusionan entre alcances, por lo que un valor predeterminado del equipo y las adiciones personales se combinan.
- Los archivos gestionados se siguen cargando. Si tu organización despliega un CLAUDE.md gestionado, un patrón que coincida con él no lo omitirá.
Para exclusiones que solo se aplican a ti, la documentación sugiere .claude/settings.local.json. Si creas ese archivo a mano, añádelo tú mismo a tu gitignore.
Evitar que Claude lea código que no necesita
Las instrucciones son solo una parte de lo que llena el contexto. La documentación dice: "Las lecturas de archivos son otro costo que crece con la base de código".
Rutas en gitignore. Las búsquedas de contenido de Claude respetan .gitignore por defecto, por lo que rutas como node_modules/, dist/ y build/ se mantienen fuera de los resultados de búsqueda.
Código generado o de terceros en el repositorio. Para rutas que están en el repositorio, añade reglas de denegación de Read en permissions.deny. Ponlas en .claude/settings.json para todos en el repositorio, en .claude/settings.local.json para ti, o en configuraciones gestionadas para forzarlas en todas partes.
La documentación es clara sobre el límite: "Las reglas de denegación no cubren subprocesos que abren archivos por sí mismos".
Búsquedas en el servidor de lenguaje. Los plugins de inteligencia de código conectan a Claude con un servidor de lenguaje, para que pueda saltar a definiciones y encontrar referencias "en lugar de escanear el árbol". La documentación dice que esto combina bien con las exclusiones y las reglas de denegación: estas mantienen fuera el contenido irrelevante, y la inteligencia de código evita que Claude lea todo lo que queda.
Descarga solo lo que necesites y añade directorios con cuidado
Para worktrees, la configuración worktree.sparsePaths utiliza git sparse-checkout para escribir solo los directorios listados más los archivos de nivel raíz. Incluye .claude en la lista si quieres que las configuraciones y reglas de la raíz estén disponibles dentro del worktree.
Cuando inicias desde un paquete y necesitas acceso a un hermano, la forma en que otorgas el acceso cambia lo que se carga. Tabla de la documentación:
- La configuración
additionalDirectories: nunca carga CLAUDE.md, reglas ni skills. - El flag
--add-diro el comando/add-dir: carga skills, y carga CLAUDE.md y reglas solo cuando la variable de entornoCLAUDE_CODE_ADDITIONAL_DIRECTORIES_CLAUDE_MDestá configurada.
Por lo tanto, añadir un paquete hermano le da a Claude acceso a los archivos, pero no necesariamente a las convenciones de ese paquete. Si las reglas del hermano son importantes para la tarea, usa --add-dir con la variable de entorno.
Añadir skills por directorio
Las skills son adecuadas para material de referencia que debe cargarse solo cuando sea relevante. La documentación dice que cualquier subdirectorio puede definir skills bajo su propio .claude/skills/, guardadas con el código de esa área. Su ejemplo: una skill de pruebas de API en el paquete de API y una skill de patrones de componentes en el paquete web. Cuando Claude trabaja en un archivo de un paquete, carga la skill de ese paquete.
Hay un inconveniente con muchas skills. Claude elige una skill leyendo el nombre y la descripción de cada skill descubierta, y "solo el contenido completo de la skill elegida se carga en el contexto". Cuando hay muchas, la documentación dice que algunas skills pueden perder sus descripciones por completo. Su consejo: "Mantén las descripciones cortas y comienza con palabras que contendría una solicitud".
Qué skills están en el alcance depende de dónde empieces:
- Desde un subdirectorio: las skills de ese directorio, las de cada padre hasta la raíz, y las skills de usuario y de empresa.
- Desde la raíz: las skills de la raíz más las skills de cada subdirectorio que Claude toque, "lo cual puede acumularse en cientos".
Para skills que comparten muchos directorios, como convenciones de PR o una lista de verificación de despliegue, la documentación sugiere el .claude/skills/ de la raíz.
Cuando la estratificación deja de escalar
La documentación es sincera al decir que los archivos por directorio no lo solucionan todo: "Las convenciones derivan, los archivos se vuelven obsoletos y nadie es dueño de la raíz".
Su recomendación es mover las convenciones y el contenido de referencia de los archivos CLAUDE.md (que siempre se cargan) a mecanismos que se cargan bajo demanda:
- Skills para material de referencia que se carga cuando es relevante.
- Plugins, paquetes versionados de skills, hooks y comandos que un equipo de plataforma posee y puede instalar para todos a través de configuraciones gestionadas. Las skills de los plugins usan un espacio de nombres, por lo que no colisionan con las skills por directorio.
- Servidores MCP, si tu organización ya ejecuta una búsqueda de código o un índice de recuperación sobre el repositorio.
Una vez que las convenciones viven en plugins, un compañero en una parte desconocida del árbol puede no saber cuál se aplica. La documentación sugiere un hook de SessionStart que mapee el directorio de inicio al plugin correcto e imprima una recomendación, ya que Claude Code añade la salida del hook al contexto de Claude antes del primer prompt.
Cambios que abarcan varios paquetes
Para un cambio que toca varios paquetes, como un tipo compartido y cada lugar donde se llama, la documentación ofrece dos técnicas. Entrega a Claude todo el cambio en una sola sesión, para que las decisiones detrás de cada edición sean consistentes. Y planifica primero: en el modo plan, Claude escribe el plan en un archivo, y "Claude Code vuelve a inyectar el archivo del plan después de cada compactación, para que el plan sobreviva donde el historial de conversación podría no hacerlo".
Lo que la gente intenta primero
Poner todo en el CLAUDE.md de la raíz. Consume contexto en instrucciones no relacionadas.
Editar claudeMdExcludes por tarea. Es estático. Inicia desde el paquete en su lugar.
Esperar que las reglas de denegación bloqueen cada lectura. Los subprocesos que abren archivos por sí mismos no están cubiertos.
Añadir un hermano con additionalDirectories y esperar su CLAUDE.md. Esa configuración nunca carga CLAUDE.md ni skills.
Escribir descripciones de skills largas. Con muchas skills, las descripciones pueden cortarse.
La solución: Cargar las instrucciones adecuadas para el código en el que estás
Paso 1: Elige dónde empezar
Empieza desde un paquete para trabajo enfocado, y desde la raíz para tareas que abarquen varios paquetes.
Paso 2: Divide CLAUDE.md por directorio
Mantén las reglas de todo el repositorio en la raíz y las convenciones específicas del stack en cada paquete, luego verifica con /context all.
Paso 3: Excluye y deniega lo que nunca necesites
Usa claudeMdExcludes para las instrucciones de otros equipos y reglas de denegación de Read para código generado o de terceros.
Paso 4: Registra por qué existe cada convención
Los archivos de instrucciones dicen qué hacer. Las decisiones detrás de ellas, y cuáles se están retirando, necesitan un hogar propio.
Configurando esto en MemoryLake
En una base de código grande, las convenciones se dispersan en muchos archivos y propietarios. Las decisiones detrás de ellas, como por qué la API usa un constructor de consultas o por qué un servicio legado está congelado, son lo que los nuevos compañeros y las nuevas sesiones siguen preguntando.
MemoryLake es una capa de memoria para ese tipo de contexto de proyecto, como decisiones arquitectónicas, propiedad de paquetes y las razones detrás de las convenciones, mantenida en un solo lugar que tú controlas y disponible para los asistentes que conectes, como ChatGPT, Claude Code y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada, ni se escribe ni se borra de tus archivos CLAUDE.md, tus reglas o skills, tus archivos de configuración, tus sesiones o el almacenamiento de cualquier proveedor. La carga de CLAUDE.md, las exclusiones y las skills funcionan de la manera que Anthropic describe.
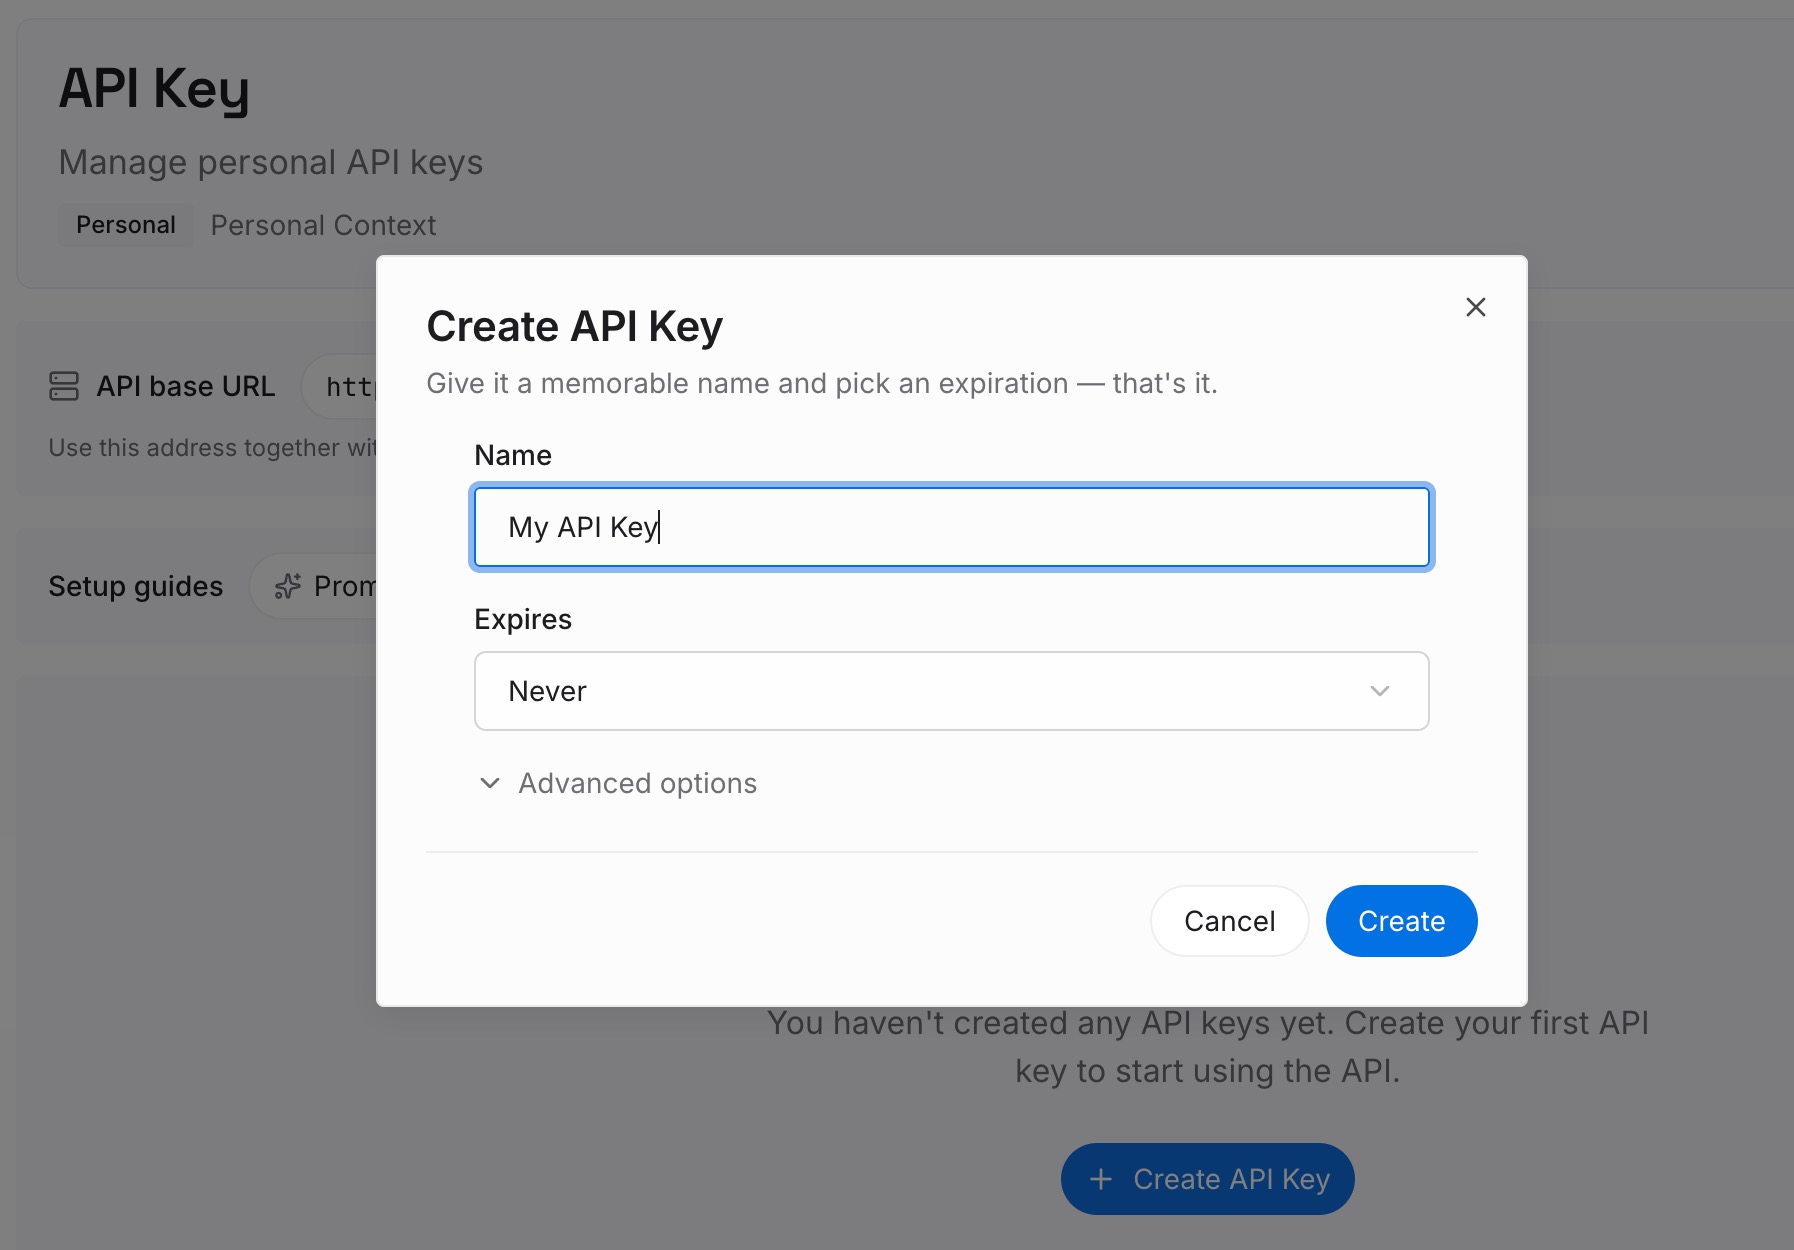
Paso 1: Crea una clave de API
Inicia sesión y genera una clave desde el panel de control. Guárdala fuera de tus repositorios, como cualquier otra credencial.
Paso 2: Sube tus primeras memorias
Empieza con lo que escribiste en el Paso 4 de la solución: las decisiones detrás de tus convenciones, agrupadas por paquete. Una decisión por entrada, con su propietario.
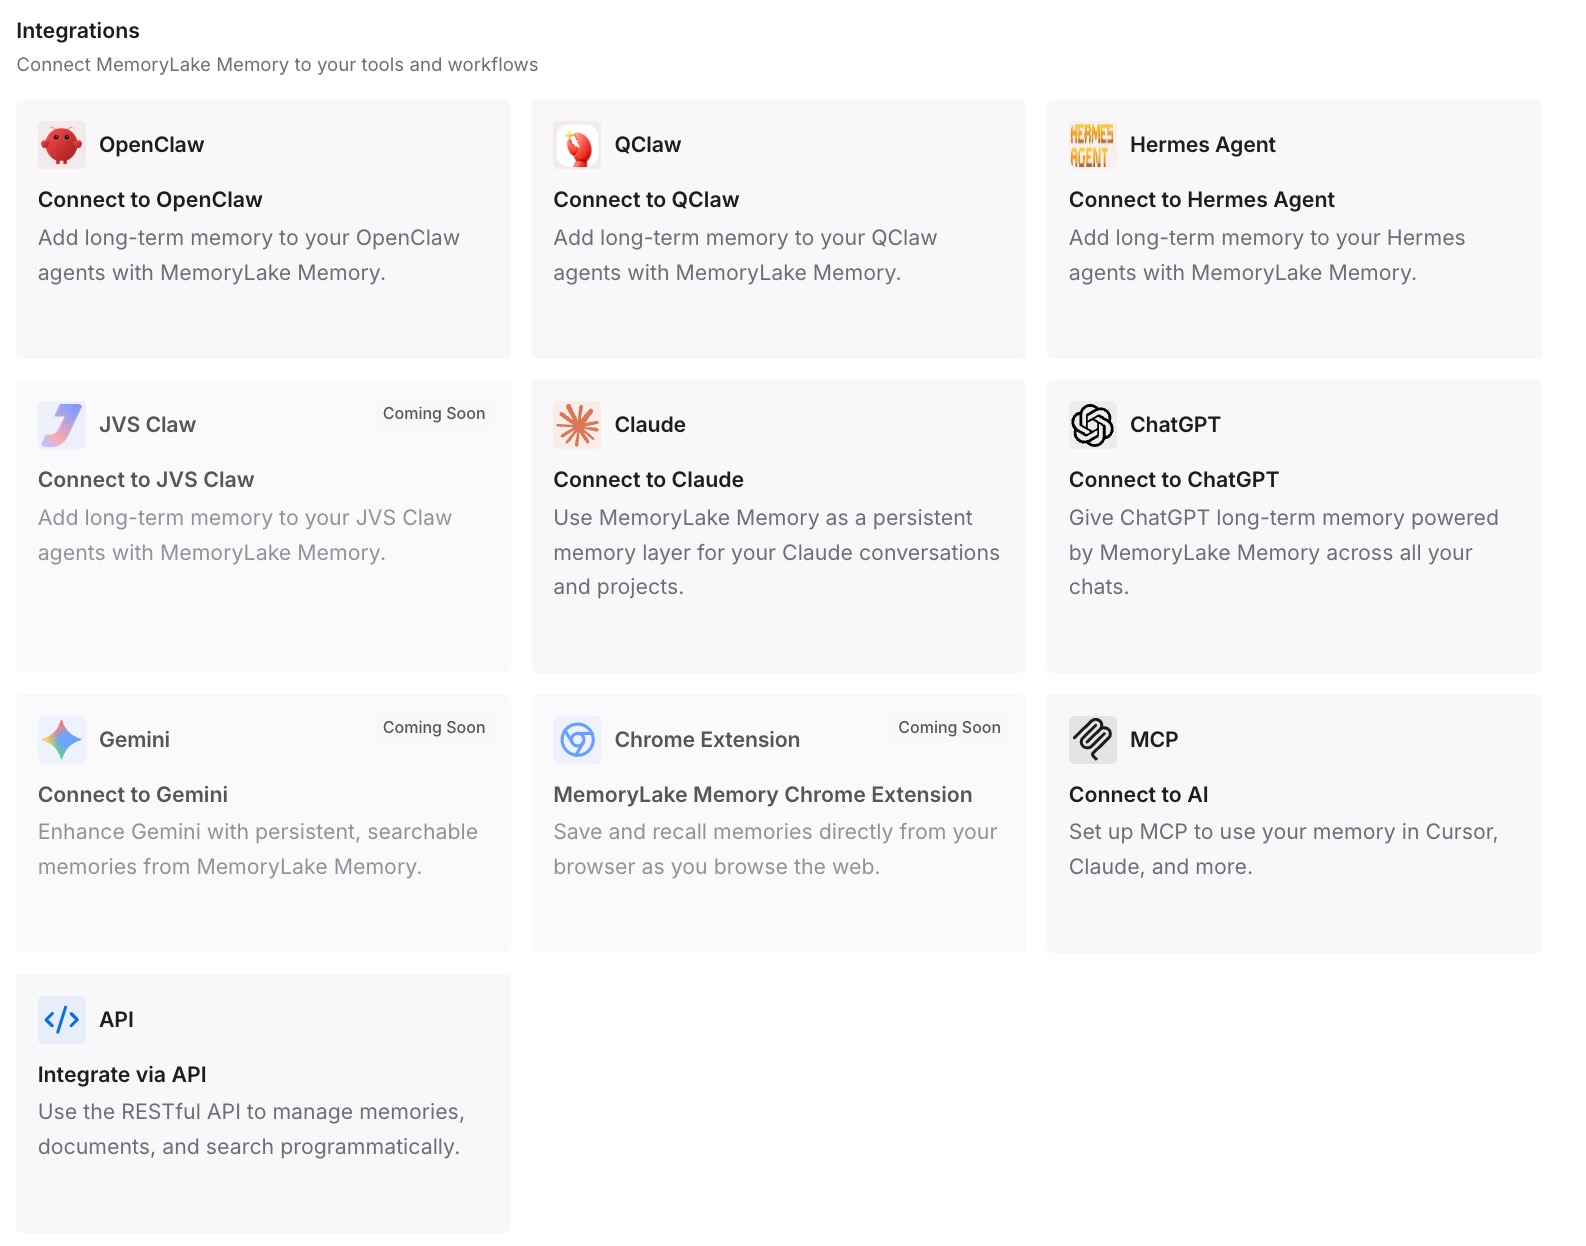
Paso 3: Conecta tu IA y agentes
Conecta Claude Code, Codex y los otros asistentes que utilices. Cada uno puede recurrir a las mismas decisiones, independientemente del paquete en el que se inicie una sesión.
Qué cambia esto en la práctica
La primera diferencia son archivos de instrucciones más pequeños. CLAUDE.md puede seguir tratando sobre qué hacer, con el razonamiento guardado en otro lugar.
La segunda es una incorporación (onboarding) más fácil. Un nuevo compañero puede leer por qué un paquete funciona de la manera en que lo hace.
La tercera es la consistencia entre herramientas. Codex trabajando en el mismo repositorio puede usar las mismas decisiones.
Mejores prácticas para Claude Code en una base de código grande
Empieza donde está el trabajo. Esto decide qué archivos CLAUDE.md se cargan.
Estratifica las instrucciones por directorio. Raíz para todas partes, paquetes para su propio stack.
Verifica qué se cargó. Usa /context all.
Excluye lo que nunca tocas. claudeMdExcludes es estático, así que configúralo una vez.
Deniega lecturas de código generado. Y recuerda que los subprocesos no están cubiertos.
Mantén cortas las descripciones de las skills. Empieza con las palabras que contendría una solicitud.
Mueve las convenciones crecientes a skills o plugins. Cárgalas bajo demanda.
Conclusión
Claude Code carga archivos CLAUDE.md basándose en dónde lo inicias: el archivo raíz solo desde la raíz, o el archivo de un paquete más el de todos sus ancestros desde un subdirectorio, con otros archivos cargándose bajo demanda. La guía de Anthropic para bases de código grandes recomienda estratificar las instrucciones por directorio, excluir los archivos en los que nunca trabajas con claudeMdExcludes, bloquear las lecturas de código generado y limitar el alcance de las skills a los paquetes a los que sirven.
Cuando los archivos por directorio dejan de escalar, la guía sugiere mover las convenciones a skills, plugins o servidores MCP que se cargan bajo demanda. Mantén las decisiones detrás de esas convenciones en algún lugar que tú mantengas, para que no deriven con los archivos.