
Por qué la verificación decide cuánto puedes delegar
La publicación comienza con lo que está en juego: "Los bucles de verificación son el bloque de construcción que te permite delegar más trabajo a Claude". Sin ellos, dice, solo puedes ejecutar uno o dos Claudes a la vez, porque tienes que revisarlo todo tú mismo.
También hace hincapié en el coste. Antes, escribir pruebas, benchmarks y especificaciones era caro. Ahora un agente puede producirlos y, una vez escritos, se ejecutan como software, por lo que pueden ejecutarse a menudo sin gastar muchos tokens adicionales.
A continuación viene la parte que conecta la verificación con la memoria. La publicación dice que puedes cerrar el círculo "usando los resultados para mejorar el rendimiento del agente en esa tarea". Su ejemplo: si un agente falla repetidamente una prueba que revisa los logs en busca de datos de usuario, "puedes crear un hook o una regla más explícita en tu CLAUDE.md para evitar problemas futuros".
Ese es el tema de todo lo que sigue. Un resultado de verificación es útil una vez. Un resultado de verificación que se convierte en una regla registrada es útil cada vez después de esa.
Los tres tipos de pruebas que recomienda el equipo
La publicación menciona tres tipos de pruebas en las que vale la pena invertir y explica por qué cada una es difícil de engañar para un agente.
Pruebas de extremo a extremo (End-to-end). "Si tienes que centrarte en un tipo de prueba, elige end-to-end". Estas describen flujos de usuarios reales, y o bien toda la funcionalidad funciona o no funciona.
Pruebas de propiedades (Property tests). Escribes una afirmación que crees que no puede fallar y una librería genera miles de entradas intentando demostrar lo contrario. Los ejemplos de la publicación incluyen codificación de ida y vuelta (round-trip), invariantes, idempotencia y equivalencia. El objetivo es usar casos de borde que no fueron creados con el mismo sesgo que el agente que escribió el código.
Pruebas diferenciales. Ejecuta el sistema antiguo y el nuevo con las mismas entradas. Si los resultados difieren, hay un error o un cambio disruptivo. Estas son adecuadas para migraciones donde el comportamiento debería mantenerse igual.
También menciona dos modos de fallo a evitar. Las pruebas inestables (flaky) entrenan a un agente para que las vuelva a ejecutar en lugar de arreglar el código. Las pruebas lentas significan menos ejecuciones, lo que hace que los problemas sean más difíciles de localizar.
Qué hace /verify y qué guarda
La primera regla del equipo es que ejecutar la aplicación importa más que las pruebas: "No enviarías un cambio de iOS sin probarlo en un simulador, y lo mismo ocurre con Claude".
Para que eso sea repetible, la publicación dice que se debe "crear una habilidad llamada verify" en una carpeta .claude/skills/ en tu repositorio, "tan cerca del código relevante como sea posible". Añade que Claude sabe que debe usar la habilidad verify antes de confirmar (commit) los cambios.
Claude Code también incluye un /verify integrado. La documentación de habilidades lo describe como una forma de "Construir y ejecutar tu aplicación para confirmar que un cambio de código hace lo que debe, sin recurrir a pruebas o comprobaciones de tipos". Funciona sin configuración infiriendo cómo lanzar tu proyecto a partir de su tipo y de archivos como tu README, package.json o Makefile. La documentación es sincera sobre el límite de eso: "Esa inferencia se vuelve poco fiable para proyectos que necesitan algo más allá de un lanzamiento estándar: una base de datos, un archivo env, una sesión gráfica, una construcción de varios pasos". Ese es exactamente el tipo de proyecto donde anotar los pasos vale la pena.
La parte de la memoria es lo que sucede después de una ejecución exitosa. Según la documentación, "/verify también puede registrar su propia receta". Cuando tiene que construir y manejar tu aplicación sin una receta registrada, "escribe lo que funcionó en .claude/skills/verify/SKILL.md en la raíz del repositorio, o en el directorio del paquete afectado en un monorepo, para que las ejecuciones posteriores y otros agentes sigan los mismos pasos".
Ese es un tipo de aprendizaje pequeño y específico. La primera ejecución exitosa descubre los pasos de lanzamiento. Cada ejecución posterior los sigue en lugar de redescubrirlos. Dos detalles más importan:
- La habilidad registrada toma el control. "En la raíz del repositorio, la habilidad registrada reemplaza al
/verifyintegrado". - No genera ruido innecesario. "Claude edita el archivo registrado solo cuando dirigió mal una ejecución, como un comando que falló o un paso faltante, para que puedas hacer commit del archivo sin diferencias por sesión".
Una habilidad integrada relacionada, /run-skill-generator, registra la receta deliberadamente. La documentación dice que pone tu aplicación en funcionamiento desde un entorno limpio, captura los comandos de instalación, las variables de entorno y el script de lanzamiento, y los confirma como una habilidad por proyecto. Después de eso, /run, /verify y otros agentes en el repositorio la siguen. El consejo de la documentación sobre el mantenimiento: "Ejecuta /run-skill-generator una vez por proyecto, y de nuevo si el proceso de construcción o lanzamiento cambia".
Cuándo ejecuta Claude la habilidad verify antes de un commit
La documentación describe una pieza más. "Cuando una sesión comienza con una habilidad llamada verify o simplify instalada, las instrucciones de commit de Claude Code le dicen a Claude que la ejecute justo antes de cada commit, excepto para cambios en documentos o pruebas". Esto requiere Claude Code v2.1.286 o posterior.
Las condiciones son específicas. La habilidad tiene que cargarse desde una ubicación compatible, y la receta que /verify registra en la raíz de tu repositorio cuenta. El /verify y /simplify integrados, las habilidades de plugins y las habilidades de tu cuenta de claude.ai no cuentan. Claude también tiene que ser capaz de invocar la habilidad, y las instrucciones de git integradas deben estar activadas.
Así que registrar una receta hace dos cosas a la vez. Guarda los pasos de lanzamiento y le da a Claude Code una habilidad de proyecto llamada verify, lo que cambia lo que se le dice a Claude que haga antes de cada commit.
El checklist: un activador para cada interrupción pasada
Esta es la parte de la publicación que trata más directamente sobre la memoria.
"Mantenemos un checklist de fiabilidad con 39 elementos, cada uno con un activador que se puede leer de un diff, una comprobación y los incidentes o PRs que hay detrás".
Cada elemento tiene tres partes:
- Un activador que se puede leer de un diff, para que Claude pueda saber si el elemento se aplica.
- Una comprobación para ejecutar cuando se aplica.
- Los incidentes o PRs detrás de él, para que la razón quede registrada con la regla.
El ejemplo de la publicación es "--resume carga transcripciones antiguas". Cuando el almacenamiento de la sesión o los tipos de mensajes cambian, el equipo pregunta si un nuevo campo se carga de forma segura, porque las transcripciones más antiguas no lo tendrán.
Luego, la frase clave: "Claude lee el diff y verifica solo los elementos cuyo activador coincide –normalmente de 3 a 10– para que nadie tenga que memorizar interrupciones pasadas".
Destacan dos opciones de diseño. El checklist no se carga como un muro de recordatorios en cada cambio. Solo se verifican los elementos cuyo activador coincide. Y cada elemento lleva su historial, para que la regla siga siendo comprensible después de que las personas que la escribieron se hayan ido.
Esa es la diferencia entre la nota del incidente en el ejemplo inicial y un elemento del checklist. La nota dependía de que alguien la recordara. El elemento del checklist se activa cuando un diff toca la misma área.
Rondas de revisión que se construyen unas sobre otras
La publicación describe un segundo hábito que funciona de la misma manera: "Dirigimos cada pase al contexto de rondas anteriores y fallos pasados en lugar de volver a verificar todo desde cero. Es más barato y encuentra más".
El equipo también mantiene a los revisores enfocados en lugar de añadir más. En lugar de apilar un segundo revisor más caro, mantiene un REVIEW.md que dice a qué debe prestar atención el revisor para ese código.
Ese archivo está protegido de los cambios que juzga. "Si un cambio puede modificar la comprobación que lo juzga, la comprobación está rota". La publicación dice que Code Review lee REVIEW.md de la rama base o por defecto, nunca de los cambios de la pull request.
Algunas otras reglas del proceso del equipo siguen la misma lógica:
- Escalar ante fallos repetidos. Claude ejecuta las comprobaciones e intenta arreglar lo que falla. "Si una comprobación sigue fallando después de tres rondas, Claude se detiene y trae a un humano".
- Decir por qué. Cuando una comprobación atrae a un revisor, debe decir por qué, para que no tengan que deducirlo del diff.
- Revisar commits, no objetivos móviles. "Una revisión aprobada en un commit desactualizado no significa nada".
- Ejecutar comprobaciones baratas primero. Claude ejecuta las pruebas, la construcción y el linter antes de abrir una pull request. La publicación dice que puedes forzar esto con un hook que ejecute pruebas cuando Claude termine. Cubrimos lo que los hooks pueden hacer, y cuáles pueden añadir contexto para Claude, en nuestra guía sobre qué son los hooks de Claude Code.
Sellos y puertas: registrando cómo se verificó cada commit
El equipo registra la verificación en el propio commit. "En nuestros propios repositorios, sellamos cada commit con cómo fue verificado". El sello puede decir "ninguno", para que el equipo pueda consultar los commits que no fueron verificados.
También construyeron una puerta de commit (commit gate) que puede bloquear un commit si la sesión no incluyó /code-review o /verify, con modos desactivado, observar y aplicar. El modo observar registra lo que habría sido bloqueado, para que los falsos positivos puedan revisarse primero. En el modo aplicar, un commit puede llevar una explicación de por qué no fue verificado, y después de dos commits bloqueados en una sesión, el siguiente pasa "para que Claude no se bloquee".
Estas son herramientas propias del equipo, descritas en una publicación de blog. La publicación no presenta el sello o la puerta como características de Claude Code que puedas activar.
Cómo los errores omitidos se convierten en reglas
La última sección de la publicación trata sobre convertir las omisiones en memoria. En el repositorio de Claude Code, el equipo utiliza dos métodos.
El primero extrae patrones de los comentarios de revisión humana y de las reversiones de PR. Un patrón tiene que "ocurrir en al menos dos PRs y ser identificable desde un diff" para ser considerado como una regla. Tres agentes intentan refutarlo, y un humano lo revisa y aprueba en una PR.
El segundo vuelve a ejecutar tres buscadores de errores contra una PR vinculada a un incidente conocido. Si al menos dos encuentran el error, es detectable. Si el error se omite en un diff pequeño, esa es una brecha que vale la pena convertir en una regla en REVIEW.md.
Las pruebas inestables reciben un tratamiento similar. Claude no puede saltárselas, añadir esperas (sleeps) o reintentar hasta que pasen. Si no puede encontrar la causa raíz, "elimina la prueba y anota por qué".
Y las reglas mismas necesitan mantenimiento: "Las reglas también necesitan limpieza". Las suites de pruebas, los pasos de verificación y los archivos .md solo crecen si lo permites, por lo que el equipo los ordena de forma rutinaria.
El consejo final de la publicación lo une todo: trata la capa de verificación como cualquier otro sistema, y "anota las lecciones cuando omitan algo para que no suceda más de una vez, y poda esas lecciones para que sigan valiendo la pena ejecutarlas".
Lo que la gente intenta primero
Escribir una nota de incidente y esperar que alguien la recuerde. El checklist del equipo vincula cada lección a un activador en el diff.
Añadir un segundo revisor. La publicación favorece el ajuste del revisor principal con REVIEW.md.
Dejar que /verify redescubra el lanzamiento cada vez. Puede registrar una receta en .claude/skills/verify/SKILL.md.
Convertir cada omisión en una regla. El equipo requiere un patrón en al menos dos PRs, legible desde un diff, y aprobación humana.
Mantener cada regla para siempre. Las reglas se podan de forma rutinaria.
La solución: convertir los resultados de verificación en algo que la próxima sesión pueda usar
Paso 1: Registrar cómo ejecutar la aplicación
Usa /run-skill-generator, o deja que /verify registre su receta, y haz commit del resultado.
Paso 2: Dar a cada lección un activador
Cuando se envíe un error, escribe la regla con qué parte de un diff debería activarla y el incidente que hay detrás.
Paso 3: Mantener las reglas fuera del alcance de los cambios que juzgan
Coloca las reglas de revisión donde el cambio bajo revisión no pueda editarlas.
Paso 4: Anotar el razonamiento detrás de tus reglas
Un activador dice cuándo se aplica una regla. La decisión detrás de ella, y el incidente que la causó, necesitan un hogar que perdure.
Configurando esto en MemoryLake
Un elemento del checklist funciona porque lleva su historial. Lo mismo ocurre con las decisiones detrás de tu proyecto: por qué existe una comprobación, qué enfoque se probó y se descartó, y qué te enseñó un incidente.
MemoryLake es una capa de memoria para ese tipo de contexto de proyecto, como decisiones, lecciones de incidentes y las razones detrás de tus reglas, mantenidas en un solo lugar que tú controlas y disponibles para los asistentes que conectes, como ChatGPT, Claude Code y Codex.
Tú mismo escribes las entradas, con tus propias palabras. No se lee nada, ni se escribe ni se borra nada de tus habilidades, tus archivos REVIEW.md o CLAUDE.md, tus sesiones, tus commits o el almacenamiento de cualquier proveedor. /verify y Code Review funcionan de la manera que Anthropic los describe.
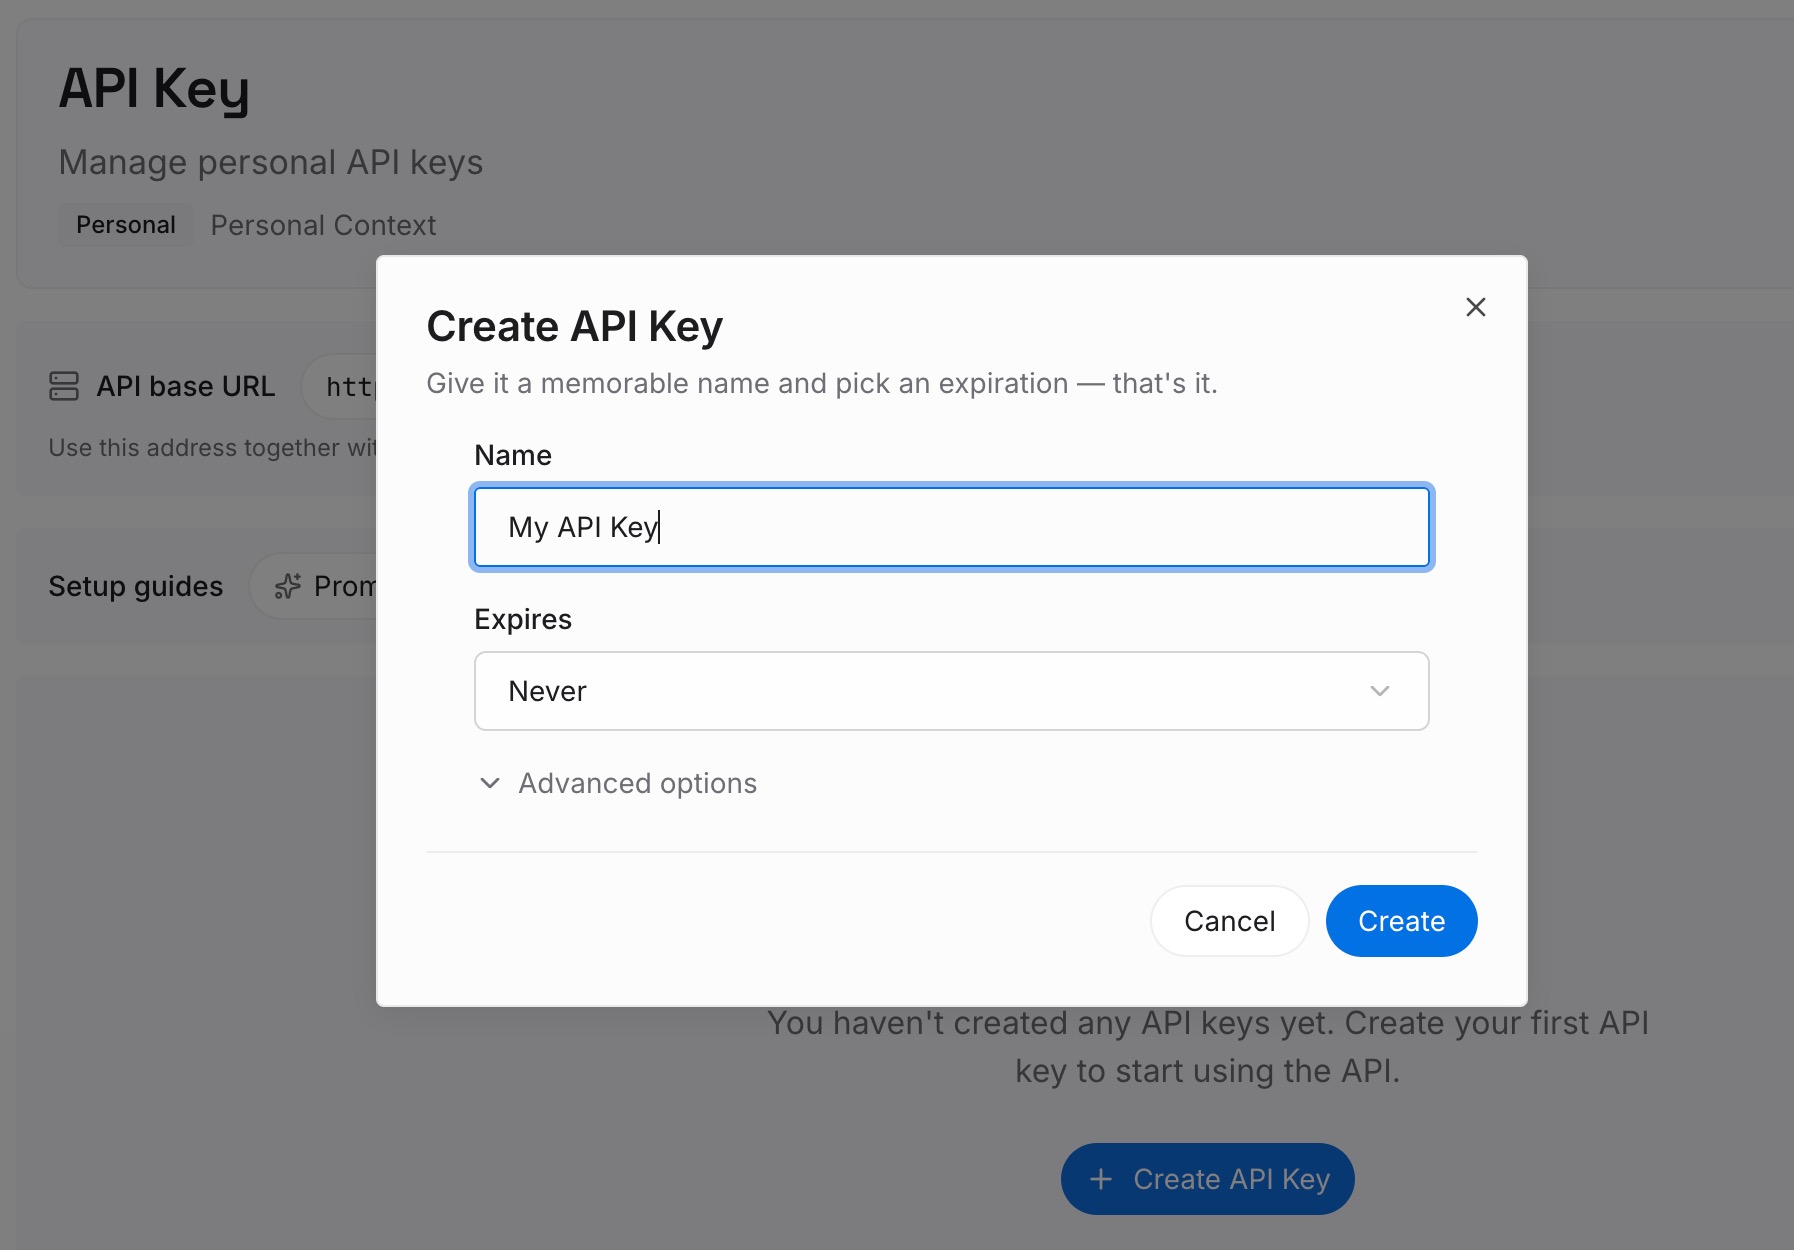
Paso 1: Crear una clave API
Inicia sesión y genera una clave desde el panel de control. Guárdala fuera de tus repositorios, como cualquier otra credencial.
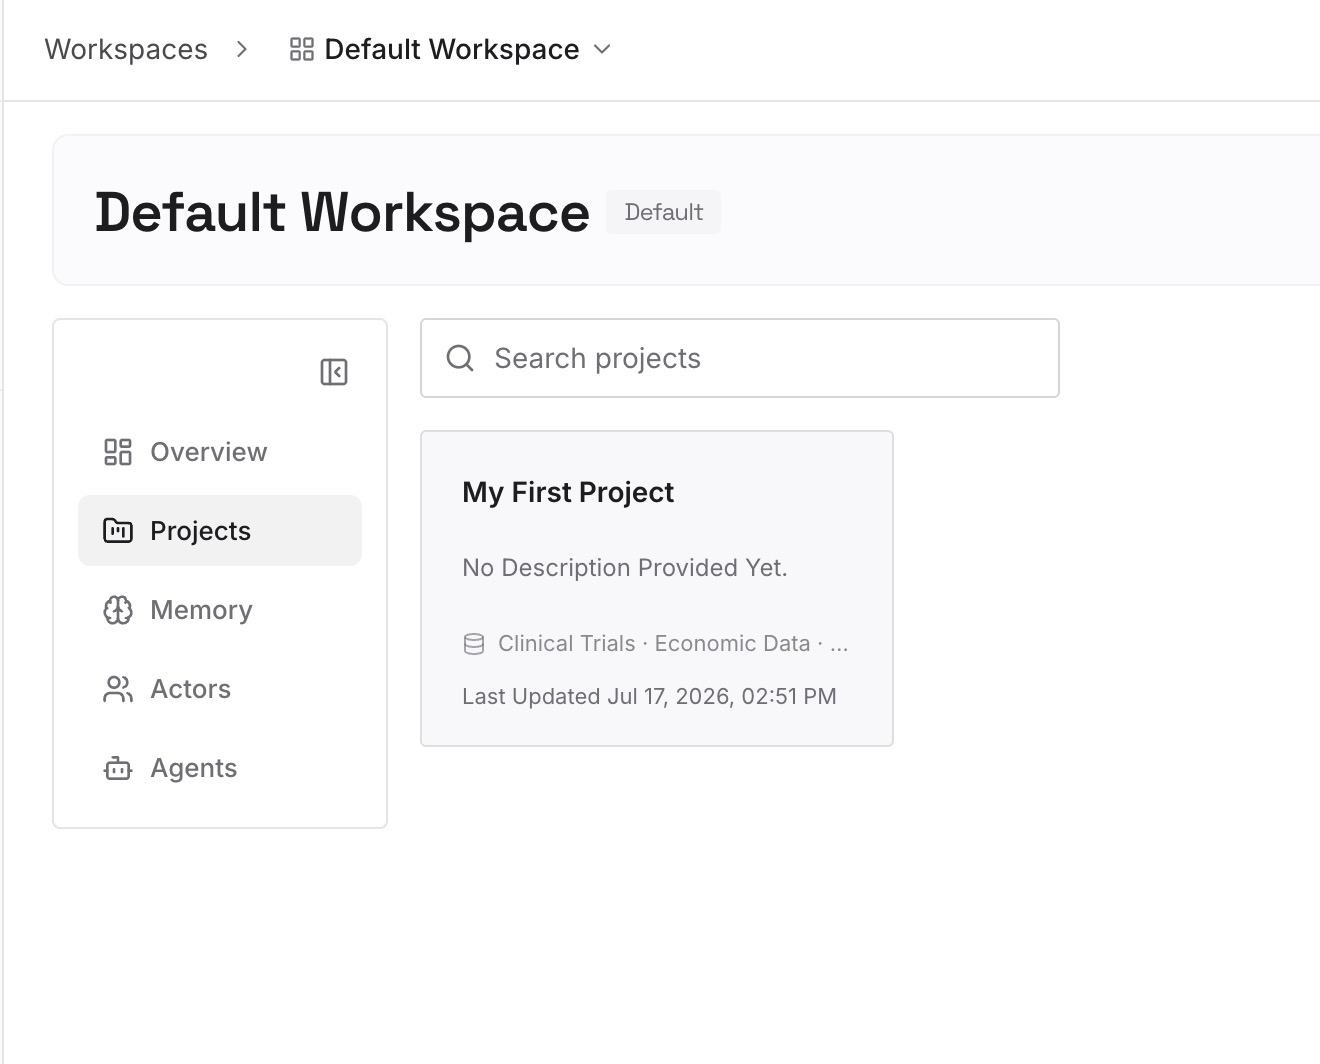
Paso 2: Sube tus primeras memorias
Comienza con lo que escribiste en el Paso 4 de la solución: los incidentes detrás de tus reglas y lo que cada uno te enseñó. Una lección por entrada, con la fecha.
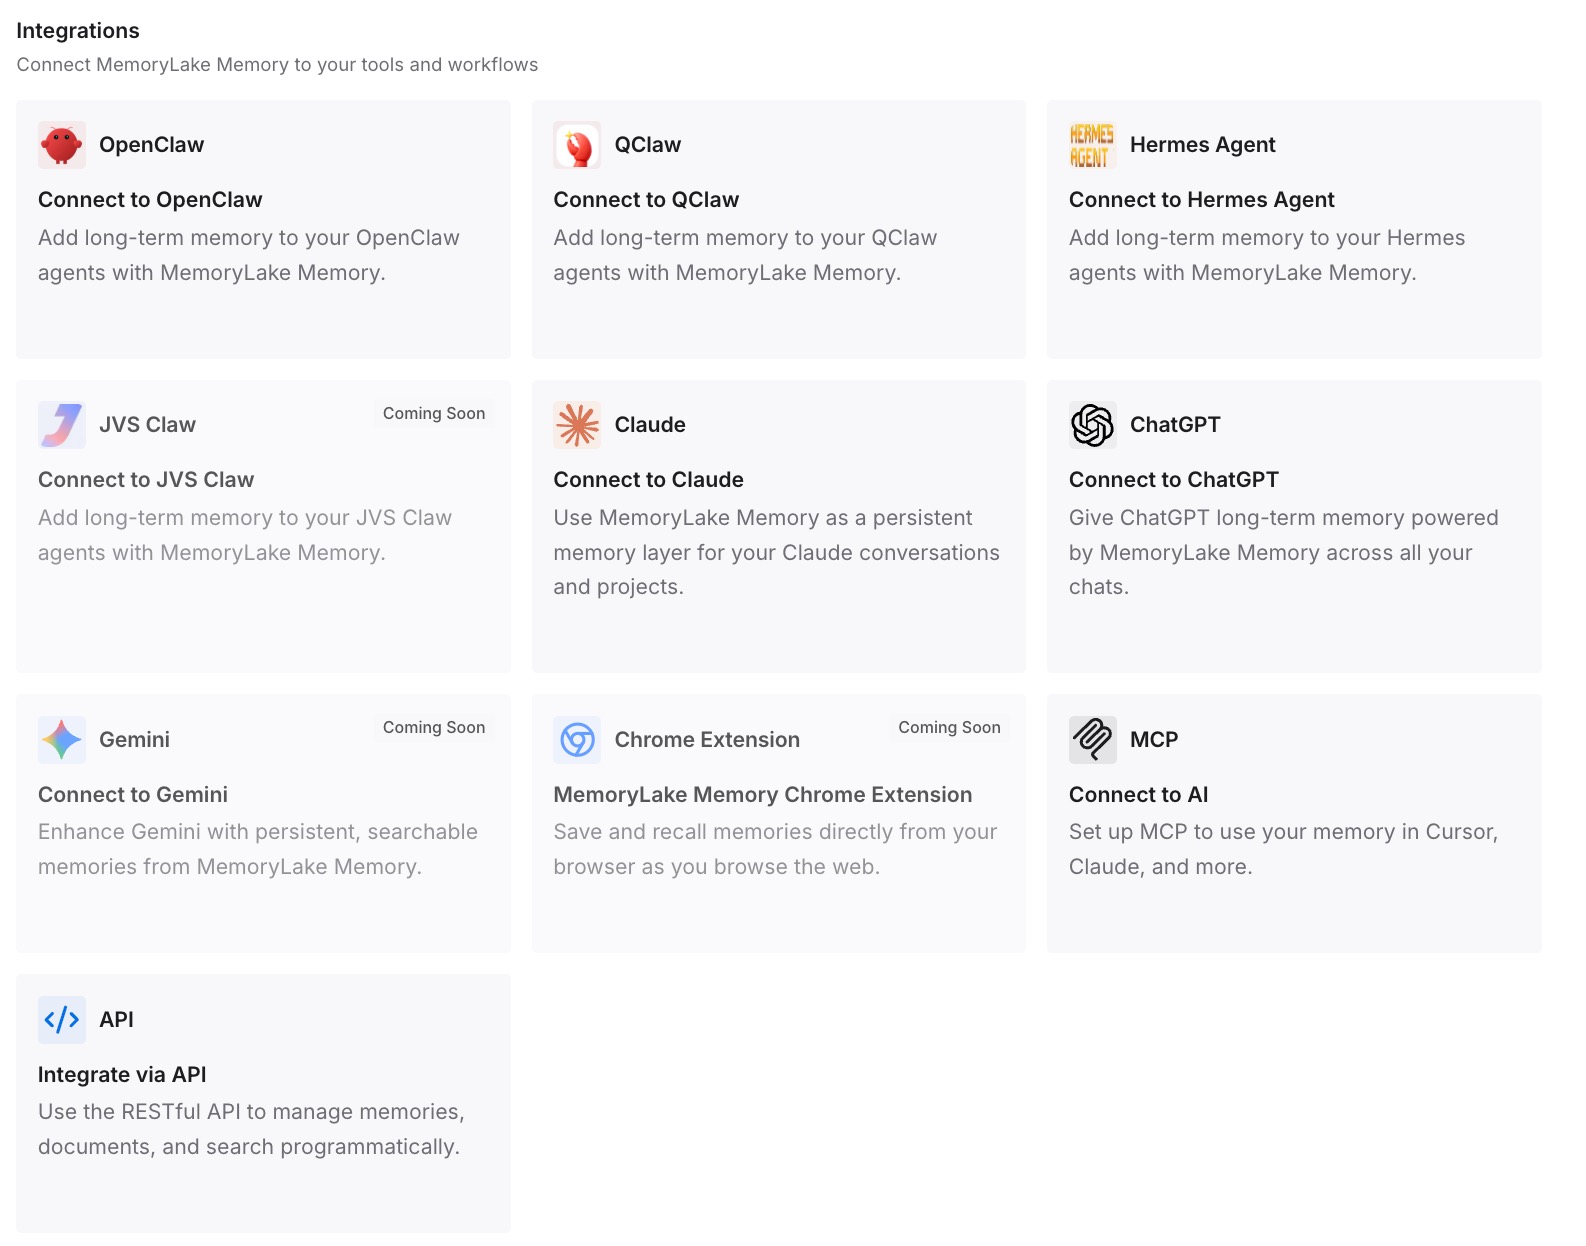
Paso 3: Conecta tu IA y agentes
Conecta Claude Code y los otros asistentes que utilices. Una nueva sesión, o el asistente de un compañero de equipo, puede recurrir a las mismas lecciones.
Qué cambia esto en la práctica
La primera diferencia es que las lecciones sobreviven a las personas que las aprendieron. La razón de una regla queda por escrito.
La segunda es menos redescubrimiento. Una receta registrada y una decisión registrada evitan que la siguiente sesión tenga que resolverlo de nuevo.
La tercera es el contexto compartido entre herramientas. Codex u otro asistente que trabaje en el mismo proyecto puede usar las mismas lecciones.
Mejores prácticas para verificar el trabajo de Claude
Ejecutar la aplicación de extremo a extremo. El equipo trata esto como algo más importante que las pruebas.
Registrar la receta de lanzamiento. Haz commit de .claude/skills/verify/SKILL.md una vez que funcione.
Dar activadores a las reglas. Verifica solo lo que toca un diff.
Adjuntar historial a las reglas. Mantén el incidente o la PR con cada elemento.
Construir sobre rondas anteriores. Dirige cada pase a los fallos pasados.
Escalar después de fallos repetidos. El equipo trae a un humano después de tres rondas.
Podar tus reglas. Las reglas solo crecen si lo permites.
Conclusión
El proceso de verificación del equipo de Claude Code trata tanto sobre la memoria como sobre las pruebas. /verify puede registrar los pasos que funcionaron en .claude/skills/verify/SKILL.md, para que las ejecuciones posteriores y otros agentes los sigan. El checklist de fiabilidad del equipo le da a cada lección un activador, una comprobación y los incidentes detrás de ella, y Claude verifica solo los elementos que coinciden con un diff. Las rondas de revisión apuntan a fallos pasados, y los errores omitidos se convierten en reglas solo después de que se repiten y un humano los aprueba.
El hilo conductor es que una lección tiene que escribirse en algún lugar donde la próxima sesión la encuentre, con suficiente historial para seguir siendo comprensible.